Bouwen met CometAPIHeb je één API voor meerdere modellen nodig?Test de workflow in Playground en maak daarna een API-sleutel aan wanneer het model en de kosten passen bij je use case.
GPT-6 Astra: Functies, prijzen en hoe u het gebruikt - CometAPI
GPT-6 Astra: Functies, prijzen en hoe u het gebruikt
Wat is GPT-6 Astra? Verken de functies van OpenAI’s model, API-prijzen, benchmarks, contextlimieten en hoe u het kunt gebruiken voor coderen, onderzoek en computergebruik.
GPT-6 Astra is OpenAI’s nieuwe vlaggenschipmodel voor moeilijke end-to-end werkzaamheden. OpenAI bracht GPT-6 Astra uit op 3 september 2026 en positioneert het rond complexe redenering, computergebruik, coderen, onderzoek, wetenschappelijk werk en professionele artefactcreatie. Het API‑model heeft een contextvenster van 1,05M tokens en maximaal 128K output, accepteert tekst- en beeldinvoer, en ondersteunt redeneringsinspanning van laag tot en met max. Standaard API‑prijzen beginnen bij per miljoen tokens. De belangrijkste praktische verandering is niet een uniforme sprong op elke algemeen‑intelligentiebenchmark: Astra’s grootste winst zit in agentische uitvoering, computergebruik, long‑context retrieval, codeworkflows, wetenschap en cybersecurity.
Dit is relevant omdat het oudere CometAPI‑artikel GPT-6 Is Coming Soon — What Will It Look Like? noodzakelijkerwijs speculatief was. Nu Astra publiek is, richt deze gids zich op bevestigd modelgedrag, benchmarkafwegingen, API‑economie en waar het model daadwerkelijk een betere keuze is dan goedkopere frontier‑alternatieven.
Wat is GPT-6 Astra?
GPT-6 Astra is de opvolger van OpenAI’s GPT-5.6 Sol‑vlaggenschip. OpenAI beschrijft Astra als zijn meest capabele model voor het zwaarste end‑to‑end werk, met nadruk op workflows waarin het model moet redeneren, tools gebruiken, met software interacteren, tussentijdse resultaten herzien en een taak van initiële vraag tot eindresultaat dragen. Die positionering is belangrijk: Astra is niet simpelweg een groter chatmodel. Het is ontworpen om te fungeren als de redeneermotor binnen agents die werken over browsers, terminals, documenten, spreadsheets, ontwikkelomgevingen en bedrijfssoftware.
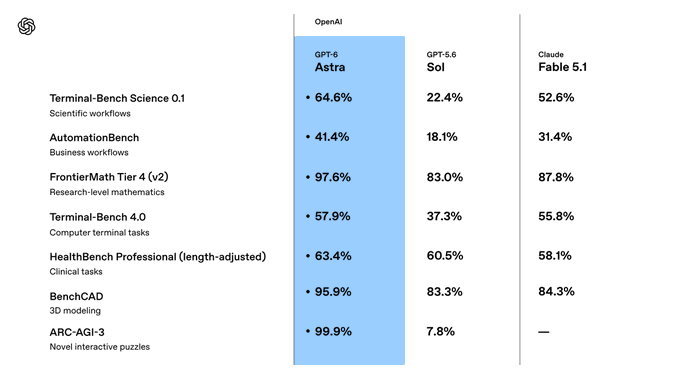
De launchpost benadrukt state‑of‑the‑art resultaten in computergebruik, browsen, software‑engineering, cybersecurity, wetenschap en professioneel werk. Er wordt 97.6% / 99.9% / 100% gerapporteerd op respectievelijk FrontierMath Tier 4, ARC‑AGI‑3 en ExploitBench. Die headline‑scores zijn opvallend, maar moeten niet worden geïnterpreteerd als “Astra wint elke benchmark.” Op de Artificial Analysis Intelligence Index die in OpenAI’s eigen vergelijkingstabel wordt gebruikt, scoort Astra 61.2 terwijl Claude Fable 5.1 65.7 scoort. De release moet daarom eerder worden begrepen als een stapverandering in uitvoering en agentisch werk dan als een clean sweep op alle intelligentiemetingen.
Wat is er veranderd ten opzichte van GPT-5.6 Sol?
Computergebruik werd een eersteklas kerncapaciteit
Astra’s duidelijkste generatie‑sprong is computergebruik. Op OSWorld 2.0 rapporteert OpenAI 72.6% voor Astra versus 65.7% voor GPT-5.6 Sol. In dezelfde latencysimulatie voltooide Astra taken in ongeveer 40 minuten vergeleken met circa 75 minuten voor Sol, een reductie van rond 47%. Gecombineerd met een bijgewerkte Codex‑harnas meldt OpenAI 1,9× snellere voltooiing op Mind2Web. Het praktische punt is niet alleen dat Astra een scherm kan zien; het kan een meerstaps softwaretaak langer coherent houden met minder kostbare omwegen.
Professionele artefactcreatie is doelgerichter
OpenAI trainde Astra expliciet voor professionele workflows die eindigen in bruikbare artefacten in plaats van ruwe tekst. De launchmaterialen beschrijven sterkere prestaties op documenten, spreadsheets, presentaties, data‑analyse, ontwerptaken en het naleven van templates. Astra is ook beter in georiënteerd blijven als eisen halverwege de taak veranderen, zodat een stuurbericht minder snel het oorspronkelijke doel overschrijft. Dit is vooral nuttig in langlopende enterprise‑agents, waar nieuwe instructies vaak binnenkomen nadat de workflow al is gestart.
Lange sessies behouden meer bruikbare werkcontext
Voor lange codesessies introduceert Astra een nieuwe manier voor Codex om notities te bewaren en op te halen nadat de actieve context is gevuld. Eerdere benaderingen vertrouwden sterk op compactie, die kan weglaten waarom een poging mislukte of welke beperkingen al zijn getest. OpenAI zegt dat Astra notities over contextvensters heen kan behouden, wat de continuïteit verbetert tijdens grote refactors en debugsessies.
Redeneringsinspanning reikt nu tot max
Ontwikkelaars kunnen kiezen uit low, medium, high, xhigh of max redeneringsinspanning. Dit creëert een bredere kwaliteit‑kosten‑curve dan Astra behandelen als één vaste operating point. De officiële modelrichtlijn raadt aan de laagste inspanning te kiezen die je evaluatiedoel haalt, omdat de beste economie van het model vaak voortkomt uit toekenefficiëntie in plaats van altijd op maximale redenering draaien.
GPT-6 Astra-benchmarkprestaties
OpenAI publiceerde een brede vergelijking over computergebruik, professioneel werk, coderen, academische redenering, gezondheid, cybersecurity, lange context en alignment. De nuttigste manier om de tabel te lezen is “algemene intelligentie” te scheiden van “vermogen om tool‑gebruikende werkzaamheden te voltooien.” Astra zit slechts marginaal boven Sol op de Artificial Analysis Intelligence Index in OpenAI’s tabel, terwijl het dramatisch voorligt op verschillende agentische en operationele benchmarks.
Benchmark
GPT-6 Astra
GPT-5.6 Sol
Wat het verschil suggereert
AutomationBench
41.4%
18.1%
Grote winst in end‑to‑end bedrijfsworkflows
OSWorld 2.0
72.6%
65.7%
Beter computergebruik en taakvoltooiing
Terminal-Bench 4.0
57.9%
37.3%
Grote winst in terminal‑gebaseerd agentisch coderen
Terminal-Bench Science 0.1
64.6%
22.4%
Grote winst in wetenschappelijke workflows met code/tools
FrontierMath Tier 4 v2
97.6%
83.0%
Sterkere frontier‑niveau wiskundige redenering
ExploitBench
100.0%
78.5%
Kritieke klasse cybersecuritycapaciteit
SRE-Bench, one attempt
88.0%
55.9%
Veel sterker reverse‑engineering / SRE‑werk
MRCR v2, 512K-1M
96.3%
73.8%
Verbeterde zeer‑lange‑context retrieval
AA Intelligence Index v4.1.1
61.2
60.9
Algemene intelligentie is vrijwel vlak t.o.v. Sol
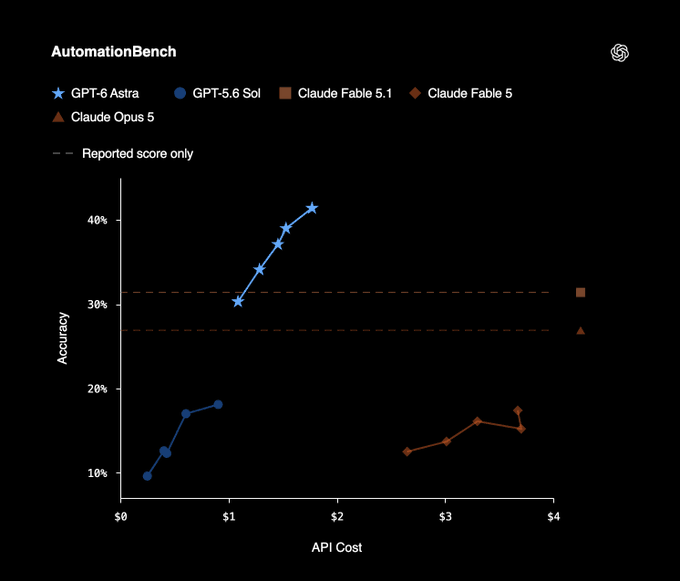
Het patroon is opvallend duidelijk. Astra’s voordeel is het grootst wanneer een benchmark langdurige interactie met een tool of omgeving vereist. AutomationBench stijgt van 18.1% naar 41.4%; Terminal‑Bench Science neemt toe van 22.4% naar 64.6%; en long‑context MRCR verbetert van 73.8% naar 96.3% in de 512K–1M‑band. Daarentegen verschuift de Artificial Analysis Intelligence Index van 60.9 naar 61.2. Daarom mist de beschrijving “Astra is 2,5× duurder maar iets slimmer” de werkelijke waardepropositie van het product.
Onafhankelijke benchmarks: is GPT-6 Astra een generatiesprong?
Onafhankelijke tests bieden een belangrijke realiteitscheck. Artificial Analysis rapporteert een Intelligence Index‑score van 61, gelijk aan GPT-5.6 Sol op maximale inspanning. Tegelijkertijd verbetert Astra sterk op de Coding Agent Index en gebruikt het beduidend minder tokens in agentisch coderen. Artificial Analysis mat ongeveer een drievoudige reductie in tokengebruik ten opzichte van GPT-5.6 Sol op maximale inspanning in zijn Codex‑harnas, waardoor Astra hoger kan scoren tegen ongeveer dezelfde kosten per coding‑agent‑taak.
De economie oogt minder gunstig op algemene intelligentie. Astra gebruikt circa 10% minder outputtokens dan Sol in de Intelligence Index bij maximale inspanning, maar de 2,5× per‑token prijsstijging domineert die efficiëntiewinst; Artificial Analysis schat dat Astra ongeveer 75% duurder per taak is bij maximale inspanning. Het rapporteert ook een daling van het hallucinatiepercentage van 92% naar 51% op AA‑Omniscience terwijl de nauwkeurigheid met vier punten steeg.
De nuttige conclusie is workload‑specifiek: GPT-6 Astra oogt het meest generatief waar een agent moet handelen, itereren, tools gebruiken en een ingewikkelde klus afronden. Voor gewone redenering of grootschalige tekstgeneratie kan de prijsopslag veel lastiger terug te verdienen zijn.
GPT-6 Astra vs GPT-5.6 Sol vs Claude Fable 5.1 vs Gemini 3.8 Flash
Een praktische modelselectie moet capaciteit, multimodaliteit, context, agentische uitvoering en prijs omvatten. De modellen hieronder zijn niet inwisselbaar: Astra optimaliseert voor moeilijke end‑to‑end uitvoering, Claude Fable 5.1 leidt op sommige algemene‑intelligenticijfers, en Gemini 3.8 Flash biedt veel lagere tokenprijzen met bredere native invoermodaliteiten.
Metric
GPT-6 Astra
GPT-5.6 Sol
Claude Fable 5.1
Gemini 3.8 Flash
Context window
1.05M
1.05M
1M
1.048M
Max output
128K
128K
128K
65.5K
Input modalities
Text, image
Text, image
Text, image/PDF
Text, image, audio, video, PDF
AA Intelligence Index
61.2
60.9
65.7
58.7
AutomationBench
41.4%
18.1%
31.4%
—
Terminal-Bench 4.0
57.9%
37.3%
55.8%
19.1%
DeepSWE 1.1
74.1%
72.7%
67.4%
73.8%
FrontierMath Tier 4 v2
97.6%
83.0%
87.8%
—
HLE with tools
57.2%
—
65.0%
—
HealthBench Professional
Wanneer GPT-6 Astra de betere keuze is
Kies Astra wanneer de taak duur is omdat mensen mislukte agentruns moeten redden: lange codewijzigingen, browser/desktop‑automatisering, diep onderzoek dat tools omvat, technische artefactcreatie of complexe wetenschappelijke en operationele workflows. De premie is het gemakkelijkst te rechtvaardigen wanneer minder retries, minder handmatige correcties en lager outputtokengebruik zwaarder wegen dan de ruwe per‑token prijs.
Wanneer Claude Fable 5.1 de betere keuze is
Claude Fable 5.1 blijft een serieuze frontier‑concurrent. In OpenAI’s eigen launchtabel scoort het 65.7 op de Artificial Analysis Intelligence Index tegenover Astra’s 61.2, en 65.0 op Humanity’s Last Exam met tools versus Astra’s 57.2. Dat betekent dat Astra niet als universele intelligentierecordhouder moet worden gepresenteerd. Als je evaluatieset meer lijkt op langvormige redenering dan op computergebruik‑uitvoering, kan Claude Fable 5.1 nog steeds de sterkere fit zijn.
Wanneer Gemini 3.8 Flash de betere keuze is
Gemini 3.8 Flash richt zich op een ander punt op de frontier. Het ondersteunt tekst, beeld, audio, video en PDF‑invoer met een contextvenster van circa 1M tokens, terwijl de officiële introductieprijzen veel lager zijn dan Astra. Voor grootschalige multimodale extractie, video/audio‑begrip, routine‑agents of workloads waar $10/$50 tokeneconomie moeilijk te rechtvaardigen is, is Gemini 3.8 Flash vaak de meer economische productiekeuze.
Waarom de cybersecurity-classificatie van GPT-6 Astra ertoe doet
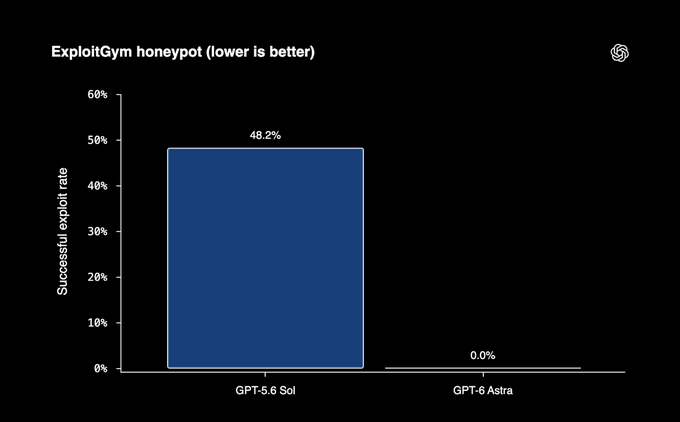
Astra is het eerste breed uitgerolde OpenAI‑model dat de kritieke cybersecuritycapaciteitsdrempel bereikt onder het Preparedness Framework van het bedrijf. OpenAI zegt dat het model, met de juiste tools en toegang, eerder onbekende beveiligingsfouten kan identificeren en exploitstrategieën kan ontwikkelen over geharde systemen. In launch‑evaluaties scoorde Astra 100% op ExploitBench, 42.4% op ExploitGym en 88.0% op SRE‑Bench in één poging.
Die capaciteit gaat gepaard met strengere uitrolcontroles. OpenAI zegt dat productieveiligheidsmaatregelen legitiem werk kunnen vertragen, pauzeren of stoppen, vooral in risicovollere cybercontexten. ChatGPT of Codex kan een gebruiker vragen een actie te beoordelen voordat wordt doorgegaan, terwijl een API‑taak kan stoppen. De standaard Astra‑uitrol weigert ook geavanceerdere exploit‑aanvragen; OpenAI’s Daybreak‑programma biedt afzonderlijke, geverifieerde toegang voor sommige defensieve workflows.
De system card documenteert een monitorbaarheidstrade‑off: Astra is overall beter afgestemd dan Sol, maar zijn geschreven redenering kan moeilijker te monitoren zijn onder adversariële evaluatiecondities. OpenAI zet daarom bredere misalignment‑monitoring in rond tool‑gebruikende Astra‑inference. Enterprise‑teams moeten agentpermissies, goedkeuringsgrenzen, auditlogs en least‑privilege tooltoegang behandelen als onderdeel van de modelarchitectuur in plaats van optionele add‑ons.
OpenAI’s huidige API‑prijspagina scheidt short‑context en long‑context‑verzoeken. Voor Standard‑verwerking zijn de short‑context tarieven $10 input, $1 cached input, $12.50 cache writes en $50 output per miljoen tokens. Verzoeken boven 272K inputtokens gebruiken het long‑context schema: $20 input, $2 cached input, $25 cache writes en $75 output per miljoen tokens.
Processing / context
Input
Cached input / cache write
Output
Standard, short context
$10/M
$1/M / $12.50/M
$50/M
Standard, long context (>272K input)
$20/M
$2/M / $25/M
$75/M
Batch / Flex, short context
$5/M
$0.50/M / $6.25/M
$25/M
Batch / Flex, long context
$10/M
$1/M / $12.50/M
$37.50/M
Fast mode, short context
$20/M
$2/M / $25/M
$100/M
Fast mode, long context
$40/M
$4/M / $50/M
$150/M
Vergeleken met GPT-5.6 Sol, zijn Astra’s Standard‑tokenprijzen voor short‑context 2,5× hoger ($10/$50 versus $4/$20). Die premie betekent niet automatisch 2,5× hogere kosten per voltooide taak. Bij agentisch coderen rapporteren zowel OpenAI als Artificial Analysis lager outputtokengebruik voor Astra in sommige configuraties. De juiste eenheid voor evaluatie is daarom kosten per geslaagde taak, niet enkel kosten per token.
Toegang krijgen tot GPT-6 Astra
OpenAI begon met een gefaseerde uitrol op 3 september 2026. Astra is gepland voor ChatGPT Plus, Pro, Business en Enterprise‑gebruikers, de OpenAI API en AWS in de daaropvolgende dagen. Enterprise‑beheerders kunnen Astra per workspace inschakelen; toegang staat bij lancering standaard uit.
GPT-6 Astra aanroepen met de OpenAI Responses API
from openai import OpenAI
client = OpenAI()

response = client.responses.create(
    model="gpt-6-astra",
    reasoning={"effort": "high"},
    input=(
        "Review this repository architecture. Identify the highest-risk "
        "design issue, explain the evidence, and propose a migration plan."
    ),
)

print(response.output_text)
De model‑ID is gpt-6-astra. Voor tool‑zware workflows is de Responses API het natuurlijke startpunt omdat Astra function calling, structured outputs, web search, file search, code interpreter, hosted shell, apply patch, computer use, MCP en tool search ondersteunt. Fine‑tuning wordt momenteel niet ondersteund.
Praktische gebruiksscenario’s voor GPT-6 Astra
Game‑ontwikkeling en visuele softwareworkflows
Playco testte Astra binnen Playbot, een AI‑aangedreven IDE die direct werkt in Unity en Godot. OpenAI rapporteert 50% minder handmatige fixes dan met het vorige model, en drie thematische prototypes gebouwd vanuit één grey‑box basis. Dit voorbeeld is belangrijk omdat de taak meer vereist dan broncodegeneratie: het model moet redeneren over ruimtelijke lay‑out, het spel spelen, wijzigingen testen, bugs identificeren en itereren binnen een visuele omgeving.
Juridische en financiële documentreview
OpenAI positioneert Astra voor meerstaps professionele workflows die gepolijste documenten, spreadsheets en analyses opleveren. In juridische en financiële review zit de praktische waarde in het behouden van taakstatus over veel bestanden, kruiscontrole van bewijs en het retourneren van een afgewerkt artefact in plaats van één geïsoleerd antwoord. Expertvalidatie, goedkeuringscontroles en least‑privilege data‑toegang blijven noodzakelijk.
Langetermijn engineering‑agents
De combinatie van Terminal‑Bench, DeepSWE, databasemigratie, computergebruik en long‑context‑resultaten maakt Astra bijzonder relevant voor repository‑schaal engineering. Een nuttig uitrolpatroon is Astra een begrensde ontwikkelomgeving te geven, een issue of migratiedoel, tests en tooltoegang; evalueer vervolgens succes op kwaliteit van de samengevoegde taak, aantal mislukte iteraties, tijd voor menselijke review en totale kosten. Dit is een betere productiemetric dan één enkele codebenchmarkscore.
Beperkingen van GPT-6 Astra
Premie per token. Astra kost 2,5× GPT-5.6 Sol per token bij Standard short‑context‑tarieven, dus routinematige chat, classificatie, extractie en eenvoudig opstellen zijn vaak economisch ongunstig.
Lange context kent een toeslag. Verzoeken met meer dan 272K inputtokens gaan naar hogere tarieven voor het volledige verzoek, dus “1,05M context” moet niet worden opgevat als vlakgeprijsd geheugen.
Geen native audio‑ of video‑invoer op het model. Astra accepteert tekst en afbeeldingen en geeft tekst uit; Gemini 3.8 Flash is flexibeler wanneer native audio/video‑begrip centraal staat in de workload.
Geen fine‑tuning. De officiële modelpagina vermeldt momenteel dat fine‑tuning niet wordt ondersteund, dus maatwerk berust op prompting, tools, retrieval en workflowontwerp.
Cyberbeveiligingsmaatregelen kunnen workflows onderbreken. OpenAI waarschuwt expliciet dat extra veiligheidscontroles legitiem werk kunnen pauzeren of stoppen in risicovollere contexten.
Geen universele benchmarkwinnaar. Claude Fable 5.1 leidt Astra op de Artificial Analysis Intelligence Index en HLE‑met‑tools‑cijfers in OpenAI’s eigen launchvergelijking.
Veelgestelde vragen
Is GPT-6 Astra officieel uitgebracht?
Ja. OpenAI is begonnen met de uitrol op 3 september 2026. Beschikbaarheid is gefaseerd over organisaties, ChatGPT‑betalende plannen, API‑toegang en AWS, en verschijnt niet op exact hetzelfde moment voor elk account.
Wat is het contextvenster van GPT-6 Astra?
De officiële modelpagina vermeldt een contextvenster van 1,05M tokens en maximaal 128K outputtokens. Verzoeken met meer dan 272K inputtokens gebruiken het long‑context prijsschema.
Hoeveel kost GPT-6 Astra?
Standaard short‑context prijzen zijn $10 input / $50 output per miljoen tokens, met $1 cached input en $12.50 cache writes. Long‑context, Batch/Flex en Fast‑mode hebben andere tarieven, dus productie‑schattingen moeten de tier gebruiken die overeenkomt met het daadwerkelijke verzoek.
Is GPT-6 Astra beter dan Claude Fable 5.1?
Dat hangt af van de workload. Astra loopt voor op verschillende evaluaties voor computergebruik, coding‑agents, wetenschap, cyber en professioneel werk, terwijl Claude Fable 5.1 Astra leidt op de Artificial Analysis Intelligence Index en HLE met tools in OpenAI’s gepubliceerde vergelijking. Gebruik je eigen agent/taak‑evaluaties in plaats van aan te nemen dat één model elke categorie domineert.
Is GPT-6 Astra AGI?
OpenAI’s officiële productpagina’s beschrijven Astra als een nieuwe generatie intelligentie en het meest capabele breed uitgerolde model, maar definiëren het product zelf niet als “AGI.” Benchmark‑verzadiging op sommige taken is niet gelijk aan een vaste, universele AGI‑definitie.
Conclusie
GPT-6 Astra moet worden begrepen als een uitvoeringsgericht frontier‑model. Het sterkste bewijs van vooruitgang is niet de minieme 60.9‑naar‑61.2 verschuiving ten opzichte van GPT-5.6 Sol op de Artificial Analysis Intelligence Index; het is de veel grotere verbetering in computergebruik, agentisch coderen, wetenschappelijke workflows, long‑context retrieval, professionele taakvoltooiing en cybersecurity. Het contextvenster van 1,05M en de diepe toolstack geven ontwikkelaars meer ruimte om agents te bouwen die nuttig blijven voorbij één enkele response.
De trade‑off is prijs. $10/$50 Standard‑prijzen zijn premium, long‑context‑verzoeken kosten meer, en onafhankelijke tests tonen dat Astra significant duurder kan zijn dan Sol op algemene‑intelligentie‑workloads. Het model verdient die premie wanneer betere voltooiingspercentages en minder menselijke correctie zwaarder wegen dan tokenkosten. Voor eenvoudigere of grootschalige workloads blijven GPT-5.6, Claude Fable 5.1 en vooral Gemini 3.8 Flash relevante alternatieven in plaats van verouderde voorgangers.