Bouwen met CometAPIHeb je één API voor meerdere modellen nodig?Test de workflow in Playground en maak daarna een API-sleutel aan wanneer het model en de kosten passen bij je use case.
Ontdek de specificaties van MiniMax M3, de 1M-tokencontext, sparse attention, multimodale mogelijkheden, benchmarkprestaties, API-tarieven en modelvergelijkingen.
MiniMax M3 is MiniMax’ frontier‑model voor coderen, agentisch werk, redeneren met lange context en multimodale verwerking. Het werd op 1 juni 2026 officieel uitgebracht en combineert drie capaciteiten die MiniMax als de kern van de release positioneerde: een contextvenster tot 1M tokens, native beeld-/videoverwerking en langlopende agentuitvoering.
Het open‑weight model heeft . Dat impliceert dat slechts circa 5,4% van de bekendgemaakte parametercapaciteit actief is per typisch token, wat helpt te verklaren hoe een zeer groot model praktisch kan blijven tijdens inferentie. M3 introduceert ook , een blockgewijs sparse‑attention‑ontwerp voor contexten van een miljoen tokens.
Voor ontwikkelaars is M3 beschikbaar via de API en open‑weight distributie van MiniMax, en tevens via CometAPI voor teams die één interface willen voor MiniMax en andere modelproviders.
Key Takeaways
MiniMax bracht M3 uit op 1 juni 2026 als een frontier‑model gericht op coderen, agents, lange context en multimodaliteit.
MiniMax demonstreerde bijna 12 uur autonome paperreproductie en ongeveer 24 uur CUDA‑kerneloptimalisatie met 1.959 tool‑aanroepen.
De API ondersteunt configureerbaar redeneren en tekst, beeld, video, function tools, standaard-/prioriteitsservicelagen en prijzen voor lange context.
What Is MiniMax M3?
MiniMax M3 is de opvolger van de M2‑generatie en vertegenwoordigt een grotere architecturale verschuiving dan een normale puntupdate. MiniMax M2.7 was al gepositioneerd rond software‑engineering in de praktijk, kantoorproductiviteit en agent‑workflows, maar M3 voegt een nieuw sparse‑attention‑ontwerp toe, native multimodale pretraining en een doel van een miljoen tokens context.
M3 als frontier multimodaal coderingsmodel met een 1M‑contextvenster. De officiële open‑weight repository voegt de belangrijkste schaalcijfers toe: ongeveer 428B parameters in totaal en 23B geactiveerd. Het bijbehorende MSA‑technische rapport beschrijft de architectuur als opererend in een Mixture‑of‑Experts‑setting, wat consistent is met het bekendgemaakte verschil tussen totale en actieve parameters.
Dit maakt M3 minder interessant als “een grotere M2.7” en interessanter als een convergentiemodel. Het brengt repository‑schaalcontext, coderen, multimodale perceptie, computergerichte agents en lokale/open uitrol samen in één systeem. MiniMax kaderde die combinatie expliciet als de belangrijkste differentiator van de release in plaats van te claimen dat M3 elke benchmark wint.
MiniMax M3 Specifications
Specification
MiniMax M3
Release date
1 juni 2026
Model size
~428B totale parameters; ~23B geactiveerd
Architecture
Sparse Mixture-of-Experts met MiniMax Sparse Attention (MSA)
Context window
Tot 1M tokens; via de API gegarandeerd minimum 512K
Input modalities
Tekst, afbeelding, video
Output
Tekst
Reasoning control
Denken aan/adaptief of uitgeschakeld via API-parameters
Maximum generation
Aanbevolen 128K; API‑documentatie staat tot 512K max_completion_tokens toe
Tool use
Functietools; agentgerichte workflows
Weights
Open‑weight release op Hugging Face / GitHub instructies
De API‑documentatie van MiniMax vermeldt M2.7 met een contextlaag van 204.800 tokens, terwijl M3 naar de klasse van een miljoen tokens verschuift. Het grotere verschil is kwalitatief: M3 accepteert visuele en video‑invoer direct, terwijl de M2.x API tekst‑ en tool‑georiënteerd blijft.
What Is New in MiniMax M3?
A 428B Model with About 23B Parameters Active
De publieke M3‑repository stelt dat het model ~428B totale parameters en ~23B geactiveerde parameters heeft. In praktische termen is het bekendgemaakte actieve aandeel ongeveer 5,4%. Dat is de basis van een sparse expert‑architectuur: de totale capaciteit kan zeer groot zijn terwijl het rekenpad voor een gegeven token slechts een fractie van het model gebruikt.
Alleen het aantal parameters bepaalt de kwaliteit niet, en “428B” moet niet gelezen worden als 428B dichte parameters die voor elk token worden geëvalueerd. De nuttigere interpretatie is dat M3 een grote pool aan modelcapaciteit heeft, gekoppeld aan conditionele activatie en een attentiesysteem dat is ontworpen om de kosten van lange context beheersbaar te houden.
MiniMax Sparse Attention: Making 1M Context Practical
De centrale architecturale verandering is MiniMax Sparse Attention (MSA). Volledige softmax‑attention groeit kwadratisch met de sequentielengte, wat duur wordt wanneer agentgeschiedenissen, code‑repositories, toollogs, afbeeldingen en lange documenten oplopen tot honderdduizenden tokens.
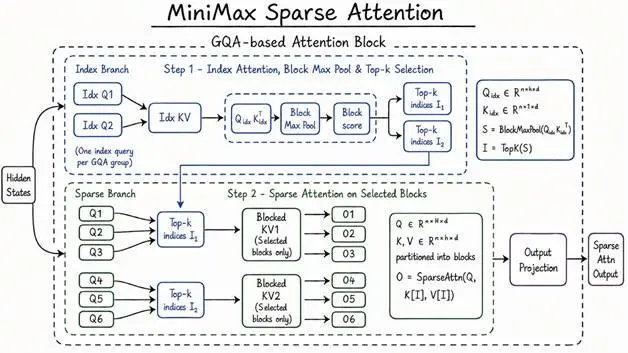
MSA voegt een lichte Index Branch toe die key‑value‑blokken scoort en voor elke grouped‑query attention‑groep een top‑k subset selecteert. De hoofdbranche voert vervolgens exacte blok‑sparse attention uit op alleen die geselecteerde blokken. Het technische rapport van MiniMax beschrijft dit als een hardware‑georiënteerd ontwerp bedoeld om kwaliteit te behouden terwijl de hoeveelheid context die door volledige attention moet worden verwerkt, wordt beperkt.
Bij 1M context meldt MiniMax dat M3 ongeveer 1/20 van de per‑token compute van de vorige generatie gebruikt en meer dan 9× prefill‑versnelling en meer dan 15× versnelling bij decoderen ten opzichte van M2 levert. Het afzonderlijke MSA‑paper rapporteert aanvullende gecontroleerde experimenten op een 109B MoE‑testmodel, dus die papercijfers moeten niet worden verward met de productiecijfers M3‑vs‑M2.
Dat onderscheid is belangrijk. Het paper valideert het attentiemechanisme in een onderzoekssetting; de M3‑lanceringscijfers beschrijven het productiemodel. De twee resultaten wijzen in dezelfde richting, maar het zijn niet dezelfde benchmarks.
Native Multimodality from Step 0
M3 wordt niet gepresenteerd als een tekstmodel met een afzonderlijke visuele adapter die achteraf is toegevoegd. MiniMax stelt dat het vanaf stap 0 multimodaal is getraind en zijn pretraining‑datapijplijn opnieuw heeft opgebouwd om interleaved multimodale data te vergroten.
De productie‑API ondersteunt tekst-, beeld‑ en video‑invoer. Dit is belangrijk voor coderen en agentwerk omdat veel echte taken niet alleen tekstueel zijn: debuggen kan een screenshot vereisen, frontendwerk kan vergelijking met een referentie‑afbeelding vereisen, onderzoek kan grafieken en vergelijkingen omvatten, en computergebruikende agents werken via visuele interfaces.
Een nuttige manier om over de multimodaliteit van M3 na te denken is daarom niet “het kan een afbeelding beschrijven”, maar “visuele status kan binnen dezelfde langlopende redeneerloop blijven als code, tooluitvoer, documenten en gebruikersfeedback.”
Interactive Coding and Agent Training
MiniMax stelt dat klassieke coderingsbenchmarks te single‑turn zijn om weer te geven hoe ontwikkelaars daadwerkelijk werken. Voor M3 bouwde het een interactieve gebruikerssimulator die het model blootstelt aan het verhelderen van requirements, het bespreken van oplossingen, feedbackgestuurde correctie, taakwisseling en meer‑ronde projectiteratie.
Het doel is de verschuiving van passieve instructie‑uitvoering naar samenwerking. Een effectieve coderingsagent moet een taak kunnen ontleden, tools kunnen aanroepen, fouten kunnen interpreteren, een plan kunnen herzien, eerdere beslissingen kunnen behouden en doorgaan na het eerste plausibele antwoord. M3’s lange context en tool‑georiënteerde training zijn precies rond die lus ontworpen.
Long-Horizon Autonomous Execution
MiniMax’ meest overtuigende M3‑demonstraties zijn geen chatvoorbeelden. Het zijn langlopende taken waarin het model status moet behouden en moet blijven verbeteren na herhaalde toolfeedback.
Task
Autonomous runtime
Evidence of persistence
Reported result
ICLR paper reproduction
Bijna 12 uur
18 commits; 23 experimentele figuren
Kernexperimenten gerepliceerd
FP8 GEMM kernel optimization
~24 uur
147 benchmarkinzendingen; 1.959 tool‑aanroepen
7,6% → 71,3% piekbenutting; 9,4× versnelling
PostTrainBench model training
12‑uur taakvenster
Datasynthese → training → evaluatie → iteratie
Score 0.37; achter Opus 4.7 en GPT‑5.5, vóór andere modellen in MiniMax‑rapport
In de taak voor paperreproductie draaide M3 bijna 12 uur en produceerde 18 commits plus 23 experimentele figuren. De taak combineerde paperlezen, begrip van grafieken/formules, code schrijven, experimenten en iteratieve interpretatie.
In de CUDA‑optimalisatietaak voltooide M3 147 benchmarkinzendingen en 1.959 tool‑aanroepen over circa 24 uur, en verhoogde uiteindelijk de gerapporteerde Hopper FP8‑piekbenutting van 7,6% naar 71,3% voor een 9,4× versnelling zonder menselijke tussenkomst. Het opvallende is niet alleen de uiteindelijke versnelling; MiniMax zegt dat de beste oplossing van het model verscheen bij de 145e inzending, na meerdere plateaus.
Benchmark Performance of MiniMax M3
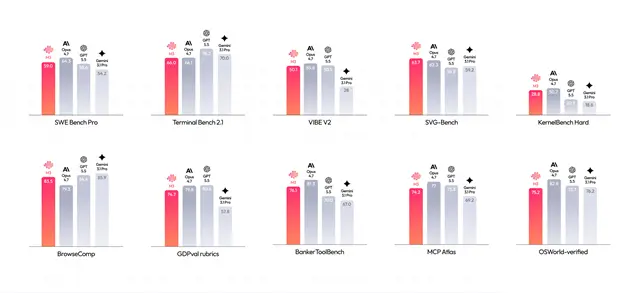
MiniMax’ lanceringsbenchmarkgrafiek vergelijkt M3 met Claude Opus 4.7, GPT-5.5, en Gemini 3.1 Pro over coderen, terminal, browsen, kantoor, tool‑gebruik en computergebruik. Dit zijn de meest bruikbare directe vergelijkingen omdat ze in hetzelfde M3‑releasepakket zijn gepubliceerd.
Alle scores in deze tabel zijn overgenomen uit MiniMax’ officiële M3‑lanceringsgrafiek. Ze moeten worden gelezen als door de leverancier gerapporteerde lanceringsresultaten, niet als een nieuwe onafhankelijke heruitvoering door CometAPI.
What the Benchmark Results Actually Show
Ten eerste is M3 werkelijk competitief in software‑engineering. Op SWE‑Bench Pro scoort het 59,0, boven de 58,6 en 54,2 die MiniMax rapporteert voor GPT‑5.5 en Gemini 3.1 Pro, maar onder Claude Opus 4.7 met 64,3. KernelBench Hard vertelt een vergelijkbaar verhaal: M3 op 28,8 ligt dicht bij Opus 4.7 op 30,7 en aanzienlijk boven de andere twee waarden in MiniMax’ grafiek.
Ten tweede is terminaluitvoering niet M3’s sterkste relatieve resultaat. Terminal‑Bench 2.1 plaatst M3 op 66,0, praktisch gelijk aan Opus 4.7 op 66,1 maar ver achter GPT‑5.5 op 78,2 en Gemini 3.1 Pro op 70,0.
Ten derde is M3 sterk maar niet dominant in informatieverzameling. BrowseComp is 83,5: hoger dan de 79,3 van Opus 4.7, maar iets onder GPT‑5.5 op 84,4 en Gemini 3.1 Pro op 85,9. MCP Atlas op 74,2 bevindt zich ook dicht bij de 75,3 van GPT‑5.5 en de 77,0 van Opus 4.7.
Ten vierde geeft de lanceringsgrafiek M3 een bijzonder goed resultaat op SVG‑Bench: 63,7 versus 62,3 voor Opus 4.7, 58,2 voor GPT‑5.5 en 59,2 voor Gemini 3.1 Pro. Dat past bij het bredere M3‑ontwerp: native visueel begrip is bedoeld om direct deel te nemen aan coderings‑ en agent‑workflows in plaats van een aparte visuele functie te blijven.
De algemene conclusie is daarom genuanceerder dan “M3 verslaat gesloten modellen.” M3 komt in dezelfde prestatieband op veel agentische taken, wint geselecteerde evaluaties en verliest andere. De differentiator is wat die scores vergezelt: open weights, multimodale training, een ontwerp voor een context van een miljoen tokens en agressieve serving‑economics.
MiniMax M3 vs Claude Opus 5 vs GPT-5.6 Sol vs Gemini 3.7 Flash
MiniMax M3 werd gelanceerd in een snel bewegende markt, en de oorspronkelijke vergelijkingsset is niet langer het nuttigste referentiepunt. Een relevantere vergelijking met de huidige generatie is Claude Opus 5, GPT‑5.6 Sol en Gemini 3.7 Flash — nieuwere gesloten modellen gericht op coderen, agents en multimodaal werk. Omdat deze modellen niet onder één identiek harnas zijn geëvalueerd, benadrukt de tabel gedocumenteerde capaciteiten en gebruikt benchmarkcijfers alleen waar de metric rechtstreeks is gerapporteerd.
Het duidelijkste voordeel van M3 is de uitrolkeuze. Noch de benchmarkgrafiek, noch het aantal parameters alleen verklaart waarom ontwikkelaars om het model zouden geven. M3 combineert open weights met een contextlengte en multimodale mogelijkheden die normaal geassocieerd worden met gehoste frontier‑systemen. Dat maakt het aantrekkelijk wanneer teams lokale uitrol, onafhankelijkheid van providers, gespecialiseerde serving of diepe controle over de inferentiestack nodig hebben.
Het tweede voordeel is de kostenarchitectuur voor lange context. MSA is expliciet ontworpen om te voorkomen dat attention‑compute explodeert op de schaal van een miljoen tokens. Dit maakt 1M‑tokenaanvragen niet goedkoop in absolute zin — KV‑cache, expertuitvoering en multimodale invoer kosten nog steeds resources — maar het verandert de schaalcurve vergeleken met volledige attention.
Where Closed Models Still Lead
Dezelfde officiële benchmarkgrafiek laat zien waarom M3 niet als automatische vervanging voor elk gesloten frontier‑model moet worden gepresenteerd. Claude Opus 4.7 heeft sterkere resultaten op SWE‑Bench Pro, KernelBench Hard, GDPval, BankerToolBench, MCP Atlas en OSWorld‑Verified in MiniMax’ eigen vergelijking. GPT‑5.5 is veel sterker op Terminal‑Bench 2.1 en leidt op GDPval. Gemini 3.1 Pro ligt iets voor op BrowseComp.
Voor productieteams kunnen gesloten platforms ook volwassen veiligheidscontroles, gehoste tools, observeerbaarheid, doorvoergarantie en integraties bieden die belangrijker zijn dan open weights. M3 wordt het meest overtuigend wanneer de voordelen van uitrol en kosten onderdeel van de vereisten zijn, niet wanneer de benchmarkrang de enige maatstaf is.
MiniMax M3 API Pricing
MiniMax gebruikt momenteel twee standaard prijsniveaus voor context. De officiële prijspagina toont een “permanente 50%‑korting” van $0,30/M invoer en $1,20/M uitvoer voor aanvragen van maximaal 512K invoertokens. Aanvragen boven 512K worden getoond op $0,60/M invoer en $2,40/M uitvoer. Priority‑service is geprijsd op 1,5× de standaardlaag.
Route / tier
Input price per 1M tokens
Output price per 1M tokens
Context note
MiniMax official Standard (current discounted rate)
$0.30
$1.20
≤512K input
MiniMax official Standard long-context
$0.60
$2.40
>512K input
MiniMax official Priority (discounted rate)
$0.45
$1.80
≤512K input; priority admission
CometAPI MiniMax-M3 page
$0.48
$1.92
Unified gateway pricing shown by CometAPI
*CometAPI’s MiniMax‑M3 is $0.48/M invoer en $1.92/M uitvoer en vergelijkt dat met MiniMax’ ongedisconteerde lijsttarief van $0.60/$2.40. Omdat MiniMax’ eigen platform momenteel een aparte 50%‑korting op de standaardlaag toont, moeten ontwikkelaars het daadwerkelijke live tarief waarmee ze worden gefactureerd vergelijken, in plaats van alleen te vertrouwen op een headlinekortingspercentage.
De reden om CometAPI in deze situatie te gebruiken is dus niet per se de laagste directe promotieprijs op elk moment. De waarde ligt in een uniforme API‑ en factureringslaag wanneer een applicatie moet routeren tussen M3 en andere providers zonder afzonderlijke integraties te onderhouden.
What Can MiniMax M3 Do?
Coding and Repository-Scale Engineering
De meest voor de hand liggende use‑case van M3 is software‑engineering over grote repositories. Een context van een miljoen tokens kan veel meer code, documentatie, testuitvoer, issue‑geschiedenis en agentstatus bevatten dan het 204,8K venster van de eerdere M2‑generatie. In de praktijk stelt dat workflows mogelijk zoals multi‑file feature‑implementatie, repository‑brede refactoring, bugdiagnose, testreparatie, build/terminal‑loops, pull‑requestreview en prestatie‑optimalisatie.
De sleutel is volharding. Een coderingsagent op repository‑schaal is alleen nuttig als hij de oorspronkelijke requirements kan behouden terwijl tooluitvoer en revisies zich opstapelen. De 12‑uur‑ en CUDA‑demonstraties suggereren dat M3 is ontworpen om door te werken na tussentijdse mislukkingen in plaats van elke toolaanroep als een afzonderlijke korte taak te behandelen.
Autonomous Research and Experimentation
Het voorbeeld van paperreproductie is een goed sjabloon voor onderzoeksagents. M3 kan een paper lezen, figuren inspecteren, over formules redeneren, code genereren, experimenten uitvoeren, beoordelen of resultaten aan verwachtingen voldoen en de implementatie blijven verfijnen. Het vermogen om papertekst, code en experimentele logs in één lange context te houden, vermindert de hoeveelheid status die moet worden samengevat of extern gereconstrueerd.
Dit is ook waarom PostTrainBench relevant is. MiniMax vroeg M3 om trainingsdata te synthetiseren, basismodellen te trainen, ze te evalueren en te itereren zonder menselijke tussenkomst. M3 werd geen eerste — het eindigde achter Opus 4.7 en GPT‑5.5 in MiniMax’ rapport — maar het experiment demonstreert een vorm van onderzoeksautomatisering die complexer is dan gewone vraag‑en‑antwoord.
Multimodal Technical Analysis
Omdat M3 native afbeeldingen en video accepteert, kunnen technische workflows visueel bewijs combineren met tekst en code. Voorbeelden zijn het vergelijken van een frontend‑implementatie met een screenshot, het analyseren van grafieken in een onderzoeksartikel, het inspecteren van UI‑status tijdens computergebruik, informatie extraheren uit diagrammen, of video‑observaties combineren met een lange onderhoudslog.
De OpenAI‑compatibele API‑documentatie van MiniMax ondersteunt expliciet image_url en video_url content‑onderdelen voor M3, inclusief geüploade bestanden voor grotere video’s. Dit maakt multimodale invoer een API‑functie voor ontwikkelaars in plaats van alleen een productdemo.
Computer and Office Automation
MiniMax Code is ontworpen als een agentframework rond M3. Het bedrijf zegt dat zijn Agent Team complexe taken kan opsplitsen in meer‑fasige parallelle workflows en een Producer + Verifier‑lus kan gebruiken voor reflectie en correctie. M3’s native multimodaliteit maakt ook computergebruik‑workflows mogelijk die bewegen tussen applicaties, bestanden, spreadsheets en desktopinterfaces.
Een officieel voorbeeld is een instructie om een lokale ERP‑client te openen en factuurinformatie batchgewijs in te voeren vanuit een Excel‑spreadsheet. De belangrijke capaciteit is status over applicaties heen: de agent moet de spreadsheet begrijpen, de interface bedienen, de mapping tussen velden behouden en herstellen als de UI verandert of een actie faalt.
Long-Context Document and Knowledge Work
Een 1M‑contextvenster is voor meer dan code nuttig. Het kan grote verzamelingen contracten, beleidsdocumenten, technische specificaties, onderzoeksartikelen, incidentrapporten of klantdossiers in één werkcontext ondersteunen. Het voordeel is niet enkel “meer pagina’s”; het is het vermogen om over verafgelegen bewijs te redeneren terwijl een lange agentgeschiedenis behouden blijft.
Er blijft wel een praktische waarschuwing: maximale contextcapaciteit garandeert niet perfecte recall op elke positie, en zeer grote prompts verhogen latency en kosten. Lange context moet worden gecombineerd met retrieval, caching, gestructureerd geheugen of taaksegmentatie wanneer die aanpak de betrouwbaarheid verbetert.
Final Verdict: Is MiniMax M3 a Frontier Model?
Ja — maar de sterkste reden voor dat label is niet dat M3 elke grafiek aanvoert. Dat doet het niet.
Wat MiniMax M3 verandert is de trade‑off. Het biedt competitieve frontier‑prestaties uit de lanceerperiode en levert daarnaast open weights, een sparse‑attention‑ontwerp voor een miljoen tokens, native tekst‑beeld‑video‑training, agentgedrag over lange horizon en veel lagere API‑kosten per token dan de gesloten vlaggmodellen in de oorspronkelijke vergelijkingsset.