
Qwen3.8-Flash uitgelegd: 1M context, 6B actieve MoE-architectuur, coding- en multimodale benchmarks, prijs-prestatie, vergelijkingen en toegang via CometAPI.
TL;DR Alibaba’s Qwen3.8-Flash is een productiemodel voor hoog-volume coderen, agents, long-contexttaken en multimodale workflows. Het ondersteunt een gehoste context van 1M tokens en combineert sterke benchmarkresultaten met lage API-prijzen. Een open-weight tegenhanger, Qwen3.8-Flash-Next, is beschikbaar voor lokale evaluatie en deployment.
Belangrijkste punten
- Naamgeving: productie vs. open-weight: Qwen3.8-Flash is het gehoste productiemodel; Qwen3.8-Flash-Next is de open-weight architectuurrelease waarmee de modeldetails en benchmarks zijn gepubliceerd.
- Extreem spaarzame activatie: 125B hoofdparameters + 51B N-gram-embeddings, met slechts 6B actieve parameters per token.
- Lange context: 262K native context voor het open model, uitbreidbaar tot 1M met YaRN; de productie-route op QwenCloud biedt standaard 1M context.
- Sterke agent-gestuurde codering: Qwen rapporteert 62.5 op SWE-bench Pro, 73.9 op CoWorkBench, 73.5 op Toolathlon Verified en 91.9 op LiveCodeBench v6.
- Multimodale kracht: Qwen rapporteert 84.5 op AndroidWorld, 88.5 op RealWorldQA en 90.6 op MathVision zonder code interpreter.
- Efficiëntie: QSA haalt tot 7.6x prefill- en 4.9x decode-kernelsnelheidswinst bij 1M tokens, en Qwen rapporteert 8.6x hogere 1M-token prefill-throughput dan Qwen3.7-Plus onder een high prefix-cache-hit setup.
- Prijzen: Alibaba Cloud vermeldt momenteel US$0.15/M input en US$0.47/M output voor internationale deployment; CometAPI vermeldt US$0.12/M input en US$0.376/M output.
Officiële Qwen3.8-Flash launch-afbeelding — Alibaba/Qwen-bron
Wat is Qwen3.8-Flash?
Qwen3.8-Flash is Alibaba Qwen’s efficiency-georiënteerde productiemodel voor codering, agents, long-context kennistaken en multimodale workflows. Het model werd aangekondigd samen met een open-weight tegenhanger genaamd Qwen3.8-Flash-Next. Alibaba beschrijft het als een open-weight multimodaal MoE-model geoptimaliseerd voor capability, latency en kosten, en zegt dat de architectuur een vroege preview is van ideeën die bedoeld zijn voor Qwen4.
Het label “Flash” is belangrijk. Qwen3.8-Max is de grotere flagship-laag voor maximale capability, terwijl Qwen3.8-Flash is gebouwd om een groot deel van de nuttige coding- en agent-prestaties te leveren met aanzienlijk minder actieve compute. De release activeert 6B parameters per token, vergeleken met veel grotere actieve footprints in flagship-MoE-systemen.
Het productiemodel wordt aangeboden onder het model-ID qwen3.8-flash. QwenCloud ondersteunt OpenAI-compatibele Chat Completions en Responses API’s plus een Anthropic-compatibele interface, waardoor het model eenvoudig te integreren is in bestaande agent- en coding-stacks.
Qwen3.8-Flash vs. Qwen3.8-Flash-Next: wat is het verschil?
Qwen3.8-Flash-Next is de open-weight modelrelease. Het stelt de architectuur, modelgewichten, deployment-guidance en benchmark-suite bloot. De gewichten zijn beschikbaar op Hugging Face en ModelScope. Het open model ondersteunt een native context van 262.144 tokens en kan worden uitgebreid tot 1M met YaRN.
Qwen3.8-Flash is de productie-API-versie. In de officiële release zegt Alibaba dat de productieversie standaard een 1M-context gebruikt en officiële ingebouwde tools bevat. In de praktijk zouden developers die het gehoste model evalueren het Qwen3.8-Flash API-gedrag en de prijzen moeten gebruiken, terwijl de Flash-Next release de beste publieke bron is voor architectuur- en benchmarkdetails.
Qwen3.8-Flash-specificaties
| Specificatie | Qwen3.8-Flash / Flash-Next |
|---|---|
| Provider | Alibaba Qwen |
| Productiemodel-ID | qwen3.8-flash |
| Open-weight model | Qwen3.8-Flash-Next |
| Architectuur | Multimodal Mixture-of-Experts; GDN + QSA hybride attentie |
| Hoofdparameters | 125B |
| Geactiveerde parameters | 6B per token |
| N-gram-embeddingparameters | 51B |
| Native open-model context | 262.144 tokens |
| Uitgebreide/gehoste context | Tot 1.000.000 tokens |
| Productie-invoermodaliteiten | Tekst + beeld gedocumenteerd in officiële integratievoorbeelden |
| Open-weight modaliteiten | Tekst + visie; uitgebracht als multimodaal |
| Reasoning-controls | low / medium / xhigh in QwenCloud-voorbeelden |
| Parallelle tool-calls | Ondersteund in officiële Codex-modelconfiguratie |
| Open gewichten | Ja, voor Qwen3.8-Flash-Next |
| Lancering | Release-window 26–27 augustus 2026 |
Het belangrijkste efficiëntiecijfer is 6B geactiveerde parameters per token. De extra 51B N-gram-embeddingparameters zijn op lookup gebaseerde capaciteit; Qwen merkt op dat ze niet op dezelfde manier meetellen in het per-token matrix-multiplicatiebudget als transformergewichten.
Wat is nieuw in de Qwen3.8-Flash-architectuur?
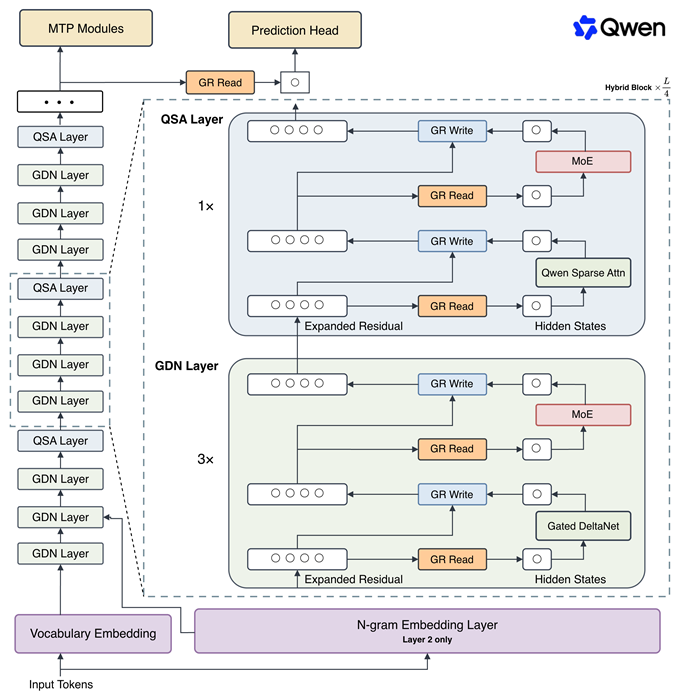
Officiële Qwen-architectuurdiagram — Qwen3.8-Flash-Next
1. GDN + Qwen Sparse Attention (QSA)
Het model mengt twee mechanismen. Drie van de vier lagen gebruiken Gated DeltaNet (GDN) om historische informatie te comprimeren in een status met vaste grootte, terwijl de resterende laag globale attentie gebruikt voor precieze retrieval. De globale-attentie-laag gebruikt vervolgens Qwen Sparse Attention om de hoeveelheid context te verminderen die direct moet worden verwerkt.
Het praktische doel is eenvoudig: GDN verzorgt goedkope geheugencompressie, terwijl QSA volledige attentie besteedt waar retrieval ertoe doet. Dit is vooral waardevol voor long-contexttoepassingen waar gewone full attention duur wordt in zowel compute als KV-cacheverkeer.
2. Gated Residual met vier informatiepaden
Gated Residual verbreedt de residual-stream tot vier parallelle takken. Een dynamische elementgewijze gate regelt hoeveel informatie wordt gelezen uit en geschreven naar elke tak. Dit geeft vroege informatie meer manieren om diepe netwerken te doorstaan in plaats van steeds weer in één stream te worden gemengd. Qwen zegt ook dat de residual-status in FP8 kan worden opgeslagen om het geheugentraffic te verminderen.
3. N-gram-embeddings voegen capaciteit toe zonder proportionele compute
Qwen voegt 51B N-gram-embeddingparameters toe die worden aangesproken met lokaal tokencontext. In tegenstelling tot normale transformergewichten worden deze parameters opgehaald via lookup-operaties en kunnen ze worden offloaded naar hostgeheugen met asynchrone prefetching. Het ontwerp vergroot de modelcapaciteit terwijl de per-token rekenlast laag blijft.
4. Muon-optimizer en trainco-design
Qwen traint het model met de Muon-optimizer voor kern 2D linear-map gewichten, terwijl AdamW behouden blijft voor embeddings, routers en geselecteerde low-rank parameters. Het team paste ook de scaling law aan voor de nieuwe architectuur en rapporteert dat batch-size warmup onnodig was, waarmee in hun experimenten 18.8% extra optimizer-stappen werden vermeden.
5. Ultra-sparse MoE en multi-token prediction
Het model behoudt een grote expertpool maar routeert slechts een klein aantal experts per token. Het gebruikt ook multi-token prediction, wat speculatieve decodering helpt door de acceptatiegraad te verhogen en tegelijkertijd de backbone tijdens training te verbeteren. Samen versterken deze keuzes hetzelfde ontwerpdoel: meer capaciteit en throughput zonder op elke token de compute van een flagship-model te betalen.
Qwen3.8-Flash benchmarkprestaties
Coding-benchmarks
Alibaba publiceert de benchmark-suite onder Qwen3.8-Flash-Next, de open-weight tegenhanger van de productieversie Qwen3.8-Flash. De volgende tabellen gebruiken door Qwen gerapporteerde releasescores en richten zich op peers die ook beschikbaar zijn via CometAPI.
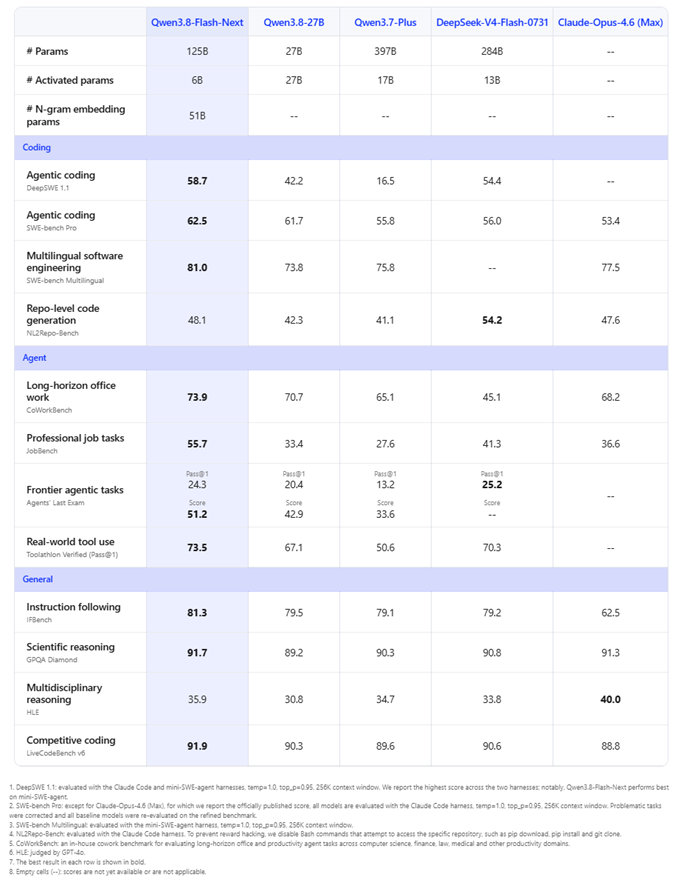
Officiële Qwen-taalbenchmarkgrafiek
| Benchmark | Qwen3.8-Flash | DeepSeek V4 Flash | Claude Opus 4.6 |
|---|---|---|---|
| DeepSWE 1.1 | 58.7 | 54.4 | — |
| SWE-bench Pro | 62.5 | 56.0 | 53.4 |
| SWE-bench Multilingual | 81.0 | — | 77.5 |
| NL2Repo-Bench | 48.1 | 54.2 | 47.6 |
| CoWorkBench | 73.9 | 45.1 | 68.2 |
| JobBench | 55.7 | 41.3 | 36.6 |
| Toolathlon Verified | 73.5 | 70.3 | — |
| IFBench | 81.3 | 79.2 | 62.5 |
| GPQA Diamond | 91.7 | 90.8 | 91.3 |
| HLE | 35.9 | 33.8 | 40.0 |
| LiveCodeBench v6 | 91.9 | 90.6 | 88.8 |
Coding-resultaat: Qwen3.8-Flash leidt de geselecteerde peers op SWE-bench Pro (62.5), SWE-bench Multilingual (81.0) en LiveCodeBench v6 (91.9). De belangrijkste uitzondering is NL2Repo-Bench, waar DeepSeek V4 Flash 54.2 scoort tegenover 48.1.
Agent-resultaat: Qwen3.8-Flash noteert 73.9 op CoWorkBench en 55.7 op JobBench, materieel boven de geselecteerde peers in Qwen’s releasetabel. Het model gaat ook nipt DeepSeek V4 Flash voorbij op Toolathlon Verified, 73.5 versus 70.3.
Reasoning-resultaat: Het veld ligt dichter bij elkaar. Qwen3.8-Flash scoort 91.7 op GPQA Diamond, dicht bij Claude Opus 4.6 met 91.3 en DeepSeek V4 Flash met 90.8. Op HLE leidt Claude Opus 4.6 met 40.0 tegenover Qwen’s 35.9.
Multimodale benchmarks
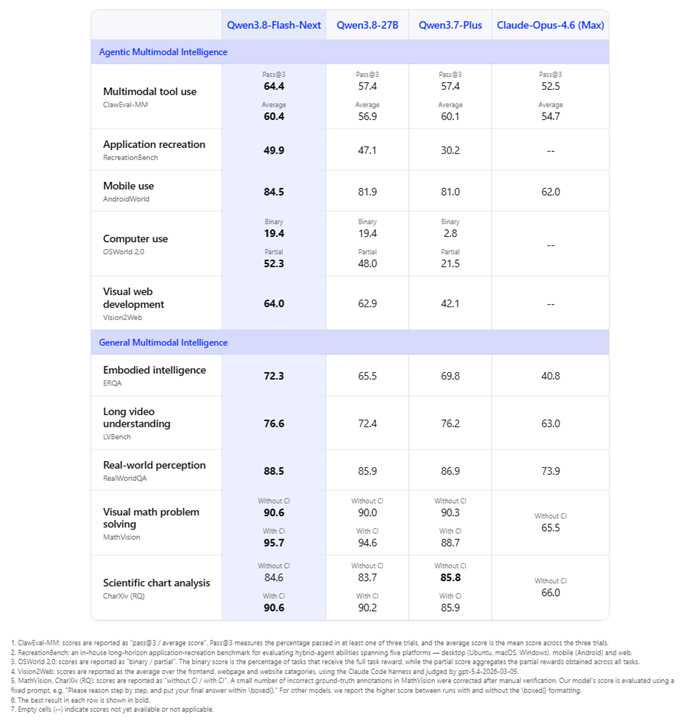
Officiële Qwen vision-language benchmarkgrafiek
| Benchmark | Qwen3.8-Flash | Claude Opus 4.6 |
|---|---|---|
| ClawEval-MM (Pass@3 / Avg) | 64.4 / 60.4 | 52.5 / 54.7 |
| AndroidWorld | 84.5 | 62.0 |
| ERQA | 72.3 | 40.8 |
| LVBench | 76.6 | 63.0 |
| RealWorldQA | 88.5 | 73.9 |
| MathVision (no CI / with CI) | 90.6 / 95.7 | 65.5 / — |
| CharXiv RQ (no CI / with CI) | 84.6 / 90.6 | 66.0 / — |
De multimodale releasescores zijn een van de sterkste argumenten voor Qwen3.8-Flash. Qwen rapporteert 84.5 op AndroidWorld, 88.5 op RealWorldQA en 90.6 op MathVision zonder code interpreter. Deze scores suggereren dat het model bedoeld is voor agents die schermen moeten lezen, visuele toestand begrijpen en doorhandelen in plaats van alleen beeldvragen te beantwoorden.
Benchmark-opmerking: Dit zijn door de leverancier gerapporteerde releasescores, geen neutrale head-to-head labtest. Verschillende benchmarks gebruiken verschillende harnesses of toolconfiguraties en sommige zijn in-house. Behandel de cijfers als directioneel bewijs en valideer het model vervolgens op je eigen prompts, tools, latentie-doel en acceptatiecriteria.
Waarom Qwen3.8-Flash snel en kostenefficiënt is
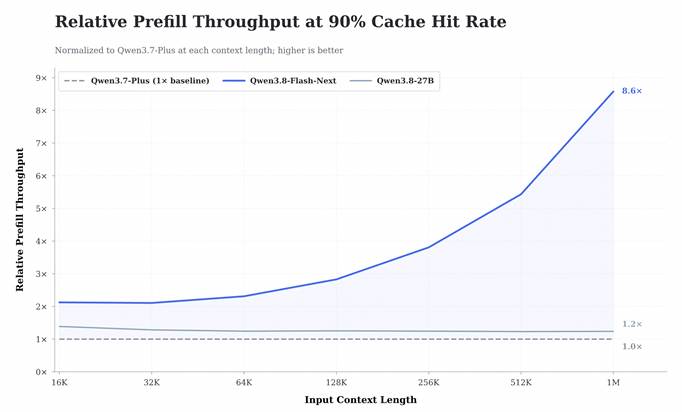
Officiële Qwen long-context efficiëntiegrafiek
Bij een context van 1M tokens rapporteert Qwen tot 7.6x snellere prefill en 4.9x snellere decode voor de QSA-attentie-kernel. In een serving-experiment met 90% prefix-cache hit rate bereikte Qwen3.8-Flash-Next 8.6x de prefill-throughput van Qwen3.7-Plus.
Het grotere system-level verhaal is actieve compute. Een 125B hoofdmodel klinkt normaal gesproken groot, maar slechts 6B parameters worden geactiveerd per token. Die actieve footprint is minder dan de helft van de 13B geactiveerde parameters die zijn gerapporteerd voor DeepSeek V4 Flash en ver onder de circa 95B geactiveerde parameters die zijn gerapporteerd voor Qwen3.8-Max. Parameter-aantallen vertalen niet lineair naar snelheid, maar het ontwerp geeft Qwen3.8-Flash een duidelijke efficiëntiedoelstelling.
Alibaba rapporteert ook dat training ongeveer één-negende van de resources van Qwen3.7-Plus vergde terwijl coding- en kantoorprestaties verbeterden. Afzonderlijk wordt gemeld dat de QwenWork Standard-modus, aangedreven door het model, het tokenverbruik per taak met 75% vermindert en de generatiesnelheid ongeveer verdubbelt ten opzichte van de vorige modus. Die productniveau-cijfers moeten niet worden gezien als universele API-latentiegaranties, maar ze laten zien hoe Alibaba verwacht dat het model wordt gebruikt.
Qwen3.8-Flash prijzen
De lanceringsaankondiging van Alibaba vermeldt QwenCloud-prijzen van $0.16 per miljoen inputtokens en $0.47 per miljoen outputtokens. Prijzen kunnen variëren per regio, productinterface, caching of latere updates, dus productieteams moeten altijd de live providerpagina controleren voordat ze een grote workload inschatten.
Op het moment dat dit artikel werd opgesteld, vermeldt CometAPI Qwen3.8-Flash op $0.12 per miljoen inputtokens en ongeveer $0.376 per miljoen outputtokens. De CometAPI-modelpagina labelt dit als een 20% korting ten opzichte van de vermelde referentieprijs.
| Route | Input / 1M tokens | Output / 1M tokens | Voorbeeld: 10M input + 2M output |
|---|---|---|---|
| QwenCloud lanceringsprijs | $0.16 | $0.47 | $2.54 |
| CometAPI vermelde prijs | $0.12 | ~$0.376 | ~$1.95 |
Voor een workload met 10 miljoen inputtokens en 2 miljoen outputtokens is de rekenkunde bij de lanceringsprijs ongeveer $2.54 op QwenCloud versus ongeveer $1.95 tegen de momenteel vermelde CometAPI-prijs. Echte agentrekeningen kunnen hoger uitvallen omdat tool-calls, retries, lange reasoning, herhaalde context en externe services kosten toevoegen. Vergelijk kosten per geaccepteerd resultaat in plaats van alleen tokenprijs.
Qwen3.8-Flash vs. Qwen3.8-Max vs DeepSeek V4 Flash
| Dimensie | Qwen3.8-Flash | Qwen3.8-Max | Gemini 3.7 Flash | DeepSeek V4 Flash |
|---|---|---|---|---|
| Positionering | Efficiëntie-eerst Qwen productiemodel | Flagship Qwen-model | Google werkpaard Flash-model | Efficiëntie-eerst tekst-MoE |
| Totaal / actieve params | 125B + 51B lookup / 6B | 2.4T / ~95B | Niet bekendgemaakt | 284B / 13B |
| Context | 1M gehost | 1M | 1,048,576 | 1M |
| Multimodaal | Tekst + visie gedocumenteerd | Tekst + beeld + video | Tekst + beeld + video + audio + PDF | Tekstgericht |
| Reasoning-controls | low / medium / xhigh | Geavanceerde reasoning / snelle modi | low / medium / high | Non-think / Think / Think Max |
| CometAPI inputprijs | US$0.12/M | US$1.60/M | US$0.60/M | US$0.176/M |
| Officiële providerprijs (input / output) | US$0.15 / US$0.47 (Alibaba Cloud international) | US$2 / US$6 (Alibaba Cloud international) | US$0.75 / US$3.75 t/m 31 dec. 2026 | Piek: US$0.44 / US$1.32; dal: US$0.22 / US$0.66 |
| Best fit | Hoog-volume codering, agents, cowork | Moeilijkste Qwen-taken, autonomie op lange termijn | Google-tool-ecosysteem, brede multimodale agents | Hoogthroughput tekstreasoning en codering |
Waar Qwen3.8-Flash wint
- Efficiëntie van actieve compute: 6B geactiveerde parameters is uitzonderlijk klein voor een model dat sterke agent-gestuurde coding- en multimodale scores neerzet.
- Waarde binnen het Qwen-ecosysteem: Qwen3.8-Flash is aanzienlijk goedkoper dan Qwen3.8-Max voor workloads die het flagship-niveau niet nodig hebben.
- Balans agent + kantoor: De release is ongebruikelijk sterk op CoWorkBench, JobBench, Toolathlon, SWE-bench Pro en multimodale agenttaken in plaats van alleen academische QA.
- Open-weight pad: Qwen3.8-Flash-Next biedt gewichten voor teams die lokale deployment, onafhankelijke evaluatie of fine-tuning nodig hebben.
Waar een ander model beter kan zijn
- Gebruik Qwen3.8-Max voor piekcapability binnen Qwen. De Max-laag heeft een veel groter actieve compute-budget en is ontworpen voor de moeilijkste long-horizon taken.
- Gebruik Gemini 3.7 Flash wanneer brede invoermodaliteit belangrijk is. Google’s Flash-model dekt expliciet audio, video, PDF en diepe Google-toolintegraties.
- Gebruik DeepSeek V4 Flash als tekst-first efficiëntie prioriteit heeft. Het wint NL2Repo-Bench in Qwen’s vergelijking en blijft een sterke kosten-georiënteerde coding-alternatief.
- Gebruik Claude Opus 4.6 wanneer premium reasoning en enterprise-werkstroomvolwassenheid de prijs rechtvaardigen. In Qwen’s releasetabel leidt het nog steeds HLE en blijft het zeer competitief op GPQA.
Beste use-cases voor Qwen3.8-Flash
Coding agents en repository-werk
Qwen3.8-Flash past goed bij issue-resolutie, refactoring, code review, repo-navigatie, testgeneratie, debugging en tool-gedreven coding-loops. De hoge LiveCodeBench- en SWE-bench Pro-resultaten suggereren dat het niet louter een low-latency chatmodel is; het is ontworpen voor meerstaps softwarewerk.
Long-context enterprise kennistaken
Een productiecontext van 1M tokens kan grote documentcollecties, codebases, logs, vergaderverslagen of langlopende agentgeschiedenis bevatten. De CoWorkBench- en JobBench-resultaten maken het model bijzonder interessant voor documentsynthese, spreadsheet/slide-workflows, onderzoeks-support, compliance-review en operationele analyse.
Multimodale agents
De scores op AndroidWorld, RealWorldQA, ERQA en MathVision wijzen richting agents die screenshots, visuele documenten, interfaces, diagrammen en real-world beelden moeten begrijpen als onderdeel van een workflow. Dit maakt het model relevant voor browseragents, UI-testing, visuele QA, documentagents en scherm-bewuste automatisering.
Hoog-volume routing
Omdat Qwen3.8-Flash veel goedkoper is dan flagship-modellen, is een praktische architectuur om het grootste deel van het productieverkeer naar Flash te routeren en alleen ambigue, risicovolle of uitzonderlijk moeilijke verzoeken op te schalen naar Qwen3.8-Max of een ander premium model. Geünificeerde gateways zoals CometAPI maken dit routeringspatroon eenvoudiger omdat de applicatie van provider kan wisselen achter één API-contract.
Beperkingen en kanttekeningen
- De benchmarks zijn zelfgerapporteerd. Sommige gebruiken door Qwen geselecteerde harnesses, in-house taken of tool-enabled settings. Onafhankelijke verificatie blijft belangrijk.
- Niet elke benchmark is een winst. DeepSeek V4 Flash leidt NL2Repo-Bench in de officiële vergelijking en Claude Opus 4.6 leidt HLE.
- Computergebruik blijft in absolute zin lastig. De release rapporteert een OSWorld 2.0 binair resultaat van 19.4, ook al is de partial-credit performance veel hoger.
- Gehost en open-weight gedrag kan verschillen. System prompts, tools, contextbeheer, quantization, serving-stack en providerupdates kunnen echte resultaten wegbewegen van de gepubliceerde Flash-Next-benchmarksetup.
- Prijzen zijn dynamisch. De lanceringsaankondiging en huidige aggregatorpagina’s kunnen licht verschillende referentieprijzen tonen. Gebruik de live endpoint-prijs bij het budgetteren.
Qwen3.8-Flash-API gebruiken met CometAPI
CometAPI biedt Qwen3.8-Flash via een OpenAI-compatibel endpoint, dus bestaande OpenAI SDK-integraties kunnen doorgaans overstappen door de API-sleutel, base URL en model-ID te wijzigen.
Waarom CometAPI gebruiken voor Qwen3.8-Flash?
CometAPI geeft developers één uniforme API-endpoint om Qwen3.8-Flash naast andere modellen te testen zonder afzonderlijke providerintegraties te onderhouden. Dit is vooral handig voor benchmarkvergelijkingen, fallback-routing en kosten gebaseerde modelselectie.
- Maak een CometAPI API-sleutel aan. Genereer een sleutel in het CometAPI-dashboard en bewaar deze in een omgevingsvariabele in plaats van in broncode.
- Gebruik de uniforme base URL. Stel de SDK base URL in op
https://api.cometapi.com/v1. - Selecteer het model. Gebruik qwen3.8-flash als model-ID.
Python
from openai import OpenAI
import os

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="qwen3.8-flash",
    messages=[
        {"role": "system", "content": "You are a precise coding assistant."},
        {"role": "user", "content": "Review this API design and identify reliability risks."},
    ],
)

print(response.choices[0].message.content)
cURL
curl "https://api.cometapi.com/v1/chat/completions" \
  -H "Authorization: Bearer $COMETAPI_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "qwen3.8-flash",
    "messages": [
      {"role": "user", "content": "Summarize the main risks in this migration plan."}
    ]
  }'
For production, add timeout handling, retry policy, token limits, structured output validation, and model-routing telemetry. If your workflow is agentic, track tool-call failures and accepted-task rate in addition to raw model latency.
Veelgestelde vragen
Is Qwen3.8-Flash open source?
De productieversie Qwen3.8-Flash is een gehoste API. De open-weight tegenhanger, Qwen3.8-Flash-Next, heeft gewichten vrijgegeven op Hugging Face en ModelScope. “Open-weight” is de preciezere term omdat gebruiksrechten afhangen van de modellincensie.
Wat is het Qwen3.8-Flash contextvenster?
Het open model ondersteunt 262.144 tokens native en kan worden uitgebreid tot 1.000.000 tokens met YaRN. Alibaba zegt dat de productie-service Qwen3.8-Flash standaard een 1M-token context gebruikt.
Hoeveel parameters heeft Qwen3.8-Flash?
De release heeft een hoofdmodel met 125B parameters, 51B N-gram-embeddingparameters en 6B geactiveerde parameters per token. De lage geactiveerde telling is cruciaal voor het efficiëntieontwerp.
Ondersteunt Qwen3.8-Flash afbeeldingen?
Ja. De release is multimodaal, de open-weight deployment-stack ondersteunt tekst en visie, en officiële integratievoorbeelden vermelden tekst- en beeldinvoer voor het gehoste model. Providerspecifieke interfaces kunnen verschillende modaliteitscombinaties aanbieden, dus controleer de huidige API-capabiliteitspagina vóór deployment.
Is Qwen3.8-Flash beter dan Qwen3.8-Max?
Niet universeel. Qwen3.8-Flash is de betere keuze wanneer latency, actieve compute en prijs belangrijk zijn. Qwen3.8-Max is de flagship-keuze voor de moeilijkste long-horizon en high-value taken. Een routeringssysteem kan beide gebruiken.
Wat kost Qwen3.8-Flash?
Alibaba kondigde $0.16/M input en $0.47/M output tokens aan voor QwenCloud bij lancering. CometAPI vermeldt momenteel ongeveer $0.12/M input en $0.376/M output. Controleer live prijzen omdat provider- en aggregator-tarieven kunnen veranderen.
Conclusie
Qwen3.8-Flash is een van de duidelijkste voorbeelden van de huidige verschuiving van “groter model” naar “betere systeemeconomie”. De 125B-hoofdruggengraat oogt groot op papier, maar het model activeert slechts 6B parameters per token en voegt capaciteit toe via lookup-stijl N-gram-embeddings. QSA, Gated Residual, ultra-sparse MoE-routing en een long-context-georiënteerd serving-ontwerp duwen allemaal in dezelfde richting: agent-gestuurde coding- en multimodale capability leveren zonder inferencekosten op flagship-niveau.
De releasescores zijn bijzonder overtuigend voor software-engineering, kantooragents, toolgebruik en visuele workflows. Tegelijkertijd is het model niet uniform superieur: DeepSeek V4 Flash wint minstens één repo-generatiebenchmark in Qwen’s eigen tabel, Claude Opus 4.6 blijft sterker op HLE en Qwen3.8-Max is nog steeds de hogere capability-laag binnen Qwen.
Voor developers is de meest praktische volgende stap om Qwen3.8-Flash te evalueren op echte taken en de kosten per geaccepteerd resultaat te vergelijken met Gemini 3.7 Flash, DeepSeek V4 Flash en de premium modellen in je routeringsstack. CometAPI biedt één OpenAI-compatibele interface voor dat soort multi-model testing en deployment.