
TL;DR
MiMo-V2.6 is Xiaomi’s nieuwe modellenfamilie met open gewichten: native multimodaal en agent-georiënteerd voor redeneren. MiMo-V2.6-Pro gebruikt een sparse MoE-ontwerp met in totaal 1,02 biljoen parameters en circa 42 miljard geactiveerde parameters per token, terwijl MiMo-V2.6-Flash 309 miljard totale parameters en circa 15 miljard geactiveerde parameters gebruikt. Beide ondersteunen een contextvenster van 1M tokens en multimodale input, inclusief tekst, afbeeldingen, video en audio.
Key Takeaways
- MiMo-V2.6-Pro is een sparse MoE-model met 1,02T parameters en circa 42B geactiveerde parameters per token; Flash heeft 309B totaal en circa 15B actieve parameters.
- Beide modellen ondersteunen een contextvenster van 1M tokens, multimodale input en tot 128K outputtokens via Xiaomi’s API.
- De familie is ontworpen voor redeneren, toolgebruik, webzoekopdrachten, gestructureerde output en agentworkflows met lange horizon.
- Xiaomi trainde V2.6 met gemengd reinforcement learning over coding, algemene agents, visuele taken en cybersecurity-omgevingen.
- Officiële resultaten positioneren Pro als de optie met hogere capaciteit en Flash als de voordelige, schaalbare optie; evaluatie per workload blijft noodzakelijk.
What Is Xiaomi MiMo-V2.6?
MiMo-V2.6 is de nieuwste generatie van Xiaomi’s MiMo-modellenfamilie. De nadruk ligt niet alleen op betere antwoorden genereren, maar op het uitvoeren van lange actiesequenties: een omgeving inspecteren, tools aanroepen, resultaten observeren, fouten corrigeren en doorgaan tot een doel is voltooid. Xiaomi kadert de release in Recursive Self-Improvement (RSI), oftewel een RL-trainingslus waarin het model herhaaldelijk omgevingen verkent, rijkere beloningssignalen ontvangt, trajecten vergelijkt en effectievere strategieën leert. Dit moet niet worden opgevat als dat het model autonoom zijn eigen opvolger herschrijft en traint.
Pro vs Flash vs UltraSpeed: What is the differnence
| Feature | MiMo-V2.6-Pro | MiMo-V2.6-Flash | MiMo-V2.6-Pro-UltraSpeed |
|---|---|---|---|
| Positioning | Vlaggenschip voor redeneren | Hoog volume / waarde | Vlaggenschip met lage latency |
| Total parameters | 1.02T | 309B | Zelfde Pro-model |
| Active parameters | 42B | 15B | Zelfde Pro-capaciteit |
| Architecture | Sparse MoE | Sparse MoE | Pro-servingmodus |
| Context | 1M | 1M | 1M |
| Max output | 128K | 128K | 128K |
| Text / image / video / audio input | Yes | Yes | Yes |
| Deep reasoning / tool calling | Yes | Yes | Yes |
| Structured output / context caching | Yes | Yes | Yes |
| Main advantage | Maximale capaciteit | Kostenefficiëntie | Tot 20× snellere serving |
MiMo-V2.6-Pro or Flash: Which One Should You Use?
Praktische keuze: kies MiMo-V2.6-Pro voor moeilijke engineeringtrajecten met lange horizon, research, cybersecurity en hoogwaardig agentwerk; kies MiMo-V2.6-Flash voor hoogvolume-automatisering, document- en multimodale verwerking en kostenkritische, herhaalde aanroepen; kies MiMo-V2.6-Pro-UltraSpeed wanneer redeneren op Pro-niveau vereist is maar latency doorslaggevend is. UltraSpeed is een serving-laag in plaats van een model met andere capaciteiten en wordt geadverteerd met tot 20× de outputsnelheid van standaard Pro.
How Does Xiaomi MiMo-V2.6 Work?
Sparse Mixture-of-Experts-architectuur
MiMo-V2.6 activeert niet zijn volledige parameterverzameling voor elke token. Het vlaggenschip-Pro-checkpoint bevat 1,02 biljoen totale parameters, maar slechts circa 42 miljard zijn actief per token. Xiaomi’s modelkaart beschrijft 70 Transformer-lagen, 384 “routed experts” en acht gelijktijdig geactiveerde experts. Flash is aanzienlijk kleiner met 309B totaal / 15B actief, met 48 Transformer-lagen en 256 “routed experts”.
| Architecture specification | MiMo-V2.6-Pro | MiMo-V2.6-Flash |
|---|---|---|
| Total parameters | 1.02T | 309B |
| Activated parameters | 42B | 15B |
| Transformer layers | 70 | 48 |
| Hidden size | 6,144 | 4,096 |
| Routed experts | 384 | 256 |
| Experts activated | 8 | 8 |
| Maximum context | 1M | 1M |
| MiMo ViT | 681M parameters | 681M parameters |
| AudioTokenizer | 308M parameters | 308M parameters |
| Audio patch encoder | 127M parameters | 127M parameters |
| Speculative decoder | 5 lagen | 5 lagen |
De architectuur combineert “sliding-window attention” met “global-attention”-lagen en bevat een vijflaags speculative decoder voor multi-token-predictie. De praktische implicatie is dat het headline-aantal parameters en de compute per token zeer verschillende grootheden zijn: sparse routing laat Xiaomi een grote expertpool behouden zonder per token dichte inferentie over alle gewichten uit te voeren.
Native multimodale ondersteuning
MiMo-V2.6 gebruikt Xiaomi’s MiMo ViT met 681M parameters voor visuele encodering, samen met dedicated audio-onderdelen. Dit geeft dezelfde agent de mogelijkheid om tekstinstructies, screenshots, foto’s, video en audio te verwerken. Voor agents die computers bedienen is native multimodaliteit belangrijk, omdat perceptie en besluitvorming binnen dezelfde redeneerlus kunnen plaatsvinden in plaats van te worden opgesplitst in losstaande, gebruikersgerichte modellen.
Why Is Reinforcement Learning So Important to MiMo-V2.6?
Xiaomi meldt dat zowel Flash als Pro ongeveer 30 RL-stappen en rond 750.000 trajecten doorliepen in een zesdaags publiek trainingsexperiment. De gerapporteerde trainingskosten waren circa $850.000 voor Flash en $2,62 miljoen voor Pro. Elke update gebruikte 1.568 trainingsvoorbeelden, met afzonderlijke trainingsstappen van ongeveer 3,5–3,7 miljard tokens. De taakmix omvatte code, algemene agents, visuele taken, cybersecurity en meerdere agent-harnesses.
Tijdens dit RL-proces meldt Xiaomi dat de out-of-sample DeepSWE v1.1-score steeg van 48,8 naar 65,7 voor Flash en van 58,4 naar 72,6 voor Pro. Deze cijfers beschrijven de live RL-experimenten en moeten niet worden verward met elke uiteindelijke benchmarkscore voor de vrijgegeven checkpoints, omdat de evaluatieopzet kan verschillen.
Groupwise agentic grading
Voor agenttraining kan een binaire pass/fail-beloning betekenisvolle verschillen tussen twee succesvolle trajecten verbergen. De ene oplossing kan snel klaar zijn met een paar toolaanroepen, terwijl een andere tientallen stappen verspilt. Xiaomi beschrijft daarom Groupwise Reward Synthesis and Groupwise Advantage Redistribution als mechanismen om trajecten binnen een groep te vergelijken en het leersignaal te herverdelen richting schonere oplossingen. Het doel is niet alleen taakvoltooiing te verbeteren, maar ook de efficiëntie van het gevolgde pad.
How Good Is Xiaomi MiMo-V2.6 on Agent Benchmarks?
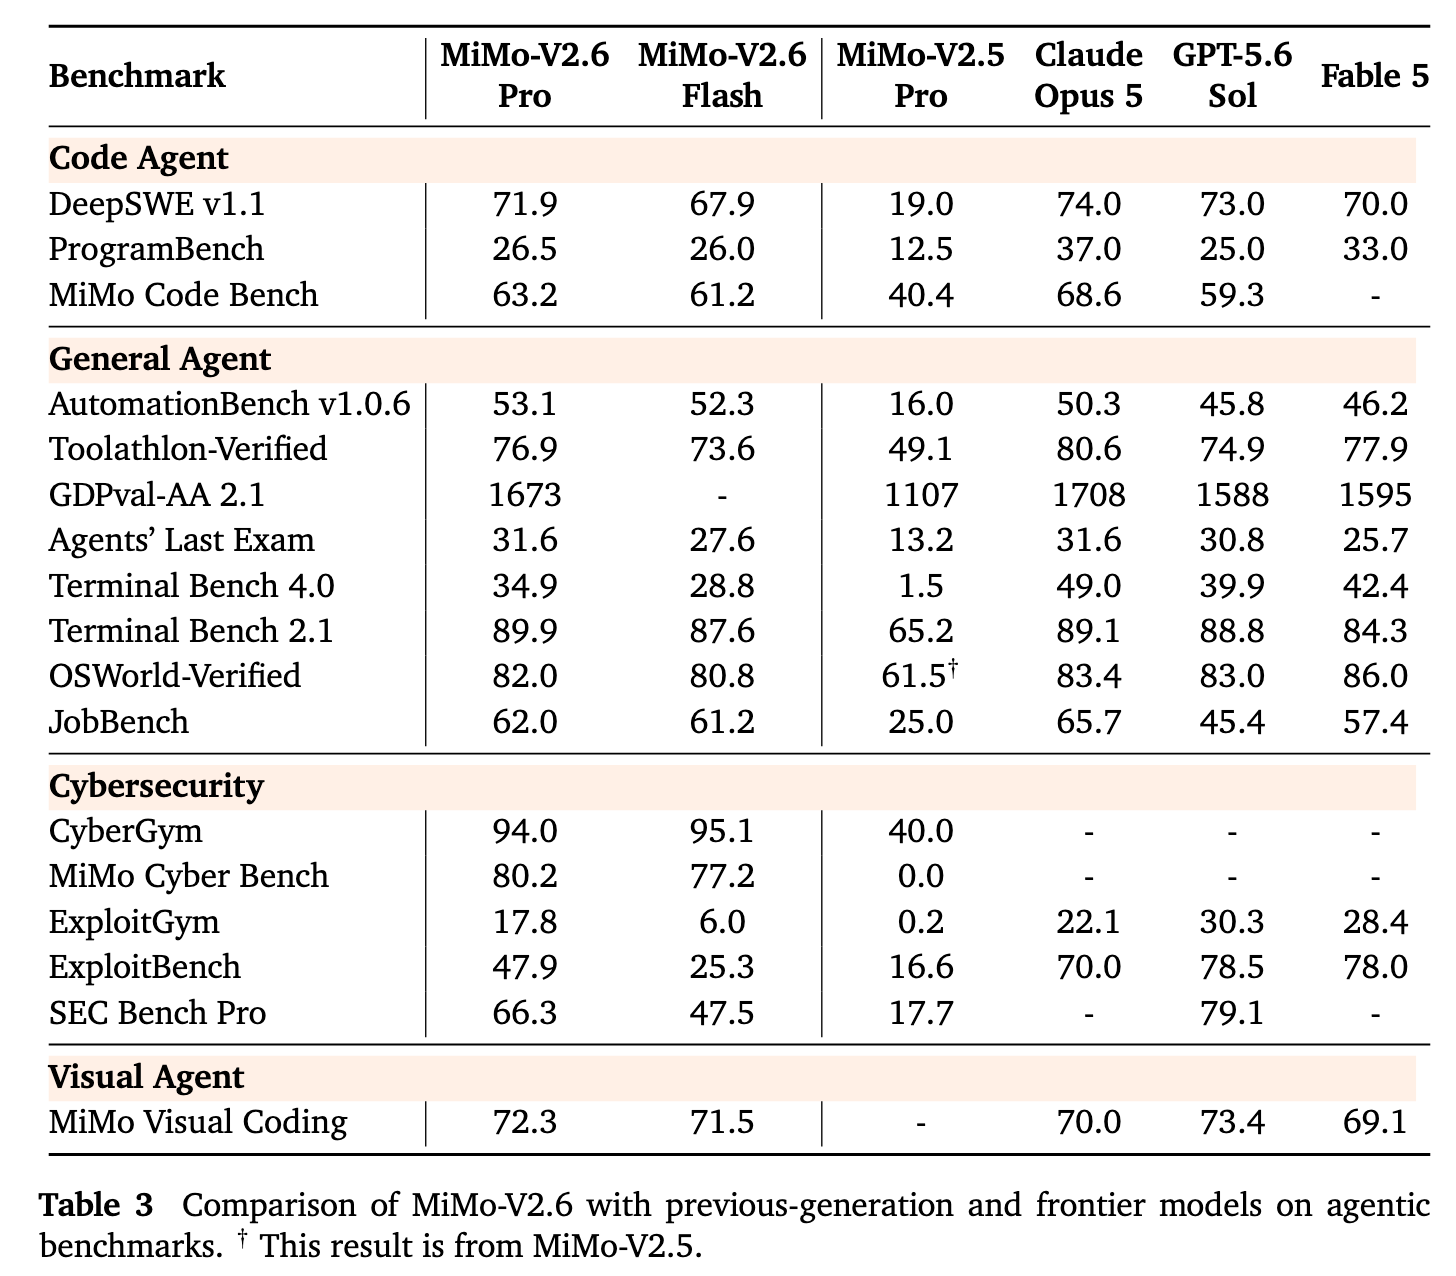
Het sterkste publieke bewijs voor V2.6 is geconcentreerd in agentgerichte benchmarks in plaats van conventionele meerkeuzetests. Xiaomi’s officiële grafiek vergelijkt Pro en Flash met MiMo-V2.5-Pro, Claude Opus 5, GPT-5.6 Sol en Fable 5 over coding-, algemene agent-, cybersecurity- en visuele agent-taken.
| Benchmark | MiMo-V2.6-Pro | MiMo-V2.6-Flash | Claude Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| DeepSWE v1.1 | 71.9 | 67.9 | 74.0 | 73.0 |
| ProgramBench | 26.5 | 26.0 | 37.0 | 25.0 |
| MiMo Code Bench | 63.2 | 61.2 | 68.6 | 59.3 |
| AutomationBench v1.0.6 | 53.1 | 52.3 | 50.3 | 45.8 |
| Toolathlon-Verified | 76.9 | 73.6 | 80.6 | 74.9 |
| Agents' Last Exam | 31.6 | 27.6 | 31.6 | 30.8 |
| Terminal Bench 2.1 | 89.9 | 87.6 | 89.1 | 88.8 |
| OSWorld-Verified | 82.0 | 80.8 | 83.4 | 83.0 |
| JobBench | 62.0 | 61.2 | 65.7 | 45.4 |
| MiMo Visual Coding | 72.3 | 71.5 | 70.0 | 73.4 |
Coding Progress
De coderingswinst is het duidelijkst bij uitvoering met lange horizon. Tijdens de live RL-run meldt Xiaomi dat out-of-sample DeepSWE v1.1 is verbeterd van 48,8 naar 65,7 voor Flash en van 58,4 naar 72,6 voor Pro. In de vrijgegeven cross-modeltabel behaalt Pro 71,9 op DeepSWE v1.1 en 63,2 op MiMo Code Bench, terwijl Flash 67,9 en 61,2 behaalt. Pro wint niet elke codingtest—Claude Opus 5 blijft voor op DeepSWE, ProgramBench en MiMo Code Bench—maar V2.6 combineert competitieve prestaties op repository-schaal met open gewichten en aanzienlijk lagere API-prijzen.
Reasoning and Agentic Progress
De vooruitgang in redeneren is beter te begrijpen als verbeterde planning, toolgebruik en herstel dan als één abstract intelligentiecijfer. Pro noteert 89,9 op Terminal Bench 2.1, 53,1 op AutomationBench en 76,9 op Toolathlon-Verified; Flash noteert 87,6, 52,3 en 73,6. Pro ligt iets voor op de vermelde resultaten van Claude Opus 5 en GPT-5.6 Sol op Terminal Bench 2.1, terwijl beide V2.6-modellen die vergelijkers aanvoeren op AutomationBench. Xiaomi schrijft de verbetering toe aan groepsgewijze trajectvergelijking, rijkere graders, training over meerdere harnesses en beloningssignalen die kortere, schonere oplossingspaden bevoordelen.
Knowledge and Research Progress
Kennisintensieve vooruitgang wordt meer ondersteund door agent-evaluaties en demonstraties dan door een conventionele kennisexamsuite. Pro evenaart Claude Opus 5 met 31,6 op Agents’ Last Exam en bereikt 62,0 op JobBench. Xiaomi rapporteert ook materialenonderzoek-workflows met literatuur- en octrooiafleiding, hypothesevorming en computationele screening, plus een Lean 4-formalisatieproject van meer dan 6.000 geverifieerde regels. Deze voorbeelden suggereren sterker retrieval, synthese, formele redenering en tool-onderbouwd kenniswerk, maar ze moeten niet worden gezien als onafhankelijk bewijs van universele kennissuperioriteit.
Overall: De vooruitgang van V2.6 is breed maar ongelijk. Het sterkste bewijs ligt bij verbeterde coding met lange horizon en agentuitvoering, terwijl claims over algemeen redeneren en kennis gekoppeld moeten blijven aan de specifieke benchmark, harness en demonstratie.
Benchmark note: Tenzij anders vermeld, zijn de onderstaande cross-modelresultaten gerapporteerd door Xiaomi in de MiMo-V2.6-modelkaart. Scores kunnen afhangen van benchmarkversies, agent-harnesses, toolconfiguraties, inferentiebudgetten en evaluatieprotocollen; ze moeten daarom niet worden geïnterpreteerd als een onafhankelijk gereproduceerde ranglijst.
MiMo-V2.6 vs MiMo-V2.5: What Changed?
| Dimension | MiMo-V2.5 generation | MiMo-V2.6 breakthrough |
|---|---|---|
| Training focus | Sterke multimodale agents, lange context en toekenefficiëntie | Veel groter gemengd RL-programma over code, algemene agents, visie, cybersecurity en meerdere harnesses |
| Agent capability | V2.5-Pro richtte zich op moeilijk werk met lange horizon | Xiaomi meldt dat V2.6-Flash V2.5-Pro allesomvattend overtreft op zijn agent-benchmarksuite |
| Learning efficiency | Eerder productiecheckpoint | Circa 750.000 trajecten over 30 RL-stappen; out-of-sample DeepSWE-winsten van ruwweg 17 punten voor Flash en 14 punten voor Pro tijdens training |
| Openness | Open gewichten en ecosysteemondersteuning | Voegt volledige RL-code toe, 7.000+ task-omgevingen, trainingsframework, lichte harnesses en een 9B-distillatiecheckpoint |
| Economics | Bestaand V2.5 API-prijsniveau | Hoger gerapporteerde intelligentie tegen dezelfde officiële API-prijzen, waardoor de capaciteit-kostengrens opschuift |
Coding and agent execution
Ten opzichte van V2.5 is de duidelijkste verandering een sterkere agentpolicy in plaats van een langer contextvenster. Xiaomi meldt dat V2.6-Flash V2.5-Pro overtreft op de eigen agent-benchmarksuite. Tijdens de V2.6-trainingsrun verbeterde out-of-sample DeepSWE v1.1 van 48,8 naar 65,7 voor Flash en van 58,4 naar 72,6 voor Pro; deze trainingsrunscores zijn niet één-op-één uitwisselbaar met de vrijgegeven benchmarktabel hierboven.
Reasoning, knowledge, and training breadth
V2.6 breidt reinforcement learning uit over coding, algemene agents, visie, cybersecurity en meerdere harnesses. Xiaomi meldt circa 750.000 trajecten over ongeveer 30 RL-stappen. Dit ondersteunt bredere planning, toolgebruik en herstel, maar bewijst op zichzelf geen universele winst op elke kennis- of redeneerbenchmark; vergelijk gelijksoortige taken en evaluatie-instellingen.
Migration and openness
De release voegt ook RL-code toe, meer dan 7.000 taakomgevingen, trainingsinfrastructuur en een 9B-distillatiecheckpoint. Het contextvenster van 1M tokens en multimodale input zijn continuïteiten vanaf V2.5, geen nieuwe V2.6-doorbraken.
De praktische verandering is dus niet een nieuwe contextomvang—de 1M-context en volledige multimodaliteit bestonden al in V2.5—maar een sterkere agentpolicy, getraind met substantieel meer reinforcement-learningcompute en bredere verifieerbare omgevingen. Xiaomi heeft aangekondigd dat de modelnamen V2.5 en V2.5-Pro op 21 oktober 2026 niet meer zullen werken, dus nieuwe implementaties moeten mikken op V2.6 en bestaande implementaties moeten migratietests plannen.
How V2.6 compares with other frontier models
| Dimension | MiMo-V2.6-Pro | Closed frontier models | Other open-weight models |
|---|---|---|---|
| Weights | Open gewichten | Doorgaans gesloten | Afhankelijk van het model |
| Verified MiMo context | 1M tokens | Raadpleeg elke officiële modelpagina | Raadpleeg elke officiële modelkaart |
| Verified MiMo modalities | Tekst, afbeelding, video, audio | Afhankelijk van provider | Afhankelijk van model |
| Agent-focused RL | Sterke nadruk in de release | Afhankelijk van model en systeem | Afhankelijk van model en checkpoint |
| Self-hosting | Ja, met substantiële infrastructuur | Meestal niet | Vaak mogelijk voor open checkpoints |
| Primary MiMo advantage | Open gewichten, native multimodaliteit, lage API-kosten | Provider-ecosysteem en beheerde tooling | Variabel per licentie, grootte en deploymentstack |
Voor een actuele vergelijkingsset, evalueer MiMo-V2.6 tegen Claude Opus 5.5 voor langdurige agentic coding, Claude Fable 5.1 voor het zwaarste autonome werk, GPT-6 Sol en Gemini 4 Pro. Modelbeschikbaarheid en prijzen zijn dynamisch, dus productievergelijkingen moeten de livecatalogus gebruiken met gelijkgezette prompts, tools, budgetten en acceptatiecriteria.
What Can Xiaomi MiMo-V2.6 Actually Do?
Coding and software-engineering agents
MiMo-V2.6 is ontworpen voor lange software-engineeringtrajecten: repositories inspecteren, code wijzigen, terminaltools gebruiken, tests draaien, fouten diagnosticeren en doorgaan tot een doel is gehaald. De resultaten op DeepSWE, Terminal Bench, AutomationBench en Toolathlon wijzen erop dat Xiaomi optimaliseert voor uitvoering in plaats van alleen codeaanvulling. Praktische workloads omvatten codingagents, geautomatiseerd debuggen, repository-refactoring, oplossen van CI-issues en engineeringworkflows met meerdere tools.
Computer use
Xiaomi demonstreert expliciet een Computer Use Agent (CUA). Het model kan grafische interfaces interpreteren, informatie ophalen, content bewerken, data verwerken, resultaten inspecteren, problemen diagnosticeren en daaropvolgende acties wijzigen op basis van visuele feedback. In deze workflow is de modeloutput vaak niet het eindproduct; het kan in plaats daarvan de volgende software- of browseractie bepalen.
3D worlds and Blender workflows
Onder het “Vibe World”-concept kan MiMo-V2.6 tekst-, beeld- of videoreferenties gebruiken en een 3D-verzoek opsplitsen in taken voor scenebouw, interactieprogrammering en visuele verificatie. Xiaomi demonstreert ook dat het model Blender kan aansturen om 3D-objecten en -scenes te creëren op basis van beschrijvingen of referentiebeelden. Dit breidt vibe coding uit voorbij applicatiecode naar interactieve omgevingen.
Robotics and embodied agents
Xiaomi demonstreert MiMo-V2.6 in een belichaamde simulatieomgeving met multiview-camerabeelden en een Franka Panda-robotarm. Voorbeeldtaken omvatten objecten grijpen, kleuren matchen en nauwkeurige plaatsing. Dit bewijst niet dat V2.6 een universeel robotica-fundamentmodel is, maar het laat zien hoe native visie en besluitvorming over lange horizon kunnen worden gekoppeld aan belichaamde regellussen.
Scientific research and formal reasoning
Xiaomi rapporteert een materiaalkunde-case waarin MiMo-V2.6-Pro onderzoekers hielp met metaal-organische raamwerken voor PFAS-adsorptie, inclusief literatuur- en octrooizoek, kandidaatselectie en aanroepen van computationele tools. In een ander experiment hielp het model bij de formalisatie van de hoofdstelling uit “Period Three Implies Chaos” in Lean 4. Xiaomi meldt een voltooid project van meer dan 6.000 regels Lean-code, geverifieerd door de Lean-kernel zonder onbewezen placeholders. Deze voorbeelden moeten worden opgevat als demonstraties van agentische onderzoeksworkflows, niet als bewijs van autonome wetenschappelijke ontdekking.
Websites, presentations, video, and music
MiMo-V2.6 kan front-end-codering, designworkflows, slides, SVG-assets, videopijplijnen en muziekproductietools coördineren. Xiaomi demonstreert orkestratie met gespecialiseerde mediasystemen, inclusief narratie via MiMo-V2.5-TTS, in plaats van te claimen dat V2.6 zelf elke image-, video- of audiogenerator vervangt. Het model past daarom natuurlijk als orkestrator voor creatieve productie.
De use-cases in deze sectie zijn Xiaomi-demonstraties, geen onafhankelijk bewijs dat elke implementatie dezelfde resultaten zal reproduceren. Productieteams moeten het model testen met hun eigen tools, permissies, herstelmechanismen en evaluatiecriteria.
How Much Does Xiaomi MiMo-V2.6 Cost?
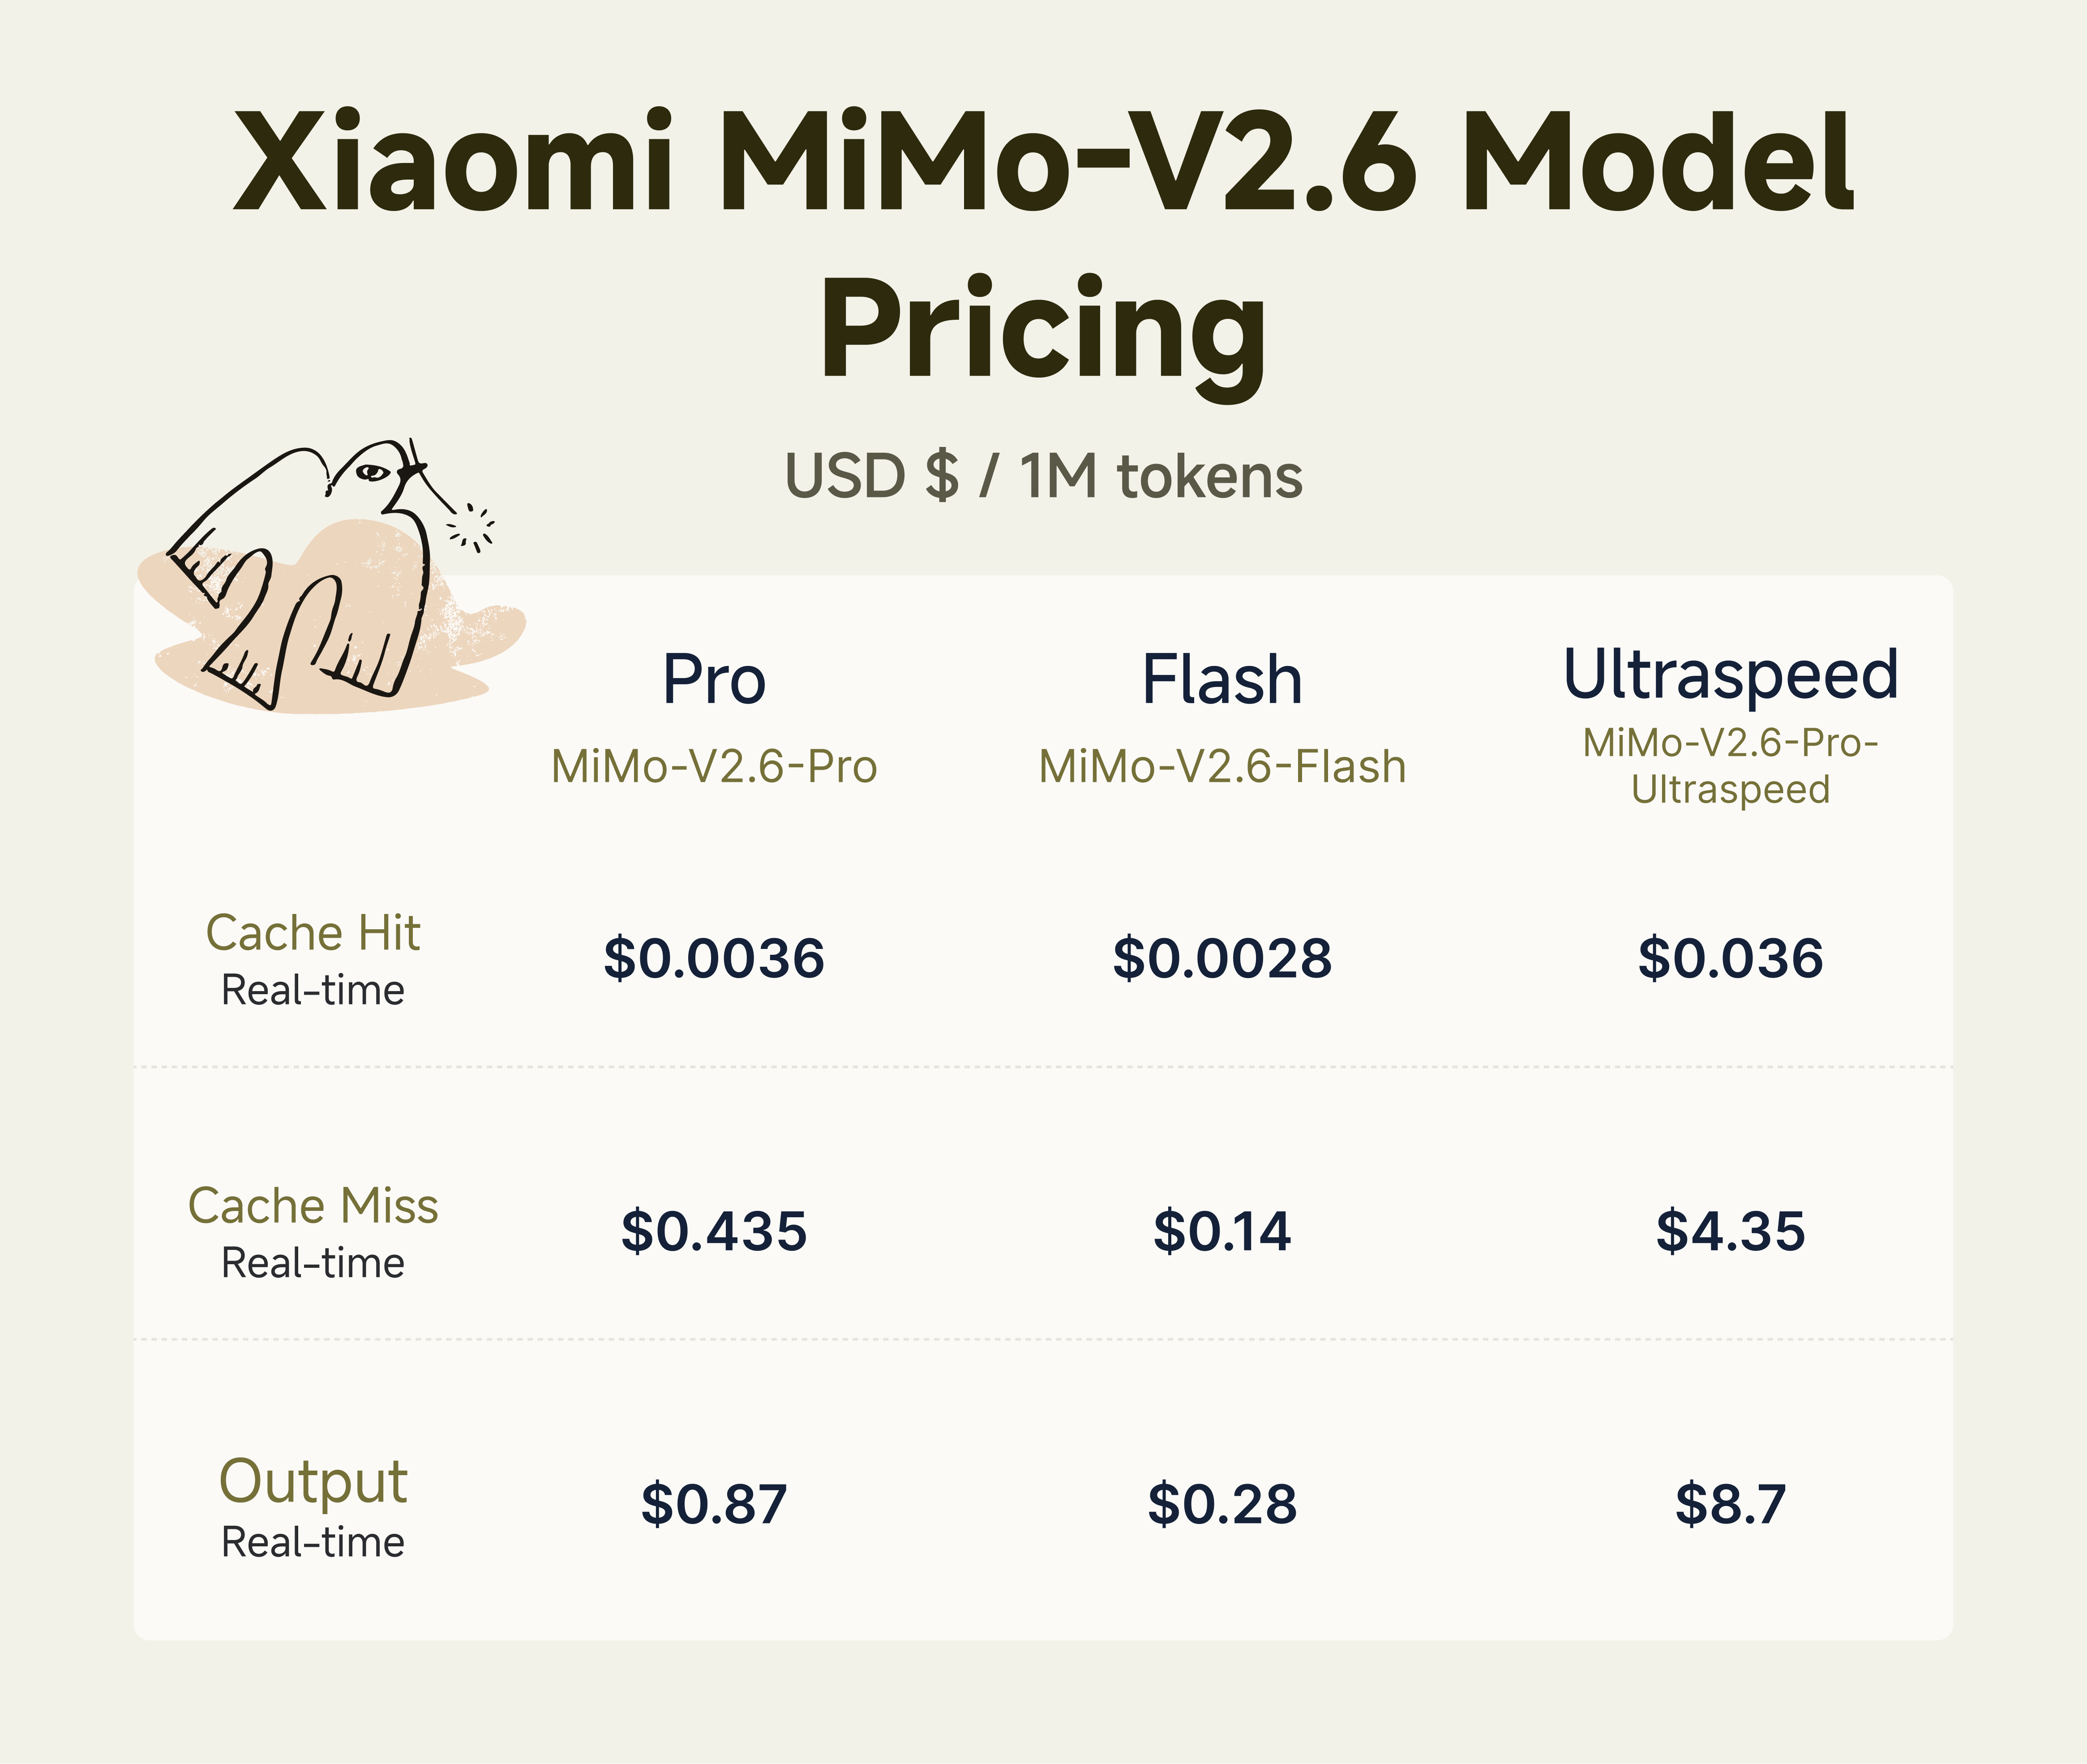
| Pricing | MiMo-V2.6-Pro | MiMo-V2.6-Flash | Pro UltraSpeed |
|---|---|---|---|
| Cached input / 1M tokens | $0.0036 | $0.0028 | $0.036 |
| Uncached input / 1M tokens | $0.435 | $0.14 | $4.35 |
| Output / 1M tokens | $0.87 | $0.28 | $8.70 |
Xiaomi houdt de V2.6-API-prijzen op hetzelfde algemene niveau als de V2.5-generatie. Flash valt vooral op voor workloads met hoog volume: de officiële Xiaomi-prijzen tonen $0,14 per miljoen niet-gecachete inputtokens en $0,28 per miljoen outputtokens.
CometAPI Pricing and Availability
| CometAPI route | Input / 1M | Output / 1M | Catalog status |
|---|---|---|---|
| mimo-v2.6-pro-ultraspeed | $3.48 | $6.96 | Beschikbaar; 20% onder de vermelde officiële tarieven (niet-gecached) |
| mimo-v2.6-pro | $0.348 | $0.6960 | Beschikbaar; 20% onder de vermelde officiële tarieven (niet-gecached) |
| mimo-v2.6-flash | $0.112 | $0.2240 | Beschikbaar; 20% onder de vermelde officiële tarieven (niet-gecached) |
How Can Developers Access Xiaomi MiMo-V2.6?
Xiaomi stelt de modellen beschikbaar via een OpenAI-compatibele API en documenteert compatibiliteit met het Anthropic-protocol op de officiële modelpagina’s. De officiële identifiers zijn mimo-v2.6-pro, mimo-v2.6-flash en mimo-v2.6-pro-ultraspeed. Xiaomi documenteert toolaanroepen, gestructureerde output, streaming, regelingen voor redeneren, context-caching en webzoek. De OpenAI-compatibele interface gebruikt thinking.type-waarden zoals enabled of disabled, met deep thinking standaard ingeschakeld voor V2.6-modellen.
Ontwikkelaars hebben drie praktische toegangspaden. Ten eerste: download het open-gewicht-checkpoint van Pro of Flash voor een self-hosted integratie, onderhevig aan substantiële servingvereisten. Ten tweede: gebruik Xiaomi’s beheerde API met een Xiaomi-sleutel en het gedocumenteerde endpoint. Ten derde: gebruik een ondersteunde CometAPI-route met een CometAPI-sleutel en base-URL; dit kan multi-model-evaluatie en facturatie vereenvoudigen. Coding-assistenten zoals Claude Code kunnen een Anthropic-compatibele route gebruiken wanneer die route en het model worden ondersteund, maar compatibiliteit moet worden getest en niet verondersteld.
Accessing MiMo-V2.6 through CometAPI
CometAPI biedt een uniforme endpoint- en facturatielaag voor ondersteunde modellen. Het belangrijkste operationele voordeel is migratie-eenvoud: teams kunnen een vertrouwde SDK behouden, de base-URL en model-ID wijzigen, MiMo vergelijken met andere frontiermodellen binnen hetzelfde account en gebruik, prijzen en beschikbaarheid centraal controleren. Dit is nuttig voor multi-modelrouting, fallbackstrategieën, geconsolideerde facturen en evaluaties die identieke prompts over providers heen nodig hebben.
CometAPI documenteert drie tekstaanvraagformaten op platformniveau: OpenAI Chat Completions, Anthropic Messages en OpenAI Responses. Voor een compatibele SDK betekent migratie doorgaans het wijzigen van de base-URL, API-sleutel en model-ID in plaats van het herschrijven van de hele applicatie. Endpoint- en parameterondersteuning kan per model variëren, dus test de exacte MiMo-V2.6-variant en het aanvraagformaat voordat u claimt dat alle drie de routes werken.
Zoals gecontroleerd op 23 september 2026, heeft MiMo-V2.6-Pro-UltraSpeed een beschikbare catalogusroute met vermelde input- en outputprijzen. De toegewijde pagina’s voor Pro en Flash tonen Coming soon in hun catalogus-snapshots, hoewel hun API-health-panelen Available zeggen. Behandel dit als een inconsistente pagina-indicatie, niet als bevestigde productie beschikbaarheid of prijsstelling. Controleer de livecatalogus, het dashboard en een testrun vóór implementatie.
Het volgende voorbeeld volgt het gepubliceerde Anthropic-SDK-patroon van CometAPI en roept de momenteel vermelde UltraSpeed-route aan. Sla de API-sleutel op in een omgevingsvariabele.
import Anthropic from '@anthropic-ai/sdk';

const client = new Anthropic({
  apiKey: process.env.COMETAPI_KEY,
  baseURL: 'https://api.cometapi.com',
});

const message = await client.messages.create({
  model: 'mimo-v2.6-pro-ultraspeed',
  max_tokens: 4096,
  messages: [{ role: 'user', content: 'Analyze this project and propose the next implementation steps.' }],
});
Is Xiaomi MiMo-V2.6 Open Source?
Xiaomi heeft modelgewichten, technisch materiaal, RL-resources, trainingsomgevingen en gerelateerde infrastructuur vrijgegeven. De release omvat meer dan 7.000 RL-taakomgevingen, variërend van software-engineering en het reproduceren van kwetsbaarheden tot kennisintensief werk en webdesign/-ontwikkeling. Xiaomi bracht ook MiMo-V2.6-Distill-Qwen-9B uit, zodat onderzoekers de RL-pijplijn op veel kleinere schaal kunnen bestuderen.
Officiële modelkaarten: MiMo-V2.6-Pro-RL | MiMo-V2.6-Flash-RL
What Are the Limitations of Xiaomi MiMo-V2.6?
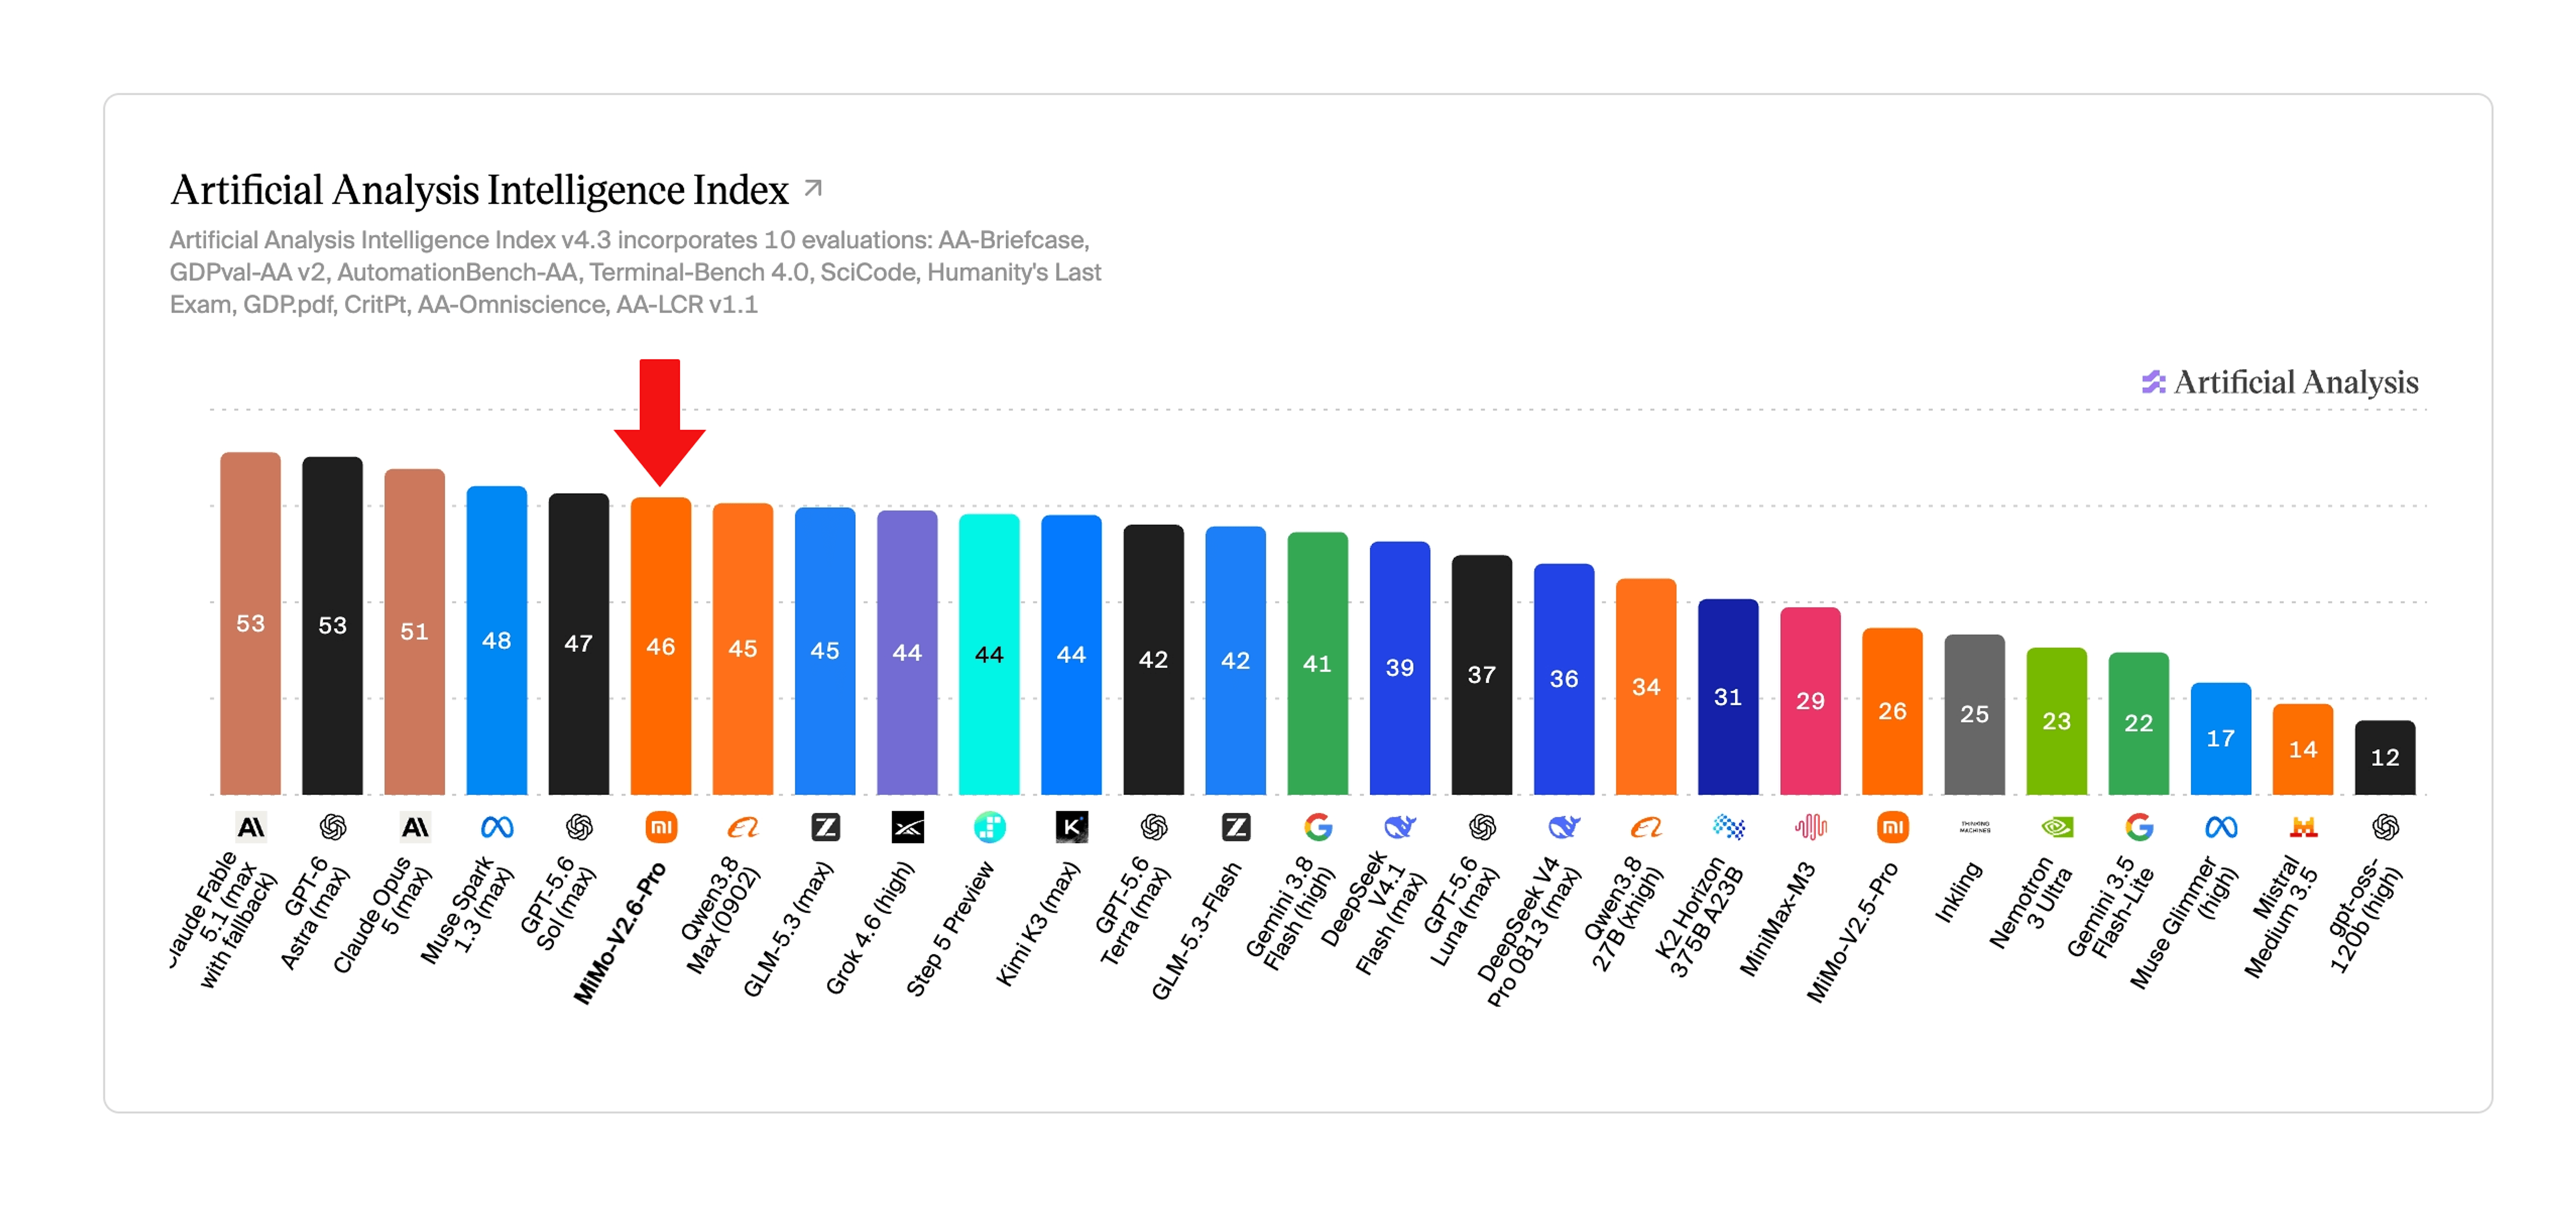
Het headlinecijfer van een biljoen parameters moet niet worden gezien als bewijs dat V2.6 universeel sterker is dan gesloten frontier-systemen. Xiaomi’s eigen benchmarktabel toont een gemengd beeld: Claude Opus 5 blijft voor op sommige code-, toolgebruik- en OS-benchmarks, terwijl GPT-5.6 Sol ook leidt op geselecteerde tests. Evaluatie per workload is daarom zinvoller dan een generiek “winnaar”-label.
Self-hosting van het volledige Pro-checkpoint is eveneens een infrastructuurintensieve taak. Open gewichten betekenen niet eenvoudige werkstationimplementatie. Bovendien zijn verschillende headline-demonstraties—onderzoek, belichaamde besturing, 3D-werelden en videoproductie—afhankelijk van externe tools en agent-harnesses. Evalueer MiMo-V2.6 als een model binnen een systeem, niet enkel als een standalone chatmodel.
Why Does Xiaomi MiMo-V2.6 Matter?
MiMo-V2.6 combineert drie belangrijke richtingen: zeer grote sparse MoE-modellen, native multimodaliteit en reinforcement learning over echte agentomgevingen. Het parametercijfer van 1,02T trekt aandacht, maar de belangrijkere ontwerpkeuze is Xiaomi’s investering in herhaalde omgevingsinteractie, trajectbeoordeling, toolgebruik en zelfcorrectie.
Als deze aanpak blijft schalen, kunnen open modellen steeds meer worden onderscheiden niet alleen door hoeveel statische kennis ze bevatten, maar ook door hoe effectief ze handelen, evalueren, herstellen en lange taken voltooien. MiMo-V2.6 moet daarom worden begrepen als een open, agent-georiënteerd fundamentmodel in plaats van simpelweg nog een chatbot met een biljoen parameters.
Conclusion
MiMo-V2.6 is een substantiële release met open gewichten, omdat het native tekst-, beeld-, video- en audio-input combineert met lange context, sparse MoE-inferentie en reinforcement learning over echte agentomgevingen. Pro past beter bij moeilijke taken met lange horizon, Flash richt zich op hoogvolume- en kostengevoelige workloads, en UltraSpeed ruilt een aanzienlijk hogere API-prijs in voor lagere latency.
De modellenfamilie is competitief op verschillende door de leverancier gerapporteerde agentbenchmarks, maar voert niet elke evaluatie aan en moet niet worden behandeld als een universele vervanging voor gesloten frontier-modellen. Het betrouwbaarste adoptiepad is MiMo-V2.6 te testen tegen de exacte tools, latencyeisen, faalmodi en kostenprofielen van de beoogde productieworkflow.
FAQ
What should teams test before moving MiMo-V2.6 into production?
Test het volledige systeem in plaats van alleen het model. Meet taakvoltooiing, nauwkeurigheid van toolaanroepen, herstel na mislukte acties, latency, tokenverbruik, contextbeheer en permissiegrenzen. Agentbenchmarks bieden oriëntatie, maar interne evaluaties moeten de daadwerkelijke repository-, browser-, document- of onderzoeksworkflow spiegelen.
Why can self-hosting MiMo-V2.6-Pro be difficult despite its sparse architecture?
Sparse activatie vermindert compute per token ten opzichte van een dense model met een biljoen parameters, maar het volledige checkpoint heeft nog steeds een zeer grote geheugen- en gedistribueerde serving-footprint. Productie-implementatie kan multinode-inferentie, expertparallelisme, gespecialiseerde kernels en zorgvuldige capaciteitsplanning vereisen.
How should developers interpret Xiaomi's cross-model benchmark table?
Behandel het als door de leverancier gerapporteerd bewijs, niet als een onafhankelijk gereproduceerde universele ranglijst. Resultaten kunnen variëren met de agent-harness, het inferentiebudget, tools, omgevingsimage, bemonsteringsmethode en benchmarkversie. Vergelijk trends over meerdere taken en reproduceer intern de meest relevante workloads.
When is MiMo-V2.6-Flash a better choice than Pro?
Flash is de sterkere standaard wanneer callvolume en kosten dominant zijn, vooral voor documentverwerking, multimodale analyse en herhaalde agentstappen. Pro is geschikter wanneer moeilijke redenering of uitvoering met lange horizon voldoende bedrijfswaarde oplevert om de hogere prijs te rechtvaardigen.
Does a 1M-token context window eliminate the need for retrieval or prompt management?
Nee. Een groter venster verhoogt de capaciteit, maar het verzenden van onnodige historie kan latency en kosten verhogen en relevant bewijs verdunnen. Retrieval, samenvatting, gestructureerd geheugen en context-pruning blijven belangrijk voor betrouwbare productie-agents.