Bygg med CometAPITrenger du ett API for flere modeller?Test arbeidsflyten i Playground, og opprett deretter en API-nøkkel når modellen og kostnaden passer bruksområdet ditt.
Hva er prompt-mellomlagring? OpenAI vs Claude vs Gemini i 2026
Lær hvordan prompt-caching fungerer i 2026. Sammenlign cachemetoder, TTL-er, priser, ytelse, Python-eksempler og CometAPI-tilgang for OpenAI, Claude og Gemini.
Prompt-caching lar språkmodeller gjenbruke tidligere prosesserte prompt-prefikser i stedet for å gjenta den samme inndata-beregningen. Det kan redusere kostnader for inndata-tokens og forbedre latens, spesielt for agentarbeidsflyter, kundestøtte, RAG og analyse av store dokumenter. I 2026 tilbyr OpenAI automatisk caching og nyere eksplisitte cache-kontroller, Claude støtter automatisk og blokk-nivå cache-brytepunkter, og Gemini vektlegger implisitt caching for sine nyeste modeller. Leverandører priser ulikt for cache-skrivinger, -lesinger og, der det er aktuelt, lagring. Utløp kan utløse en ny skriving eller en full inndatakostnad, så faktiske besparelser avhenger av gjenbruksfrekvens og målte cache-treff.
Denne guiden sammenligner prompt-caching i GPT-6.1 Sol, Claude Opus 5.5 og Gemini 4 Argon for utviklere som bygger applikasjoner med gjentatt inndata. Den fokuserer på cache-kontroller, prising og hvordan man verifiserer gjenbruk.
Gjennomgått for klarhet, kildeangivelse og gjeldende API-terminologi.
Claude-prompt-caching tilbyr 5-minutters og valgfri 1-times TTL med automatisk og eksplisitt cache-kontroll.
Gemini-kontekstcaching er implisitt på moderne modeller; eksplisitte cache-ressurser forblir modellavhengige.
Besparelser med prompt-caching avhenger av cache-skrivinger, -lesinger, lagring og faktiske treff; verifiser endepunktstøtte og fakturering av cachede tokens når du bruker CometAPI.
Hva er prompt-caching i LLM-er?
Prompt-caching er en inferensoptimalisering som muliggjør gjenbruk av beregningstilstander avledet fra et tidligere prosessert prefiks. En prompt inneholder ofte stabile instruksjoner, verktøydefinisjoner eller dokumenter etterfulgt av et skiftende brukerspørsmål. Hvis en senere forespørsel gjentar det kvalifiserte prefikset, kan leverandøren gjenbruke bufrede key-value (KV)-tilstander og kun prosessere den ikke-bufrede resten. I motsetning til respons-caching, spiller dette ikke av et tidligere svar: modellen genererer et nytt svar for den aktuelle forespørselen.
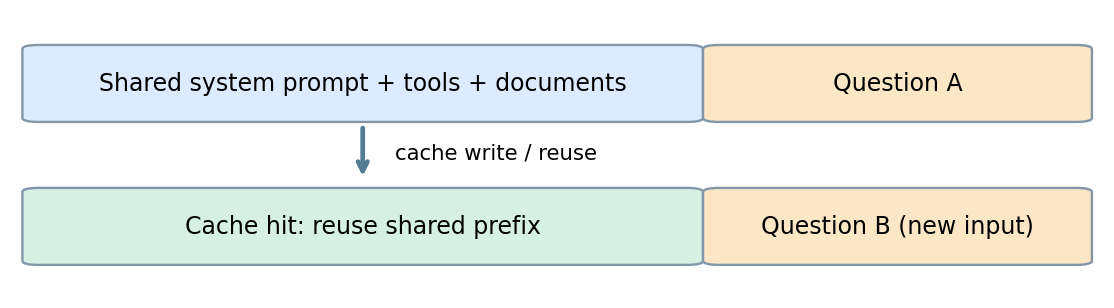
Arbeidsflyt for prompt-caching:
Første forespørsel: send et stort, repeterbart prefiks og et spesifikt spørsmål.
Opprettelse av cache: leverandøren lagrer kvalifiserte mellomliggende beregningstilstander.
Neste forespørsel: gjenbruk det identiske prefikset og bytt ut spørsmålet.
Cache-lesing: tidligere prosesserte tokens gjenbrukes, mens nye tokens prosesseres som normalt.
Konseptuell illustrasjon levert med det opprinnelige utkastet: gjentatt prompt-materiale går foran et skiftende spørsmål. Dette er ikke et offisielt arkitekturskjema fra noen leverandør.
Det felles designprinsippet er prefiksstabilitet. API-kontrakter, kvalifiserte modelfamilier, cache-levetid og gebyrer er ikke ombyttbare.
OpenAI, Claude og Gemini-caching i et blikk
Det samme prinsippet om stabilt prefiks gjelder på tvers av leverandører, men kontrollene nedenfor er spesifikke for modellene som brukes i denne guiden. Sjekk modellen og endepunktet sammen før du kopierer en innstilling.
Parameter
OpenAI: GPT-6.1 Sol
Claude: Opus 5.5
Google: Gemini 4 Argon
Cache activation
Implicit matching; explicit breakpoints supported
Opt in with request-level or content-block cache_control
Implicit caching enabled by default
Minimum prefix
1,024 visible input tokens
512 tokens before the cache boundary
4,096 input tokens
Lifetime controls
Responses API: prompt_cache_options.ttl; 30m default or 12h
5-minute default; optional 1-hour TTL
Provider-managed implicit lifetime
Where to place stable content
Leading instructions, tools, and reference material
Stable tool definitions, system content, or message blocks before the breakpoint
Large shared content at the start of the prompt
Usage to inspect
input_tokens_details.cached_tokens and reported cache-write usage
cache_creation_input_tokens and cache_read_input_tokens
cached_content_token_count in usage_metadata, when present
Important distinction
prompt_cache_key can separate accounting; it is not required for Sol's automatic routing
The breakpoint must end on content that stays unchanged
No explicit cache resource for Argon; older supported models expose a separate interface
Kontroller for prompt-caching og Python-eksempler
Hvert eksempel sender det samme referansematerialet med to forskjellige spørsmål. Hold det delte innholdet uendret, kjør forespørslene sekvensielt, og inspiser usage for å se om den andre forespørselen faktisk gjenbrukte bufret inndata.
OpenAI: Cache-kontroller og Python-eksempel
OpenAI matcher automatisk cache-kvalifiserte prompt-prefikser og, på støttede nyere modeller, tillater eksplisitt brytepunkt- og retention-konfigurasjon. Gjenbruk av cache er spesielt nyttig når lange systeminstruksjoner, verktøyskjemaer eller repository-kontekst går igjen på tvers av forespørsler. Kravet til prefikslengde og tokenpris-multiplikatorer avhenger av modellgenerasjonen og valgt retention-nivå.
Eksemplet bruker Responses API med prompt_cache_options satt til implicit-modus og 30 minutters levetid. Tidligere modellgenerasjoner bruker ulike retention-parametere; følg innstillinger for din eksakte modell.
Installer openai SDK og sett OPENAI_API_KEY. Bruk minst 1,024 synlige tokens i det stabile prefikset. Kjør begge forespørsler sekvensielt og inspiser input_tokens_details.cached_tokens og cache_write_tokens i usage. En positiv verdi for bufrede tokens bekrefter en fakturert cache-lesing; det lover ikke lavere latens på hver forespørsel.
For å kjøre eksemplene, installer relevant Python SDK, sett leverandørens API-nøkkel, og opprett en UTF-8 reference.txt-fil som inneholder nok stabilt innhold til å møte modellens caching-minimum.
from pathlib import Path
from openai import OpenAI

client = OpenAI()  # Reads OPENAI_API_KEY
shared = Path("reference.txt").read_text(encoding="utf-8")
questions = ["Summarize the architecture.", "Identify the main technical risks."]
for question in questions:
    response = client.responses.create(
        model="gpt-6.1-sol",
        instructions="Use the following reference material.\n" + shared,
        input=question,
        prompt_cache_key="docs-assistant-v1",
        prompt_cache_options={"mode": "implicit", "ttl": "30m"},
    )
    print(response.output_text)
    print(response.usage)
Claude: Cache-kontroller og Python-eksempel
I Claude Messages API er prompt-caching opt-in. Legg til cache_control på forespørselsnivå for automatisk plassering av brytepunkt, eller knytt det til en innholdsblokk for å markere et eksplisitt brytepunkt. Utviklere kan markere stabile instruksjoner, dokumenter og utvalgte promptblokker, mens senere brukerinput endres. Standard cache med kort varighet er fem minutter, med et ett-timers alternativ for passende arbeidslaster.
Installer anthropic SDK og sett ANTHROPIC_API_KEY. For Claude Opus 5.5, oppgi minst 512 tokens før cache-grensen. Hold systemblokken identisk på tvers av forespørsler. En cache-oppføring blir tilgjengelig når det første svaret starter; dette eksemplet venter på hele svaret for å gjøre demonstrasjonen enkel. Inspiser antall cache-opprettelser og -lesinger; et kort prefiks kan returnere null for begge uten å kaste en feil.
from pathlib import Path
import anthropic

client = anthropic.Anthropic()  # Reads ANTHROPIC_API_KEY
shared = Path("reference.txt").read_text(encoding="utf-8")
for question in ["Summarize the architecture.", "Identify the main technical risks."]:
    response = client.messages.create(
        model="claude-opus-5-5",
        max_tokens=1024,
        system=[{
            "type": "text",
            "text": shared,
            "cache_control": {"type": "ephemeral"},
        }],
        messages=[{"role": "user", "content": question}],
    )
    print(response.content)
    print(response.usage.cache_creation_input_tokens)
    print(response.usage.cache_read_input_tokens)
Gemini: Implisitt caching og Python-eksempel
Google kaller sin implementering kontekstcaching. Gemini 4 Argon bruker implisitt caching og støtter ikke eksplisitte cache-ressurser. Noen tidligere modelfamilier støtter eksplisitte cacher med konfigurerbar TTL. Velg caching-grensesnittet fra den individuelle modellkontrakten i stedet for å anta at alle Gemini-modeller eksponerer de samme kontrollene.
Installer google-genai og sett GEMINI_API_KEY. Bruk minst 4,096 tokens med delt ledende innhold for Gemini 4 Argon, og send den andre forespørselen kort tid etter den første. Inspiser cached_content_token_count i usage_metadata når den finnes. Implisitt caching kan misse selv når prefikset er kvalifisert.
from pathlib import Path
from google import genai

client = genai.Client()  # Reads GEMINI_API_KEY
shared = Path("reference.txt").read_text(encoding="utf-8")
for question in ["Summarize the architecture.", "Identify the main technical risks."]:
    response = client.models.generate_content(
        model="gemini-4-argon",
        contents=shared + "\nQuestion: " + question,
    )
    print(response.text)
    print(response.usage_metadata)
Hvor mye koster prompt-caching hos OpenAI, Claude og Gemini?
Cache-kostnader bør vurderes som kombinasjonen av skrivinger, lesinger og—på noen eksplisitte cache-systemer—retention eller lagring. Følgende multiplikatorer illustrerer vanlige design og er ikke universelle prisløfter på tvers av modellversjoner.
Kostnadskategori
OpenAI
Claude
Gemini
Ubufret inndata
Normal pris for inndata-tokens
Normal pris for inndata-tokens
Normal pris for inndata-tokens
Cache-skriving
Mulige påslag for nyere modeller
5m/1h-påslag
Implisitt eller eksplisitt, modellspesifikt
Cache-lesing
Redusert, modellspesifikk sats
Redusert, modellspesifikk sats
Redusert, modellspesifikk sats
Cache-levetid
Modellspesifikk
5m / 1h
Implisitt styrt / eksplisitt konfigurerbar
Ekstra lagring
Avhenger av modell
Som oftest reflektert i skrive-nivå
Eksplisitte lagringskostnader kan gjelde
Illustrerende eksempel: et prefiks på 10,000 tokens gjenbrukes på tvers av N forespørsler, den første cache-skrivingen koster 1,25 ganger ordinær inndata, og påfølgende cache-lesinger koster 0,1 ganger ordinær inndata. Anta en grunnpris for inndata på $2 per million tokens og perfekte cache-treff etter den første forespørselen.
Antall forespørsler
Uten caching
Med caching
Besparelse på gjenbrukt prefiks
10
$0.200
$0.043
78.50%
100
$2.000
$0.223
88.85%
Formel: Kostnad for bufret prefiks = 1.25P + (N − 1) × 0.1P, der P er den ordinære kostnaden for å prosessere det delte prefikset én gang. Dette eksemplet ekskluderer dynamisk inndata, utdata, utløp, bomtreff, lagring og andre tjenester.
Eksemplet over bruker en illustrerende 10% lesesats, ikke GPT-6.1 Sols nåværende sats. Sol's standardpriser for kort kontekst er $2 per million ubufrede inndata-tokens, $0.10 per million bufrede inndata-tokens og $2.50 per million tokens skrevet med standard levetid. Regn ut eksemplet på nytt med din faktiske modell, nivå og endepunktfakturering.
En lengre levetid er bare verdt det dersom den forhindrer nok gjentatte skrivinger eller ubufrede forespørsler til å oppveie prisen. Claudes 5-minutters og 1-times skrivinger faktureres til henholdsvis 1,25× og 2× basisinndata. Eksplisitte Gemini-cacher på støttede eldre modeller kan også pådra lagringskostnader. Mål gjenbruk over reelle hvileperioder, ikke bare et burst av back-to-back-kall.
Se på bomtreff, utløp og utdatagenerering som en del av regningen. Hvis et prefiks utløper før det gjenbrukes, kan neste forespørsel kreve en ny skriving eller full inndatabehandling. Korte prompt kan ikke kvalifisere i det hele tatt, mens lange svar kan gjøre utdata-tokens til den største kostnaden selv med sterk cache-gjenbruk. Sammenlign total kostnad per fullført oppgave før du legger til mer caching-kompleksitet.
Hvilket prompt-caching-API er best for ulike arbeidslaster?
For kodingagenter og kundestøtte, plasser stabile verktøydefinisjoner, repository-kontekst, retningslinjer og kunnskap foran den skiftende oppgaven. OpenAI og Claude tilbyr brytepunkt-kontroller som hjelper med å definere gjenbrukbare grenser; evaluer endepunktets faktiske cache-lesinger i stedet for å anta at gjentatt tekst ble bufret.
For dokumentanalyse og multimodalt arbeid, hold kildedokumentet eller støttede medier foran spørsmålet. Geminis implisitte tilnærming reduserer cache-administrasjonsarbeid, mens Claude lar deg markere den stabile blokken direkte. Sjekk støtte for den aktuelle mediatypen og modellen før du baserer deg på gjenbruk.
For lange samtaler, appendér nye turer i stedet for å gjenta begynnelsen, og velg en tilgjengelig levetid som passer pausene mellom turene. Hvis applikasjonen din trenger en navngitt cache-ressurs som den kan opprette og referere eksplisitt, evaluer en Gemini-modell som støtter det grensesnittet; Argon gjør det ikke.
Det finnes ingen universell vinner: sammenlign cache-treffrate, kostnad per fullført oppgave og latens under ditt faktiske trafikkmønster.
Hvordan påvirker prompt-caching latens og ytelse?
Et cache-treff reduserer gjentatt inndatabehandling og kan forkorte tiden til første token. Det forbedrer ikke i seg selv svarkvalitet eller akselererer utdatagenerering, og bufret inndata opptar fortsatt kontekstvinduet. Mål både latens til første token og total svartid på sammenlignbare forespørsler; et cache-treff alene er ikke bevis på at brukeren fikk det endelige svaret raskere.
Hvordan optimalisere prompt-caching og feilsøke bomtreff
Start med et stabilt, nyttig prefiks
Plasser gjenbrukbare instruksjoner, verktøydefinisjoner, retningslinjer og dokumenter først; legg tidsstempler, forespørsels-ID-er, skiftende kontekst og brukerens spørsmål etterpå. Hold verktøyrekkefølge og skjemaer stabile. Når du bruker eksplisitt caching, avslutt brytepunktet på den siste uendrede blokken. Legg til nyttig referansemateriale når det hjelper oppgaven; ikke blås opp hver forespørsel bare for å jakte på en cache-metrikk.
Hvis bufrede tokens forblir null
Sjekk kvalifisering før du endrer prompten: bekreft nøyaktig modell, endepunkt, minimum tokenlengde og nødvendige cache-kontrollinnstillinger. Send deretter to sekvensielle forespørsler med identisk delt innhold. Inspiser cache-opprettelser og cache-lesinger separat; den første forespørselen kan opprette oppføringen som en senere forespørsel kan gjenbruke. En implisitt cache er kvalifisert til å treffe, ikke garantert å treffe.
For Claude kan en forespørsel under minimum returnere null for både cache-opprettelse og cache-lesing uten en feil. Cache-oppføringen blir tilgjengelig når det første svaret starter. Claude-caching-veiledningen forklarer også hvordan plassering av brytepunkt og endrede forespørselsinnstillinger påvirker gjenbruk.
Hvis treff forsvinner mellom forespørsler
Sammenlign de faktiske payloadene, ikke bare prompt-malen. Se etter endret dokumenttekst, omarrangerte verktøy, endrede skjemaer, omskrevne tidlige samtaleomganger eller dynamiske felt satt inn før den gjenbrukbare grensen. Sjekk forløpt tid siden tidligere forespørsel og om valgt levetid dekker den. Endre én variabel av gangen og registrer resulterende usage.
Hvis treff ikke gir besparelser
Separér bufret inndata, skrivinger, ubufret inndata, utdata og eventuelle lagringskostnader. Gjentatte skrivinger etter hvileperioder, lav gjenbruk eller lange genererte svar kan oppveie inndatarabatter. Bruk kostnadsberegningen ovenfor med målt usage og endepunktets faktiske satser. Behold en optimalisering bare hvis den forbedrer total oppgavekostnad eller brukersynlig latens.
Sjekk endepunktstøtte og datagrenser
Et kompatibilitetsendepunkt kan akseptere en forespørsel uten å eksponere de samme cache-kontrollene eller usage-feltene som det native API-et. Bekreft parameterstøtte og sammenlign returnert usage med kontofakturering før du behandler gjenbruk som en besparelse. Hold leietakerisolasjon og tilgangskontroller på plass, og følg leverandørens retention- og datapolicyer. Caching erstatter ikke disse kontrollene.
Hvordan kan du bruke prompt-caching med CometAPI?
CometAPI tilbyr ett integrasjonspunkt for å teste forespørsler på tvers av modelfamilier. For caching, verifiser hvilke leverandørspesifikke kontroller det valgte endepunktet aksepterer og hvordan bufret inndata vises i usage og fakturering. Utviklere kan sentralisere modelltesting samtidig som de beholder separat validering for caching-atferd og regnskap, siden native leverandøralternativer ikke er garantert identiske på tvers av proxy- eller kompatibilitetsendepunkter.
For modellspesifikt oppsett, se CometAPIs sider for GPT-6.1 Sol, Claude Opus 5.5 og Gemini 4 Argon. Bekreft at det valgte endepunktet støtter caching-atferden du trenger.
Installer openai SDK og sett COMETAPI_KEY. Dette eksemplet sender forespørsler med gjentatt prefiks gjennom CometAPIs OpenAI-kompatible Chat Completions-grensesnitt. Bekreft modelltilgjengelighet, og inspiser deretter returnert usage og kontofakturering for tegn til cache-gjenbruk. Ikke kopier Responses API-cache-parametere inn i dette endepunktet uten å sjekke støtte.
import os
from pathlib import Path
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)
shared = Path("reference.txt").read_text(encoding="utf-8")
for question in ["Summarize the architecture.", "Identify the main technical risks."]:
    response = client.chat.completions.create(
        model="gpt-6.1-sol",
        messages=[
            {"role": "system", "content": shared},
            {"role": "user", "content": question},
        ],
    )
    print(response.choices[0].message.content)
    print(response.usage)
Konklusjon
For applikasjoner med hyppig gjentakelse kan prompt-caching gjøre en materiell forskjell for inferenskostnader. OpenAI gir utviklere stadig mer detaljerte prompt- og retention-kontroller; Claude tilbyr praktiske automatiske og blokk-nivå kontroller; Gemini gjør implisitt gjenbruk enkelt i moderne modeller. Riktig implementering avhenger av stabilt promptvolum, treffrate, utløp og totalkostnad. Start med et klart delt prefiks, verifiser usage-telemetri, og optimaliser deretter retention og leverandørvalg ved hjelp av målinger som ligner produksjon.
FAQ
Hvordan kan jeg sammenligne caching-leverandører rettferdig?
Spill av de samme nyttige kildedokumentene og tilsvarende spørsmål, men bruk hver leverandørs egne token-tall og faktiske priser. Hold utkravene sammenlignbare og rapporter mislykkede forespørsler så vel som vellykkede. Et fast antall tegn innebærer ikke det samme antallet tokens, så sammenlign kostnad per fullført oppgave sammen med cache-treffmålinger.
Bør jeg cache hvertt dokument i en skiftende kunnskapsbase?
Grupper dokumenter etter hvor ofte de endres og hvor ofte de gjenbrukes. Et dokument som oppdateres ofte kan gjentatte ganger invalidere et stort delt prefiks; ved å plassere stabilt policy-materiale først og skiftende materiale senere kan du redusere den eksponeringen. Versjoner kildematerialet bevisst og oppdater det når korrekthet krever det, selv om det reduserer cache-gjenbruk.