
Odpowiedź na początku
Kimi K4 nie został oficjalnie wydany, a Moonshot AI nie opublikował finalnych specyfikacji, wyników benchmarków, cennika API ani daty premiery. Najmocniejszym publicznym sygnałem jak dotąd są doniesienia, że Moonshot stara się o dodatkową przepustowość Nvidia Blackwell dla następcy, który ma być znacząco większy niż Kimi K3. To istotny dowód, że przygotowywany jest model następnej generacji, ale nie jest to oficjalna zapowiedź produktu.
Odpowiedzialnie można omawiać kierunek, jaki może obrać K4. Obecny Kimi K3 z 2,8 biliona parametrów łączy już skalowanie rzadkiej Mixture-of-Experts, natywną wizję, okno kontekstu o długości miliona tokenów oraz zdolności agentów długiego horyzontu. Kimi K4 będzie więc prawdopodobnie oceniany bardziej przez pryzmat wiarygodnego działania agentowego, głębi kompetencji w kodowaniu, multimodalnego rozumowania i efektywności skalowania niż samej liczby parametrów.
Wniosek jest prosty: Kimi K4 najwyraźniej jest w fazie rozwoju, ale niemal każda liczba krążąca poza firmą pozostaje niepotwierdzona. Każda wiarygodna zapowiedź powinna oddzielać potwierdzone fakty o K3, doniesienia o K4 oraz wnioski wybiegające w przyszłość.
Czym jest Kimi K4?4
Kimi K4 to publiczna nazwa używana dla oczekiwanego następcy Kimi K3. Obecnie należy traktować go jako model w trakcie opracowywania, a nie ogłoszony produkt API. Moonshot AI nie opublikował karty modelu K4, raportu technicznego, identyfikatora API, cennika, licencji ani tabeli benchmarków.
Serwis The Information informuje, że Moonshot AI omawia plany dotyczące Kimi K4. Powołując się na dwie osoby zaznajomione ze sprawą, raport opisuje K4 jako znacząco większy od K3 i wskazuje, że Moonshot poszukuje dostępu do dodatkowych układów Nvidia Blackwell na potrzeby modelu. Nie potwierdza jednak liczby pięciu, sześciu czy jakiejkolwiek innej liczby bilionów parametrów ani nie określa, czy K4 zostanie wydany jako otwarte wagi, będzie dostępny wyłącznie w produktach hostowanych, czy zostanie podzielony na wiele wariantów.
Ta niepewność ma znaczenie, ponieważ wydania Kimi historycznie łączyły wagi modelu, hostowane API, produkty końcowe oraz wyspecjalizowane systemy agentowe. Przyszłe ogłoszenie K4 może odnosić się do jednego modelu, rodziny modeli lub szerszego systemu zbudowanego wokół routingu, narzędzi, pamięci i komponentów multimodalnych.
Dlaczego Kimi K4 przyciąga uwagę tak wcześnie?
Kimi K3 podniosła sufit skalowania otwartych wag
Kimi K3 ustanowiła wyjątkowo ambitny punkt odniesienia. Jej oficjalne podsumowanie podaje łącznie 2,8 biliona parametrów, 104 miliardy aktywowanych parametrów, 93 warstwy, 896 routowanych ekspertów, 16 wybieranych ekspertów na token, dwóch współdzielonych ekspertów oraz długość kontekstu 1 048 576 tokenów. Model zawiera również 401‑milionowy enkoder wizji MoonViT‑V2.
To połączenie czyni K3 ważną z dwóch powodów. Po pierwsze, pokazuje, że modele z otwartymi wagami mogą skalować się do tej samej szerokiej klasy możliwości co wiodące systemy proprietarne. Po drugie, jej rzadka konstrukcja demonstruje, że łączna liczba parametrów i koszt inferencji to nie to samo: dla każdego tokena aktywowany jest tylko podzbiór ekspertów.
Doniesienia wskazują na jeszcze większego następcę
Branżowe doniesienia mówią, że Moonshot AI szuka większych zasobów klasy Blackwell dla K4 i opisują planowany model jako znacząco większy niż K3. Ten raport jest najlepszym publicznym dowodem na to, że K4 to coś więcej niż spekulacja społeczności, ale nie rozstrzyga końcowej architektury, harmonogramu treningu, rozmiaru modelu ani planu wdrożenia.
Wątek dotyczący zasobów obliczeniowych jest istotny, ponieważ skala tworzy dwa odrębne wąskie gardła. Trening wymaga wystarczającej liczby akceleratorów, sieci, magazynu danych i stabilności inżynierskiej, by ukończyć bieg na granicy możliwości. Serwowanie z kolei wymaga osobnej strategii inferencji, która zapewni akceptowalne opóźnienia i koszt. Większy K4 potrzebowałby zatem ulepszeń architektonicznych i systemowych, a nie jedynie większej liczby urządzeń.
Architektura K3 została zaprojektowana z myślą o dalszym skalowaniu
Techniczny blog Moonshot o Kimi K3 opisuje Kimi Delta Attention i Attention Residuals jako architektoniczny kręgosłup modelu zaprojektowanego do skalowania poza reżim bilionów parametrów. Kimi Delta Attention zapewnia wydajną podstawę uwagi, podczas gdy Attention Residuals selektywnie odtwarza reprezentacje wzdłuż głębokości modelu zamiast akumulować je jednolicie.
K3 wykorzystuje również Stable LatentMoE, efektywnie aktywując 16 z 896 routowanych ekspertów. Quantile Balancing wyznacza alokację ekspertów na podstawie kwantyli wyników routera, a Per-Head Muon optymalizuje głowy uwagi niezależnie. Te wybory wskazują na problemy, które K4 musi rozwiązać: stabilne routowanie, zrównoważone wykorzystanie ekspertów, wydajną uwagę dla długiego kontekstu oraz przewidywalny trening w skrajnej skali.
Dlaczego Kimi K4 miałby mieć znaczenie, skoro Kimi K3 to już model 2,8T?
Kimi K3 działa już w niezwykle dużej skali, więc nie można oceniać K4 wyłącznie pytaniem, czy ma więcej parametrów. Bardziej sensowne jest pytanie, czy dodatkowy budżet treningowy przekłada się na lepsze domykanie zadań, wyższą niezawodność przy długim horyzoncie oraz niższy efektywny koszt inferencji.
Przydatna ewaluacja K4 powinna skupić się na czterech metrykach:
- Task completion rate
- Long-horizon agent reliability
- Coding success rate
- Cost per successfully completed task
Ta ostatnia metryka jest szczególnie ważna dla deweloperów. Model, który kosztuje mniej za skuteczną naprawę repozytorium, może być cenniejszy niż model z wyższym wynikiem benchmarku, ale znacząco większą liczbą nieudanych trajektorii.
Oczekiwane specyfikacje Kimi K4
Tabela poniżej odróżnia potwierdzoną bazę techniczną K3 od raportów i wniosków o K4. Oczekiwane nie oznacza ogłoszone. Nieznane pola powinny pozostać nieznane, dopóki Moonshot AI nie opublikuje karty modelu lub dokumentacji API.
| Podstawa specyfikacji | Kimi K3 potwierdzone | Kimi K4 raporty publiczne | Pewność |
|---|---|---|---|
| Status modelu | Wydany | W trakcie rozwoju | Raportowane |
| Architektura | Rzadka MoE | Nie ujawniono; prawdopodobnie ewolucja rzadkiej MoE | Wnioskowanie |
| Łączna liczba parametrów | 2,8T | Podobno znacząco większa niż w K3 | Raportowane; dokładna wartość nieznana |
| Aktywowane parametry | 104B | Nie ujawniono | Nieznane |
| Konfiguracja ekspertów | 896 routowanych; 16 wybieranych; 2 współdzielonych | Nie ujawniono | Nieznane |
| Okno kontekstu | 1 048 576 tokenów | Prawdopodobnie co najmniej 1M, ale nie potwierdzono | Oczekiwane |
| Uwaga | KDA plus Gated MLA | Możliwa następna generacja KDA | Wnioskowanie |
| Natywna wizja | MoonViT‑V2 | Kontynuacja multimodalności prawdopodobna | Oczekiwane |
| Otwarte wagi | Dostępne | Nie potwierdzono | Nieznane |
| ID modelu API | kimi-k3 | Nie ogłoszono | Nieznane |
| Data wydania | Dostępny | Nie ogłoszono | Nieznane |
Najważniejszym zastrzeżeniem jest wiersz dotyczący parametrów. „Znacząco większa” nie określa dokładnego rozmiaru. Podobnie, milionowe okno kontekstu, multimodalność i wydanie otwartych wag K3 nie mogą zostać przepisane do specyfikacji K4 jako potwierdzone fakty. To kierunkowo prawdopodobne oczekiwania, a nie opublikowane zobowiązania produktowe.
Jakie funkcje mógłby wprowadzić Kimi K4?
-
Większe, ale bardziej efektywne skalowanie rzadkiej MoE
Najbardziej oczywistym oczekiwaniem jest większy model Mixture‑of‑Experts. Ważniejsze pytanie brzmi, czy K4 poprawi relację między łączną pojemnością, aktywowaną pojemnością a kosztem serwowania. Zwiększenie puli ekspertów bez ulepszenia routingu może tworzyć niewykorzystanych specjalistów, przegrzewających się „gorących” ekspertów, wąskie gardła komunikacyjne i niestabilny trening.
Wiarygodny postęp K4 połączyłby dodatkową pojemność z lepszym równoważeniem obciążenia, większą specjalizacją ekspertów, niższymi współczynnikami aktywacji lub silniejszą koordynacją między ekspertami. Żadne z tych szczegółów nie zostały ujawnione, więc artykuł powinien opisywać je jako cele inżynieryjne, a nie wyciekłe funkcje.
Bardziej zaawansowane Kimi Delta Attention
Kimi Delta Attention jest centralnym elementem długokontekstowego projektu K3. Wersja następnej generacji mogłaby poprawić wyszukiwanie w milionowych wejściach, zredukować pamięć stanu uwagi i zachować ważne informacje podczas długich przebiegów agentów. Praktycznym testem nie byłby wyłącznie rozmiar okna kontekstu, lecz to, czy model potrafi znaleźć, połączyć i wykorzystać odległe dowody bez agresywnego chunkingu lub powtarzanych retriwali.
Bardziej niezawodni agenci długiego horyzontu
Kimi K3 jest już pozycjonowany do długotrwałej pracy technicznej i wiedzo‑wej. Oficjalne demonstracje obejmują rozwój kompilatorów, optymalizację jąder GPU, naukowe kodowanie, badania interaktywne, tworzenie gier i przepływy projektowania układów scalonych. K4 musiałby przekształcić te imponujące demonstracje w bardziej konsekwentne działanie na co dzień.
Kluczowe metryki to mniej zbędnych wywołań narzędzi, silniejsze utrzymanie celów, lepsze odzyskiwanie po nieudanych działaniach, bardziej niezawodna weryfikacja i niższa wariancja między przebiegami. Model, który raz zamyka trudny benchmark, ale zachowuje się nieprzewidywalnie w produkcji, jest mniej użyteczny niż nieco słabszy model o niezawodnym wykonaniu.
Silniejsze programowanie i inżynieria oprogramowania
K4 prawdopodobnie pozostanie mocno ukierunkowany na kodowanie, ale horyzont przesunął się poza generowanie odizolowanych funkcji. Konkurencyjne modele inżynierii oprogramowania muszą mapować repozytoria, rozumieć zależności, obsługiwać terminale, modyfikować wiele plików, uruchamiać testy, diagnozować awarie i korygować podejście.
K3 jest już silny na ProgramBench, SWE‑Marathon, FrontierSWE i zadaniach terminalowych. Najwyraźniejszą szansą K4 jest domknięcie pozostałej luki w głębokiej naprawie repozytoriów przy jednoczesnym zachowaniu przewagi K3 w długotrwałej pracy krok po kroku.
Głębsza natywna multimodalność
K3 łączy tekst i wizję na poziomie modelu, a przykłady produktowe Moonshot rozszerzają tę zdolność na edycję wideo i rozwój z wizją w pętli. K4 mógłby poprawić przepływy screenshot‑to‑code, rozumienie wykresów i dokumentów, rozumienie temporalne wideo, testowanie interfejsów oraz agentów, którzy oglądają wyniki wizualne przed kontynuacją.
Kluczem jest różnica między przyjmowaniem obrazów a używaniem percepcji w zamkniętej pętli. Agent multimodalny musi zaobserwować wyrenderowany wynik, zidentyfikować rozbieżność, edytować swoją pracę i zweryfikować poprawkę. To bardziej wymagające niż odpowiedź na pojedyncze pytanie o obraz.
Lepsza efektywność wnioskowania i wdrożeń
Model większy niż K3 może być trudny do samodzielnego hostowania nawet przy udostępnionych wagach. K4 skorzystałby na treningu świadomym kwantyzacji, wydajnej równoległości ekspertów, dekodowaniu spekulatywnym, zoptymalizowanym zarządzaniu stanami KV i mniejszych wariantach towarzyszących. Dla większości zespołów hostowany dostęp API może pozostać praktyczniejszy niż bezpośrednia eksploatacja modelu rzadkiego w skali granicznej.
Jakiej wydajności w benchmarkach potrzebowałby Kimi K4?
K4 nie ma opublikowanych wyników benchmarków. Odpowiedzialne podejście to ustalenie poprzeczki wyznaczonej przez K3 i obecnych konkurentów z czołówki, a następnie wskazanie, gdzie następca musiałby się poprawić. Rozszerzona baza poniżej obejmuje rozumowanie, kodowanie, obsługę terminala, głębokie badania, agentową pracę wiedzo‑wą oraz zadania arkuszy kalkulacyjnych. Wszystkie wartości pochodzą z oficjalnej karty modelu Kimi K3 podlinkowanej w nagłówku tabeli.
| Oficjalny zestaw benchmarków | Kimi K3 | GPT-5.6 Sol | Claude Fable 5 | Claude Opus 4.8 |
|---|---|---|---|---|
| GPQA Diamond | 93,5 | 94,1 | 92,6 | 91,0 |
| DeepSWE | 67,5 | 73,0 | 70,0 | 59,0 |
| ProgramBench | 77,8 | 77,6 | 76,8 | 71,9 |
| Terminal-Bench 2.1 | 88,3 | 88,8 | 88,0 | 84,6 |
| FrontierSWE | 81,2 | 71,3 | 86,6 | 66,7 |
| SWE-Marathon | 42,0 | 39,0 | 35,0 | 40,0 |
| Kimi Code Bench 2.0 | 72,9 | 64,8 | 76,9 | 71,7 |
| BrowseComp | 91,2 | 90,4 | 88,0 | 84,3 |
| DeepSearchQA (F1) | 95,0 | Nie raportowano | 94,2 | 93,1 |
| ResearchRubrics | 76,2 | 73,8 | Nie raportowano | 73,5 |
| GDPval-AA v2 (Elo) | 1686 | 1736 | 1747 | 1593 |
| SpreadsheetBench 2 | 34,8 | 32,4 | 34,7 | 31,6 |
To wyniki raportowane przez Moonshot, a nie pojedyncza kontrolowana niezależna lista rankingowa. Niektóre modele oceniano w różnych harnessach agentów, a oficjalne przypisy opisują fallbacki, cyberguards, substytucje sprzętowe, ustawienia reasoning oraz procedury specyficzne dla benchmarków. GDPval‑AA v2 to ranking Elo i nie powinien być porównywany liczbowo z wierszami procentowymi. Niewielkich różnic w wynikach nie należy interpretować jako powszechnej przewagi.
Oficjalna migawka benchmarków kodowania
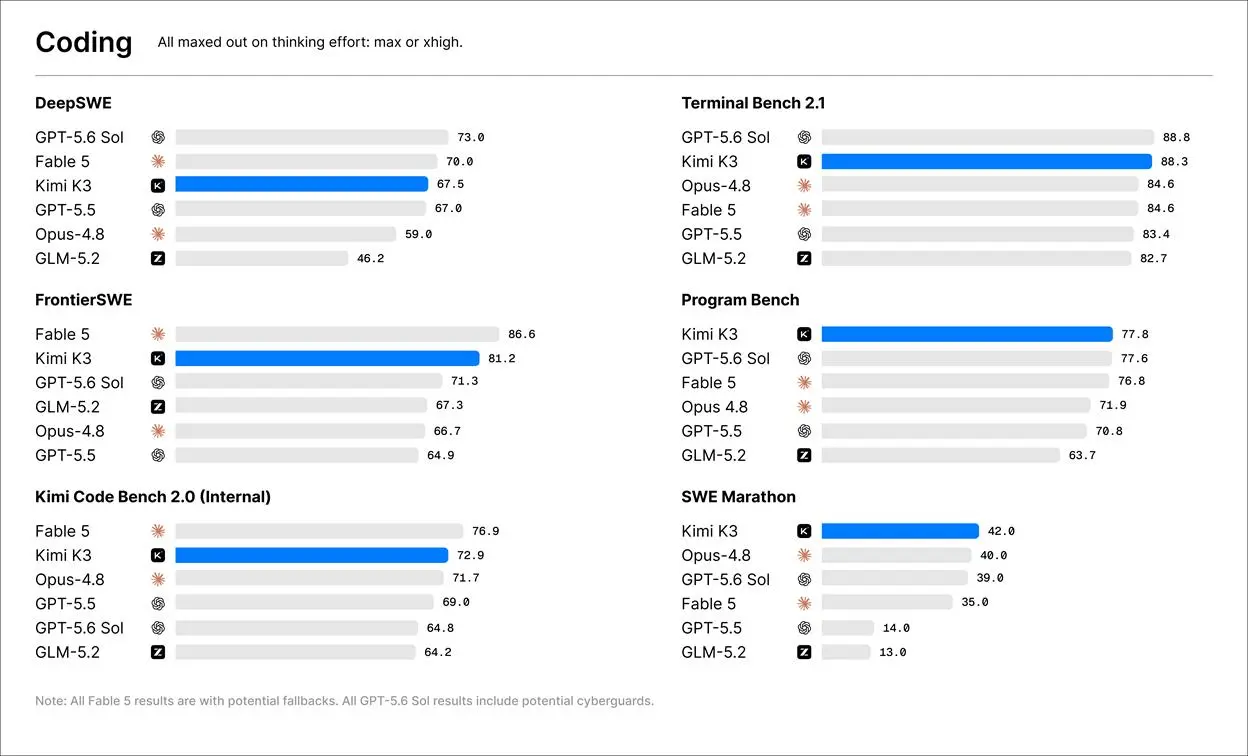
Oficjalne porównanie kodowania Kimi K3. Obraz to grafika opublikowana przez Moonshot; sprawdź aktualną kartę modelu i przypisy dla najnowszej tabeli liczb i metodologii ewaluacji.
Wyniki benchmarków i interpretacja
GPT-5.6 Sol prowadzi nad Kimi K3 w DeepSWE, co wskazuje przewagę w trudnej naprawie oprogramowania na poziomie repozytoriów. Claude Fable 5 prowadzi w FrontierSWE, podczas gdy K3 pozostaje wyraźnie przed GPT‑5.6 Sol i Claude Opus 4.8 w tym benchmarku.
Profil K3 staje się bardziej charakterystyczny przy pracy długotrwałej. Model nieznacznie prowadzi w ProgramBench i osiąga najsilniejszy wynik SWE‑Marathon w wybranym porównaniu. Prowadzi też w BrowseComp i praktycznie remisuje z Claude Fable 5 w SpreadsheetBench 2.
Dla K4 celem nie powinien być stały procentowy wzrost na każdym wykresie. Bardziej użyteczny jest zamiar poprawy głębokiej naprawy kodu i niezawodności obsługi komputera bez utraty mocnych stron K3 w długohoryzontowym kodowaniu, przeglądaniu i agentowej pracy wiedzo‑wej.
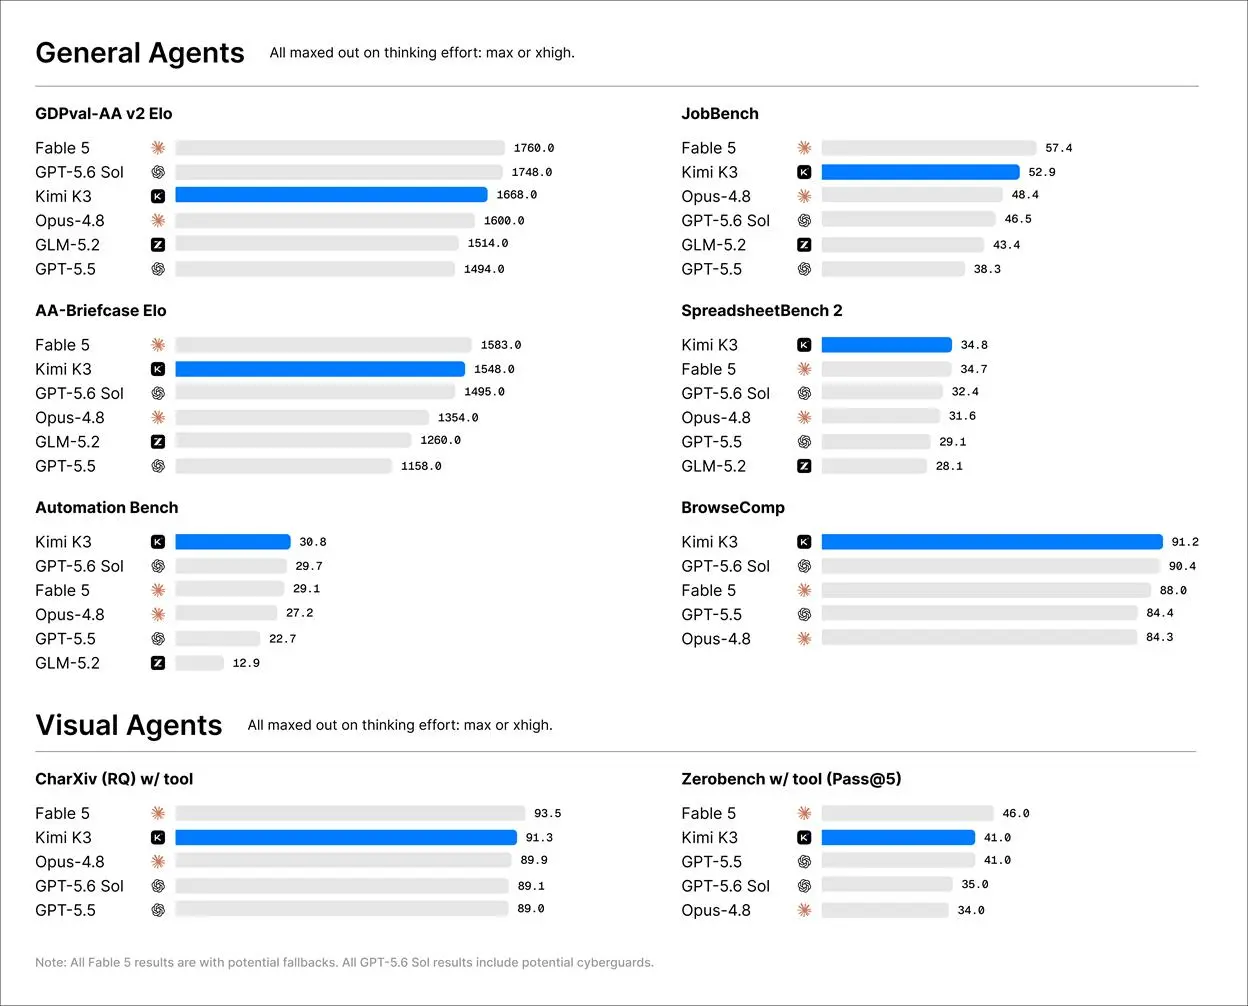
Oficjalne porównanie agentów ogólnych i wizualnych Kimi K3. Źródło: strona modelu Kimi K3 Moonshot AI.
Kimi K4 vs Kimi K3, GPT-5.6 Sol i Claude Fable 5
Porównanie przed wydaniem nie może przypisać K4 wyników, które nie istnieją. Może jednak pokazać pozycję konkurencyjną, jakiej można oczekiwać od K4, jeśli rozwinie linię K3.
| Wymiar | Oczekiwana pozycja Kimi K4 | Kimi K3 potwierdzony | Odnośniki zamknięte: GPT-5.6 Sol i Claude Fable 5 |
|---|---|---|---|
| Dostępność | W trakcie rozwoju | Dostępny | Dostępne |
| Otwartość modelu | Nieznana | Otwarte wagi | Proprietary |
| Potwierdzony kontekst | Nieznany | 1M tokenów | Zdefiniowany przez dostawcę lub klasy 1M |
| Główna mocna strona | Oczekiwana inteligencja w skali granicznej | Długohoryzontowe kodowanie i praca wiedzo‑wa | Czołowe rozumowanie, kodowanie i obsługa komputera |
| Multimodalność | Oczekiwana; nie potwierdzono | Natywna wizja | Multimodalne |
| Samodzielne hostowanie | Nieznane | Możliwe przy znaczącej infrastrukturze | Niedostępne |
| Dojrzałość agentów | Oczekiwany postęp | Silna | Silna |
| Koszt wdrożenia | Nieznany i potencjalnie wysoki | Wysoki dla self‑hostingu; hostowane API dostępne | Tylko hostowane API |
| Główny powód do obserwowania | Skala plus możliwa otwartość | Zweryfikowana otwarta baza graniczna | Maksymalna zdolność modeli zamkniętych |
Wynik porównania
Kimi K3 wyróżnia się otwartymi wagami, oknem kontekstu o długości miliona tokenów i silną wydajnością w długim horyzoncie. GPT‑5.6 Sol pozostaje mocniejszy w niektórych trudnych zadaniach rozumowania i naprawy repozytoriów, podczas gdy Claude Fable 5 jest szczególnie konkurencyjny w inżynierii oprogramowania i agentach obsługi komputera.
Jeśli K4 pozostanie otwarty lub szeroko dostępny, a jednocześnie zamknie te luki, jego znaczenie wykraczałoby poza większą liczbę parametrów. Pokazałby, że systemy otwarte lub półotwarte mogą zbliżyć się pod względem niezawodności do najsilniejszych platform agentowych modeli zamkniętych. Jeśli K4 stanie się zamknięty i niezwykle drogi w serwowaniu, praktyczna różnica byłaby dużo mniejsza.
Co Kimi K4 może oznaczać dla AI z otwartymi wagami?
K3 już pokazuje, że rozwój z otwartymi wagami wchodzi w skalę dotąd kojarzoną niemal wyłącznie z laboratoriami proprietarnymi. K4 mógłby przesunąć tę granicę dalej, ale otwartość ma kilka warstw: możliwe do pobrania wagi, używalny kod, wykonalna licencja, powtarzalna inferencja, przystępne wymagania sprzętowe i dostępne hostowane API.
Model może być technicznie otwarty, a zarazem ekonomicznie niedostępny. Skala 2,8T K3 oznacza, że poważny self‑hosting wymaga znacznej infrastruktury nawet przy rzadkiej aktywacji i kwantyzacji. Jeszcze większy K4 mógłby poszerzyć lukę między badaczami, którzy mogą analizować wagi, a organizacjami, które potrafią efektywnie eksploatować model.
Dla szerszego ekosystemu idealne wydanie K4 połączyłoby transparentne wagi, wydajne przepisy na inferencję, silne zachowanie w użyciu narzędzi oraz hostowane API. Takie połączenie pozwoliłoby badaczom studiować model, przedsiębiorstwom wdrażać go przez API, a wyspecjalizowanym zespołom adaptować go do prywatnych lub regulowanych obciążeń.
Kiedy zostanie wydany Kimi K4?
Moonshot AI nie ogłosił daty wydania Kimi K4. Publiczne doniesienia łączą model z pozyskiwaniem zasobów obliczeniowych i planowaniem rozwoju. To sprawia, że precyzyjne wskazanie miesiąca, kwartału lub odliczania jest niewiarygodne.
Nie wiadomo też, czy K4 pojawi się jednocześnie w produkcie webowym Kimi, Kimi Code, Kimi Work, Moonshot API i repozytorium z otwartymi wagami. K3 jest dostępny na kilku z tych powierzchni, ale K4 może podążać ścieżką etapowego wdrożenia lub inną strategią dystrybucji.
Sygnały warte obserwowania to oficjalny blog techniczny Moonshot, zweryfikowane repozytorium modelu, dokumentacja Kimi Platform, opublikowana licencja oraz karta modelu ze szczegółami ewaluacji możliwymi do powtórzenia. Posty w mediach społecznościowych i plotki o parametrach powinny pozostać drugorzędne, dopóki nie pojawi się jedno z tych źródeł.
Jak uzyskać dostęp do modeli Kimi w oczekiwaniu na K4
K4 nie jest obecnie wywoływalny. Deweloperzy mogą zamiast tego ocenić obecną architekturę poprzez Kimi K3 na CometAPI. Aktualny identyfikator modelu to zwykły tekst kodowy: kimi-k3. Żądanie używa POST /v1/chat/completions. Nie wysyłaj żądań produkcyjnych do spekulatywnego identyfikatora kimi-k4, dopóki nie zostanie on opublikowany w oficjalnej stronie integracji.
Utwórz konto CometAPI i wygeneruj klucz API. Przechowuj klucz w zmiennej środowiskowej zamiast wpisywać go na stałe w kodzie źródłowym aplikacji.
from openai import OpenAI client = OpenAI( api_key="YOUR_COMETAPI_KEY", base_url="https://api.cometapi.com/v1", ) response = client.chat.completions.create( model="kimi-k3", messages=[ { "role": "user", "content": "Analyze the architecture of this software project." } ], ) print(response.choices[0].message.content)
Kod to Python. Endpoint, identyfikator modelu, nazwy parametrów i słowa kluczowe w kodzie są celowo przedstawione jako kod, a nie hiperłącza. Gdy K4 stanie się dostępny, deweloperzy powinni potwierdzić jego rzeczywisty identyfikator modelu, zgodność endpointu, obsługiwane modalności i ceny przed zmianą routingu w produkcji.
Czego wciąż nie wiemy o Kimi K4
Odpowiedzialny artykuł przedpremierowy powinien zachować następujące niewiadome zamiast wypełniać je szacunkami społeczności:
- Finalna łączna i aktywowana liczba parametrów
- Liczba ekspertów, współdzielonych ekspertów i strategia routingu
- Okno kontekstu i maksymalna długość wyjścia
- Wspierane modalności wejścia i wyjścia
- Status otwartych wag, repozytorium i licencja
- ID modelu API, endpointy, tryby reasoning i ceny
- Oficjalne wyniki benchmarków i harnessy ewaluacyjne
- Format kwantyzacji i wymagania sprzętowe dla self‑hostingu
- Dostępność produktowa i data wydania
Utrzymanie tej sekcji wprost zapobiega powtarzaniu przewidywanych specyfikacji jako późniejszych faktów. Ułatwia też aktualizację artykułu, gdy Moonshot AI opublikuje dokumentację pierwotną.
FAQ
Czy Kimi K4 został wydany?
Nie. Nie istnieje oficjalna karta modelu Kimi K4, dokumentacja API ani publiczne ogłoszenie wydania. Obecna dyskusja opiera się głównie na doniesieniach, że Moonshot AI przygotowuje większego następcę K3.
Jak duży będzie Kimi K4?
Dokładny rozmiar jest nieznany. Doniesienia mówią, że może być znacząco większy niż K3, ale konkretne twierdzenia o wielobilionowych parametrach nie zostały potwierdzone przez Moonshot AI.
Czy Kimi K4 będzie open source?
To nie zostało potwierdzone. K3 ma otwarte wagi na licencji Kimi K3, ale wcześniejsza strategia wydawnicza nie gwarantuje tej samej dystrybucji dla K4.
Czy Kimi K4 będzie miał okno kontekstu miliona tokenów?
Rozsądnie jest oczekiwać, że K4 zachowa lub poprawi długokontekstowe możliwości K3, ale Moonshot AI nie opublikował limitu kontekstu K4.
Czy deweloperzy mogą użyć Kimi K4 przez CometAPI już teraz?
Nie ma potwierdzonej ścieżki modelu K4. Deweloperzy mogą obecnie testować Kimi K3 i porównywać go z innymi modelami czołówki przez tę samą warstwę integracji.
Zakończenie
Kimi K4 nie powinien być sprowadzany do plotek o liczbie parametrów. K3 już dowodzi, że Moonshot AI potrafi połączyć skrajną skalę modelu rzadkiego, milionowe okno kontekstu, natywną wizję, otwarte wagi i zachowanie agentów długiego horyzontu. Prawdziwe pytanie brzmi, czy K4 potrafi zamienić tę skalę w bardziej niezawodną inżynierię oprogramowania, silniejszą obsługę komputera, lepsze pętle multimodalnej informacji zwrotnej i bardziej wydajną inferencję.
Najważniejsze szczegóły pozostają nieznane: dokładna architektura, data wydania, wyniki benchmarków, licencja, dostęp do API i koszt serwowania. Dopóki Moonshot nie opublikuje dokumentacji pierwotnej, każda specyfikacja K4 poza raportowanym sygnałem o rozwoju powinna być oznaczona jako oczekiwanie lub wnioskowanie.
Deweloperzy nie muszą czekać, by ocenić obecny kierunek Moonshot AI. Kimi K3 jest już dostępny przez CometAPI, zapewniając praktyczną bazę do kodowania, rozumowania na długim kontekście, analizy multimodalnej i przepływów pracy agentów przed nadejściem Kimi K4.