
Najpierw odpowiedź
GPT-6 Astra to nowy flagowy model OpenAI do trudnej pracy end-to-end. OpenAI udostępniło GPT-6 Astra 3 września 2026 r., pozycjonując go wokół złożonego rozumowania, korzystania z komputera, kodowania, badań naukowych i tworzenia profesjonalnych artefaktów. Model API ma okno kontekstu 1,05 mln tokenów i maksymalny wynik 128K, przyjmuje wejście tekstowe i obrazowe oraz wspiera wysiłek rozumowania od low do max. Standardowe ceny API zaczynają się od $10 za wejście / $50 za wyjście za milion tokenów. Najważniejszą praktyczną zmianą nie jest jednolity skok na każdym benchmarku ogólnej inteligencji: największe zyski Astry pojawiają się w agentowym wykonywaniu zadań, obsłudze komputera, przywoływaniu z długiego kontekstu, przepływach pracy w kodowaniu, nauce i cyberbezpieczeństwie.
Ma to znaczenie, ponieważ starszy artykuł CometAPI GPT-6 Is Coming Soon — What Will It Look Like? z konieczności był spekulacyjny. Teraz, gdy Astra jest publiczna, ten przewodnik koncentruje się na potwierdzonym zachowaniu modelu, kompromisach benchmarkowych, ekonomii API oraz na tym, gdzie model faktycznie jest lepszym wyborem niż tańsze alternatywy z czołówki.
Czym jest GPT-6 Astra?
GPT-6 Astra to następca flagowego modelu OpenAI GPT-5.6 Sol. OpenAI opisuje Astrę jako swój najbardziej zdolny model do najtrudniejszej pracy end-to-end, z naciskiem na przepływy pracy wymagające od modelu rozumowania, korzystania z narzędzi, interakcji z oprogramowaniem, rewizji pracy pośredniej i doprowadzenia zadania od początkowej prośby do ukończonego rezultatu. To pozycjonowanie jest istotne: Astra nie jest po prostu większym modelem czatowym. Została zaprojektowana, by działać jako silnik rozumowania wewnątrz agentów pracujących w przeglądarkach, terminalach, dokumentach, arkuszach kalkulacyjnych, środowiskach deweloperskich i oprogramowaniu korporacyjnym.
Post ogłoszeniowy podkreśla najnowocześniejsze wyniki w obsłudze komputera, przeglądaniu, inżynierii oprogramowania, cyberbezpieczeństwie, nauce i pracy profesjonalnej. Raportuje 97,6% / 99,9% / 100% na kolejno FrontierMath Tier 4, ARC-AGI-3 i ExploitBench. Te nagłówkowe wyniki są uderzające, ale nie należy ich interpretować jako „Astra wygrywa każdy benchmark”. Na Artificial Analysis Intelligence Index użytym w tabeli porównawczej OpenAI, Astra uzyskuje 61,2, podczas gdy Claude Fable 5.1 65,7. Wydanie należy więc rozumieć jako skokową zmianę w realizacji i pracy agentowej, a nie czyste zwycięstwo we wszystkich miarach inteligencji.
Co się zmieniło względem GPT-5.6 Sol?
Obsługa komputera stała się kluczową kompetencją
Najbardziej wyraźny skok pokoleniowy Astry to obsługa komputera. Na OSWorld 2.0 OpenAI raportuje 72,6% dla Astry wobec 65,7% dla GPT-5.6 Sol. W tej samej symulacji opóźnień Astra kończyła zadania w około 40 minut w porównaniu z około 75 minutami dla Sol, co oznacza redukcję o około 47%. W połączeniu z zaktualizowanymi ramami testowymi Codex, OpenAI raportuje 1,9× szybsze ukończenie na Mind2Web. Praktyczna kwestia nie polega tylko na tym, że Astra „widzi ekran”; potrafi utrzymać spójność wieloetapowego zadania w oprogramowaniu przez dłuższy czas, jednocześnie wykonując mniej kosztownych objazdów.
Tworzenie profesjonalnych artefaktów jest bardziej rozważne
OpenAI wyraźnie szkoliło Astrę pod kątem profesjonalnych przepływów pracy, które kończą się użytecznymi artefaktami, a nie surową prozą. Materiały o premierze opisują silniejszą wydajność w dokumentach, arkuszach, prezentacjach, analizie danych, pracach projektowych i trzymaniu się szablonów. Astra jest też lepsza w utrzymywaniu orientacji, gdy wymagania zmieniają się w trakcie zadania, więc wiadomość sterująca rzadziej nadpisuje pierwotny cel. Jest to szczególnie przydatne w długo trwających agentach korporacyjnych, gdzie nowe instrukcje często pojawiają się po rozpoczęciu przepływu pracy.
Długie sesje zachowują więcej użytecznego kontekstu roboczego
W długich sesjach programistycznych Astra wprowadza nowy sposób, w jaki Codex zachowuje i przywołuje notatki po zapełnieniu aktywnego kontekstu. Wcześniejsze podejścia silnie polegały na kompaktowaniu, które może pomijać informację, dlaczego próba poprawki się nie powiodła lub które ograniczenia były już testowane. OpenAI twierdzi, że Astra potrafi utrzymywać notatki ponad oknami kontekstu, poprawiając ciągłość podczas dużych refaktoryzacji i sesji debugowania.
Wysiłek rozumowania teraz obejmuje tryb maksymalny
Deweloperzy mogą wybrać wysiłek rozumowania: low, medium, high, xhigh lub max. Tworzy to szerszą krzywą jakości-kosztu niż traktowanie Astry jako pojedynczego, stałego punktu pracy. Oficjalne wskazówki dotyczące modelu zalecają wybór najniższego wysiłku, który spełnia cel Waszego ewaluatora, ponieważ najlepsza ekonomia modelu często wynika z efektywności tokenowej, a nie z ciągłego uruchamiania na maksymalnym rozumowaniu.
Wydajność GPT-6 Astra w benchmarkach
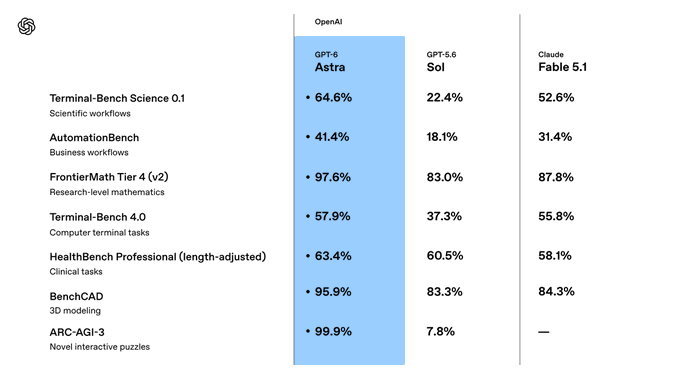
OpenAI opublikowało szerokie porównanie obejmujące obsługę komputera, pracę profesjonalną, kodowanie, akademickie rozumowanie, zdrowie, cyberbezpieczeństwo, długi kontekst i alignment. Najbardziej użyteczny sposób czytania tej tabeli to rozdzielenie „ogólnej inteligencji” od „zdolności do domykania pracy z użyciem narzędzi”. Astra jest tylko nieznacznie powyżej Sol na Artificial Analysis Intelligence Index w tabeli OpenAI, a jednocześnie dramatycznie wyprzedza na kilku benchmarkach agentowych i operacyjnych.
| Benchmark | GPT-6 Astra | GPT-5.6 Sol | Co sugeruje różnica |
|---|---|---|---|
| AutomationBench | 41,4% | 18,1% | Duży wzrost w przepływach pracy biznesowych end-to-end |
| OSWorld 2.0 | 72,6% | 65,7% | Lepsza interakcja z komputerem i realizacja zadań |
| Terminal-Bench 4.0 | 57,9% | 37,3% | Duży wzrost w agentowym kodowaniu w terminalu |
| Terminal-Bench Science 0.1 | 64,6% | 22,4% | Znaczny wzrost w naukowych przepływach pracy z kodem/narzędziami |
| FrontierMath Tier 4 v2 | 97,6% | 83,0% | Silniejsze rozumowanie matematyczne na poziomie frontier |
| ExploitBench | 100,0% | 78,5% | Zdolność cyberbezpieczeństwa klasy krytycznej |
| SRE-Bench, one attempt | 88,0% | 55,9% | Znacznie lepsza praca w reverse engineering / SRE |
| MRCR v2, 512K-1M | 96,3% | 73,8% | Ulepszone przywoływanie z bardzo długiego kontekstu |
| AA Intelligence Index v4.1.1 | 61,2 | 60,9 | Ogólna inteligencja zasadniczo płaska względem Sol |
Wzorzec jest wyjątkowo klarowny. Przewaga Astry jest największa, gdy benchmark wymaga utrzymanej interakcji z narzędziem lub środowiskiem. AutomationBench rośnie z 18,1% do 41,4%; Terminal-Bench Science wzrasta z 22,4% do 64,6%; a długokontekstowy MRCR poprawia się z 73,8% do 96,3% w paśmie 512K–1M. Z kolei Artificial Analysis Intelligence Index przesuwa się z 60,9 do 61,2. Dlatego opisanie Astry jako „2,5× droższej, ale nieco mądrzejszej” chybia rzeczywistej propozycji wartości produktu.
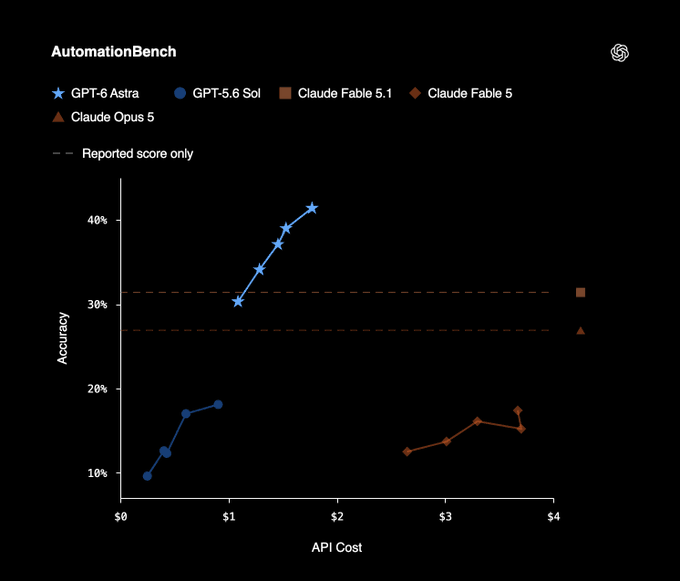
Źródło: Wykres OpenAI AutomationBench (oryginalny obraz, nie przerysowany)
Niezależne benchmarki: czy GPT-6 Astra to skok generacyjny?
Niezależne testy dodają ważną dawkę realizmu. Artificial Analysis raportuje wynik Intelligence Index 61, równy GPT-5.6 Sol przy maksymalnym wysiłku. Jednocześnie Astra silnie poprawia wynik na Coding Agent Index i zużywa znacząco mniej tokenów w agentowym kodowaniu. Artificial Analysis zmierzyło około trzykrotną redukcję zużycia tokenów względem GPT-5.6 Sol przy maksymalnym wysiłku w swoich ramach Codex, pozwalając Astrze osiągać wyższe wyniki przy mniej więcej tym samym koszcie na zadanie agentowe w kodowaniu.
Ekonomia wygląda mniej korzystnie przy ogólnej inteligencji. Astra używa o około 10% mniej tokenów wyjściowych niż Sol w Intelligence Index przy maksymalnym wysiłku, ale 2,5× wyższa cena za token dominuje nad tą oszczędnością; Artificial Analysis szacuje, że Astra jest około 75% droższa na zadanie przy maksymalnym wysiłku. Raportuje też redukcję współczynnika halucynacji z 92% do 51% na AA-Omniscience przy wzroście dokładności o cztery punkty.
Użyteczny wniosek zależy od rodzaju pracy: GPT-6 Astra wygląda najbardziej „generacyjnie” tam, gdzie agent musi działać, iterować, używać narzędzi i dokończyć skomplikowaną robotę. W przypadku zwykłego rozumowania lub generowania tekstu na dużą skalę, premia cenowa może być znacznie trudniejsza do odzyskania.
GPT-6 Astra vs GPT-5.6 Sol vs Claude Fable 5.1 vs Gemini 3.8 Flash
Praktyczne porównanie wyboru modelu powinno obejmować zdolności, multimodalność, kontekst, agentowe wykonywanie i cenę. Poniższe modele nie są zamienne: Astra optymalizuje pod trudne wykonanie end-to-end, Claude Fable 5.1 prowadzi w niektórych miarach ogólnej inteligencji, a Gemini 3.8 Flash oferuje znacznie niższe ceny tokenów z szerszymi natywnymi modalnościami wejścia.
| Metryka | GPT-6 Astra | GPT-5.6 Sol | Claude Fable 5.1 | Gemini 3.8 Flash |
|---|---|---|---|---|
| Okno kontekstu | 1,05M | 1,05M | 1M | 1,048M |
| Maksymalna długość wyjścia | 128K | 128K | 128K | 65,5K |
| Modalności wejścia | Tekst, obraz | Tekst, obraz | Tekst, obraz/PDF | Tekst, obraz, audio, wideo, PDF |
| AA Intelligence Index | 61,2 | 60,9 | 65,7 | 58,7 |
| AutomationBench | 41,4% | 18,1% | 31,4% | — |
| Terminal-Bench 4.0 | 57,9% | 37,3% | 55,8% | 19,1% |
| DeepSWE 1.1 | 74,1% | 72,7% | 67,4% | 73,8% |
| FrontierMath Tier 4 v2 | 97,6% | 83,0% | 87,8% | — |
| HLE z narzędziami | 57,2% | — | 65,0% | — |
| HealthBench Professional | 63,4% | 60,5% | 58,1% | 52,1% |
| Oficjalna standardowa cena wejścia | $10/M | $4/M | $10/M | $0,75/M |
| Oficjalna standardowa cena wyjścia | $50/M | $20/M | $50/M | $3,75/M |
Kiedy GPT-6 Astra jest lepszym wyborem
Wybierz Astrę, gdy zadanie jest kosztowne, ponieważ ludzie muszą ratować nieudane przebiegi agentów: długie zmiany w kodzie, automatyzacja przeglądarki/pulpitu, głębokie badania obejmujące narzędzia, tworzenie technicznych artefaktów lub złożone naukowe i operacyjne przepływy pracy. Jej premia najłatwiej się uzasadnia, gdy mniej powtórek, mniej ręcznych poprawek i niższe zużycie tokenów wyjściowych mają większe znaczenie niż sama cena za token.
Kiedy Claude Fable 5.1 jest lepszym wyborem
Claude Fable 5.1 pozostaje poważnym konkurentem na czołówce. W tabeli premierowej OpenAI uzyskuje 65,7 na Artificial Analysis Intelligence Index wobec 61,2 Astry i 65,0 na Humanity’s Last Exam z narzędziami wobec 57,2 Astry. Oznacza to, że Astry nie należy promować jako uniwersalnego zwycięzcy inteligencji. Jeśli Wasz zestaw ewaluacyjny bardziej przypomina długą formę rozumowania niż wykonanie z użyciem komputera, Claude Fable 5.1 może nadal być lepszym dopasowaniem.
Kiedy Gemini 3.8 Flash jest lepszym wyborem
Gemini 3.8 Flash celuje w inny punkt na froncie. Wspiera wejścia tekstowe, obrazowe, audio, wideo i PDF przy oknie kontekstu około 1 mln tokenów, a oficjalne ceny wprowadzające są znacznie niższe niż Astry. Dla ekstrakcji multimodalnej na dużą skalę, rozumienia wideo/audio, rutynowych agentów lub obciążeń, gdzie ekonomia tokenów $10/$50 jest trudna do uzasadnienia, Gemini 3.8 Flash często jest bardziej ekonomicznym wyborem produkcyjnym.
Dlaczego ocena cyberbezpieczeństwa GPT-6 Astra ma znaczenie
Astra jest pierwszym szeroko wdrożonym modelem OpenAI, który osiągnął próg krytycznej zdolności w cyberbezpieczeństwie w ramach Preparedness Framework firmy. OpenAI twierdzi, że model potrafi identyfikować wcześniej nieznane luki bezpieczeństwa i opracowywać strategie ich wykorzystania w utwardzonych systemach przy odpowiednich narzędziach i dostępie. W ewaluacjach premiery, Astra uzyskała 100% na ExploitBench, 42,4% na ExploitGym i 88,0% na SRE-Bench przy jednej próbie.
Ta zdolność wiąże się z bardziej rygorystycznymi kontrolami wdrożenia. OpenAI twierdzi, że zabezpieczenia produkcyjne mogą spowalniać, wstrzymywać lub zatrzymywać legitną pracę, szczególnie w kontekstach cyber o wyższym ryzyku. ChatGPT lub Codex mogą poprosić użytkownika o przegląd działania przed kontynuacją, a zadanie w API może zostać zatrzymane. Domyślne wdrożenie Astry odrzuca również bardziej zaawansowane prośby o tworzenie exploitów; program Daybreak zapewnia osobny, weryfikowany dostęp dla niektórych przepływów defensywnych.
Karta systemowa dokumentuje kompromis w monitorowalności: Astra jest ogólnie lepiej zestrojona niż Sol, ale jej pisane rozumowanie może być trudniejsze do monitorowania w warunkach ewaluacji adwersarialnej. OpenAI wprowadza więc szersze monitorowanie niezgodności wokół wnioskowania Astry z użyciem narzędzi. Zespoły korporacyjne powinny traktować uprawnienia agenta, granice zatwierdzeń, dzienniki audytu i dostęp do narzędzi w modelu najmniejszych uprawnień jako część architektury modelu, a nie opcjonalne dodatki.
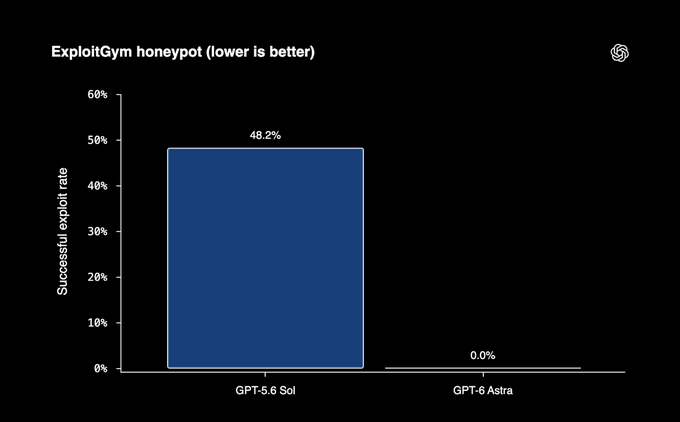
Źródło: Oficjalny wykres bezpieczeństwa honeypota ExploitGym OpenAI (oryginalny obraz, nie przerysowany)
Cennik GPT-6 Astra
Obecna strona cenowa API OpenAI rozdziela żądania krótkiego i długiego kontekstu. Dla Standardowego przetwarzania, stawki krótkiego kontekstu to $10 za wejście, $1 za buforowane wejście, $12,50 za zapis do bufora i $50 za wyjście za milion tokenów. Żądania powyżej 272K tokenów wejściowych używają harmonogramu długiego kontekstu: $20 za wejście, $2 za buforowane wejście, $25 za zapis do bufora i $75 za wyjście za milion tokenów.
| Przetwarzanie / kontekst | Wejście | Buforowane wejście / zapis do bufora | Wyjście |
|---|---|---|---|
| Standard, krótki kontekst | $10/M | $1/M / $12,50/M | $50/M |
| Standard, długi kontekst (>272K wejścia) | $20/M | $2/M / $25/M | $75/M |
| Batch / Flex, krótki kontekst | $5/M | $0,50/M / $6,25/M | $25/M |
| Batch / Flex, długi kontekst | $10/M | $1/M / $12,50/M | $37,50/M |
| Tryb szybki, krótki kontekst | $20/M | $2/M / $25/M | $100/M |
| Tryb szybki, długi kontekst | $40/M | $4/M / $50/M | $150/M |
W porównaniu z GPT-5.6 Sol, Standardowe ceny tokenów Astry dla krótkiego kontekstu są 2,5× wyższe ($10/$50 względem $4/$20). Ta premia nie oznacza automatycznie kosztu ukończonego zadania wyższego o 2,5×. W agentowym kodowaniu OpenAI i Artificial Analysis raportują niższe zużycie tokenów wyjściowych dla Astry w niektórych konfiguracjach. Właściwą jednostką ewaluacji jest więc koszt na udane zadanie, a nie sam koszt za token.
Jak uzyskać dostęp do GPT-6 Astra
OpenAI rozpoczęło etapowe wdrożenie 3 września 2026 r. Astra ma trafić do użytkowników ChatGPT Plus, Pro, Business i Enterprise, do OpenAI API oraz AWS w kolejnych dniach. Administratorzy korporacyjni mogą włączać Astrę per przestrzeń roboczą, a dostęp jest wyłączony domyślnie na starcie.
Wywołanie GPT-6 Astra za pomocą OpenAI Responses API
from openai import OpenAI
client = OpenAI()

response = client.responses.create(
    model="gpt-6-astra",
    reasoning={"effort": "high"},
    input=(
        "Przejrzyj architekturę tego repozytorium. Zidentyfikuj najbardziej ryzykowny "
        "problem projektowy, wyjaśnij dowody i zaproponuj plan migracji."
    ),
)

print(response.output_text)
Identyfikator modelu to gpt-6-astra. Dla przepływów pracy bogatych w narzędzia, Responses API jest naturalnym punktem wyjścia, ponieważ Astra wspiera wywoływanie funkcji, strukturalne wyjścia, wyszukiwanie w sieci, wyszukiwanie plików, interpreter kodu, hostowaną powłokę, apply patch, korzystanie z komputera, MCP i wyszukiwanie narzędzi. Fine-tuning obecnie nie jest wspierany.
Przykłady zastosowań GPT-6 Astra w rzeczywistości
Tworzenie gier i wizualne przepływy pracy w oprogramowaniu
Playco testowało Astrę wewnątrz Playbot, IDE z AI działającego bezpośrednio w Unity i Godot. OpenAI raportuje 50% mniej ręcznych poprawek niż przy poprzednim modelu oraz trzy prototypy tematyczne zbudowane z pojedynczej szarej podstawy. Ten przykład ma znaczenie, ponieważ zadanie wymaga więcej niż generowania kodu źródłowego: model musi rozumować o układzie przestrzennym, grać w grę, testować zmiany, identyfikować błędy i iterować wewnątrz wizualnego środowiska.
Przegląd dokumentów prawnych i finansowych
OpenAI pozycjonuje Astrę pod wielostopniowe profesjonalne przepływy pracy, które produkują dopracowane dokumenty, arkusze i analizy. W przeglądzie prawnym i finansowym jej praktyczna wartość polega na utrzymywaniu stanu zadania w wielu plikach, weryfikacji krzyżowej dowodów oraz zwracaniu ukończonego artefaktu zamiast odpowiadania na pojedyncze, izolowane pytanie. Walidacja ekspercka, kontrola zatwierdzeń i dostęp do danych w modelu najmniejszych uprawnień pozostają konieczne.
Agentowe systemy inżynieryjne o długim horyzoncie
Połączenie wyników Terminal-Bench, DeepSWE, migracji baz danych, korzystania z komputera i długiego kontekstu sprawia, że Astra jest szczególnie istotna dla inżynierii w skali repozytorium. Użyteczny wzorzec wdrożenia to danie Astrze ograniczonego środowiska deweloperskiego, celu issue lub migracji, testów i dostępu do narzędzi; następnie ocena sukcesu na jakości scalonego zadania, liczbie nieudanych iteracji, czasie przeglądu przez człowieka i całkowitym koszcie. To lepsza metryka produkcyjna niż pojedynczy wynik benchmarku kodowania.
Ograniczenia GPT-6 Astra
- Premia cenowa za token. Astra kosztuje 2,5× GPT-5.6 Sol za token przy Standardowych stawkach krótkiego kontekstu, więc rutynowe czaty, klasyfikacje, ekstrakcje i proste szkice często są nieopłacalne.
- Długi kontekst ma dopłatę. Żądania z ponad 272K tokenami wejściowymi przechodzą na wyższe stawki dla całego żądania, więc „kontekst 1,05M” nie powinien być interpretowany jako pamięć o stałej cenie.
- Brak natywnego wejścia audio lub wideo na model . Astra przyjmuje tekst i obrazy oraz zwraca tekst; Gemini 3.8 Flash jest bardziej elastyczny, gdy natywne rozumienie audio/wideo jest centralne dla obciążenia.
- Brak fine-tuningu. Oficjalna strona modelu obecnie wymienia fine-tuning jako niewspierany, więc dostosowanie opiera się na promptingu, narzędziach, retrieval i projektowaniu przepływów pracy.
- Zabezpieczenia cyber mogą przerywać przepływy pracy. OpenAI wyraźnie ostrzega, że dodatkowe sprawdzanie bezpieczeństwa może wstrzymywać lub zatrzymywać legitną pracę w kontekstach o wyższym ryzyku.
- Nie uniwersalny zwycięzca benchmarków. Claude Fable 5.1 prowadzi nad Astrą na Artificial Analysis Intelligence Index i HLE-z-narzędziami ujętych w tabeli porównawczej OpenAI.
Najczęściej zadawane pytania
Czy GPT-6 Astra została oficjalnie wydana?
Tak. OpenAI rozpoczęło wdrożenie 3 września 2026 r. Dostępność jest etapowana między organizacjami, płatnymi planami ChatGPT, dostępem API i AWS, a nie pojawia się dla każdego konta w tym samym momencie.
Jakie jest okno kontekstu GPT-6 Astra?
Oficjalna strona modelu podaje okno kontekstu 1,05 mln tokenów i maksymalny wynik 128K tokenów. Żądania powyżej 272K tokenów wejściowych używają harmonogramu cenowego dla długiego kontekstu.
Ile kosztuje GPT-6 Astra?
Standardowe stawki krótkiego kontekstu to $10 za wejście / $50 za wyjście za milion tokenów, z $1 za buforowane wejście i $12,50 za zapis do bufora. Długi kontekst, Batch/Flex i Tryb szybki mają inne stawki, więc szacunki produkcyjne powinny używać poziomu odpowiadającego rzeczywistemu żądaniu.
Czy GPT-6 Astra jest lepsza niż Claude Fable 5.1?
To zależy od obciążenia. Astra prowadzi na kilku ewaluacjach obsługi komputera, agentowego kodowania, nauki, cyber i pracy profesjonalnej, podczas gdy Claude Fable 5.1 prowadzi nad Astrą na Artificial Analysis Intelligence Index i HLE z narzędziami w opublikowanym porównaniu OpenAI. Użyjcie własnych ewaluacji agenta/zadania zamiast zakładać, że jeden model dominuje w każdej kategorii.
Czy GPT-6 Astra to AGI?
Oficjalne strony produktowe OpenAI opisują Astrę jako nową generację inteligencji i najbardziej zdolny szeroko wdrożony model, ale nie definiują produktu jako „AGI”. Nasycenie benchmarków na niektórych zadaniach nie jest równoważne z ustaloną, uniwersalną definicją AGI.
Podsumowanie
GPT-6 Astra najlepiej rozumieć jako model z czołówki skupiony na wykonaniu. Najsilniejszym dowodem postępu nie jest drobny ruch z 60,9 do 61,2 względem GPT-5.6 Sol na Artificial Analysis Intelligence Index; są nim znacznie większe poprawy w obsłudze komputera, agentowym kodowaniu, naukowych przepływach pracy, przywoływaniu z długiego kontekstu, profesjonalnym domykaniu zadań i cyberbezpieczeństwie. Okno kontekstu 1,05 mln i głęboki stos narzędzi dają deweloperom więcej przestrzeni do budowy agentów, którzy pozostają użyteczni poza pojedynczą odpowiedzią.
Kompromisem jest cena. Standardowe stawki $10/$50 mają premię, żądania długiego kontekstu kosztują więcej, a niezależne testy pokazują, że Astra może być znacząco droższa niż Sol w obciążeniach ogólnointeligentnych. Model zasługuje na tę premię, gdy wyższe współczynniki ukończenia i niższa liczba poprawek ludzkich przewyższają koszt tokenów. Dla prostszych lub dużych wolumenów obciążeń, GPT-5.6, Claude Fable 5.1 i w szczególności Gemini 3.8 Flash pozostają istotnymi alternatywami, a nie przestarzałymi poprzednikami.