Construa com CometAPIPrecisa de uma API para vários modelos?Teste o fluxo no Playground e depois crie uma chave da API quando o modelo e o custo atenderem ao seu caso de uso.
Como usar a DeepSeek V4.1 Flash API com a CometAPI usando cURL, Python e JavaScript. Explore o modo de raciocínio, a entrada, o streaming e as práticas de produção.
Mia MarenEquipe de pesquisa de modelos e API de IA
Para desenvolvedores usando a API do DeepSeek V4.1 Flash na CometAPI, a integração prática é compatível com OpenAI: use https://api.cometapi.com/v1 como a URL base, defina o modelo como deepseek-v4.1-flash e chame a interface padrão de Chat Completions.
Uma diferença de nomenclatura importa: a API de primeira parte da DeepSeek usa deepseek-flash, enquanto a CometAPI usa deepseek-v4.1-flash. Trate os identificadores de modelo como configuração específica do provedor.
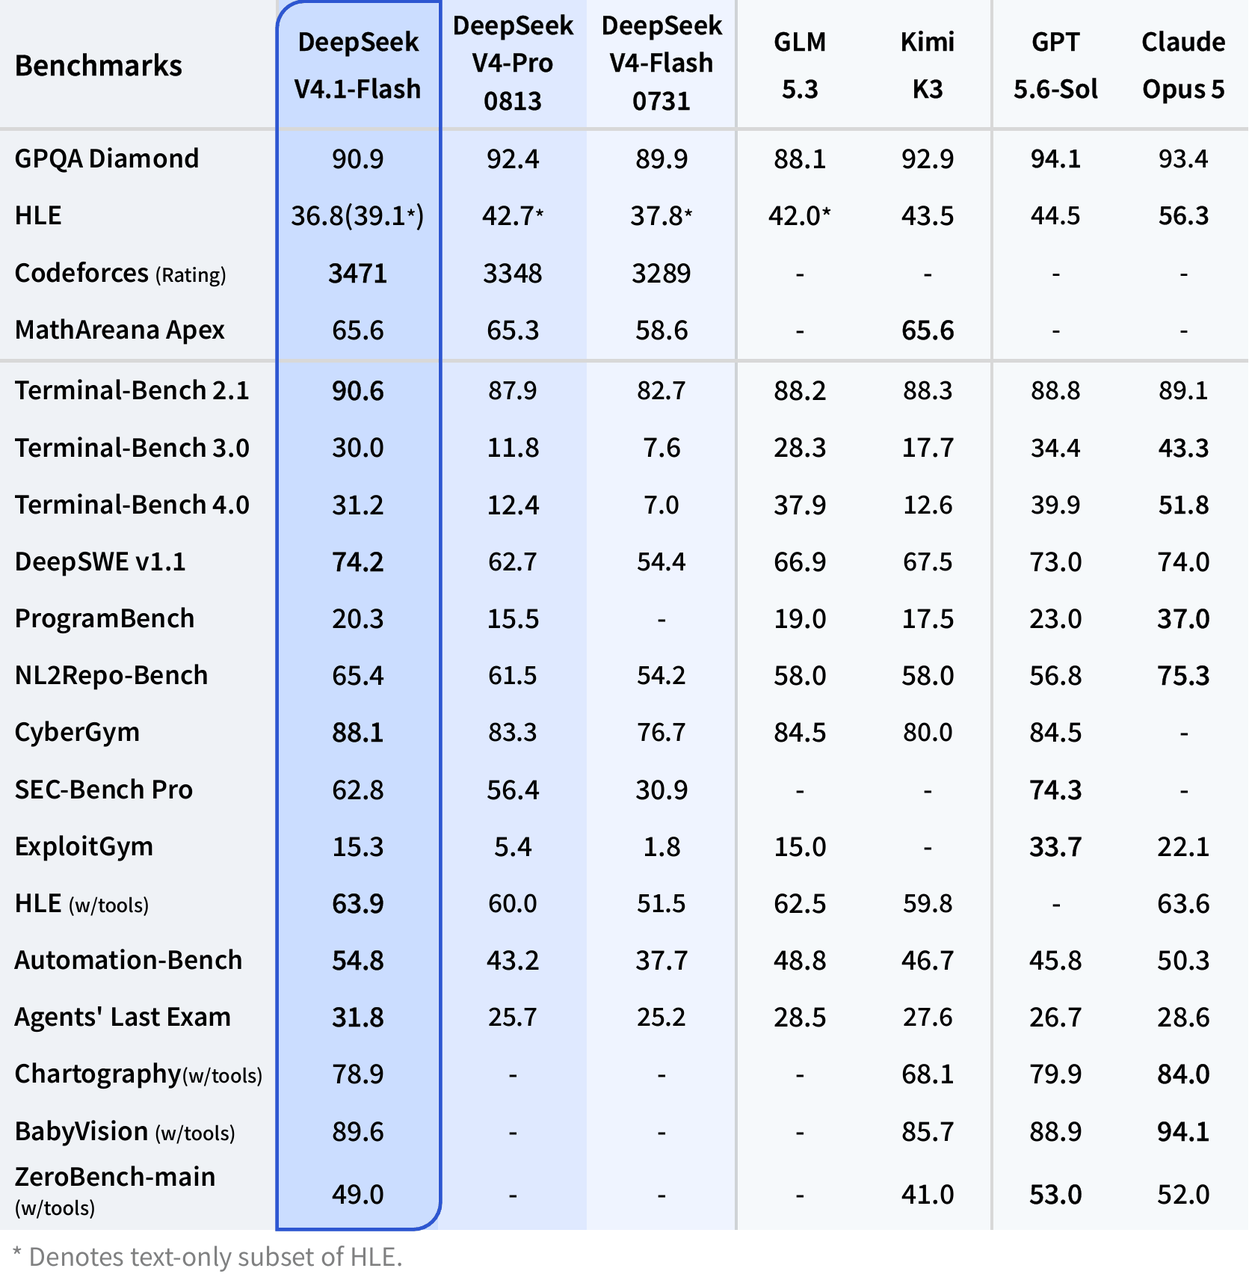
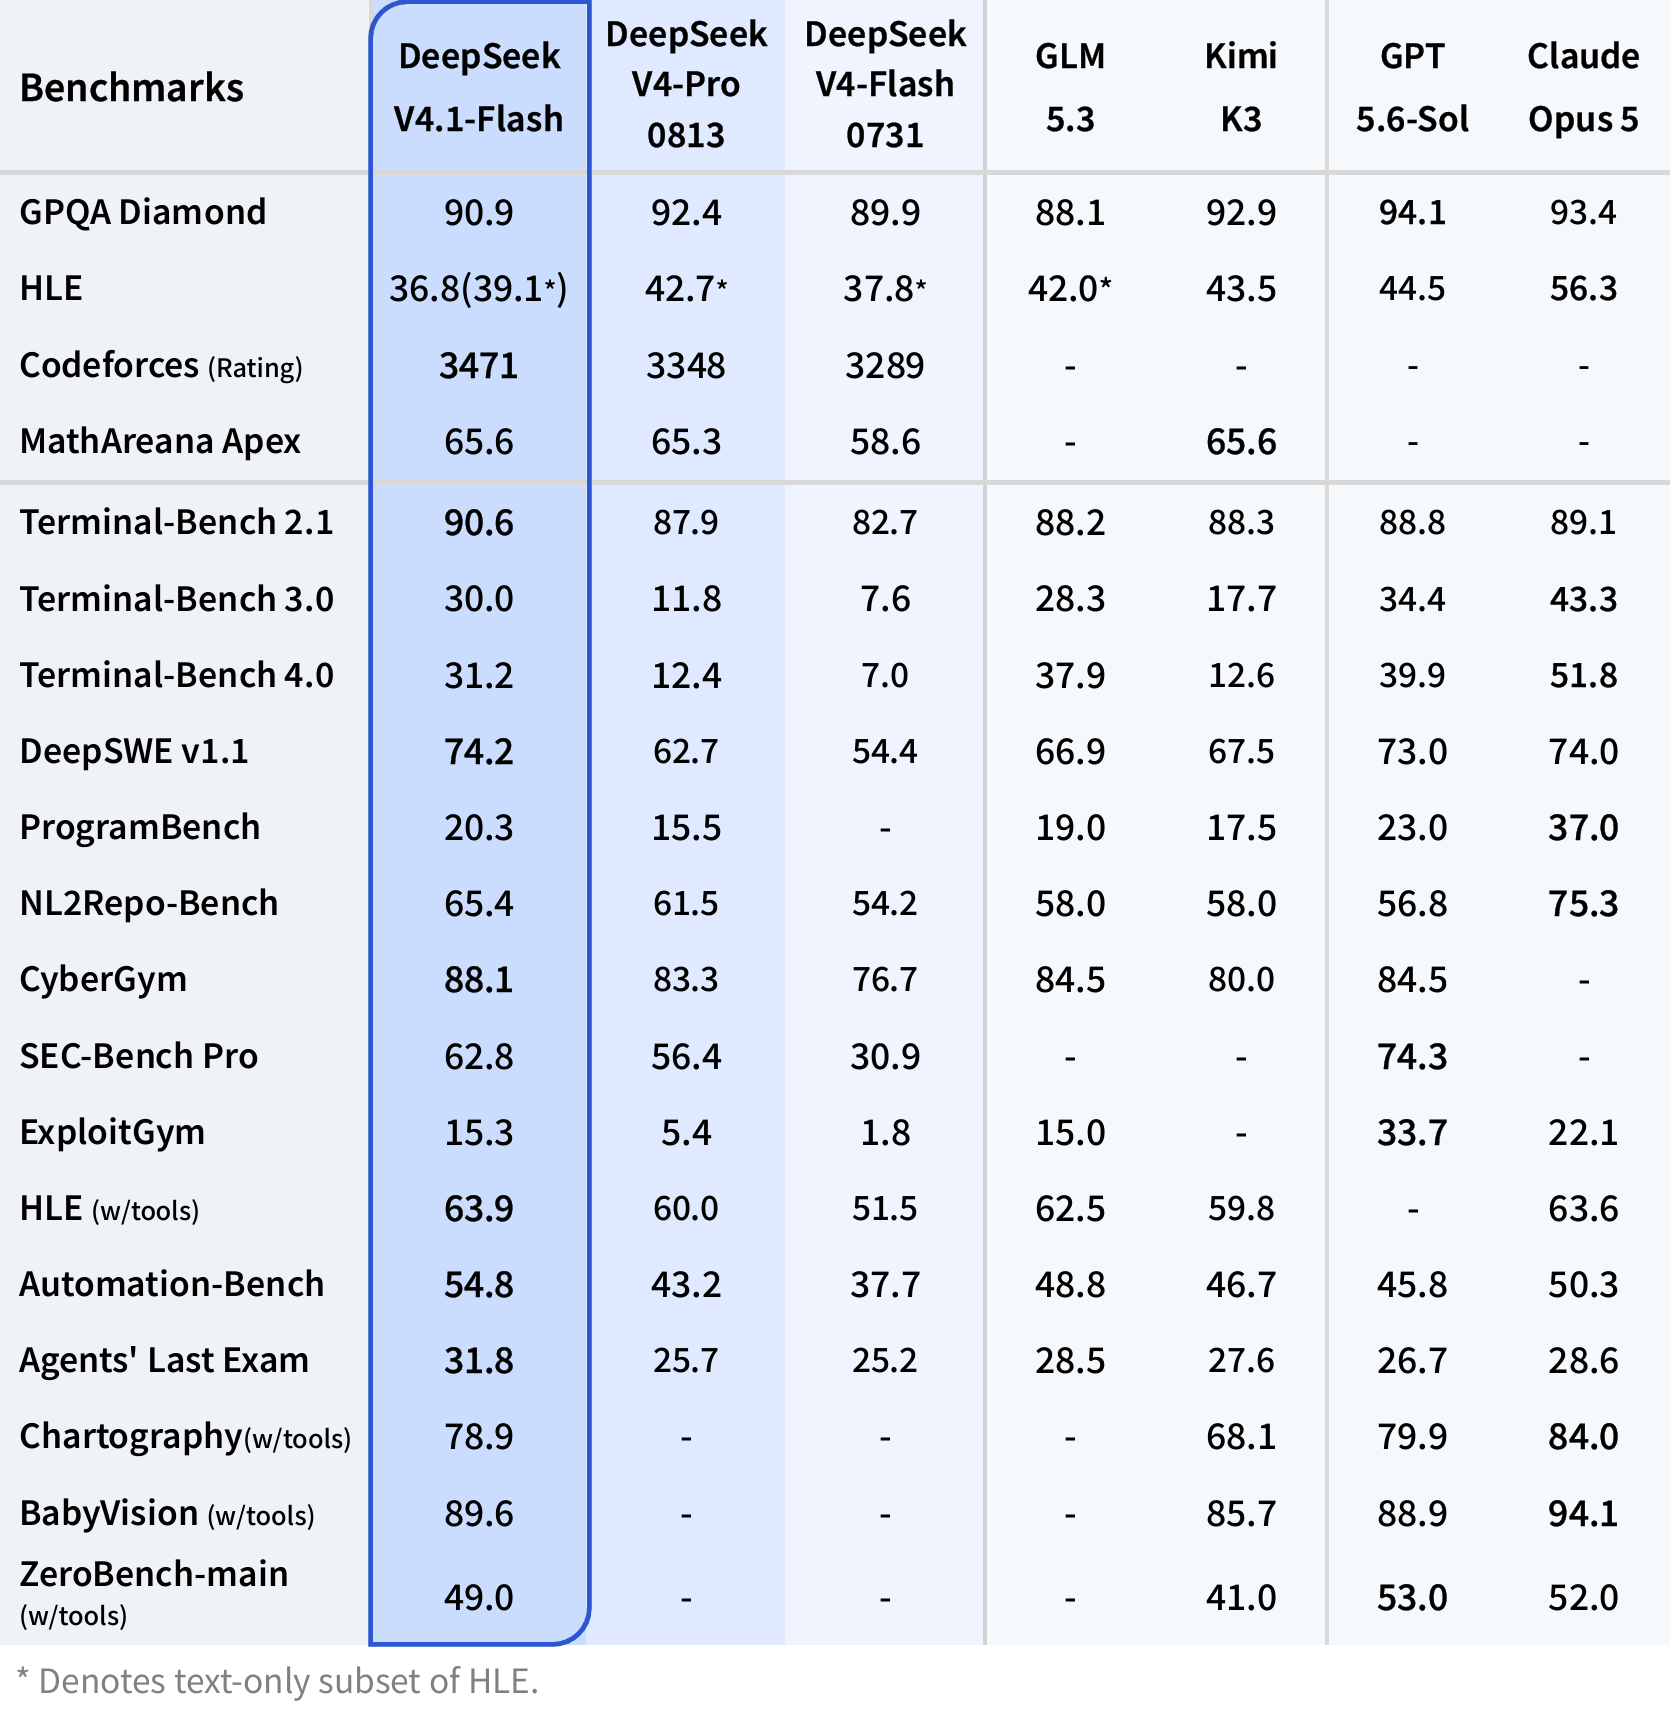
As maiores diferenças medidas concentram-se em benchmarks de coding, terminal, repositório, automação e agentes com ferramentas.
Antes da implantação em produção, valide campos avançados como controles de thinking, cargas de visão, streaming, tool calls e saída estruturada exatamente na rota do provedor que você irá usar.
O que é a API DeepSeek V4.1 Flash?
DeepSeek V4.1 Flash é o mais recente modelo Flash construído sobre uma arquitetura Mixture-of-Experts com 552B de parâmetros. Seu design Causal Encoder-Decoder ativa 8B de parâmetros para processamento de entrada e 16B para geração de saída.
Para planejamento de integração, a API oficial da DeepSeek expõe uma janela de contexto de 1M tokens e uma saída máxima de 384K tokens. O serviço upstream oferece suporte às APIs de Chat Completions e Responses compatíveis com OpenAI, uma API compatível com Anthropic, streaming, saída JSON, chamadas de ferramenta e entrada de imagem nativa. Este guia usa a rota de Chat Completions da CometAPI, portanto verifique o repasse de recursos nessa rota antes da implantação em produção.
Especificação
Detalhes da API oficial DeepSeek V4.1 Flash
Arquitetura
552B MoE, Causal Encoder-Decoder
Parâmetros ativos
8B para entrada; 16B para saída
Comprimento de contexto
1M tokens
Saída máxima
384K tokens
Interfaces
Chat Completions, Responses API, API compatível com Anthropic
Streaming
Suportado
Saída estruturada
Saída JSON e JSON Schema nos endpoints compatíveis
Chamadas de ferramenta
Suportadas, incluindo uso de ferramentas em modo thinking
Entrada de visão
JPEG, PNG, GIF e WebP
Limites de imagem
32 MiB inline; 64 MiB por arquivo; até 600 imagens por requisição
ID do modelo de primeira parte
deepseek-flash
ID do modelo na CometAPI
deepseek-v4.1-flash
Nota do provedor: IDs de modelo e campos avançados de requisição são específicos de rota. Use deepseek-v4.1-flash para os exemplos da CometAPI neste guia e teste visão, tool calls, saída estruturada e controles de thinking no endpoint implantado.
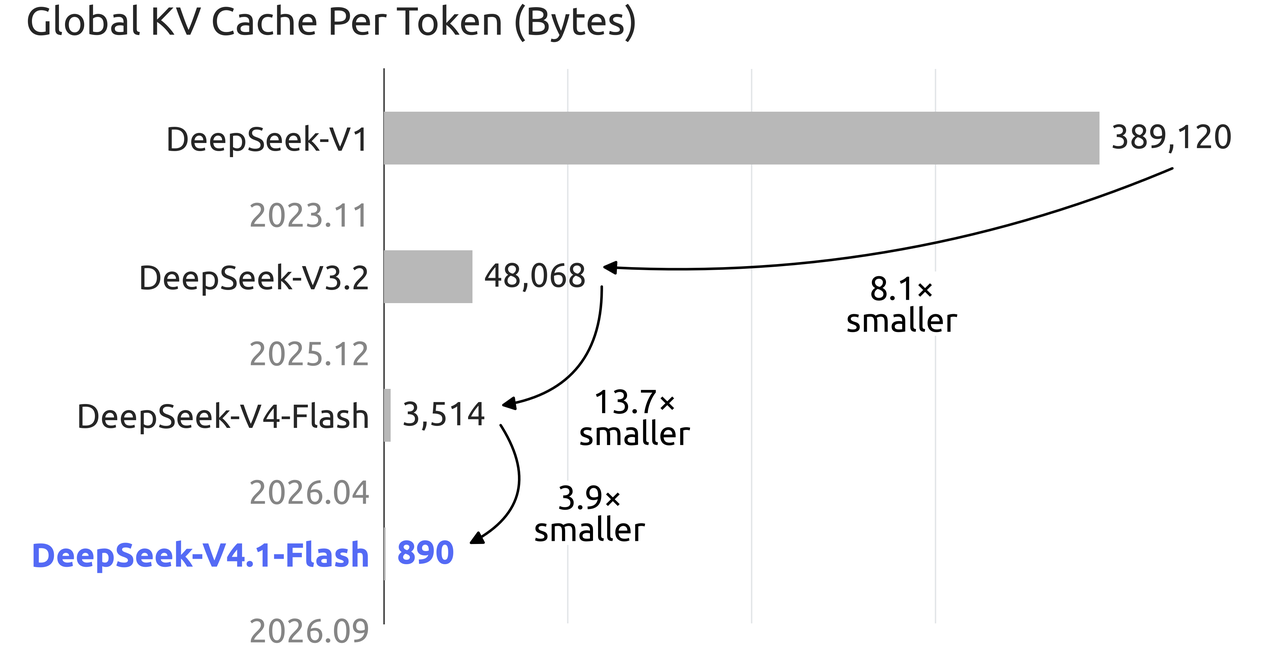
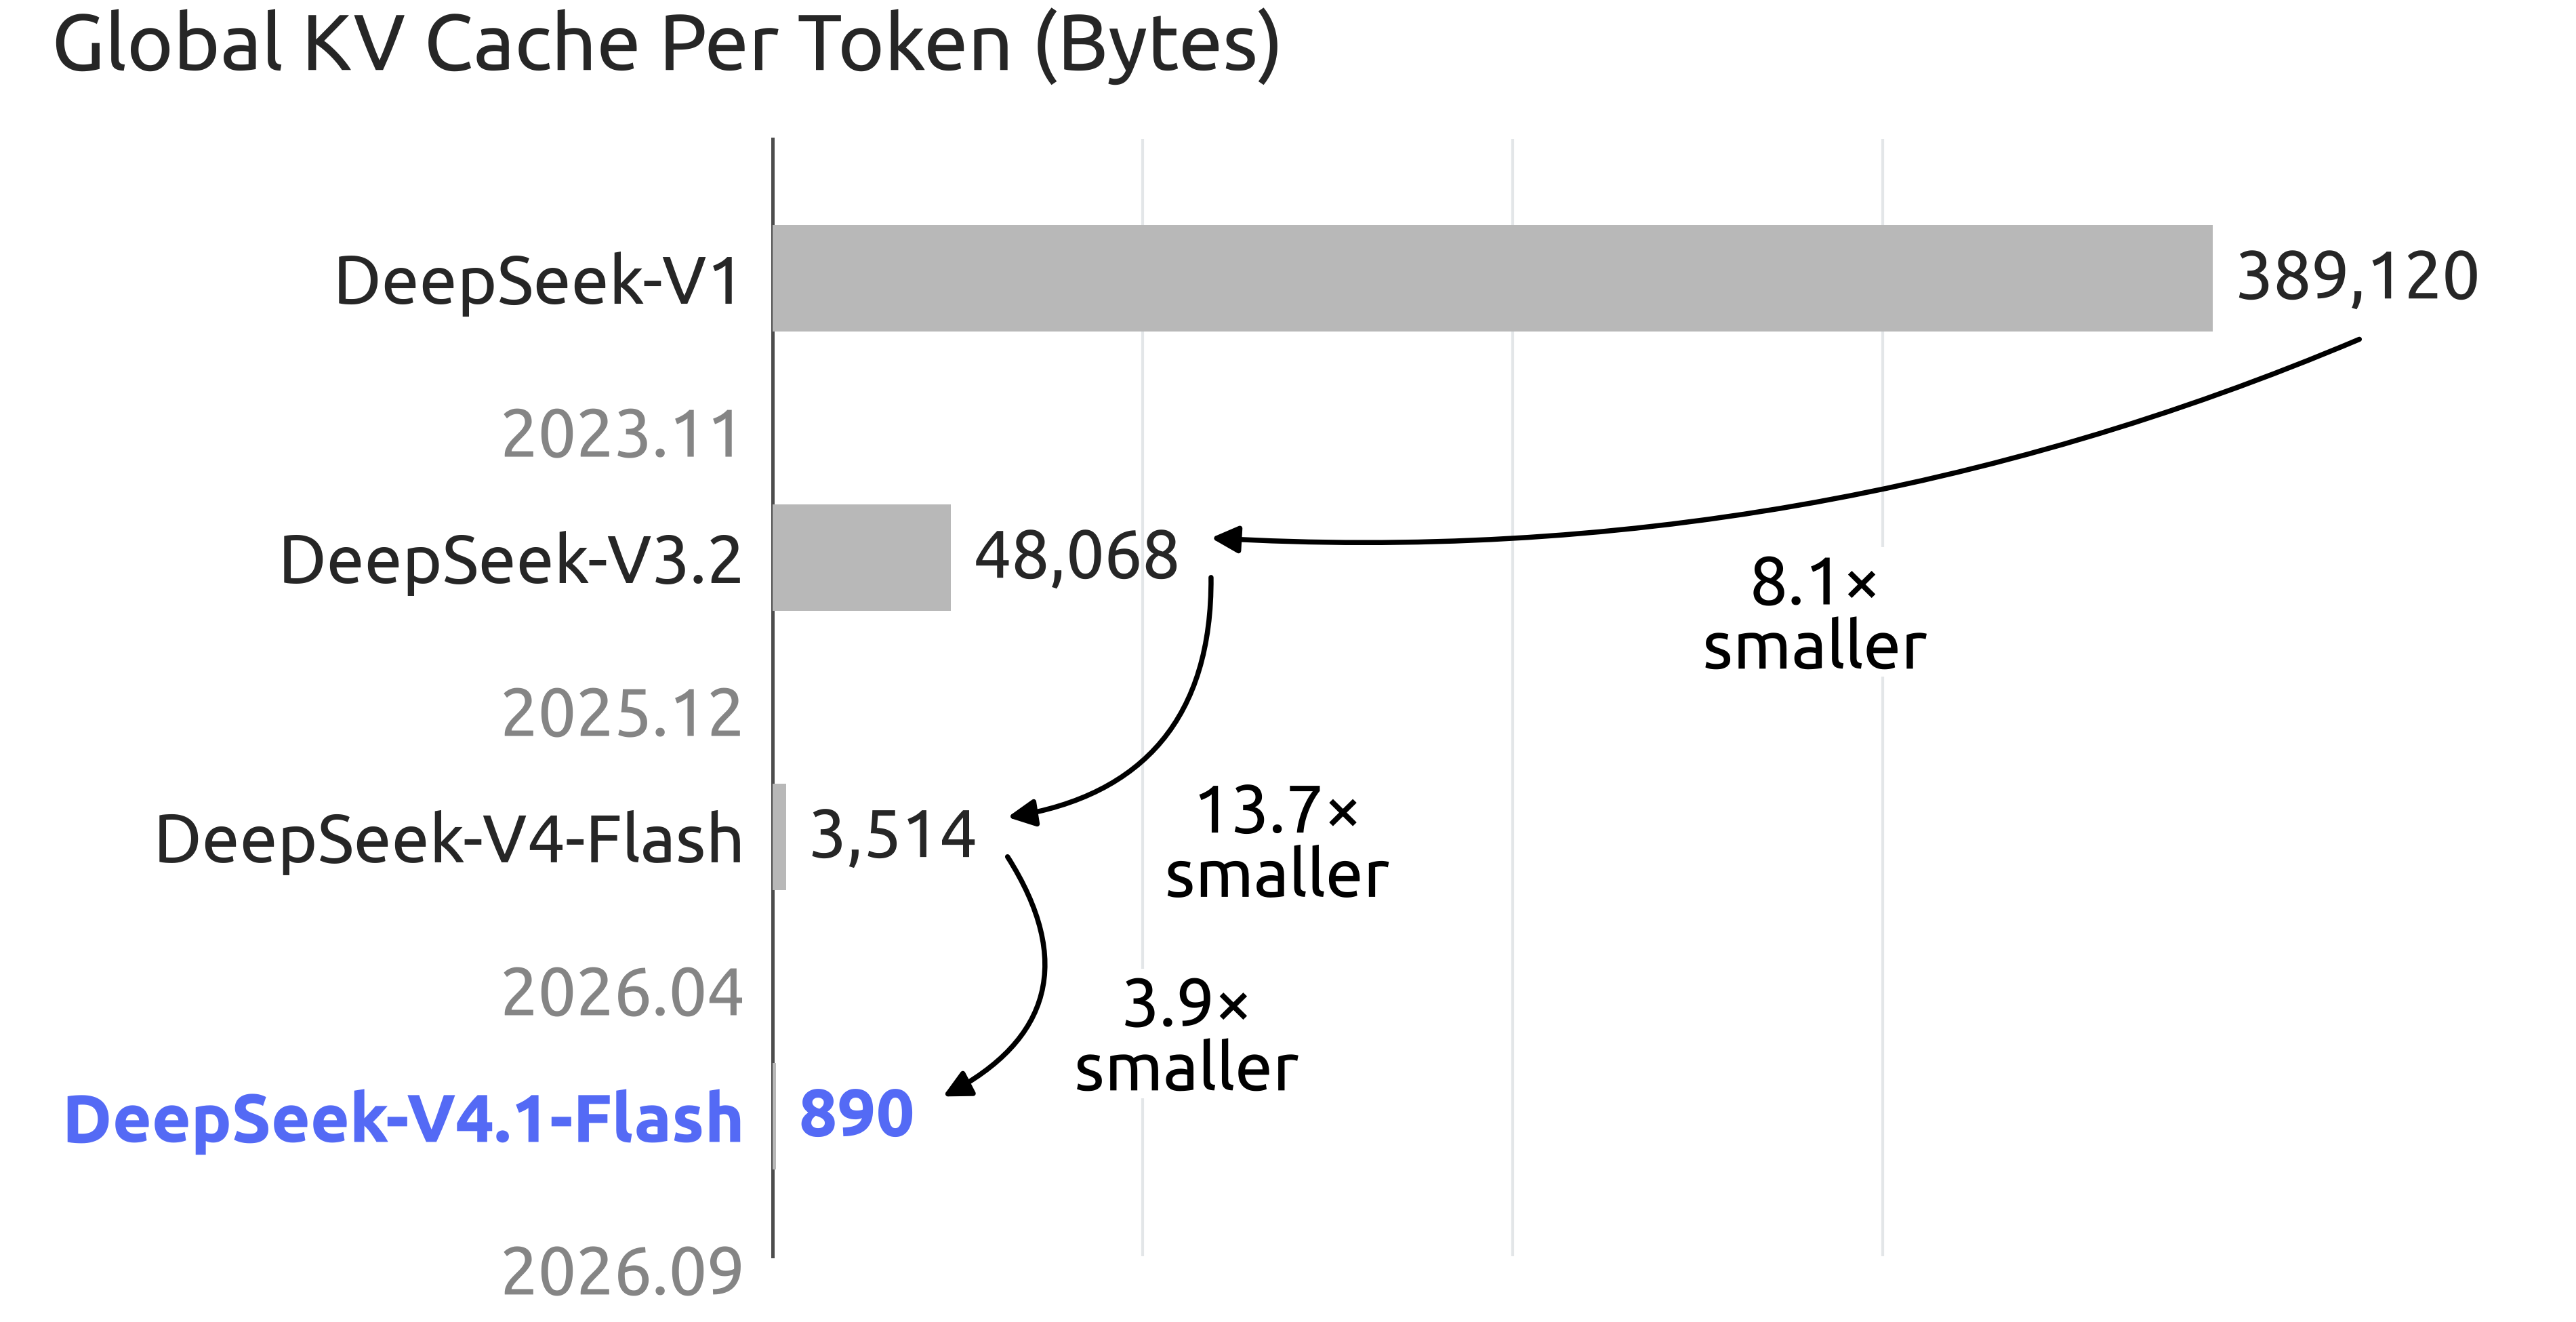
A DeepSeek também informa que o cache KV global é de cerca de 890 bytes por token, versus 3.514 bytes por token na geração anterior V4 Flash. Essa redução importa principalmente para agentes de longa execução que reutilizam repetidamente prompts grandes, esquemas de ferramentas e histórico de conversas.
Quão forte é o DeepSeek V4.1 Flash para coding e agentes de IA?
Este guia foca em evidências de benchmark que informam diretamente a seleção de API. A DeepSeek caracteriza o V4.1 Flash como superando modelos flagship, incluindo o V4 Pro, em seu pacote de avaliações publicado. Os ganhos mais acionáveis aparecem em trabalho de terminal, engenharia de software, tarefas em repositórios, automação e agentes com ferramentas; equipes de produção ainda devem validar o modelo com seus próprios prompts e critérios de conclusão.
Benchmark
DeepSeek V4.1 Flash
DeepSeek V4 Pro
DeepSeek V4 Flash
GPQA Diamond
90.9
92.4
89.9
Terminal-Bench 2.1
90.6
87.9
82.7
DeepSWE v1.1
74.2
62.7
54.4
NL2Repo-Bench
65.4
61.5
54.2
HLE with tools
63.9
60.0
51.5
Automation-Bench
54.8
43.2
37.7
Agents' Last Exam
31.8
25.7
25.2
A conclusão prática é mais estreita do que “V4.1 é mais inteligente”. O DeepSeek V4.1 Flash é especialmente atraente para uso repetido de ferramentas, ações de terminal, coding em escala de repositório, automação e trajetórias longas de agentes. Cargas de trabalho puramente de conhecimento ou raciocínio podem produzir uma classificação diferente.
Por que usar a API DeepSeek V4.1 Flash via CometAPI?
A principal vantagem de integração é que a API DeepSeek V4.1 Flash na CometAPI pode ser chamada pelo mesmo padrão de cliente compatível com OpenAI usado para outros modelos, reduzindo a troca de SDKs em aplicativos multi-modelo.
Configuração
Valor
URL base
https://api.cometapi.com/v1
Endpoint de chat
/chat/completions
ID do modelo
deepseek-v4.1-flash
Autenticação
Chave de API Bearer
SDK Python
Compatível com SDK OpenAI
SDK JavaScript
Compatível com SDK OpenAI
Isso também evita um erro comum de integração: copiar o identificador de primeira parte da DeepSeek em uma requisição da CometAPI. As rotas dos provedores referem-se à mesma família de modelos, mas os IDs documentados são diferentes.
Crie uma chave de API da CometAPI, armazene-a em uma variável de ambiente e configure a URL base compatível com OpenAI como https://api.cometapi.com/v1. Não incorpore credenciais de produção no código-fonte.
Use o identificador de modelo da CometAPI deepseek-v4.1-flash com o endpoint padrão de Chat Completions.
curl "https://api.cometapi.com/v1/chat/completions"
  -H "Content-Type: application/json"
  -H "Authorization: Bearer ${COMETAPI_KEY}"
  -d '{
    "model": "deepseek-v4.1-flash",
    "messages": [
      {
        "role": "user",
        "content": "Explain three ways to reduce latency in a high-throughput API service."
      }
    ]
  }'
Uma resposta bem-sucedida usa a estrutura familiar de completion no estilo OpenAI, então aplicações que já leem choices[0].message.content exigem migração mínima.
Exemplo com SDK Python
pip install openai
``````python
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[
        {
            "role": "user",
            "content": "Write a Python retry helper with exponential backoff."
        }
    ],
)

print(response.choices[0].message.content)
Para produção, adicione timeouts explícitos, tentativas limitadas, registro de requisições e monitoramento de uso.
Exemplo com SDK JavaScript
npm install openai
``````js
import OpenAI from "openai";

const client = new OpenAI({
  apiKey: process.env.COMETAPI_KEY,
  baseURL: "https://api.cometapi.com/v1",
});

const response = await client.chat.completions.create({
  model: "deepseek-v4.1-flash",
  messages: [
    {
      role: "user",
      content: "Create a typed rate limiter interface for an Express API."
    }
  ],
});

console.log(response.choices[0].message.content);
A abstração do cliente permanece inalterada enquanto a URL base e o ID do modelo tornam-se configuração do provedor.
Recursos da API DeepSeek V4.1 Flash
Configure raciocínio e modo thinking
A DeepSeek documenta operação com e sem thinking. Ao rotear pela CometAPI, verifique se os campos específicos do fornecedor são repassados exatamente como esperado antes de depender deles como contrato de produção.
Teste cada nível de esforço suportado em relação às suas metas de latência, uso de tokens e conclusão de tarefas, pois os mapeamentos do provedor podem diferir.
Analise imagens com entrada de visão
O DeepSeek V4.1 Flash aceita imagens JPEG, PNG, GIF e WebP. Os limites oficiais incluem 32 MiB por imagem inline, 64 MiB por imagem baseada em arquivo, até 600 imagens por requisição e um limite de 8.192 caracteres para URLs de imagem externas. As imagens pertencem a mensagens de user ou developer, não de system ou assistant.
response = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[
        {
            "role": "user",
            "content": [
                {"type": "text", "text": "Identify the three most important anomalies."},
                {
                    "type": "image_url",
                    "image_url": {"url": "https://example.com/dashboard.png"}
                }
            ]
        }
    ],
)
Valide tamanho da imagem, acessibilidade da URL, pré-processamento, uso de tokens e latência exatamente na rota da CometAPI usada em produção.
Faça streaming de respostas com SSE
O streaming reduz a latência percebida ao entregar saída incremental para interfaces interativas de coding, chat e agentes.
stream = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[
        {
            "role": "user",
            "content": "Explain distributed-cache invalidation."
        }
    ],
    stream=True,
)

for chunk in stream:
    if chunk.choices and chunk.choices[0].delta.content:
        print(chunk.choices[0].delta.content, end="", flush=True)
Clientes de produção devem lidar com streams interrompidos, deltas vazios, recuperação de timeout, limites de repetição e contabilização final de uso.
Quanto custa a API DeepSeek V4.1 Flash?
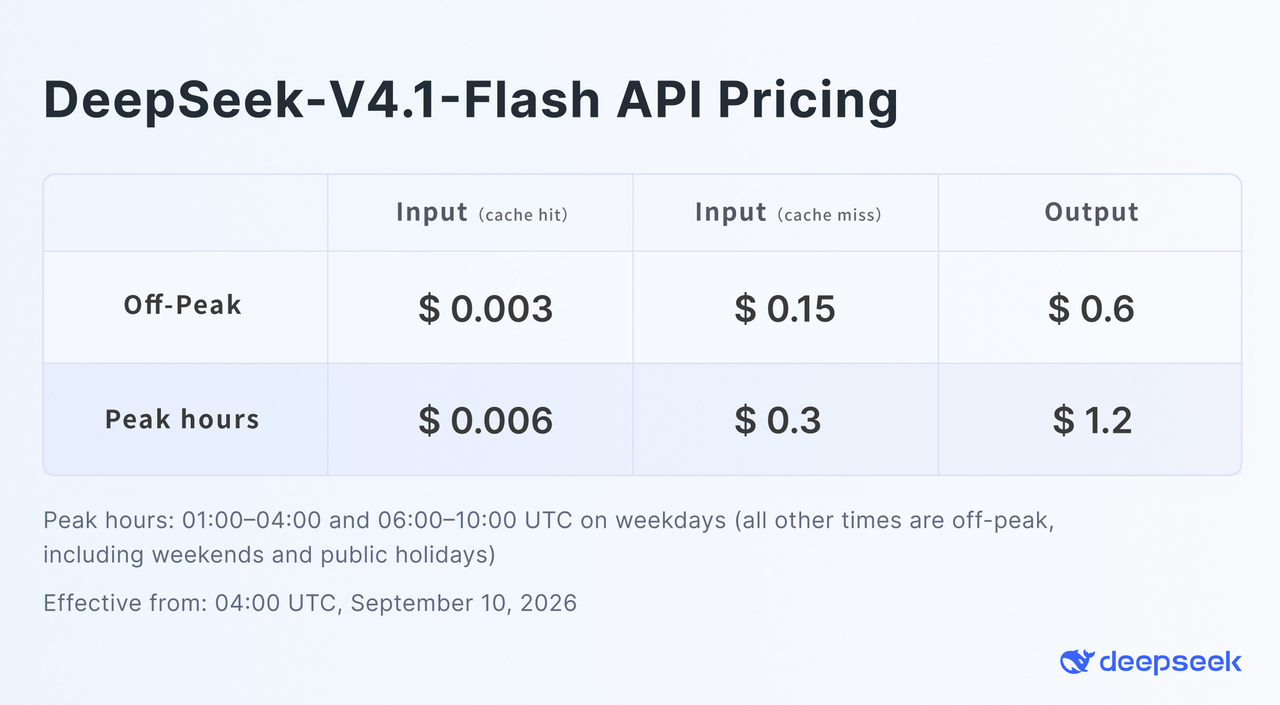
A precificação documentada da API da DeepSeek usa janelas de pico e fora de pico. A imagem oficial de preços mostra taxas off-peak de $0.003/M para entrada com acerto de cache, $0.15/M para entrada com cache miss e $0.60/M para saída; em horários de pico, as taxas dobram.
Um exemplo simples com tarifa base para 100M tokens de entrada (cache miss) e 20M tokens de saída é:
Entrada:
100 x $0.12 = $12.00

Saída:
20 x $0.48 = $9.60

Custo base total:
$21.60
O custo real em produção depende da mistura de tokens em cache, multiplicadores de pico, condições de requisição e a tarifa atual do provedor. A grande diferença entre preços de cache hit e cache miss torna prefixos reutilizáveis estáveis — instruções de system, esquemas de ferramentas e contexto comum — uma alavanca importante de custo.
API DeepSeek V4.1 Flash vs V4 Pro vs V4 Flash
Dimensão
DeepSeek V4.1 Flash
DeepSeek V4 Pro
DeepSeek V4 Flash
Posicionamento primário
Raciocínio eficiente, agentes, visão
Raciocínio V4 de alto nível
Camada V4 rápida anterior
Visão nativa
Sim
Dependente do modelo/rota
Rota de visão separada na geração anterior
Thinking
Sim
Sim
Sim
Desempenho em agentes
Mais forte dos três em muitos testes de agentes publicados
informa que o DeepSeek V4 Pro permanece disponível após 14 de setembro de 2026, com faturamento inalterado. Verifique a documentação ao vivo antes de depender de comportamento de roteamento ou migração.
O que testar antes de colocar a API DeepSeek V4.1 Flash em produção?
Roteamento de modelo: confirme deepseek-v4.1-flash na CometAPI e mantenha IDs específicos do provedor na configuração, não na lógica da aplicação.
Regressão de prompt: execute prompts representativos de produção e compare conclusão de tarefas, não apenas scores de benchmarks.
Saída estruturada: valide cada resposta JSON contra o schema da aplicação e defina um caminho de reparo ou retry.
Chamadas de ferramenta: teste tipos de argumentos, chamadas malformadas, chamadas paralelas e condições de término de loop.
Controles de thinking: verifique quais campos a CometAPI repassa e meça o impacto de latência e tokens de cada configuração.
Visão: teste capturas de tela e documentos reais, incluindo limites de tamanho, URLs inacessíveis e papéis de mensagem não suportados.
Streaming: lide com deltas vazios, conexões interrompidas, limites de retry e contabilização final de uso.
Longo contexto e caching: meça qualidade de resposta, taxa de cache hit e custo conforme o prompt cresce.
Confiabilidade: registre latência p50, p95 e p99; exercite 429, 5xx, timeout e caminhos de fallback.
Controle de custos: rastreie tokens de entrada, entrada em cache, raciocínio e saída por tarefa concluída.
Para cargas de agentes, compare o custo por tarefa concluída — não apenas dólares por milhão de tokens. Um modelo pode ser mais caro por token de saída e ainda assim ser mais barato ponta a ponta se reduzir retries e chamadas de ferramentas; o inverso também é verdadeiro quando maior esforço de raciocínio adiciona tokens sem melhorar a conclusão da tarefa.
Vale a pena usar a API DeepSeek V4.1 Flash?
Para novas integrações com DeepSeek, o DeepSeek V4.1 Flash é um forte candidato padrão para a família Flash porque combina melhor desempenho publicado em agentes com visão nativa e preços agressivos.
Seus casos de uso mais fortes não são apenas chat genérico. O melhor ajuste são agentes de coding, engenharia de software automatizada, análise de longo contexto, assistentes multimodais, automação de alto volume e agentes que usam ferramentas, onde o contexto reutilizado pode dominar o custo total.
Para desenvolvedores que desejam manter uma arquitetura de SDK no estilo OpenAI, a API DeepSeek V4.1 Flash na CometAPI oferece o padrão de integração usado ao longo deste guia: mantenha a interface de cliente padrão, aponte para https://api.cometapi.com/v1 e use deepseek-v4.1-flash.
FAQ da API DeepSeek V4.1 Flash
Como devo organizar os IDs de modelo específicos de cada provedor?
Armazene o provedor, a URL base e o ID do modelo juntos na configuração específica do ambiente. Isso evita que um ID de primeira parte, como deepseek-flash, seja enviado por engano para uma rota da CometAPI que espera deepseek-v4.1-flash.
Como posso melhorar a reutilização de cache em agentes de longa execução?
Mantenha instruções de system estáveis, esquemas de ferramentas e contexto de referência compartilhado no início do prompt. Acrescente entradas voláteis do usuário e resultados de ferramentas depois, para que o prefixo reutilizável mude menos.
Qual é a maneira mais segura de comparar V4.1 Flash com V4 Pro?
Reproduza o mesmo conjunto de tarefas de produção, limite orçamentos de retry e compare taxa de conclusão, latência, contagem de tool calls e total de tokens. Um preço menor por token não garante menor custo por tarefa bem-sucedida.
Qual política de fallback um agente deve usar?
Defina quais falhas são reexecutáveis, estabeleça um teto estrito de retries e selecione um modelo de fallback apenas após preservar o estado de ferramenta necessário para retomar com segurança. Registre todo fallback para que desvios silenciosos de qualidade fiquem visíveis.
Como as entradas de imagem devem ser validadas antes do envio?
Verifique a assinatura real do arquivo, formato suportado, tamanho em bytes, acessibilidade da URL e papel da mensagem. Remova metadados desnecessários e evite enviar imagens sensíveis, a menos que suas políticas de retenção e acesso permitam explicitamente.
Quando devo considerar a Responses API em vez de Chat Completions?
Use Chat Completions ao manter um fluxo de mensagens compatível com OpenAI existente. Considere a Responses API quando a aplicação se beneficiar de itens de entrada tipados, imagens de saída de ferramenta ou saída via JSON Schema; então confirme que a rota do provedor selecionada suporta os campos exigidos.
Como devo lidar com falhas de validação de schema?
Rejeite a saída inválida antes que ela alcance sistemas downstream, registre o erro de validação e faça retry com um prompt de reparo limitado. Se reparos repetidos falharem, encaminhe a tarefa para um fallback seguro em vez de aceitar JSON plausível porém inválido.