Solutions Choose your path
For individuals Build, learn, and create with simple usage-based access. For business Scale teams, billing, governance, and model workflows. More English 繁體中文 日本語 한국어 Français Deutsch Español Italiano Português Русский العربية ไทย Tiếng Việt Bahasa Indonesia Bahasa Melayu Türkçe Polski Nederlands Danish Norsk Қазақ اردو
เริ่มต้นฟรี เริ่มต้นฟรี
500+ AI Model API, All In One API.
Just In CometAPI © 2026 CometAPI · All rights reserved
Home Blog GLM-6.0: โรดแมปการฝึกด้วยตนเองแบบเต็มรูปแบบของ Z.AI บอกอะไรกับเราอย่างแท้จริง ai-model / งานวิจัย CometAPI
GLM-6.0: โรดแมปการฝึกด้วยตนเองแบบเต็มรูปแบบของ Z.AI บอกอะไรกับเราอย่างแท้จริง ข้อมูลที่ Z.AI เปิดเผยเกี่ยวกับ GLM 6.0, Full Self-Training, ลูปการฝึกแบบรีเคอร์ซีฟ, เกณฑ์มาตรฐานของ GLM ในปัจจุบัน และข้อเท็จจริงที่ยังไม่ครบถ้วนก่อนการเปิดตัว
Mia Maren ทีมวิจัยโมเดล AI และ API ข้อมูลที่ Z.AI เปิดเผยเกี่ยวกับ GLM 6.0, Full Self-Training, ลูปการฝึกแบบรีเคอร์ซีฟ, เกณฑ์มาตรฐานของ GLM ในปัจจุบัน และข้อเท็จจริงที่ยังไม่ครบถ้วนก่อนการเปิดตัว
ใช้สรุปนี้เพื่อดูคำตอบอย่างรวดเร็ว แล้วอ่านคู่มือเพื่อดูบริบท ตัวอย่าง และรายละเอียดการใช้งาน
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_COMETAPI_KEY",
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="gpt-5-mini",
    messages=[{"role": "user", "content": "Build this workflow."}],
)

print(response.choices[0].message.content)TL;DR
Z.AI ได้ประกาศชื่อ GLM-6.0 ต่อสาธารณะและวาง Full Self-Training ไว้เป็นแกนกลางของโรดแมปรุ่นถัดไป ทิศทางที่เปิดเผยเชื่อมโยง “ประสบการณ์ที่โมเดลสร้างเอง” ตลอดช่วงก่อนการฝึก ช่วงกลางการฝึก และช่วงหลังการฝึก เข้ากับการประเมินและการแก้ไขด้วยตนเอง เปลี่ยนการฝึกให้เป็นวงป้อนกลับที่ถูกกำกับแทนที่จะเป็นเพียงการสร้างข้อมูลแบบครั้งเดียว
ความท้าทายคือการควบคุม: GLM-6.0 จำเป็นต้องทำความสะอาดข้อมูลสังเคราะห์ ตรวจจับและซ่อมแซมข้อผิดพลาด หยุดการวนซ้ำที่ไม่ก่อผล และป้องกันไม่ให้ตัวประเมินให้รางวัลกับทางลัด กลไกเหล่านี้ก่อให้เกิดคำถามเชิงปฏิบัติเกี่ยวกับการตรวจสอบโดยอิสระ ความปลอดภัย ต้นทุน และธรรมาภิบาล เนื่องจากยังไม่มี model card ชุดเบนช์มาร์ก สเปก API ราคา หรือวันเปิดตัวที่เปิดเผยต่อสาธารณะ บทความนี้จึงประเมินสถาปัตยกรรมการฝึกและหลักฐานที่มีอยู่ ไม่ใช่สเปกที่คาดเดา
Key Takeaways for GLM 6.0?
หลักฐานสาธารณะที่แข็งแรงที่สุดเกี่ยวข้องกับระบบ Full Self-Training ไม่ใช่จำนวนพารามิเตอร์หรือผลเบนช์มาร์กที่รั่วไหล
ทิศทางที่เปิดเผยครอบคลุมข้อมูลที่ผลิตเอง การสร้างสภาพแวดล้อมการฝึกด้วยตนเอง และการเพิ่มประสิทธิภาพโครงสร้างพื้นฐานโดยมีโมเดลช่วย
เรียนรู้ต่อ
เชื่อมโยงบทความนี้กับการตัดสินใจถัดไป ดูทุกหัวข้อ เผยแพร่เมื่อ Sep 15, 2026 อัปเดตล่าสุด Sep 15, 2026 ตรวจสอบความชัดเจน การอ้างอิงแหล่งที่มา และคำศัพท์ API ปัจจุบันแล้ว
วงป้อนกลับที่ตั้งใจไว้ครอบคลุมก่อนการฝึก ช่วงกลางการฝึก และหลังการฝึก แทนที่จะมองว่า self-training เป็นเทคนิคเฉพาะช่วงหลังการฝึก
การสร้างโมเดลมัลติโหมดโดยกำเนิด การเรียนรู้แบบเสริมกำลังที่มีขอบเขตเวลายาวขึ้น การวางแผน การใช้เครื่องมือ การกู้คืน และการตรวจสอบ เป็นทิศทางวิจัยที่เกี่ยวข้อง แต่ยังไม่ใช่สเปกที่เผยแพร่ของ GLM 6.0
Ox Alpha ไม่ใช่หลักฐานของประสิทธิภาพ GLM 6.0 ที่รั่วไหล; Z.AI ระบุว่าเป็นตัวตนก่อนเปิดตัวของ GLM-5.3-Flash
What Has Z.AI Actually Confirmed About GLM 6.0? ข้อมูลสาธารณะของ Z.AI ยืนยันสัญญาณที่เป็นรูปธรรมสี่ประการ: ชื่อ GLM-6.0, Full Self-Training เป็นทิศทางการฝึกหลัก, วงป้อนกลับที่ตั้งใจครอบคลุมก่อน ช่วงกลาง และหลังการฝึก และกลไกการประเมินและการแก้ไขด้วยตนเอง บริษัทยังระบุว่าประมาณ 60% ของรายได้สุทธิที่ได้รับตั้งใจจะสนับสนุนโมเดลรุ่นถัดไป, Full Self-Training, การฝึกขนาดใหญ่, การอนุมาน, คอมพิวต์ และโครงสร้างพื้นฐานที่เกี่ยวข้อง
Z.AI’s Full Self-Training Framework Full Self-Training ถูกเสนอให้เป็นแนวคิดหลักของ GLM-6.0 ไม่ใช่ฟีเจอร์เล็กๆ เฉพาะช่วงหลังการฝึก ระบบที่ตั้งใจไว้จะสร้างประสบการณ์การฝึก เรียนรู้จากผลลัพธ์ กรองตัวอย่างที่อ่อน และทำซ้ำวงจรภายใต้การควบคุมคุณภาพอย่างชัดเจน
GLM-6.0 Self-Training Across Pre-, Mid-, and Post-Training ลำดับที่เปิดเผย—ก่อนการฝึก ช่วงกลางการฝึก และหลังการฝึก—บ่งชี้ว่าประสบการณ์ที่สร้างเองอาจมีอิทธิพลต่อความรู้พื้นฐาน การหล่อหลอมขีดความสามารถ และการจัดแนวกับภารกิจ แทนที่จะปรากฏเฉพาะในช่วงปรับแต่งขั้นสุดท้าย Z.AI ยังไม่ได้เปิดเผยชุดข้อมูล เส้นแบ่งแต่ละช่วง หรืออัตราส่วนการผสม จึงควรมองว่าเป็นทิศทางที่ยืนยันแล้วมากกว่าสูตรที่สมบูรณ์
GLM-6.0 Self-Evaluation and Correction Mechanism โรดแมปเชื่อม Full Self-Training เข้ากับการประเมินตนเอง การตรวจจับข้อผิดพลาด การแก้ไข และการทำความสะอาดข้อมูลด้วยตนเอง ในทางปฏิบัติ โมเดลจำเป็นต้องตัดสินเส้นทางการทำงาน แก้ไขขั้นตอนที่ล้มเหลว ทิ้งข้อมูลที่ไม่น่าเชื่อถือ และตัดสินใจว่าเมื่อใดที่การวนซ้ำเพิ่มเติมไม่ทำให้ประสิทธิภาพที่วัดโดยอิสระดีขึ้น แบบออกแบบของตัวประเมินและกฎการหยุดยังไม่ถูกเปิดเผย
What We Know vs What We Don't บันทึกสาธารณะสนับสนุนโรดแมป แต่ไม่ใช่สเปกที่เสร็จสมบูรณ์ ตารางต่อไปนี้แยกทิศทางที่ยืนยันแล้วออกจากคำถามที่ยังเปิดอยู่ เพื่อไม่ให้บทความตีความเจตนาที่เปิดเผยเป็นข้ออ้างอิงผลิตภัณฑ์ที่ไม่มีหลักฐานรองรับ
GLM-6.0 name Publicly identified Z.AI ได้ตั้งชื่อโมเดลรุ่นถัดไปว่า GLM-6.0 วันเปิดตัวและการจัดวางตำแหน่งสุดท้าย Full Self-Training Confirmed roadmap เป็นยุทธศาสตร์ที่ระบุไว้อย่างชัดเจน รายละเอียดการทำงานและพฤติกรรมการสเกล Pre-training → Mid-training → Post-training Confirmed direction Self-training ตั้งใจให้ครอบคลุมวงจรการฝึกทั้งหมด ชุดข้อมูล ตัวตรวจสอบ เส้นแบ่งช่วง และอัตราส่วนข้อมูล Self-evaluation and correction Confirmed objective โรดแมปรวมการทำความสะอาดข้อมูล การตรวจจับข้อผิดพลาด และการแก้ไข ความน่าเชื่อถือ การตรวจสอบโดยอิสระ และเกณฑ์การหยุด Specifications Not disclosed ไม่มีสเปกสาธารณะที่สมบูรณ์ พารามิเตอร์ หน้าต่างบริบท มัลติโหมด ราคา และตัวระบุ API Benchmarks Not disclosed ไม่มีชุดผลลัพธ์ GLM-6.0 อย่างเป็นทางการ คะแนน ระเบียบวิธี และผลที่ทำซ้ำได้โดยอิสระ
What Is Full Self-Training and how it work Full Self-Training คือวงปิดการเรียนรู้ที่โมเดลช่วยสร้างงานหรือสภาพแวดล้อม พยายามทำงานนั้น ประเมินทราเจกทอรีที่ได้ แก้ไขขั้นตอนที่อ่อน และป้อนประสบการณ์ที่ผ่านการยอมรับกลับเข้าสู่การฝึก ความเปลี่ยนแปลงสำคัญคือจากไปป์ไลน์ข้อมูลสังเคราะห์แบบครั้งเดียวสู่กระบวนการที่ถูกกำกับอย่างต่อเนื่อง
Generate: สร้างปัญหา สภาพแวดล้อมเครื่องมือ และเส้นทางวิธีแก้ที่เป็นไปได้Act: ทำงานให้เสร็จและบันทึกการกระทำ การสังเกต และการให้เหตุผลระหว่างทางเป็นเส้นทางการปฏิบัติEvaluate and correct: ให้คะแนนผลลัพธ์ด้วยตัวตรวจสอบ ตรวจจับข้อผิดพลาด แก้ไขขั้นตอนที่ล้มเหลว และปฏิเสธตัวอย่างที่ความเชื่อมั่นต่ำTrain and stop: เรียนรู้จากประสบการณ์ที่ยอมรับ แล้วดำเนินต่อเฉพาะเมื่อการประเมินโดยอิสระแสดงให้เห็นถึงการปรับปรุงที่มีประโยชน์ การขยายวงจรนี้ครอบคลุมช่วงก่อน ช่วงกลาง และหลังการฝึกจะช่วยให้ GLM-6.0 ปรับปรุงคุณภาพข้อมูล การหล่อหลอมขีดความสามารถ และการจัดแนวภารกิจในแต่ละช่วง สถาปัตยกรรมยังขึ้นกับตัวประเมินที่น่าเชื่อถือ: หากไม่มีการตรวจสอบโดยอิสระ การฝึกด้วยตนเองอาจให้รางวัลแก่จุดบอดของตนเอง
How Could Full Self-Training Change GLM 6.0? การออกแบบที่เปิดเผยควรเข้าใจว่าเป็นสถาปัตยกรรมระบบมากกว่าบล็อก Transformer ใหม่เพียงบล็อกเดียว มันพยายามปิดลูปรอบโมเดลเพื่อให้โมเดลช่วยสร้างทรัพยากรที่จำเป็นสำหรับรอบการฝึกถัดไปมากขึ้นเรื่อยๆ
How could GLM 6.0 produce training data? ลูปแรกคือการผลิตข้อมูลด้วยตนเอง แทนที่จะพึ่งพาเฉพาะชุดข้อมูลที่มนุษย์เขียนหรือรวบรวมภายนอก โมเดลสามารถใช้ self-play การตรวจสอบแบบมีเกณฑ์ กฎผลการรัน เครื่องมือช่วยตัดสิน โมเดลช่วยตัดสิน และการสุ่มตรวจโดยมนุษย์ เพื่อสร้างและกรองตัวอย่างใหม่ ตัวอย่างที่ผ่านการยอมรับจะไหลกลับเข้าสู่ก่อนการฝึก ช่วงกลางการฝึก และหลังการฝึก
ข้อจำกัดสำคัญคือการตรวจสอบความถูกต้อง: การสร้างสังเคราะห์ราคาถูกมีประโยชน์เฉพาะเมื่อระบบสามารถระบุตัวอย่างที่ถูกต้อง หลากหลาย และไม่เสื่อมสภาพได้ วงจรเชิงปฏิบัติคือ การสร้างโดยโมเดล → การรันภารกิจ → การตรวจด้วยกฎหรือเครื่องมือ → การกรอง → การฝึกซ้ำ
How could GLM 6.0 construct training environments? ลูปที่สองคือการสร้างสภาพแวดล้อมการฝึกด้วยตนเอง เอเจนต์สามารถรวบรวมหรือแปลงภารกิจในโลกจริง พยายามทำภารกิจนั้น สร้างตัวตรวจสอบ และตรวจว่าภารกิจนั้นแก้ได้จริงก่อนจะกลายเป็นวัสดุฝึก สิ่งนี้สำคัญเป็นพิเศษสำหรับงานโค้ดและงานเอเจนต์ ซึ่งสถานะปลายทาง ผลลัพธ์จากเครื่องมือ สถานะเบราว์เซอร์ ผลการทดสอบ และการกู้คืนจากความล้มเหลว ให้สัญญาณกำกับที่แข็งแรงกว่าคำตอบแบบข้อความล้วน
เป้าหมายการประเมินจึงเปลี่ยนจาก “คำตอบฟังดูสมเหตุสมผลหรือไม่” ไปสู่ “การกระทำสำเร็จหรือไม่ ผลลัพธ์ตรวจสอบได้โดยอิสระหรือไม่ และเอเจนต์กู้คืนหลังความล้มเหลวได้หรือไม่”
How could GLM 6.0 optimize its training infrastructure? ลูปที่สามคือการเพิ่มประสิทธิภาพโครงสร้างพื้นฐานด้วยตนเอง ในทางปฏิบัติ นี่ตีความได้ดีที่สุดว่าเป็นวิศวกรรมระบบที่ AI ช่วย: โมเดลโค้ดที่แข็งแรงเสนอการเปลี่ยนแปลงต่อโอเปอเรเตอร์ เคอร์เนล การจัดตาราง การแคช หรือโค้ดเสิร์ฟ ขณะที่เบนช์มาร์กอัตโนมัติและการตรวจรับรองโดยมนุษย์ตัดสินว่าการเปลี่ยนแปลงใดถูกยอมรับ
วงจรที่ได้คือ โมเดลดีขึ้น → ข้อเสนอระบบที่ดียิ่งขึ้น → กำไรประสิทธิภาพที่ผ่านการรับรอง → ทดลองฝึกได้มากขึ้น → โมเดลดีขึ้นอีก การทบทวนโดยมนุษย์และเบนช์มาร์กที่ทำซ้ำได้ยังคงเป็นจุดควบคุม ไม่ใช่ตัวเลือก
What Does the Current GLM 5.3 Flash Baseline Tell Us About GLM 6.0? Release status พร้อมใช้งาน อยู่ระหว่างพัฒนา; ชื่อผลิตภัณฑ์สุดท้ายยังไม่ถูกยืนยันโดยเอกสารอ้างอิงที่ยกมา Parameters รวม 320B / ใช้งานจริง 18B ไม่เปิดเผย Core architecture MoE; attention แบบ sparse ผสม linear; mHC ไม่เปิดเผยในระดับบล็อก Training data คอร์ปัสมัลติโหมด 30T โทเคน ข้อมูลที่ผลิตเองตั้งใจให้เข้าสู่วงจรเรียนรู้แบบเวียนซ้ำ Multimodality อินพุตมัลติโหมดโดยกำเนิด การทำให้มัลติโหมดแบบเอกภาพเป็นทิศทางวิจัย ไม่ใช่สเปกที่เผยแพร่ Training stages สูตรการฝึกแบบแบ่งช่วงที่เผยแพร่แล้ว การฝึกด้วยตนเองครอบคลุมก่อน ช่วงกลาง และหลังการฝึก Training environments สภาพแวดล้อมที่นักวิจัยออกแบบและทดสอบเบนช์มาร์ก เอเจนต์ช่วยสร้างและตรวจรับรองสภาพแวดล้อม Verification ไปป์ไลน์การประเมินและการฝึกที่มีอยู่ การตัดสินตนเองที่แข็งแรงขึ้น ฟีดแบ็กจากการรัน และการตรวจสอบด้วยตนเอง Infrastructure สแตกการอนุมานที่ปรับแต่งแล้ว โมเดลช่วยเพิ่มประสิทธิภาพโครงสร้างพื้นฐาน API details มีตัวระบุโมเดลและ API แบบไลฟ์ ไม่เปิดเผย
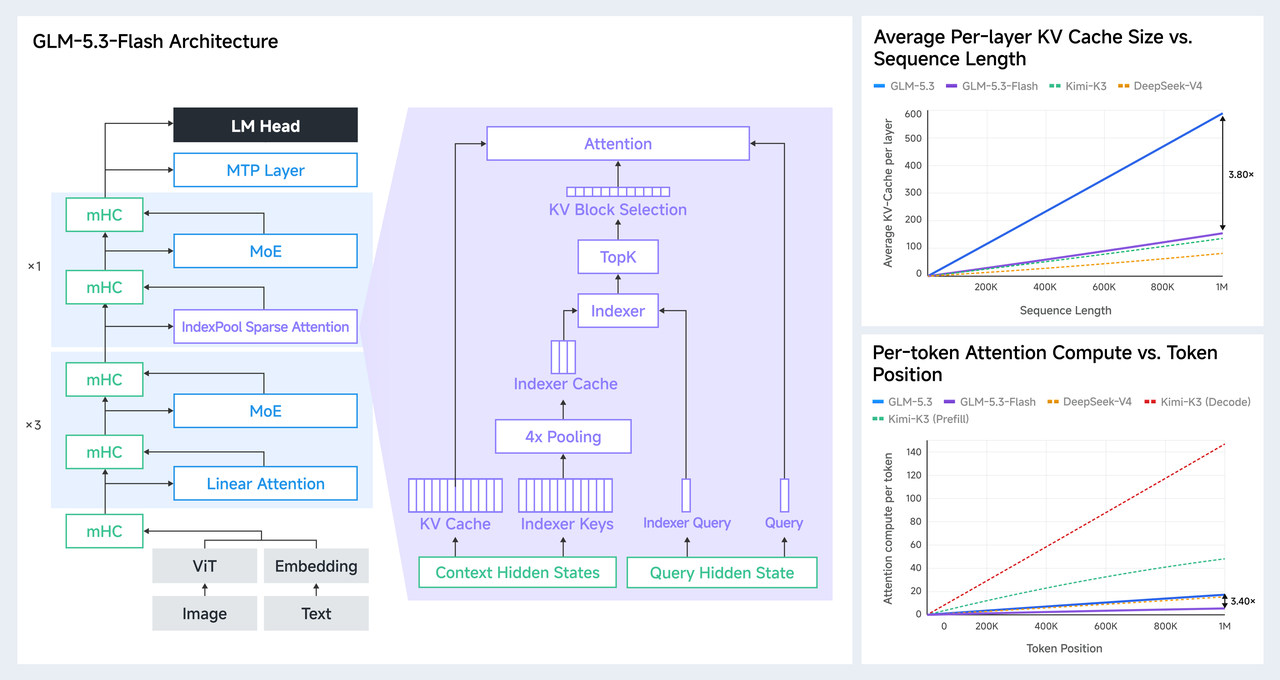
ข้อความเปิดตัวของ Z.AI รายงานว่า GLM-5.3-Flash มีการคำนวณของ attention ต่ำลงประมาณ 3.0× และขนาด KV-cache ต่อเลเยอร์เล็กลง 4.4× เมื่อเทียบกับ GLM-5.3 API กราฟิกอย่างเป็นทางการที่มาพร้อมกันระบุว่าการเปรียบเทียบที่ 1 ล้านโทเคนเป็น 3.40× สำหรับการคำนวณของ attention และ 3.80× สำหรับ KV-cache ต่อเลเยอร์ เนื่องจากสินทรัพย์ทางการทั้งสองใช้ตัวเลขต่างกัน จึงควรรายงานตามบริบทของแต่ละแหล่ง แทนที่จะถูกรวมเป็นค่าการวัดเดียว
แผนภาพสถาปัตยกรรมและการเปรียบเทียบประสิทธิภาพอย่างเป็นทางการของ GLM-5.3-Flash ที่เผยแพร่โดย Z.AI
ยังไม่มีตารางเบนช์มาร์ก GLM 6.0 ที่ได้รับการยืนยันแบบสาธารณะ รุ่น GLM ปัจจุบันจึงใช้เป็น baseline เท่านั้น เพราะการประเมินด้านล่างวัดความสามารถด้านการวางแผน การเขียนโค้ด การใช้เครื่องมือ ระบบอัตโนมัติ และการรันระยะยาว ซึ่งเกี่ยวข้องมากที่สุดกับทิศทาง Full Self-Training ที่เปิดเผย
Terminal Bench 2.1 84.3 81.0 +3.3 DeepSWE v1.1 63.4 46.2 +17.2 NL2Repo 56.3 48.9 +7.4 Toolathlon Verified 78.4 59.9 +18.5 AutomationBench v1.0.6 48.8 26.2 +22.6 Agents’ Last Exam 26.3 20.4 +5.9 HLE with Tools 55.3 54.7 +0.6 GDPval-AA v2 1773 Elo 1504 Elo +269 Elo
การเปรียบเทียบเป็นแบบหลายมิติ ไม่ใช่อันดับคะแนนเดียว GLM-5.3-Flash แสดงส่วนต่างที่รายงานมากที่สุดบน AutomationBench (+22.6), Toolathlon Verified (+18.5) และ DeepSWE (+17.2) ขณะที่ HLE-with-Tools ต่างเพียง +0.6 รูปแบบนี้ชี้ถึงการเพิ่มขึ้นที่แข็งแรงในงานเอเจนต์ที่ต้องลงมือปฏิบัติมาก เทียบกับเหตุผลเชิงเครื่องมือทุกประเภท ไม่ได้ทำนายคะแนน GLM 6.0
Why these benchmarks matter เบนช์มาร์กสำคัญก็ต่อเมื่อเผยให้เห็นความสามารถที่ Full Self-Training ตั้งใจจะปรับปรุง หกหมวดในตารางฝังด้านล่างเป็นความก้าวหน้าจากการสร้างงานที่ถูกต้องไปสู่การคงพฤติกรรมที่มีประสิทธิภาพในสภาพแวดล้อมจริง การเขียนโค้ดทดสอบว่าโมเดลสามารถทำภารกิจซับซ้อนได้หรือไม่; การใช้เครื่องมือทดสอบว่ามันเปลี่ยนการกระทำเป็นฟีดแบ็กและเลือกก้าวต่อไปได้หรือไม่; และระบบอัตโนมัติทดสอบว่ามันคงวงจรนั้นตลอดเวิร์กโฟลว์ยาวๆ ได้หรือไม่
Coding ทดสอบการทำภารกิจซับซ้อน Tool Use ทดสอบวงจรจากการกระทำสู่ฟีดแบ็ก Automation ทดสอบการดำเนินเวิร์กโฟลว์ระยะยาว HLE ทดสอบการแก้ปัญหาระดับผู้เชี่ยวชาญที่ซับซ้อน GDPval ทดสอบคุณภาพงานระดับมืออาชีพ Multimodal ทดสอบการใช้ฟีดแบ็กจากภาพ
จากนั้น HLE จะเพิ่มระดับความยากของปัญหาที่ต้องแก้, GDPval ถามว่างานที่ส่งออกมีประโยชน์ในงานมืออาชีพหรือไม่, และการประเมินมัลติโหมดทดสอบว่าการสังเกตจากภาพนำทางการกระทำถัดไปได้หรือไม่ เมื่ออ่านรวมกัน ทั้งหกหมวดจะเคลื่อนจากความสามารถโดดเดี่ยวไปสู่การทำภารกิจแบบครบวงจร: สร้างแผน ปฏิบัติ สังเกตฟีดแบ็ก แก้ข้อผิดพลาด และทำต่อจนกว่าจะบรรลุวัตถุประสงค์
ดังนั้น ผลลัพธ์ GLM-6.0 ในอนาคตจะมีความหมายไม่ใช่เพราะได้คะแนนรวมสูงขึ้น แต่เพราะการเพิ่มขึ้นในมิติเหล่านี้แสดงว่าประสบการณ์การฝึกที่สร้างเองถ่ายทอดสู่การปฏิบัติจริงที่ไว้ใจได้ Full Self-Training มีเป้าหมายสูงสุดไม่ใช่เพื่อเพิ่มคะแนนทดสอบ แต่เพื่อเพิ่มความสามารถของโมเดลในการทำภารกิจในโลกจริงให้เสร็จสมบูรณ์
Why Could Full Self-Training Matter for GLM 6.0? คำสัญญาที่แท้จริงไม่ใช่ว่า GLM 6.0 จะ “ฝึกตัวเอง” ได้อย่างเรียบง่าย การเปลี่ยนแปลงที่มีความหมายกว่าคือส่วนใหญ่ของไปป์ไลน์พัฒนาจะกลายเป็นสิ่งที่เครื่องสร้างและตรวจรับรองเอง ทุกวันนี้ นักวิจัยยังทำงานรอบๆ โมเดลจำนวนมาก: รวบรวมข้อมูล ออกแบบงาน สร้างตัวประเมิน สร้างสภาพแวดล้อม วินิจฉัยความล้มเหลว และจูนซอฟต์แวร์ระบบ Full Self-Training ผลักดันให้โมเดลเข้าไปมีบทบาทในหลายช่วงนั้นมากขึ้น
หากแนวทางนี้ได้ผล ตัวแปรการสเกลที่สำคัญจะเปลี่ยนจาก “เพิ่มพารามิเตอร์ได้มากแค่ไหน” ไปสู่ “ดำเนินรอบการเรียนรู้ที่มีประโยชน์และผ่านการตรวจรับรองได้กี่รอบต่อหน่วยคอมพิวต์” นี่คือการตีความเชิงปฏิบัติของการพัฒนาตนเองแบบเวียนซ้ำที่ต่างจากภาพวิทยาศาสตร์นิยายของการแก้ไขตนเองแบบอัตโนมัติไร้ข้อจำกัด
ควรประเมินยุทธศาสตร์ที่เปิดเผยนี้ในฐานะระบบฟีดแบ็กที่ออกแบบวิศวกรรมพร้อมตัวตรวจสอบ สภาพแวดล้อมที่ทำซ้ำได้ เบนช์มาร์กโครงสร้างพื้นฐาน และการควบคุมโดยมนุษย์—ไม่ใช่หลักฐานของการพัฒนาตนเองแบบอัตโนมัติไร้ข้อจำกัด
What Could Go Wrong With Full Self-Training? วงฝึกแบบตนเองสามารถขยายความผิดพลาดได้อย่างมีประสิทธิภาพไม่แพ้การขยายประสบการณ์ที่มีประโยชน์ โหมดความล้มเหลวสี่แบบที่ควรจับตาเป็นพิเศษ:
Error amplification: ทราเจกทอรีสังเคราะห์ที่อ่อนอาจกลายเป็นข้อมูลฝึกในอนาคต ทำให้รูปแบบที่ดูสมเหตุสมผลแต่ผิดพลาดถูกเสริมแรงReward and evaluator gaming: หากระบบเดียวกันสร้างงานและตัดสินงาน มันอาจปรับให้เหมาะกับช่องโหว่ของตัวตรวจสอบ แทนความสำเร็จของภารกิจจริงDistribution narrowing: การเรียนรู้ซ้ำๆ จากข้อมูลที่โมเดลสร้างเองอาจลดความหลากหลายและทำให้กรณีจริงที่พบไม่บ่อยจัดการได้ยากขึ้นCost, security, and governance pressure: การสร้างสภาพแวดล้อม การเข้าถึงเครื่องมือ และการวนซ้ำอย่างต่อเนื่องเพิ่มความต้องการคอมพิวต์และขยายพื้นผิวโจมตี การทำ GLM-6.0 ให้มีความน่าเชื่อถือจึงต้องมีตัวตรวจสอบอิสระ แหล่งที่มาของข้อมูล เกณฑ์การยอมรับ การทดสอบเชิงรุกโดยทีมแดง การตรวจสอบโดยมนุษย์ และกฎการหยุดที่ชัดเจน การแก้ไขตนเองจะมีประโยชน์ก็ต่อเมื่อสัญญาณแก้ไขน่าเชื่อถือกว่าพฤติกรรมที่ถูกแก้
When Could the GLM 6.0 API Become Available? Z.AI ยังไม่เผยแพร่วันเปิดตัว API ของ GLM 6.0 ตัวระบุโมเดล หน้าต่างบริบท เอาต์พุตสูงสุด ราคาโทเคน คำมั่นเปิดน้ำหนัก หรือข้อกำหนดการติดตั้ง ค่าที่เฉพาะเจาะจงใดๆ ในตอนนี้ล้วนเป็นการคาดเดา
Conclusion GLM-6.0 สำคัญในฐานะการทดสอบว่า Z.AI จะเปลี่ยน Full Self-Training ให้เป็นระบบวิศวกรรมที่ทำซ้ำได้หรือไม่ มากกว่าคำสัญญาผลิตภัณฑ์ โรดแมปเชื่อมโยงประสบการณ์ที่สร้างเอง การฝึกแบบแบ่งช่วง การประเมินตนเอง การแก้ไข และการวนซ้ำที่ถูกควบคุม หลักฐานชี้ขาดจะอยู่ที่ว่า กลไกเหล่านี้ทำให้ความน่าเชื่อถือในการทำงานจริงที่ยาว ใช้เครื่องมือ และอยู่ในโลกความเป็นจริงดีขึ้นหรือไม่
หลักฐานนั้นยังไม่สมบูรณ์ Z.AI ยังไม่เผยแพร่ model card ของ GLM-6.0 วันเปิดตัว ตัวระบุ API การตั้งราคา หรือชุดเบนช์มาร์ก จนกว่าจะมีสิ่งเหล่านั้น ข้อสรุปที่ป้องกันได้จึงมีขอบเขตจำกัด: บริษัทได้เปิดเผยทิศทางการฝึก ไม่ใช่โปรไฟล์ความสามารถที่เสร็จสมบูรณ์
เป้าหมายสูงสุดของ Full Self-Training ไม่ใช่การเพิ่มคะแนนทดสอบ แต่คือการเพิ่มความสามารถของโมเดลในการทำภารกิจในโลกจริงให้เสร็จสมบูรณ์