Solutions Choose your path
For individuals Build, learn, and create with simple usage-based access. For business Scale teams, billing, governance, and model workflows. More English 繁體中文 日本語 한국어 Français Deutsch Español Italiano Português Русский العربية ไทย Tiếng Việt Bahasa Indonesia Bahasa Melayu Türkçe Polski Nederlands Danish Norsk Қазақ اردو
เริ่มต้นฟรี เริ่มต้นฟรี
500+ AI Model API, All In One API.
Just In CometAPI © 2026 CometAPI · All rights reserved
Home Blog GPT‑5.3 Codex Spark เทียบกับ GPT‑5.3 Codex: การวิเคราะห์อย่างครอบคลุม technology / งานวิจัย CometAPI
GPT‑5.3 Codex Spark เทียบกับ GPT‑5.3 Codex: การวิเคราะห์อย่างครอบคลุม ในเดือนกุมภาพันธ์ ปี 2026 OpenAI ได้เปิดตัวสมาชิกสองรายของตระกูล “Codex” ที่เกี่ยวข้องกันอย่างใกล้ชิด—แต่แตกต่างกันเชิงกลยุทธ์—: GPT-5.3-Codex (โมเดลการเขียนโค้ดเชิงเอเจนต์ที่มีศักยภาพสูง) และ GPT-5.3-Codex-Spark (รุ่นย่อยที่มีขนาดเล็กกว่า มีความหน่วงต่ำเป็นพิเศษ ปรับแต่งเพื่อการเขียนโค้ดแบบโต้ตอบ) Together they represent OpenAI’s dual approach to serving both “deep thinking” and “fast doing” in software engineering workflows: one model that pushes the ceiling of coding intelligence and tool-driven agentic behavior, and one that prioritizes real-time interactivity for developer-facing UI.
Anna ทีมวิจัยโมเดล AI และ API ในเดือนกุมภาพันธ์ ปี 2026 OpenAI ได้เปิดตัวสมาชิกสองรายของตระกูล “Codex” ที่เกี่ยวข้องกันอย่างใกล้ชิด—แต่แตกต่างกันเชิงกลยุทธ์—: GPT-5.3-Codex (โมเดลการเขียนโค้ดเชิงเอเจนต์ที่มีศักยภาพสูง) และ GPT-5.3-Codex-Spark (รุ่นย่อยที่มีขนาดเล็กกว่า มีความหน่วงต่ำเป็นพิเศษ ปรับแต่งเพื่อการเขียนโค้ดแบบโต้ตอบ) Together they represent OpenAI’s dual approach to serving both “deep thinking” and “fast doing” in software engineering workflows: one model that pushes the ceiling of coding intelligence and tool-driven agentic behavior, and one that prioritizes real-time interactivity for developer-facing UI.
ใช้สรุปนี้เพื่อดูคำตอบอย่างรวดเร็ว แล้วอ่านคู่มือเพื่อดูบริบท ตัวอย่าง และรายละเอียดการใช้งาน
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_COMETAPI_KEY",
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="gpt-5-mini",
    messages=[{"role": "user", "content": "Build this workflow."}],
)

print(response.choices[0].message.content)ในเดือนกุมภาพันธ์ ปี 2026 OpenAI เปิดตัวสมาชิกสองรุ่นที่เกี่ยวข้องอย่างใกล้ชิด—but แตกต่างเชิงกลยุทธ์—ในตระกูล “Codex”: GPT-5.3-Codex (โมเดลเขียนโค้ดเชิงเอเจนต์ที่มีขีดความสามารถสูง) และ GPT-5.3-Codex-Spark (รุ่นย่อที่มีความหน่วงต่ำเป็นพิเศษ ปรับเหมาะสำหรับการเขียนโค้ดแบบโต้ตอบ) ทั้งสองสะท้อนแนวทางคู่ขนานของ OpenAI ในการบริการทั้ง “คิดลึก” และ “ทำเร็ว” ในเวิร์กโฟลว์วิศวกรรมซอฟต์แวร์: โมเดลหนึ่งผลักเพดานสติปัญญาการเขียนโค้ดและพฤติกรรมเชิงเอเจนต์ที่ขับเคลื่อนด้วยเครื่องมือ อีกโมเดลหนึ่งให้ความสำคัญกับความโต้ตอบแบบเรียลไทม์สำหรับ UI ที่เผชิญหน้าผู้พัฒนา
CometAPI ขณะนี้ผสานรวมกับ GPT-5.3 Codex ซึ่งคุณสามารถใช้งานผ่าน API ส่วนลดและปรัชญาการให้บริการของ CometAPI จะทำให้คุณประหลาดใจ
GPT-5.3-Codex และ GPT-5.3-Codex-Spark คืออะไร?
เรียนรู้ต่อ
เชื่อมโยงบทความนี้กับการตัดสินใจถัดไป ดูทุกหัวข้อ เผยแพร่เมื่อ Feb 25, 2026 ตรวจสอบความชัดเจน การอ้างอิงแหล่งที่มา และคำศัพท์ API ปัจจุบันแล้ว
GPT-5.3-Codex เป็นเอเจนต์เขียนโค้ด “frontier” รุ่นล่าสุดจาก OpenAI มันผสานความสามารถการเขียนโค้ดขั้นสูงเข้ากับการให้เหตุผลทั่วไป และออกแบบมาอย่างชัดเจนสำหรับงานเชิงเอเจนต์ระยะยาวที่เกี่ยวข้องกับการค้นคว้า การใช้เครื่องมือ การรันคำสั่งเทอร์มินัล การวนซ้ำผ่านโทเค็นจำนวนมาก และการจัดการโครงการซอฟต์แวร์หลายขั้นตอน OpenAI รายงานผลลัพธ์ระดับรัฐ-of-the-art บนชุดทดสอบวิศวกรรมหลายภาษา เช่น SWE-Bench Pro และ Terminal-Bench 2.0 และไฮไลต์ว่า GPT-5.3-Codex สามารถใช้เพื่อดีบัก ดีพลอย และแม้กระทั่งช่วยในเวิร์กโฟลว์การพัฒนาของตัวเอง
GPT-5.3-Codex-Spark เป็นรุ่นย่อที่ปรับให้เหมาะสมด้านความหน่วง ตั้งใจสำหรับประสบการณ์การเขียนโค้ดแบบโต้ตอบและเรียลไทม์ Spark ถูกพัฒนาร่วมให้ทำงานบนฮาร์ดแวร์เวเฟอร์สเกลจาก Cerebras ทำให้ได้ปริมาณงานเกิน 1,000 โทเค็นต่อวินาที และหน้าต่างบริบท 128k โทเค็น สำหรับรุ่นเปิดตัว มันถูกวางตำแหน่งเป็นโมเดลคู่หู: เร็วมากสำหรับการแก้ไขแบบอินไลน์ การสร้างโค้ดโครงร่าง การรีแฟกเตอร์อย่างรวดเร็ว และงานระยะสั้น — แต่ตั้งใจให้มีความลึกในการให้เหตุผลน้อยกว่ารุ่น Codex มาตรฐาน
ทำไมต้องมีสองโมเดล? การแยกนี้สะท้อนการแลกเปลี่ยนเชิงผลิตภัณฑ์ในทางปฏิบัติ: ทีมต้องการทั้ง (a) เอเจนต์ที่ลึกและมีความสามารถสูงซึ่งสามารถวางแผนและให้เหตุผลครอบคลุมพื้นที่ปัญหาขนาดใหญ่ และ (b) ผู้ร่วมงานที่เกือบจะทันทีซึ่งช่วยให้ผู้พัฒนาอยู่ในโฟลว์ หลักฐานชี้ว่าควรใช้ทั้งสองร่วมกันในเวิร์กโฟลว์แบบไฮบริด ไม่ใช่แทนกันโดยตรง
GPT‑5.3 Codex Spark vs Codex: สถาปัตยกรรมและการปรับใช้
ฮาร์ดแวร์ใดรองรับแต่ละโมเดล?
GPT-5.3-Codex (มาตรฐาน) : ร่วมออกแบบ ฝึก และให้บริการหลักบน NVIDIA GB200 NVL72 GPUs และสแตกอินเฟอเรนซ์ที่รองรับการให้เหตุผลเชิงลึกและจำนวนพารามิเตอร์ขนาดใหญ่มาก โครงสร้างพื้นฐานนี้ให้ความสำคัญกับขีดความสามารถของโมเดลมากกว่าความหน่วงระดับมิลลิวินาทีGPT-5.3-Codex-Spark : ทำงานบน Cerebras Wafer-Scale Engine (WSE-3) สถาปัตยกรรมของ Cerebras แลกแบนด์วิดท์บนชิปที่สูงมากและความหน่วงต่ำกับโปรไฟล์ขีดความสามารถที่แตกต่าง: รุ่น Spark มีขนาดเล็กลง/ถูกปรุงแต่งให้แมปกับข้อกำหนด SRAM ของเวเฟอร์ พร้อมส่งมอบโทเค็นผ่านเข้าออกได้สูงกว่า
ขนาดโมเดลและการกำหนดพารามิเตอร์ต่างกันอย่างไร? Spark ได้ความเร็วจากการทำ pruning/distillation และรอยเท้าพารามิเตอร์ที่เล็กลงเพื่อให้โมเดลพอดีและทำงานอย่างมีประสิทธิภาพบน WSE-3 ทางเลือกด้านการออกแบบนี้สร้างการแลกเปลี่ยนประสิทธิภาพตามคาด: ปริมาณงานสูงกว่ามากควบคู่กับความลึกในการให้เหตุผลต่อโทเค็นที่ต่ำกว่า
แล้วหน้าต่างบริบทและการจัดการโทเค็นล่ะ?
GPT-5.3-Codex — หน้าต่างบริบท 400,000 โทเค็น ในรายการสำหรับนักพัฒนาของโมเดล GPT-5.3-Codex สิ่งนี้ทำให้รุ่นมาตรฐานโดดเด่นมากกับโครงการระยะยาวที่ต้องให้เหตุผลข้ามหลายพันบรรทัดและหลายไฟล์GPT-5.3-Codex-Spark — รุ่นตัวอย่างเชิงวิจัยเปิดตัวด้วยหน้าต่างบริบท 128k โทเค็น ใหญ่ แต่เล็กกว่ารุ่น Codex มาตรฐาน หน้าต่างนี้ยังใหญ่มากเมื่อเทียบกับสไนปเพ็ตใน IDE ทั่วไป แต่การผสมผสานระหว่างหน้าต่างที่เล็กลงเล็กน้อยและคอมพิวต์ที่เล็กลงบ่งชี้ข้อจำกัดในการสังเคราะห์โค้ดเชิงลึกหลายไฟล์
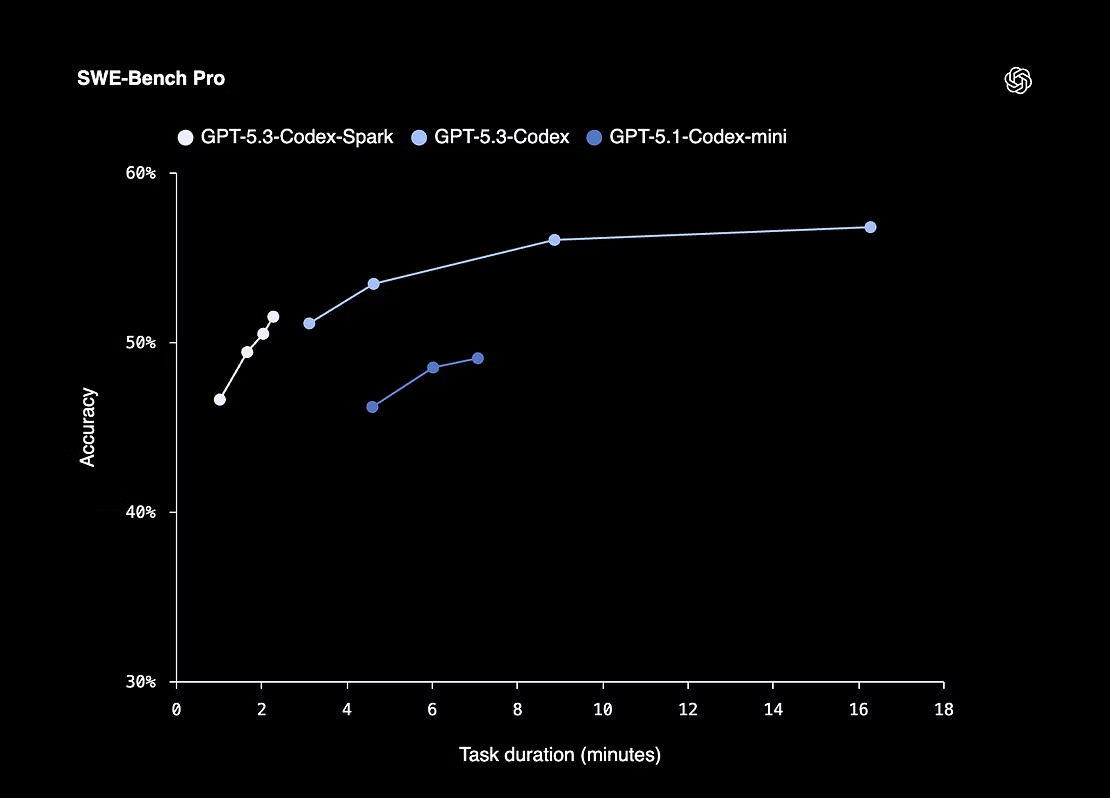
GPT‑5.3 Codex Spark vs Codex: ชุดทดสอบการเขียนโค้ดและความหน่วง ด้านล่างคือข้อมูลสาธารณะที่สำคัญที่สุด:
GPT-5.3-Codex (มาตรฐาน) : OpenAI เผยตัวเลขชุดทดสอบในประกาศเปิดตัว: คะแนน Terminal-Bench 2.0 77.3% , SWE-Bench Pro 56.8% , OSWorld 64.7% , ผลชนะ/เสมอของ GDPval 70.9% และคะแนนงานอื่น ๆ ที่ไฮไลต์ในภาคผนวก ตัวเลขเหล่านี้วางตำแหน่ง GPT-5.3-Codex ให้เป็นผู้นำใหม่ในงานวิศวกรรมซอฟต์แวร์เชิงเอเจนต์หลายภาษาGPT-5.3-Codex-Spark : OpenAI เน้นปริมาณงาน >1000 tokens/sec และความเร็วในการทำงานเสร็จสิ้นที่แข็งแกร่ง ขณะที่การวิเคราะห์อิสระและชุดทดสอบจากชุมชน (ผู้ใช้งานระยะแรก) รายงานการลดลงอย่างมีนัยในความแม่นยำการให้เหตุผลบนงานเทอร์มินัลที่ซับซ้อนเมื่อเทียบกับรุ่นเต็ม การวิเคราะห์หนึ่งระบุคะแนนประเมิน Terminal-Bench ประมาณ ~58.4% สำหรับ Spark (เทียบกับ 77.3% ของรุ่นมาตรฐาน) แสดงการแลกเปลี่ยนเชิงปฏิบัติระหว่างความเร็วและความถูกต้องบนงานเทอร์มินัลที่ซับซ้อน
Interpretation: สำหรับงานสั้น ๆ ที่กำหนดขอบเขตชัดเจน — เช่น การแก้ไขเล็กน้อย การสร้างยูนิตเทสต์ การแก้ไข regex หรือไวยากรณ์ — ความหน่วงต่ำของ Spark ทำให้ลูปมนุษย์-เอไอราบรื่นขึ้นและเพิ่มปริมาณงานของนักพัฒนา สำหรับการออกแบบสถาปัตยกรรม การดีบักข้อผิดพลาดการเชื่อมโยงที่ซับซ้อน หรือเวิร์กโฟลว์เชิงเอเจนต์หลายขั้นตอน ความแม่นยำในการให้เหตุผลที่สูงกว่าของ GPT-5.3-Codex มาตรฐานเหนือกว่าอย่างมีนัยสำคัญ
ทำไม GPT‑5.3 Codex Spark ถึงรู้สึกเร็วมาก?
นี่เป็นกลยุทธ์ด้านฮาร์ดแวร์ล้วน ๆ หรือไม่? บางส่วน ฮาร์ดแวร์ Cerebras WSE-3 ที่ใช้กับ Spark ลดความหน่วงจากการเคลื่อนย้ายหน่วยความจำจำนวนมากโดยเก็บบัฟเฟอร์ข้อมูลขนาดใหญ่ไว้บนชิปและให้แบนด์วิดท์หน่วยความจำมหาศาล แต่ฮาร์ดแวร์เพียงอย่างเดียวไม่เพียงพอ — OpenAI สร้างรุ่นที่ถูกกลั่น/ตัดแต่งให้แมปกับข้อกำหนด SRAM และโปรไฟล์คอมพิวต์ของเวเฟอร์ การผสมนั้น (โมเดลที่เล็กลง + ความหน่วงต่ำแบบเวเฟอร์สเกล) สร้างพฤติกรรมแบบเรียลไทม์
ต้นทุนของการทำ pruning/distillation คืออะไร? การกลั่นลดจำนวนพารามิเตอร์หรือความลึกของโมเดล และอาจเอาความสามารถในการให้เหตุผลหลายขั้นตอนบางส่วนออกไป ในทางปฏิบัติสิ่งนี้แสดงออกเป็น:
ประสิทธิภาพที่อ่อนลงบนงานเทอร์มินัลที่ซับซ้อนซึ่งต้องอาศัยการอนุมานต่อเนื่องหลายขั้น
ความน่าจะเป็นที่สูงขึ้นของข้อผิดพลาดตรรกะหรือด้านความปลอดภัยแบบละเอียดสำหรับการเปลี่ยนแปลงโค้ดยาวหรือเชื่อมโยงลึก
โทเค็นภายในสำหรับ “สิ่งที่ฉันกำลังคิด” น้อยลง (เช่น chain-of-thought ที่ลดลงเมื่อไม่ได้ร้องขออย่างชัดเจน)
แม้เช่นนั้น Spark ก็โดดเด่นกับการแก้ไขแบบเจาะจงเป้าหมายและการเรียกคืนข้อมูลแบนด์วิดท์สูง — ประเภทความช่วยเหลือที่ทำให้นักพัฒนาพิมพ์ต่อเนื่องโดยไม่สะดุด
นี่หมายความว่าอะไรสำหรับทีมผลิตภัณฑ์และนักพัฒนา?
ควรเรียกใช้ Spark เมื่อใด เทียบกับ Codex มาตรฐาน?
เรียกใช้ Spark เมื่อคุณต้องการ: การเติมคำสั่งอินไลน์ทันที การรีแฟกเตอร์แบบโต้ตอบ การตรวจเช็ค CI แบบเร็ว โครงร่างยูนิตเทสต์ การซ่อมไวยากรณ์ หรือคำแนะนำโค้ดแบบเรียลไทม์ที่ไม่ควรทำให้โฟลว์ของผู้ใช้สะดุด การสร้างผลลัพธ์ต่ำกว่าหนึ่งวินาทีของ Spark ทำให้ UI รู้สึกราบรื่นเรียกใช้ GPT-5.3-Codex มาตรฐาน เมื่อคุณต้องการ: การออกแบบสถาปัตยกรรม การคัดกรองบั๊กที่ซับซ้อน การให้เหตุผลหลายไฟล์ เอเจนต์ระยะยาว การตรวจสอบ/แข็งตัวด้านความปลอดภัย หรือปฏิบัติการที่ความถูกต้องครั้งแรกช่วยลดค่าใช้จ่ายการตรวจสอบที่แพง
เวิร์กโฟลว์แบบไฮบริดที่แนะนำ
ใช้ Spark เป็น “ซับเอเจนต์” เชิงยุทธวิธี สำหรับการแก้ไขสั้น ๆ และเพื่อคงโฟลว์ของนักพัฒนา (แมปกับคีย์ลัดหรือปุ่มอินไลน์ใน IDE)
ใช้ GPT-5.3-Codex เป็น “นักวางแผน” เชิงกลยุทธ์: สำหรับการสร้าง PR ข้อเสนอการรีแฟกเตอร์ แผนรีแฟกเตอร์ที่ต้องใช้บริบทลึก หรือเมื่อทำการตรวจสอบความปลอดภัยอย่างละเอียด
ใช้ “โหมดไฮบริด” : จัดเส้นทางพรอมต์สั้น ๆ เรื่องไวยากรณ์/สไตล์ไปยัง Spark โดยอัตโนมัติ และยกระดับการสนทนาหรือคำขอหลายขั้นตอนขึ้นไปยัง Codex มาตรฐาน OpenAI กำลังสำรวจการจัดเส้นทางแบบไฮบริด แต่คุณสามารถทำฝั่งไคลเอนต์ได้ทันที
แนวทางการตั้งพรอมต์และปฏิบัติการที่ดีที่สุด
เริ่มด้วยพรอมต์เล็กและเจาะจงใน Spark แล้วค่อยยกระดับไปยัง Codex สำหรับการรีแฟกเตอร์เต็มรูปแบบหรือกรณีที่ความถูกต้องเป็นเรื่องสำคัญ แพตเทิร์นไฮบริดนี้ให้ UX ที่ดีที่สุด (Spark สำหรับฉบับร่าง, Codex สำหรับการตรวจสอบและสรุปผล)ใช้สตรีมมิงสำหรับปฏิสัมพันธ์ UI : แสดงโทเค็นทีละส่วนจาก Spark เพื่อสร้างความรู้สึก “สด”; หลีกเลี่ยงการเรียกแบบ synchronous ยาว ๆ ที่บล็อกเอดิเตอร์ติดตั้งการทดสอบยืนยัน : สำหรับการเปลี่ยนแปลงใด ๆ ที่แตะตรรกะหรือความปลอดภัย ให้บังคับใช้ยูนิตเทสต์และให้ Codex เป็นผู้รันหรือสังเคราะห์เทสต์เหล่านั้น อัตโนมัติวงจรทดสอบ-ตรวจสอบที่ Spark เสนอการเปลี่ยนแปลงและ Codex ตรวจสอบ/สรุปผลปรับแต่งความพยายามในการให้เหตุผล : เอ็นด์พอยต์ของ Codex จำนวนมากมีปุ่ม reasoning หรือ effort (เช่น low/medium/high/xhigh) — เพิ่มระดับความพยายามสำหรับงานที่ซับซ้อนและมีผลกระทบสูงแคชและการจัดการเซสชัน : สำหรับ UI ที่ขับเคลื่อนด้วย Spark ให้แคชโทเค็นบริบทก่อนหน้าอย่างมีประสิทธิภาพและส่งเฉพาะเดลต้าเพื่อลดความหน่วงต่อคำขอและการใช้โทเค็นความปลอดภัยมาก่อน : ปฏิบัติตาม system card/แนวทาง Governance ของผู้ให้บริการสำหรับโดเมนความเสี่ยงสูง (cyber, bio ฯลฯ) — system card ของ Codex บันทึกมาตรการป้องกันเพิ่มเติมและขั้นตอนความพร้อมเมื่อโมเดลมีความสามารถสูงในบางโดเมนอย่างชัดเจน มีสองแพตเทิร์นที่พบได้บ่อย: (A) การเรียกแบบสตรีมมิงเชิงโต้ตอบไปยัง Codex-Spark สำหรับการเติมอินไลน์, (B) คำขอที่เชิงเอเจนต์และใช้ความพยายามสูงกว่าไปยัง GPT-5.3-Codex สำหรับงานรีแฟกเตอร์/เอเจนต์ระยะยาว
A) ตัวอย่าง — สตรีมมิงการเติมอินไลน์ด้วย Codex-Spark (Python) # Pseudocode / illustrative example# Install: pip install openai (or use official SDK)import openaiopenai.api_key = "YOUR_API_KEY"# Use a hypothetical streaming endpoint that favors low latency.# Model name is illustrative: "gpt-5.3-codex-spark"with openai.ChatCompletion.stream( model="gpt-5.3-codex-spark", messages=[ {"role": "system", "content": "You are a fast, precise coding assistant."}, {"role": "user", "content": "In file app.py, refactor this function to be async and add type hints:\n\n<paste code here>"} ], max_tokens=256, stream=True) as stream: for event in stream: if event.type == "output.delta": print(event.delta, end="") # print incremental completions for instant UI elif event.type == "response.completed": print("\n[done]")
ทำไมใช้แพตเทิร์นนี้? สตรีมมิง + max_tokens ขนาดเล็กทำให้การวนรอบในเอดิเตอร์ฉับไว ใช้ Spark เมื่อคุณต้องการผลลัพธ์แบบเพิ่มพูนทีละส่วนในเวลาไม่ถึงวินาที
B) ตัวอย่าง — งานเชิงเอเจนต์ระยะยาวด้วย GPT-5.3-Codex (Python) # Pseudocode for a multi-step agent request: run tests, find failing module, write fix, create PRimport openaiopenai.api_key = "YOUR_API_KEY"response = openai.ChatCompletion.create( model="gpt-5.3-codex", messages=[ {"role":"system", "content":"You are an engineering agent. You can run tests and edit files given repo access."}, {"role":"user", "content":"Take the repository at /workspace/myapp, run the test suite, and if any tests fail, create a minimal fix and return a patch plus a test that demonstrates the bug."} ], max_tokens=2000, reasoning="xhigh", # Codex supports effort settings: low/medium/high/xhigh tools=["shell","git"], # illustrative: agent tools for real actions stream=False)# The response may include a multi-step plan, diffs, and tests.print(response.choices[0].message.content)
ทำไมใช้แพตเทิร์นนี้? โหมดการให้เหตุผลของ Codex (low→xhigh) ช่วยให้คุณแลกความหน่วงกับการวางแผนหลายขั้นตอนอย่างรอบคอบ; มันถูกออกแบบมาสำหรับงานที่มีความเสี่ยงสูงกว่าและมีระยะยาว ซึ่งคุณต้องการให้โมเดลจัดการเครื่องมือและคงสถานะข้ามขั้นตอน
บทสรุป: โมเดลใด “ชนะ”? ไม่มีผู้ชนะเพียงรายเดียว — แต่ละโมเดลมุ่งเป้าส่วนที่เติมเต็มกันของวงจรวิศวกรรมซอฟต์แวร์ GPT-5.3-Codex เหมาะกว่าเมื่อความถูกต้อง การให้เหตุผลระยะยาว และการจัดออร์เคสเตรตเครื่องมือมีความสำคัญ GPT-5.3-Codex-Spark ชนะในบริบทที่การคงโฟลว์ของนักพัฒนาและการลดความหน่วงเป็นสิ่งสำคัญ สำหรับองค์กรส่วนใหญ่ กลยุทธ์ที่ถูกต้องไม่ใช่การเลือกอย่างใดอย่างหนึ่ง แต่เป็นการบูรณาการ: ใช้ Codex เป็นสถาปนิก และ Spark เป็นช่างก่อ Early adopters รายงานผลผลิตเพิ่มขึ้นเมื่อเชื่อมทั้งสองเข้ากับเครื่องมือโดยมีกระบวนการตรวจสอบที่เข้มแข็ง
นักพัฒนาสามารถเข้าถึง GPT-5.3 Codex ผ่าน CometAPI ได้แล้ว เริ่มต้นโดยสำรวจขีดความสามารถของโมเดลใน Playground และดู คู่มือ API เพื่อคำแนะนำรายละเอียด ก่อนเข้าถึง กรุณาแน่ใจว่าคุณได้ล็อกอิน CometAPI และได้รับคีย์ API แล้ว CometAPI เสนอราคาต่ำกว่าราคาอย่างเป็นทางการอย่างมากเพื่อช่วยให้คุณผสานรวม
หากคุณต้องการเคล็ดลับ คู่มือ และข่าวสาร AI เพิ่มเติม ติดตามเราได้บน VK , X และ Discord !