
สรุป
GPT-6 Astra ทำคะแนนพาดหัวที่โดดเด่น โดยได้กำไรสูงสุดเมื่อ “การให้เหตุผล” ต้องแปลงเป็น “การลงมือทำ”: การปฏิบัติการผ่านเทอร์มินัล การใช้ซอฟต์แวร์ ระบบอัตโนมัติ การค้นคืนบริบทยาว เวิร์กโฟลว์ทางวิทยาศาสตร์ และความปลอดภัยไซเบอร์ สำหรับแบบทดสอบเชิงวิชาการที่เข้าใกล้เพดานแล้ว การพัฒนาจากรุ่นก่อนของ OpenAI มักเล็กกว่ามาก
โมเดลนี้ผสาน หน้าต่างบริบท 1,050,000 โทเค็น เข้ากับการรองรับเครื่องมือที่กว้างขวาง เกณฑ์ปฏิบัติที่ OpenAI เผยแพร่ชี้ว่าการอัปเกรดมีผลชัดที่สุดในงานระยะยาว แต่การออกแบบฮาร์เนส ความพยายามเชิงเหตุผล ระยะหน่วง และการเข้าถึงเครื่องมือส่งผลอย่างมีนัยสำคัญต่อผลลัพธ์
ประเด็นสำคัญ
- จุดเด่นที่สุดของ Astra คือการดำเนินงานเชิงตัวแทน ไม่ใช่คำตอบทุกประเภท
- ผลลัพธ์ของ Terminal-Bench, AutomationBench, การใช้คอมพิวเตอร์ และการย้ายฐานข้อมูล แสดงการขยับที่ใหญ่กว่ามากเมื่อเทียบกับ GPQA หรือ DeepSWE
- ผล ARC-AGI-3 แสดงว่าภาวะโมเดล การจัดการบริบท และฮาร์เนสประเมินผล สามารถครอบงำคะแนนสุดท้ายได้
- หน้าต่างบริบทขนาดใหญ่จะมีความหมายก็ต่อเมื่อข้อมูลยังค้นคืนได้ใกล้ขีดจำกัด; MRCR ให้ข้อมูลมากกว่าเพียงความจุที่โฆษณา
- ราคาต่อโทเค็นที่สูงกว่าไม่ได้หมายความว่าค่างานจะสูงกว่าโดยอัตโนมัติ หากโมเดลใช้โทเค็น นับรอบ ลองซ้ำ หรือการแก้ไขของมนุษย์น้อยลง
- การตัดสินใจในงานผลิตต้องพิจารณาอัตราความสำเร็จ เวลาที่ใช้จริง ต้นทุนรวม ความเชื่อถือได้ของเครื่องมือ และภาระการแก้ไขร่วมกัน
GPT-6 Astra โดยสรุป
OpenAI ระบุเอาต์พุตได้สูงสุด 128,000 โทเค็น รับอินพุตทั้งข้อความและภาพ ให้เอาต์พุตเป็นข้อความ และตั้งค่าความพยายามเชิงเหตุผลได้ตั้งแต่ต่ำจนถึงสูงสุด สเปคเหล่านี้ทำให้เวิร์กโฟลว์ขนาดใหญ่หลายขั้นตอนเป็นไปได้ แต่ไม่ได้พิสูจน์ว่าโมเดลจะค้นหลักฐานที่ถูกต้องหรือทำงานสำเร็จอย่างเชื่อถือได้
| สเปคทางการ | GPT-6 Astra ใน CometAPI | ความหมายเชิงปฏิบัติ |
|---|---|---|
| Model ID | gpt-6-astra | ตัวระบุที่เสถียรสำหรับการกำหนดเส้นทาง API |
| Context window | 1,050,000 tokens | รองรับคลังโค้ด/เอกสารขนาดใหญ่และประวัติเอเจนต์ |
| Maximum output | 128,000 tokens | รองรับรายงาน แพตช์ และอาร์ติแฟกต์เชิงโครงสร้างขนาดใหญ่ |
| Knowledge cutoff | April 30, 2026 | ข้อเท็จจริงหลังจากนี้ต้องใช้เครื่องมือหรือแหล่งที่ให้มา |
| Input | Text and images | รองรับเอกสาร ภาพหน้าจอ แผนภาพ และหลักฐานแบบผสม |
| Output | Text | สร้างร้อยแก้ว โค้ด และข้อความเชิงโครงสร้าง |
| Reasoning effort | low, medium, high, xhigh, max | แลกระหว่างระยะหน่วง/ต้นทุนกับการค้นหาเชิงลึก |
| Agent capabilities | Function calling, structured outputs, computer use, web/file search, hosted shell, Apply Patch, MCP | เปิดใช้งานเวิร์กโฟลว์ครบวงจร แทนคำตอบแยกส่วน |
| OpenAI Standard input | $10 per million tokens | ขนาดอินพุตและการใช้แคชซ้ำมีผลต่อค่าใช้จ่ายรวม |
| OpenAI cached input | $1 per million tokens | ใช้เมื่อพรีฟิกซ์พรอมป์ต์ถูกนำมาจากแคช |
| OpenAI cache writes | $12.50 per million tokens | คิดค่าบริการ 1.25× ของอัตราอินพุตที่ไม่แคช |
| OpenAI Standard output | $50 per million tokens | เอาต์พุตที่ยาวสามารถครองต้นทุนงาน |
| Requests above 272K input tokens | Input and cache rates ×2; output rate ×1.5 | อัตราที่สูงกว่านี้ใช้กับคำร้องทั้งรายการ |
ขีดจำกัดบริบทวัดความจุ ไม่ใช่การจดจำที่ใช้งานได้ รายการเครื่องมือวัดความพร้อมใช้งาน ไม่ใช่ความสำเร็จในการปฏิบัติ จำเป็นต้องมีเกณฑ์เพื่อทดสอบว่าสเปคเหล่านี้แปลงเป็นงานที่เสร็จจริงหรือไม่
ผลเกณฑ์ของ GPT-6 Astra บอกอะไร?
พอร์ตโฟลิโอแสดงรูปแบบที่ไม่เสมอกัน Astra แทบไม่ขยับจาก Sol ในบางแบบทดสอบเชิงวิชาการและเหตุผลด้านซอฟต์แวร์ แต่กลับเพิ่มขึ้นเลขสองหลักในงานเทอร์มินัล ระบบอัตโนมัติ การย้ายฐานข้อมูล ปฏิสัมพันธ์เชิงภาพ การค้นคืนบริบทยาว และคณิตศาสตร์ขั้นสูง
| เกณฑ์ที่เผยแพร่ | GPT-6 Astra | GPT-5.6 Sol | Claude Fable 5.1 | Astra vs. Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 57.9% | 37.3% | 55.8% | +20.6 pp |
| DeepSWE v1.1 | 74.1% | 72.7% | 67.4% | +1.4 pp |
| Database Migration Tasks | 63.9% | 42.7% | 57.8% | +21.2 pp |
| OSWorld 2.0 | 72.6% | 65.7% | — | +6.9 pp |
| ScreenSpot-Pro | 92.7% | 76.9% | — | +15.8 pp |
| AutomationBench | 41.4% | 18.1% | 31.4% | +23.3 pp |
| BenchCAD | 95.9% | 83.3% | 84.3% | +12.6 pp |
| FrontierMath Tier 4 v2 | 97.6% | 83.0% | 87.8% | +14.6 pp |
| GPQA Diamond | 96.0% | 94.6% | 93.7% | +1.4 pp |
| MRCR v2, 512K–1M | 96.3% | 73.8% | — | +22.5 pp |
| AA Intelligence Index v4.1.1 | 61.2 | 60.9 | 65.7 | +0.3 |
| ARC-AGI-3, Provider Adapter | 99.9% | 7.8% | — | +92.1 pp |
เกิดคลัสเตอร์สามกลุ่ม กลุ่มแรก ความต่าง 1.4 จุดใน DeepSWE และ GPQA บ่งชี้การขยับเพิ่มที่จำกัดในงานที่โมเดลแข็งแรงอยู่แล้ว กลุ่มที่สอง กำไรเกิน 20 จุดใน Terminal-Bench, AutomationBench การย้ายฐานข้อมูล และการค้นคืนระดับล้านโทเค็น แสดงการเปลี่ยนแปลงด้านการปฏิบัติที่ใหญ่กว่า กลุ่มที่สาม ARC-AGI-3 เป็นค่าผิดปกติที่ขึ้นกับการตีความฮาร์เนส
ผลการทดสอบอิสระ
Artificial Analysis รายงาน Astra และ Sol อยู่ที่ประมาณ 61 บน Intelligence Index พร้อมทั้งแสดงกำไรที่ชัดกว่าบน Coding Agent Index สิ่งนี้เสริมข้อมูลของ OpenAI อย่างอิสระ: การปรับปรุงที่ใหญ่ที่สุดกระจุกตัวในงานเชิงตัวแทน
ที่ความพยายามสูงสุดในฮาร์เนส Codex Astra reportedly ใช้ จำนวนโทเค็นประมาณหนึ่งในสาม ของ Sol บน Coding Agent Index ขณะที่การใช้โทเค็นบน Intelligence Index ลดลงเพียงประมาณ 10% เนื่องจากอัตราโทเค็นของ Astra สูงกว่า โปรไฟล์ประสิทธิภาพสองแบบนี้จึงสร้างเศรษฐศาสตร์ที่ต่างกัน
| การประเมินอิสระ | ผลที่สังเกต | ความหมายในงานผลิต |
|---|---|---|
| Intelligence Index | แทบไม่แยกจาก Sol | เหตุผลกว้างอาจไม่คุ้มพรีเมียมราคา |
| Coding Agent Index | ปรับปรุงเชิงตัวแทนอย่างชัดเจน | ใช้โทเค็นน้อยลงอาจชดเชยอัตราโทเค็นที่สูงขึ้น |
| AA-Omniscience | อัตราเพ้อฝันลดจาก 92% เหลือ 51% ที่ความพยายามสูงสุด | การงดตอบที่ดีขึ้นอาจสำคัญสำหรับระบบวิจัยและค้นคืน |
| งานความรู้ระยะยาว | ความคืบหน้าผสมผสานข้ามงาน | ยังจำเป็นต้องประเมินภายในองค์กร |
ไม่มีเกณฑ์อิสระใดรับรองความเป็นข้อเท็จจริงหรือความปลอดภัยในงานผลิต ทีมงานควรให้คะแนนคำตอบที่ถูกต้อง ความไม่แน่นอนที่มีเหตุผล อ้างอิงที่ไม่มีหลักฐาน และความล้มเหลวในการปฏิบัติตามข้อจำกัดของแหล่งข้อมูลแยกต่างหาก
เหตุใด Astra จึงเหมาะกับงานเชิงตัวแทนระยะยาวมากกว่า?
GPT-6 Astra เพิ่มตัวควบคุมสามอย่างที่ออกแบบมาสำหรับงานที่เปลี่ยนแปลงระหว่างรัน ความเชื่อถือได้ของงานระยะยาวยังขึ้นกับระบบบริบททั้งหมด: หน้าต่างบริบทกำหนดความจุ; การบีบย่อควบคุมว่าข้อมูลเก่าถูกย่ออย่างไร; เหตุผลที่คงอยู่พาสถานะโมเดลที่เกี่ยวข้องไปข้างหน้า; การค้นคืนทำให้หลักฐานก่อนหน้ายังค้นได้; และแอปต้องเก็บเอาต์พุตของเครื่องมือ ผลการทดสอบ วิธีที่ล้มเหลว และข้อกำหนดผู้ใช้อย่างสำคัญ กลไกเหล่านี้ควรทดสอบร่วมกับฮาร์เนสเอเจนต์
- การเรียกเครื่องมือแบบ async: Astra สามารถเดินเหตุผลต่อเองหรือเรียกเครื่องมืออื่นระหว่างที่แอปกำลังรันเครื่องมือที่กินเวลานาน
- การกำกับระหว่างเทิร์น: แอปสามารถส่งการแก้ไขหรือข้อกำหนดใหม่ผ่าน WebSocket โดยไม่ต้องทิ้งงานที่ทำเสร็จแล้ว
- การปรับเหตุผลกลางบทสนทนา: การอัปเดตคอนฟิกสามารถเพิ่มหรือลดความพยายามเชิงเหตุผล พร้อมรักษาพรีฟิกซ์พรอมป์ต์ที่แคชไว้
จุดที่ GPT-6 Astra ดีขึ้นจริง
การเขียนโค้ดเชิงตัวแทน: งานเทอร์มินัลคือการอัปเกรดยิ่งใหญ่กว่า
Terminal-Bench 4.0 ประเมินว่าเอเจนต์สามารถทำงานเทอร์มินัลที่ยากได้หรือไม่ แทนที่จะสร้างคำตอบโค้ดแบบเดี่ยว Astra ทำได้ 57.9% สูงกว่า Sol 20.6 จุด และสูงกว่า Fable 2.1 จุด นี่คือการก้าวกระโดดจากรุ่นสู่รุ่นที่สำคัญสำหรับ OpenAI แต่ข้อได้เปรียบเหนือระบบเชิงตัวแทนระดับแนวหน้ารายอื่นนั้นแคบกว่า
DeepSWE ให้ภาพอีกแบบ: Astra 74.1% และ Sol 72.7% ความต่าง 1.4 จุดเตือนว่าอย่าทั่วไปจากเกณฑ์โค้ดตัวเดียว Astra ดูเหมือนได้กำไรสูงสุดเมื่อการเขียนโค้ดต้องปฏิสัมพันธ์กับสภาพแวดล้อม การทำซ้ำ การคงสถานะ และการยืนยันผล
งาน Database Migration ย้ำข้อสรุปนั้น ผล 63.9% สูงกว่า Sol 21.2 จุด และสูงกว่า Fable 6.1 จุด งานย้ายประกอบด้วยความเข้าใจโค้ด การใช้เครื่องมือ การจัดลำดับ และวิจารณญาณเชิงปฏิบัติการ—เวิร์กโฟลว์ผสมที่การปรับปรุงเหตุผลเล็กๆ สามารถสะสมเป็นกำไรความสำเร็จที่ใหญ่กว่า
สำหรับเอเจนต์เขียนโค้ด ประเมินโมเดลและฮาร์เนสไปด้วยกัน คำแนะนำในรีโป เครื่องมือเทอร์มินัล พฤติกรรมการลองซ้ำ การคงบริบท และการรันทดสอบล้วนมีส่วนต่อผลวัดได้
การใช้คอมพิวเตอร์: อัตราความสำเร็จและเวลารันสำคัญทั้งคู่
ใน Agents’ Last Exam GPT-6 Astra ได้ 59.3% เทียบกับ GPT-5.6 Sol ที่ 53.6% เพิ่มขึ้น 5.7 จุด นี่เติมผลงานเชิงเอเจนต์ที่กว้างขึ้นเข้ากับคะแนน OSWorld 2.0 และ ScreenSpot-Pro ในภาพรวมด้านบน
นอกเหนือจากความแม่นยำ การเปรียบเทียบเวลาใน OSWorld เพิ่มมิติที่ใช้งานจริง: OpenAI รายงานเวลาต่อภารกิจประมาณ 40 นาทีสำหรับ Astra เทียบกับราว 75 นาทีสำหรับ Sol หรือเวลาที่ผ่านไปลดลงประมาณ 47% พร้อมเพิ่มอัตราความสำเร็จ
เอเจนต์ที่สำเร็จบ่อยขึ้นเล็กน้อยและจบงานเร็วขึ้นมากสามารถเพิ่มอัตราการส่งงานได้อย่างมีนัยสำคัญ การทดสอบจัดซื้อจึงควรรายงานอัตราความสำเร็จ เวลาที่ผ่านไป การเรียกเครื่องมือ การลองซ้ำ และการแทรกแซงของมนุษย์—ไม่ใช่แค่ความแม่นยำ
ระบบอัตโนมัติและงานมืออาชีพ
AutomationBench เพิ่มจาก 18.1% เป็น 41.4% กำไร 23.3 จุด คะแนนสัมบูรณ์ยังห่างจากความสมบูรณ์แบบ แต่รูปแบบความล้มเหลวที่เปลี่ยนไปสำคัญกว่าการขยับหนึ่งจุดใกล้เพดาน บน BenchCAD Astra ทำได้ 95.9% นำ Sol 12.6 จุด และ Fable 11.6 จุด
ผลเหล่านี้สนับสนุนข้ออ้างเฉพาะ: Astra เก่งขึ้นในการแปลงคำสั่งเป็นลำดับการกระทำที่ผ่านการยืนยัน แต่ไม่ได้พิสูจน์ว่าทุกเวิร์กโฟลว์ธุรกิจจะได้กำไรเท่ากัน กระบวนการผลิตอาจเพิ่มขั้นตอนยืนยันตัวตน อินเทอร์เฟซเฉพาะ นโยบายที่คลุมเครือ หรือรูปแบบข้อมูลที่ไม่อยู่ในเกณฑ์
วิทยาศาสตร์
วิทยาศาสตร์เป็นหนึ่งในกำไรความสามารถที่ชัดเจนของ Astra บน FrontierMath Tier 4 v2 Astra ได้ 97.6% เทียบกับ Sol 83.0% และ Fable 87.8% ความต่าง 14.6 จุดเหนือ Sol สำคัญมาก แม้ว่าเกณฑ์นี้จะครอบคลุมการกระจายภารกิจที่คัดเลือก ไม่ใช่เวิร์กโฟลว์วิทยาศาสตร์ทั้งหมด
ความปลอดภัยไซเบอร์
ความปลอดภัยไซเบอร์เป็นอีกกำไรใหญ่ พร้อมความเสี่ยงสูงกว่าการจัดอันดับทั่วไป บน ExploitBench ครอบคลุมมิถุนายน–สิงหาคม 2026 Astra ได้ 39.0% เทียบกับ Sol 5.5% OpenAI รายงานว่าชุดใหม่นี้มุ่งเป้าช่องโหว่ในสามเดือนก่อนหน้าเพื่อลดการเปิดรับในอดีต ในการประเมินด้านไซเบอร์ของ OpenAI Astra แสดงความสามารถในการค้นหาและใช้ประโยชน์ช่องโหว่ zero-day ที่ไม่เคยรู้จักมาก่อน 2 รายการในสภาวะควบคุม ผลนี้สำคัญเพราะการประเมินออกแบบรอบช่องโหว่ที่เปิดเผยล่าสุด ไม่ใช่ปัญหาที่เป็นที่รู้จักมานาน จึงลดโอกาสที่ผลงานเกิดจากตัวอย่างจำ โมเดลจึงไปถึงเกณฑ์ความสามารถไซเบอร์ระดับ Critical ของ OpenAI และเปลี่ยนข้อกำหนดด้านการป้องกันที่ต้องใช้ในการนำไปใช้งาน ความหมายไม่ใช่ว่า Astra สามารถปฏิบัติการไซเบอร์แบบไร้ข้อจำกัดเองได้ แต่ระดับความสามารถที่สูงขึ้นเปลี่ยนข้อกำหนดด้านการป้องกัน ระบบที่มีความสามารถค้นหาและใช้ประโยชน์ช่องโหว่ที่แข็งแกร่งขึ้นต้องการการควบคุมการเข้าถึง การเฝ้าระวัง การ sandbox และกลไกการทบทวนโดยมนุษย์ที่เข้มงวดกว่า
งานระยะยาว: หน้าต่างบริบทไม่ใช่ทุกอย่าง
หน้าต่างบริบท 1,050,000 โทเค็นของ Astra อธิบายความจุ ไม่ใช่ความต่อเนื่อง ประสิทธิภาพระยะยาวขึ้นกับการบีบย่อ สถานะที่คงอยู่ ค้นหาบริบทก่อนหน้าได้ เหตุผลที่คงอยู่ และการเก็บเอาต์พุตเครื่องมือ ใน MRCR v2 Astra ได้ 100.0% ที่ 256K–512K และ 96.3% ที่ 512K–1M ขณะที่ Sol ได้ 91.5% และ 73.8% ความต่าง 22.5 จุดในช่วงยาวสุดแสดงว่าการค้นคืนที่ใช้งานได้ใกล้ขีดจำกัดสำคัญกว่าความจุที่โฆษณา
MRCR ยังคือการทดสอบค้นคืนแบบสังเคราะห์ ดังนั้นการประเมินงานผลิตควรเก็บหลักฐานที่สรุปมักทำหาย: เหตุใดการแก้ก่อนหน้าถึงล้มเหลว พฤติกรรมของคอมโพเนนต์เฉพาะ ผลการทดสอบ ข้อกำหนดเชิงประวัติ และรายละเอียดในเอาต์พุตเครื่องมือ คลังรีโปและคลังวิจัยควรทดสอบด้วยชื่อซ้ำ การอ้างไขว้ นโยบายล้าสมัย แหล่งข้อมูลขัดแย้ง และช่วงตัวเบี่ยงยาว เพื่อแยกความจุบริบทดิบออกจากพฤติกรรมการคงบริบทและค้นคืนที่เอเจนต์ระยะยาวต้องการจริง
การคงบริบท: เหตุใด Astra จึงต่างจากระบบบริบทยาวแบบดั้งเดิม
เวิร์กโฟลว์บริบทยาวแบบดั้งเดิมมักเป็นรูปแบบ:
context → compaction → summary → continue
แนวทางนี้ลดการใช้โทเค็น แต่เสี่ยงสำคัญ: ข้อมูลระหว่างทางที่สำคัญอาจหายไประหว่างการสรุป
ข้อมูลที่หายมักไม่ใช่คำตอบสุดท้าย แต่เป็นรายละเอียดเชิงปฏิบัติที่จำเป็นต่อการตัดสินใจในอนาคต:
- เหตุใดการแก้ก่อนหน้าจึงล้มเหลว;
- คอมโพเนนต์ใดแสดงพฤติกรรมผิดปกติ;
- ผลทดสอบใดเปลี่ยนทิศทางการพัฒนา;
- ข้อกำหนดผู้ใช้ใดถูกเพิ่มภายหลัง;
- เอาต์พุตเครื่องมือใดมีหลักฐานสำคัญ
GPT-6 Astra แก้ข้อจำกัดนี้โดยผสานกลไกการคงบริบทและการค้นคืนไว้ในเวิร์กโฟลว์เอเจนต์ระยะยาว
แทนที่จะพึ่งพาเฉพาะสรุปแบบบีบ ระบบสามารถเก็บบันทึกสำคัญ ค้นคืนข้อมูลก่อนหน้าเมื่อจำเป็น และรักษาความต่อเนื่องระหว่างปฏิสัมพันธ์กับเครื่องมือหลายครั้ง
สำหรับเอเจนต์เขียนโค้ดอย่าง Codex นี่หมายความว่างานดีบักระยะยาวสามารถเก็บ:
- การทดลองที่ล้มเหลวก่อนหน้า;
- การเปลี่ยนแปลงในรีโพ;
- เอาต์พุตการทดสอบ;
- การตัดสินใจเชิงสถาปัตยกรรม;
- ประเด็นที่ยังไม่คลี่คลาย
ดังนั้น มูลค่าของหน้าต่างบริบท 1M โทเค็นของ Astra ไม่ใช่แค่ปริมาณข้อมูลที่รับได้ แต่คือความสามารถของระบบในการคงและกู้คืนข้อมูลที่ถูกต้องหลังจากโต้ตอบกันเป็นชั่วโมง
การให้เหตุผลและการตีความ
ARC-AGI-3: ฮาร์เนสคือส่วนหนึ่งของผลลัพธ์
ARC-AGI-3 แสดงชัดเจนที่สุดว่าเกณฑ์แนวหน้าสามารถวัด “ระบบ” มากกว่า “โมเดลเดี่ยว” ARC Prize รายงาน 62.7% ด้วย Standard harness ที่ความพยายามสูงสุด และ 99.9% ด้วย Provider Adapter ที่ความพยายามระดับ high
| การประเมิน ARC Prize | Standard Harness | Provider Adapter | กำไรจาก Adapter |
|---|---|---|---|
| max | 62.7% | 98.6% | +35.9 pp |
| xhigh | 59.3% | 98.4% | +39.1 pp |
| high | 54.8% | 99.9% | +45.1 pp |
| medium | 38.6% | 98.4% | +59.8 pp |
| low | 17.5% | 98.0% | +80.5 pp |
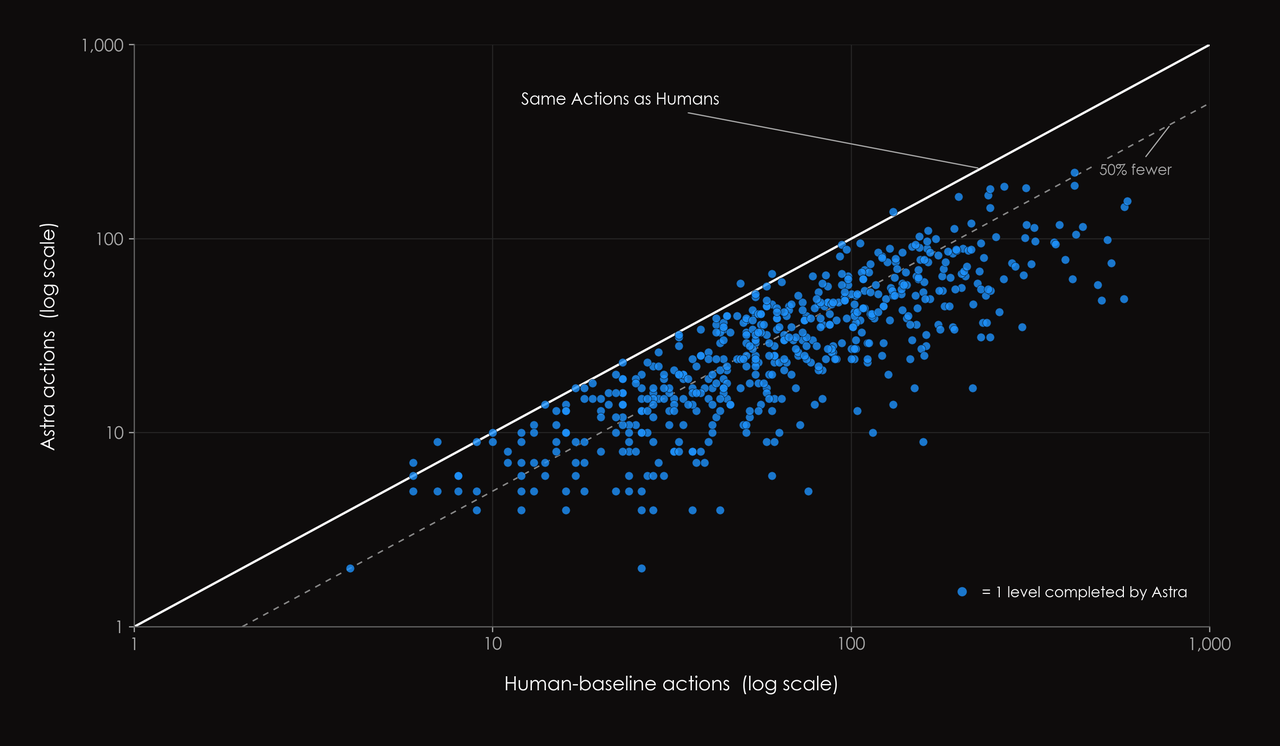
การเปรียบเทียบประสิทธิภาพการกระทำของ Astra ข้ามฮาร์เนสประเมินของ ARC Prize
นโยบาย provider-neutral harness กำหนดให้โมเดลคงข้อมูลสำคัญไว้ในสถานะที่มองเห็นได้ Provider Adapter จะรักษาสถานะเหตุผลเพิ่มเติมและใช้การจัดการบริบทเฉพาะผู้ให้บริการ ข้ามคู่โจทย์-คำตอบที่แก้ร่วมกัน ARC Prize รายงานการรันเร็วขึ้น 3.66× และใช้โทเค็นรวมลดลง 49% ด้วย Adapter
ผล 99.9% วัด “ระบบโมเดล–ผู้ให้บริการ–อะแดปเตอร์” เฉพาะ และไม่ควรถูกมองว่าเป็นตัวชี้วัดความฉลาดดิบของโมเดลที่อิสระจากฮาร์เนส สถาปัตยกรรมบริบทเป็นส่วนหนึ่งของระบบที่ถูกประเมิน
ความพยายามเชิงเหตุผลไม่ได้สเกลเชิงเส้น
ตาราง ARC ยังแสดงว่า “ความพยายามสูงสุด” ไม่ได้ให้คะแนนสูงสุดเสมอไป ความพยายามระดับ high ได้ 99.9% กับ Provider Adapter ขณะที่ระดับ max ได้ 98.6% ใน Standard harness ระดับ max ทำคะแนนดีที่สุด
OpenAI ระบุว่าตัวเลขในตารางเปิดตัวโดยทั่วไปใช้ การตั้งค่าความพยายามเชิงเหตุผลที่ดีที่สุดที่สังเกตได้ วิธีนี้ประมาณเพดานประสิทธิภาพ แต่ไม่ได้บอกคอนฟิกที่ดีที่สุดในงานผลิต ทีมงานควรทดสอบหลายระดับความพยายามและคำนวณคุณภาพส่วนเพิ่มต่อวินาทีและดอลลาร์ที่เพิ่มขึ้น
คณิตศาสตร์และเหตุผลเชิงวิชาการ
FrontierMath Tier 4 v2 เพิ่มจาก 83.0% เป็น 97.6% กำไร 14.6 จุด นี่คือการพัฒนาที่ใหญ่ แต่ไม่ใช่หลักฐานว่าคณิตศาสตร์แนวหน้าถูกแก้ทั้งหมด การประเมินครอบคลุมการกระจายภารกิจที่คัดเลือก และไม่ได้วัดทุกขั้นของงานวิจัยคณิตศาสตร์ เช่น การเลือกปัญหา การตรวจพิสูจน์อย่างเป็นทางการ การพัฒนาโปรแกรมระยะยาว หรือการทบทวนโดยเพื่อนในทางปรปักษ์
GPQA Diamond ให้รูปแบบตรงข้าม: Astra 96.0% Sol 94.6% Fable 93.7% และ Gemini 3.8 Flash 95.3% โมเดลจับกลุ่มแน่นใกล้เพดาน การรายงานความต่าง Astra–Sol 1.4 จุดถูกต้อง แต่เรียกมันว่าการปฏิวัติความฉลาดอย่างกว้างจะเกินเลยหลักฐาน
ความสามารถเชิงวิกฤต + มาตรการป้องกัน
| การประเมินไซเบอร์ | Astra | Sol | กำไรสัมบูรณ์ |
|---|---|---|---|
| ExploitBench | 100.0% | 78.5% | +21.5 pp |
| ExploitGym | 42.4% | 30.3% | +12.1 pp |
| ExploitBench, June–August 2026 | 39.0% | 5.5% | +33.5 pp |
| SRE-Bench | 88.0% | 55.9% | +32.1 pp |
| SEC-Bench Pro | 85.4% | 79.1% | +6.3 pp |
OpenAI สร้าง ExploitBench (มิถุนายน–สิงหาคม 2026) จากช่องโหว่ที่เปิดเผยในสามเดือนก่อนหน้า เพื่อลดโอกาสที่การเปิดรับในอดีตจะทำให้ผลสูงเกินจริง Astra ได้ 39.0% ในชุดนี้เทียบกับ Sol 5.5% และ OpenAI รายงานว่า Astra พบและใช้ประโยชน์ช่องโหว่ zero-day ที่ไม่เคยรู้จักมาก่อนสองรายการ ผลเหล่านี้ทำให้ Astra กลายเป็นโมเดลที่นำไปใช้ในวงกว้างตัวแรกของ OpenAI ที่ถึงเกณฑ์ความสามารถไซเบอร์ระดับ Critical ซึ่งส่งผลโดยตรงต่อมาตรการป้องกันและนโยบายการเข้าถึง
วิธีอ่านคะแนนที่เข้าใกล้เพดาน
คะแนนเกิน 90% ต้องใช้ภาษาระมัดระวังมากกว่าคะแนนกลางๆ ขยับจาก 50% เป็น 60% แก้ภารกิจเพิ่ม 10 งานจากทุก 100 งาน ขยับจาก 95% เป็น 96% แก้เพิ่มเพียง 1 งานจากทุก 100 งาน แม้จะลดข้อผิดพลาดจาก 5 เหลือ 4 ซึ่งเท่ากับลดความผิดพลาด 20% ทั้งสองคำอธิบายถูกต้องทางคณิตศาสตร์ แต่รองรับพาดหัวคนละแบบ
ข้อควรระวังตรงกันข้ามใช้กับเกณฑ์คะแนนต่ำ เพิ่มจาก 18.1% เป็น 41.4% ยังห่างไกลจากการทำงานอัตโนมัติที่เชื่อถือได้ แต่เพิ่มจำนวนกรณีสำเร็จมากกว่าสองเท่า และเปลี่ยนเวิร์กโฟลว์แบบกำกับดูแลได้ คะแนนสัมบูรณ์กำหนดความพร้อมของระบบ; ขนาดการปรับปรุงบอกความเร็วในการเปลี่ยนความสามารถ ตัดสินใจงานผลิตต้องใช้ทั้งสองด้าน
การเปรียบเทียบหลายมิติ
| มิติ | Astra | Sol | Fable | สัญญาณตัดสินใจ |
|---|---|---|---|---|
| เหตุผลเชิงวิชาการทั่วไป | ยอดเยี่ยม; มักใกล้เพดาน | ตามหลังเล็กน้อย | แข่งขันได้ | ช่องว่างเล็กมักไม่ชี้ขาดการนำไปใช้ |
| การปฏิบัติการเทอร์มินัล | ระดับแนวหน้า | ช่องว่างระหว่างรุ่นใหญ่ | คู่แข่งใกล้เคียง | ทดสอบฮาร์เนสโค้ดเต็มรูปแบบ |
| การใช้คอมพิวเตอร์ | ความสำเร็จสูงและเวลารันต่ำกว่า | ช้ากว่าและแม่นยำน้อยกว่า | ข้อมูลเทียบเคียงในตารางเปิดตัวยังไม่พอ | วัดความสำเร็จต่อชั่วโมง |
| การค้นคืนบริบทยาว | แข็งแกร่งใกล้ 1M โทเค็น | เสื่อมลงอย่างมีนัยใกล้ขีดจำกัด | ข้อมูลเทียบเคียงโดยตรงไม่เพียงพอ | ใช้การทดสอบค้นคืนที่คล้ายงานจริง |
| การควบคุมเหตุผล | low ถึง max | ช่วงความพยายามต่างกัน | แนวทางปรับคิดตามสถานการณ์ | ปรับคอนฟิก ไม่ใช่แค่ชื่อโมเดล |
| ความสามารถไซเบอร์ | ระดับความเสี่ยงสูงกว่าเชิงคุณภาพ | ผลเผยแพร่ต่ำกว่า | ไม่ได้เปรียบเทียบที่นี่ | มาตรการป้องกันและนโยบายสำคัญ |
| เศรษฐศาสตร์โทเค็น | อัตราสูงกว่า; บางครั้งใช้โทเค็นน้อยกว่า | อัตราต่ำกว่า | ขึ้นกับภารกิจ | เทียบต้นทุนต่อภารกิจที่สำเร็จ |
ผลขึ้นกับภารกิจ Astra น่าดึงดูดที่สุดเมื่อภารกิจต้องปฏิสัมพันธ์กับเครื่องมือ/สภาพแวดล้อมอย่างต่อเนื่อง การกู้คืนหลังล้มเหลว หรือการค้นคืนที่เชื่อถือได้ในบริบทขนาดใหญ่มาก Sol อาจคุ้มค่ากว่าสำหรับงานที่จำกัด มีบริบทพอประมาณ และทำซ้ำจำกัด Fable เป็นคู่แข่งใกล้เคียงในงานเทอร์มินัลและนำในบางการประเมินเชิงวิชาการภายนอก ดังนั้นเกณฑ์ระดับแอปจึงมีประโยชน์กว่าข้อสรุประดับผู้ให้บริการ
ใครบ้างควรใช้ GPT-6 Astra?
| กรณีใช้งาน | คำแนะนำ |
|---|---|
| การจัดประเภทอย่างง่าย | ไม่จำเป็นต้องใช้ Astra |
| การสรุปอย่างง่าย | ไม่จำเป็นต้องใช้ Astra |
| RAG มาตรฐาน | เปรียบเทียบต้นทุนกับประสิทธิภาพก่อน |
| สังเคราะห์/วิเคราะห์เอกสารยาว | ควรทดสอบ Astra |
| เอเจนต์เขียนโค้ด | แนะนำให้ทดสอบอย่างยิ่ง |
| การใช้คอมพิวเตอร์ | แนะนำให้ทดสอบอย่างยิ่ง |
| ระบบอัตโนมัติหลายขั้นตอน | แนะนำให้ทดสอบอย่างยิ่ง |
| งานวิจัยซับซ้อน | ควรทดสอบ |
| คอมพิวติ้งวิทยาศาสตร์/ซอฟต์แวร์เฉพาะทาง | ควรทดสอบ |
| ความปลอดภัยไซเบอร์ | ความสามารถแข็งแกร่ง แต่ต้องมีมาตรการความปลอดภัยที่เหมาะสม |
| งานปริมาณมาก-ง่าย | โมเดลราคาต่ำอาจคุ้มค่ากว่า |
กำไรประสิทธิภาพของ GPT-6 Astra คุ้มราคาที่สูงกว่าหรือไม่?
GPT-6 Astra แพงกว่า GPT-5.6 Sol อย่างมีนัย แต่การปรับปรุงไม่กระจายเท่ากันข้ามภารกิจ ดังนั้นคำถามด้านราคาไม่อาจตอบด้วยการเทียบอัตราโทเค็นอย่างเดียว
| สถานการณ์ | กำไรประสิทธิภาพ | เหตุผลด้านต้นทุน |
|---|---|---|
| ถาม-ตอบแบบง่าย | ปรับปรุงเล็ก | มักไม่คุ้มพรีเมียม |
| เอเจนต์เขียนโค้ด | ปรับปรุงใหญ่ | พรีเมียมอาจคุ้ม |
| การวิเคราะห์บริบทยาว | ปรับปรุงชัด | ขึ้นกับความต้องการค้นคืน |
| ระบบอัตโนมัติคอมพิวเตอร์ | ปรับปรุงแข็งแกร่ง | มักคุ้มค่าที่ทดสอบ |
| เหตุผลทั่วไป | ปรับปรุงจำกัด | เทียบต้นทุนอย่างระมัดระวัง |
ที่อัตรา OpenAI Standard GPT-6 Astra มีค่า $10 ต่อหนึ่งล้านโทเค็นอินพุต $1 ต่อหนึ่งล้านโทเค็นอินพุตจากแคช $12.50 ต่อหนึ่งล้านโทเค็นเขียนแคช และ $50 ต่อหนึ่งล้านโทเค็นเอาต์พุต อินพุตและเอาต์พุต Standard สูงกว่า GPT-5.6 Sol 2.5× (เมื่อเทียบกับ $4 และ $20) เมื่อคำร้องเกิน 272K โทเค็นอินพุต อัตราอินพุตและแคชของ Astra จะเพิ่มเป็นสองเท่า และอัตราเอาต์พุตเพิ่ม 1.5× สำหรับคำร้องทั้งรายการ
พรีเมียมราคาเข้ากันได้ดีที่สุดกับงานเชิงตัวแทน Astra เพิ่มมากกว่า 20 จุดบน Terminal-Bench, AutomationBench, การย้ายฐานข้อมูล และ MRCR ช่วงยาวสุด; การทดสอบอิสระยังรายงานว่าใช้โทเค็นประมาณหนึ่งในสามของ Sol บน Coding Agent Index ความสอดคล้องอ่อนกว่าบนเหตุผลกว้างที่ Intelligence Index แทบเสมอกันและใช้โทเค็นลดลงเพียง ~10% ดังนั้นการตัดสินใจซื้อต้องเทียบ “ต้นทุนต่อภารกิจที่สำเร็จ” รวมเอาต์พุต กิจกรรมแคช การใช้เครื่องมือ เวลา ลองซ้ำ ความล้มเหลว และการแก้ไขของมนุษย์
Cost per successful task
Cost per successful task = (Input cost + Output cost + Tool cost + Retry cost + Human review cost) / Successful tasks
Expected business cost
Expected business cost = API cost + Tool cost + Retry cost + Human-review cost + Failure cost
เมตริกการตัดสินใจควรเป็น “ต้นทุนรวมต่อภารกิจที่สำเร็จ” ที่คุณภาพผ่านเกณฑ์ที่รับได้—ไม่ใช่ราคาโทเค็นที่โฆษณา
นักพัฒนาควรประเมิน Astra อย่างไร
รายการอันดับสาธารณะควรกำหนดว่าอะไรควรถูกทดสอบ ไม่ใช่ตัดสินใจนำไปใช้ สร้างชุดภารกิจที่แทนงานจริง มีเคสทั่วไป เคสยาก เคสขาดบริบท ความล้มเหลวของเครื่องมือ และคำสั่งเชิงปรปักษ์ ใช้พรอมป์ต์งานผลิต สิทธิ์ แฟ้มต้นทาง งบเวลา และเกณฑ์เสร็จสมบูรณ์ชุดเดียวกันสำหรับทุกโมเดล
| มิติการประเมิน | สิ่งที่วัด | เหตุผลที่สำคัญ |
|---|---|---|
| ความสำเร็จภารกิจ | ผ่านเกณฑ์การยอมรับ | ป้องกันคำตอบที่น่าเชื่อแต่ไม่ครบถ้วนได้คะแนนสำเร็จ |
| ความเชื่อถือได้ | การกระจายความสำเร็จข้ามการรันซ้ำ | เปิดเผยชัยชนะครั้งเดียวที่ไม่เสถียร |
| การปฏิบัติการเครื่องมือ | การกระทำที่ตรวจยืนยันแล้วสำเร็จ | แยกการเรียกเครื่องมือออกจากผลลัพธ์ที่ถูกต้อง |
| ความเป็นข้อเท็จจริง | คำอ้างที่มีหลักฐานรองรับ | วัดคุณภาพหลักฐานและการงดตอบ |
| ระยะหน่วง | เวลาสำเร็จมัธยฐานและหาง | จับ throughput เชิงปฏิบัติ |
| ต้นทุน | ต้นทุนรวมต่อภารกิจที่สำเร็จ | รวมการลองซ้ำและความพยายามที่ล้มเหลว |
| ความพยายามมนุษย์ | นาทีของการแก้ไขและการทบทวน | มักครองต้นทุนจริงในงานผลิต |
| ความกำกับได้ | การกู้คืนหลังข้อกำหนดเปลี่ยน | ทดสอบพฤติกรรมเอเจนต์ระยะยาว |
Astra API ใน CometAPI ใช้ model ID gpt-6-astra API ที่รองรับหลายโมเดลทำให้รันทดสอบเดียวกันข้าม Astra, Sol, Fable และ Gemini ได้โดยไม่ต้องออกแบบเกณฑ์ใหม่ตามตารางพาดหัวของผู้ให้บริการรายเดียว ส่งงานเชิงตัวแทนที่หนักไปยังโมเดลที่ “คุ้มพรีเมียม” และใช้โมเดลราคาต่ำกว่าเมื่อความได้เปรียบที่วัดได้หายไป
บทสรุป
แผ่นคะแนนของ Astra น่าประทับใจ แต่คะแนนที่หวือหวาที่สุดไม่ได้มีประโยชน์โดยอัตโนมัติ ARC-AGI-3 แสดงศักยภาพของฮาร์เนสเอเจนต์เฉพาะผู้ให้บริการ; คะแนน Standard-harness แสดงว่าโครงสร้างพื้นฐานส่งผลอย่างแรง GPQA และ Intelligence Index อิสระชี้ว่าเหตุผลทั่วไปเพิ่มเพียงเล็กน้อย งานเทอร์มินัล ระบบอัตโนมัติ การใช้คอมพิวเตอร์ การค้นคืนบริบทยาว เวิร์กโฟลว์ทางวิทยาศาสตร์ และไซเบอร์ซิเคียวริตีบอกเรื่องสำคัญกว่า
การเปิดตัวนี้ไม่ใช่เรื่องแชตบอตที่ฉลาดขึ้นสัดส่วนในทุกคำถาม แต่คือปัญญาแนวหน้าที่เก่งขึ้นในการ “ทำงานให้เสร็จ” การอัปเกรดนั้นคุ้มจ่ายหรือไม่ขึ้นกับการกำหนดค่าระบบโมเดลทั้งหมดและเศรษฐศาสตร์ของ “ภารกิจที่สำเร็จ” ในงานผลิต