
TL;DR
Z.AI, GLM-6.0 adını kamuya açık biçimde duyurdu ve Full Self-Training’i yeni nesil yol haritasının merkezine yerleştirdi. Açıklanan yönelim, kendiliğinden üretilen deneyimi ön eğitim, orta-aşama eğitim ve sonraki eğitim boyunca öz değerlendirme ve düzeltmeyle bağlayarak, eğitimi tek seferlik veri üretimi yerine yönetilen bir geri besleme döngüsüne dönüştürüyor.
Zor kısım kontrol: GLM-6.0’ın sentetik veriyi arındırması, hataları tespit edip onarması, verimsiz yinelemeleri durdurması ve değerlendiricisinin kestirmeleri ödüllendirmesini önlemesi gerekir. Bu mekanizmalar, bağımsız doğrulama, güvenlik, maliyet ve yönetişim hakkında pratik sorular doğurur. Tüm bir model kartı, karşılaştırma paketi, API teknik özellikleri, fiyat veya yayın tarihi kamuya açık olmadığı için, makale spekülatif özellikler yerine eğitim mimarisi ve buna ilişkin kanıtları değerlendirir.
GLM 6.0 için Öne Çıkan Başlıklar?
- En güçlü kamuya açık kanıt, sızdırılmış bir parametre sayısı veya benchmark sonucundan ziyade Full Self-Training sistemine ilişkindir.
- Açıklanan yönelim; kendi ürettiği veriler, kendi kurduğu eğitim ortamları ve model destekli altyapı optimizasyonunu kapsar.
- Hedeflenen geri besleme döngüsü, Full Self-Training’i yalnızca bir sonraki eğitim tekniği olarak değil; ön eğitim, orta-aşama eğitim ve sonraki eğitimi kapsayacak şekilde tasarlar.
- Doğal multimodal modelleme, daha uzun ufuklu pekiştirmeli öğrenme, planlama, araç kullanımı, kurtarma ve doğrulama ilgili araştırma yönleridir; ancak bunlar henüz yayımlanmış GLM 6.0 özellikleri değildir.
- Ox Alpha, sızdırılmış GLM 6.0 performansına dair kanıt değildir; Z.AI, bunu GLM-5.3-Flash’ın ön sürüm kimliği olarak tanımlamıştır.
Z.AI GLM 6.0 Hakkında Aslında Neyi Doğruladı?
Z.AI’nin kamuya açık materyalleri dört somut sinyal ortaya koyuyor: GLM-6.0 adı, Full Self-Training’in merkezi eğitim yönelimi olması, ön–orta–sonraki eğitim boyunca planlanan döngü ve öz değerlendirme ile düzeltme mekanizması. Şirket ayrıca net gelirlerin yaklaşık %60’ının yeni nesil modelleri, Full Self-Training’i, büyük ölçekli eğitimi, çıkarımı, hesaplamayı ve ilgili altyapıyı desteklemeyi hedeflediğini ifade ediyor.
Z.AI’nin Full Self-Training Çerçevesi
Full Self-Training, GLM-6.0 için düzenleyici fikir olarak sunuluyor; küçük bir sonraki eğitim özelliği değil. Hedeflenen sistem; eğitim deneyimi üretir, sonuçlardan öğrenir, zayıf örnekleri filtreler ve açık kalite kontrolleri altında döngüyü tekrarlar.
GLM-6.0’da Ön–Orta–Sonraki Eğitim Boyunca Öz-Eğitim
Açıklanan sıra—ön eğitim, orta-aşama eğitim ve sonraki eğitim—öz-üretilmiş deneyimin yalnızca son ayarlama sırasında değil; temel bilgi, yetenek şekillendirme ve görev hizalamasını da etkileyebileceğini ima ediyor. Z.AI, veri setlerini, aşama sınırlarını veya karışım oranlarını açıklamadı; bu nedenle bunu eksiksiz bir tarif değil, doğrulanmış bir yönelim olarak görmek gerekir.
GLM-6.0 Öz-Değerlendirme ve Düzeltme Mekanizması
Yol haritası, Full Self-Training’i öz değerlendirme, hata tespiti, düzeltme ve verinin kendi kendini arındırmasıyla ilişkilendiriyor. Pratikte, modelin trajektörileri yargılaması, başarısız adımları revize etmesi, güvenilmez veriyi elmesi ve bağımsız ölçülen performans artık iyileşmediğinde daha fazla yinelemeyi durdurması gerekir. Değerlendirici tasarımı ve durdurma kuralları açıklanmadı.
The GLM-6.0 and Full Self-Training disclosure should be read together with Z.AI’s public proceeds allocation.
Bildiklerimiz ve Bilmediklerimiz
Kamuya açık kayıtlar bir yol haritasını destekliyor; bitmiş bir teknik özellik setini değil. Aşağıdaki tablo, açıklanmış niyeti kanıtsız ürün iddiasına dönüştürmemek için doğrulanmış yönlerle açık soruları ayırır.
| İddia | Kanıt durumu | Desteklenen | Bilinmeyenler |
|---|---|---|---|
| GLM-6.0 adı | Kamuya açık | Z.AI, yeni nesil modele GLM-6.0 adını verdi. | Yayın tarihi ve nihai konumlandırma. |
| Full Self-Training | Onaylı yol haritası | Stratejik öncelik olarak açıklandı. | Uygulama detayları ve ölçekleme davranışı. |
| Ön eğitim → Orta-aşama → Sonraki eğitim | Onaylı yönelim | Öz-eğitimin eğitim yaşam döngüsüne yayılması hedefi. | Veri setleri, doğrulayıcılar, aşama sınırları ve oranlar. |
| Öz değerlendirme ve düzeltme | Onaylı hedef | Öz arındırma, hata tespiti ve düzeltme içeriyor. | Güvenilirlik, bağımsız doğrulama ve durdurma ölçütleri. |
| Teknik özellikler | Açıklanmadı | Tam bir kamuya açık teknik spesifikasyon yok. | Parametreler, bağlam penceresi, modaliteler, fiyat, API ID. |
| Benchmark’lar | Açıklanmadı | Resmi GLM-6.0 sonuç seti yok. | Puanlar, metodoloji ve bağımsız olarak tekrarlanabilir sonuçlar. |
Full Self-Training nedir ve nasıl çalışır
Full Self-Training, modelin görevler veya ortamlar oluşturduğu, bunları denediği, ortaya çıkan trajektörileri değerlendirdiği, zayıf adımları düzelttiği ve kabul edilen deneyimi tekrar eğitime beslediği kapalı bir öğrenme döngüsüdür. Önemli değişim, tek seferlik sentetik veri hattından sürekli ve kontrollü bir sürece geçiştir.
- Generate: sorunları, araç ortamlarını ve aday çözüm yollarını oluştur.
- Act: görevleri tamamla; eylemleri, gözlemleri ve ara akıl yürütmeleri trajektöriler olarak kaydet.
- Evaluate and correct: sonuçları doğrulayıcılarla puanla, hataları tespit et, başarısız adımları revize et ve düşük güvenli örnekleri reddet.
- Train and stop: kabul edilen deneyimden öğren; bağımsız değerlendirmeler faydalı iyileşme gösterdiği sürece devam et.
Bu döngüyü ön eğitim, orta-aşama eğitim ve sonraki eğitim boyunca genişletmek, GLM-6.0’ın veri kalitesini, yetenek şekillendirmesini ve görev hizalamasını farklı aşamalarda geliştirmesine olanak tanır. Mimari yine de güvenilir değerlendiricilere bağlıdır: bağımsız kontroller olmadan öz-eğitim, modelin kendi kör noktalarını ödüllendirebilir.
Full Self-Training GLM 6.0’ı nasıl değiştirebilir?
Açıklanan tasarım, tek bir yeni Transformer bloğu olarak değil bir sistem mimarisi olarak anlaşılmalıdır. Amaç, döngüyü modelin etrafında kapatarak, modelin bir sonraki eğitim çevrimi için gereken kaynakların giderek daha fazlasını üretip doğrulamasını sağlamaktır.
GLM 6.0 eğitim verisini nasıl üretebilir?
İlk döngü veri öz-üretimidir. Yalnızca insan yazımı veya harici toplanan veri setlerine bağımlı olmak yerine, modeller öz-oyun, kural tabanlı kontroller, yürütme sonuçları, model hakemliği ve insan örnek kontrollerini kullanarak yeni örnekler üretebilir ve filtreleyebilir. Kabul edilen örnekler ardından ön eğitim, orta-aşama eğitim ve sonraki eğitime geri akar.
Önemli kısıt doğrulamadır: ucuz sentetik üretim, sistem doğru, çeşitli ve dejenerasyona uğramamış örnekleri ayırt edebildiğinde faydalıdır. Pratik bir döngü; model üretimi → görev yürütme → kural veya araç doğrulaması → filtreleme → yeniden eğitimdir.
GLM 6.0 eğitim ortamlarını nasıl kurabilir?
İkinci döngü ortamların öz-inşasıdır. Ajanlar gerçek dünya görevlerini toplayabilir veya dönüştürebilir, bu görevleri deneyebilir, doğrulayıcılar oluşturabilir ve görev eğitim materyali olmadan önce gerçekten çözülebilir olup olmadığını kontrol edebilir. Bu, özellikle kodlama ve ajan çalışmalarında önemlidir; çünkü terminal durumu, araç çıktısı, tarayıcı durumu, test sonuçları ve hata kurtarma, yalnızca metne dayalı yanıtlardan daha güçlü denetim sağlar.
Değerlendirme hedefi, cevabın ikna edici görünüp görünmediğinden, eylemin başarılı olup olmadığına, sonucun bağımsız olarak doğrulanabilirliğine ve ajanın başarısızlıktan sonra toparlanıp toparlanamadığına kayar.
GLM 6.0 eğitim altyapısını nasıl optimize edebilir?
Üçüncü döngü altyapı öz-optimizasyonudur. Pratikte bu, yapay zekâ destekli sistem mühendisliği olarak yorumlanmalıdır: güçlü bir kodlama modeli operatörler, çekirdekler, zamanlama, önbellekleme veya servis kodu üzerinde değişiklikler önerirken, otomatik benchmark’lar ve insan kontrollü doğrulama hangi değişikliklerin kabul edileceğini belirler.
Ortaya çıkan döngü: daha iyi model → daha iyi sistem önerileri → doğrulanmış verimlilik kazanımları → daha fazla eğitim deneyi → daha iyi model. İnsan incelemesi ve tekrarlanabilir benchmark’lar, opsiyonel değil kontrol noktaları olarak kalır.
Mevcut GLM 5.3 Flash temel seviyesi GLM 6.0 hakkında ne söylüyor?
GLM 6.0 için kamuya açık bir model kartı olmadığından, en savunulabilir karşılaştırma mevcut, ölçülmüş GLM yeteneklerini bir sonraki nesil yönelimden ayırır. Z.AI, GLM-5.3-Flash’ı 320B toplam, 18B aktif MoE model olarak ve 30T belirteçli multimodal derlem üzerinde eğitildiğini tanımlar. Bunlar GLM-5.3-Flash özellikleridir, GLM 6.0 özellikleri değil.
| Karşılaştırma boyutu | CometAPI’de GLM-5.3-Flash API | GLM 6.0 açıklanan yönelim |
|---|---|---|
| Yayın durumu | Mevcut | Geliştirme aşamasında; nihai ürün adı atıfta bulunulan dosyada bağımsız doğrulanmadı |
| Parametreler | 320B toplam / 18B aktif | Açıklanmadı |
| Çekirdek mimari | MoE; hibrit seyrek + doğrusal dikkat; mHC | Blok düzeyinde açıklanmadı |
| Eğitim verisi | 30T belirteçli multimodal derlem | Öz-üretilmiş verinin döngüsel olarak geri girmesi hedefleniyor |
| Multimodality | Doğal multimodal girdi | Birleştirilmiş multimodal modelleme bir araştırma yönü; yayımlanmış özellik değil |
| Eğitim aşamaları | Yayınlanmış aşamalı eğitim tarifi | Ön–orta–sonraki eğitim boyunca öz-eğitim |
| Eğitim ortamları | Araştırmacı tasarımlı ve benchmark’lı | Ajanlar ortamları kurmaya ve doğrulamaya yardımcı olur |
| Doğrulama | Mevcut değerlendirme ve eğitim hatları | Daha güçlü öz-yargı, yürütme geri bildirimi ve öz-doğrulama |
| Altyapı | Optimize edilmiş çıkarım yığını | Modeller altyapı optimizasyonuna yardımcı olur |
| API detayları | Yayınlanmış model ID ve canlı API | Açıklanmadı |
Z.AI’nin yayın metni, GLM-5.3-Flash için GLM-5.3 API’ye göre yaklaşık 3,0× daha düşük dikkat hesaplama maliyeti ve 4,4× daha küçük KV önbellek boyutu bildirir. Eşlik eden resmi grafik ise bir milyon belirteçlik karşılaştırma için dikkat hesaplamasını 3,40× ve katman başına KV önbelleğini 3,80× olarak etiketler. İki resmi varlık farklı rakamlar kullandığı için, tek bir ölçümde birleştirilmek yerine bağlamlarıyla birlikte raporlanmalıdır.
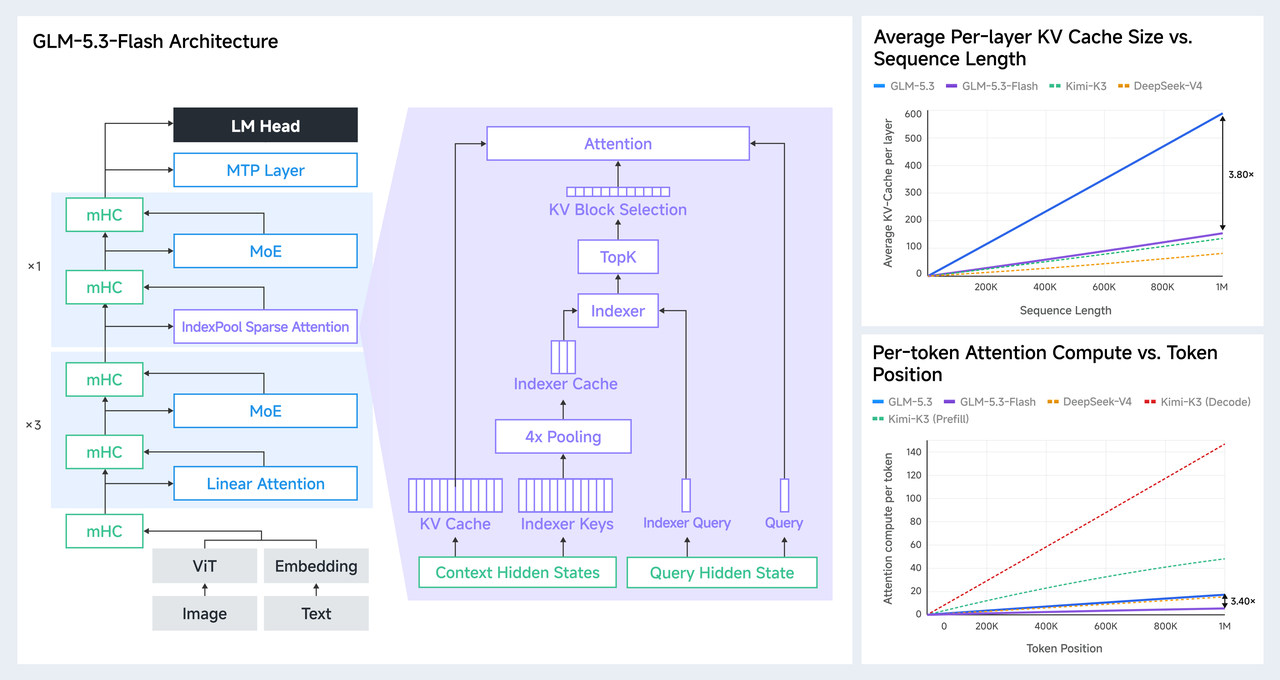
Z.AI tarafından yayımlanan resmi GLM-5.3-Flash mimarisi ve verimlilik karşılaştırması
Hangi Benchmark sonuçları GLM 6.0 temelini oluşturuyor?
Doğrulanmış bir GLM 6.0 benchmark tablosu kamuya açık değil. Mevcut GLM nesli, yalnızca bir temel seviyeyi temsil eder; çünkü aşağıdaki değerlendirmeler, açıklanan Full Self-Training yönelimiyle en ilgili olan planlama, kodlama, araç kullanımı, otomasyon ve uzun ufuklu yürütmeyi ölçer.
| Resmi Z.AI değerlendirmesi | GLM-5.3-Flash | GLM-5.2 | Raporlanan fark |
|---|---|---|---|
| Terminal Bench 2.1 | 84.3 | 81.0 | +3.3 |
| DeepSWE v1.1 | 63.4 | 46.2 | +17.2 |
| NL2Repo | 56.3 | 48.9 | +7.4 |
| Toolathlon Verified | 78.4 | 59.9 | +18.5 |
| AutomationBench v1.0.6 | 48.8 | 26.2 | +22.6 |
| Agents’ Last Exam | 26.3 | 20.4 | +5.9 |
| HLE with Tools | 55.3 | 54.7 | +0.6 |
| GDPval-AA v2 | 1773 Elo | 1504 Elo | +269 Elo |
Karşılaştırma, tek puanlı bir sıralama yerine çok boyutludur. GLM-5.3-Flash, AutomationBench (+22,6), Toolathlon Verified (+18,5) ve DeepSWE (+17,2) üzerinde en büyük raporlanan kazanımları gösterirken, HLE-with-Tools farkı yalnızca +0,6’dır. Bu desen, her tür araç destekli akıl yürütmeden ziyade yürütme ağırlıklı ajan görevlerinde daha güçlü kazançlara işaret eder. GLM 6.0 puanlarını öngörmez.
Bu benchmark’lar neden önemli
Benchmark’lar burada, ancak Full Self-Training’in iyileştirmeyi amaçladığı yetenekleri ortaya koyuyorsa anlamlıdır. Gömülü tablodaki altı kategori, doğru çıktı üretmekten gerçek ortamlarda sürdürülebilir davranışa kadar bir ilerleme oluşturur. Kodlama modelin karmaşık bir görevi yürütüp yürütemediğini; araç kullanımı ise bir eylemi geri bildirime dönüştürüp bir sonraki adımı seçip seçemediğini; otomasyon da bu döngüyü uzun bir iş akışında sürdürebilip sürdüremediğini test eder.
| Benchmark kategorisi | GLM-6.0 için neden önemli |
|---|---|
| Kodlama | Karmaşık görev yürütmeyi test eder |
| Araç kullanımı | Eylemden geri bildirime döngüyü test eder |
| Otomasyon | Uzun ufuklu iş akışı yürütmesini test eder |
| HLE | Karmaşık uzman düzeyi problem çözmeyi test eder |
| GDPval | Profesyonel iş çıktısının kalitesini test eder |
| Multimodal | Görsel geri bildirim kullanımını test eder |
HLE, çözülen problemlerin zorluk seviyesini yükseltir; GDPval, çıktının profesyonel işte yararlı olup olmadığını sorar; multimodal değerlendirme ise görsel gözlemlerin sonraki eylemleri yönlendirip yönlendiremeyeceğini test eder. Birlikte okunduğunda bu altı kategori, yalıtık yetkinlikten uçtan uca görev tamamlamaya kadar uzanır: bir plan üret, eyleme geç, geri bildirimi gözlemle, hataları düzelt ve hedefe ulaşana kadar devam et.
Bu nedenle, gelecekteki bir GLM-6.0 sonucu, daha yüksek bir toplam puan ürettiği için değil; bu boyutlar boyunca kazanımların, öz-üretilmiş eğitim deneyiminin güvenilir gerçek dünya yürütmesine aktarıldığını gösterdiği için anlamlı olacaktır. Full Self-Training’in nihai hedefi test puanlarını artırmak değil, modelin gerçek dünya görevlerini tamamlama yeteneğini geliştirmektir.
Full Self-Training GLM 6.0 için neden önemli olabilir?
Asıl vaat, GLM 6.0’ın basitçe “kendini eğitmesi” değil. Daha anlamlı değişim, geliştirme hattının daha büyük bir bölümünün makine tarafından üretilip makine tarafından doğrulanabilir hale gelmesidir. Bugün araştırmacılar hâlâ model etrafındaki işlerin çoğunu yapıyor: veri toplama, görev tasarlama, değerlendirici inşa etme, ortam oluşturma, hata teşhisi ve sistem yazılımını ayarlama. Full Self-Training, modelin o aşamaların daha fazlasına girmesini sağlar.
Yaklaşım işe yararsa, önemli ölçekleme değişkeni; kaç parametre eklenebileceğinden çok, birim hesaplama başına kaç faydalı ve doğrulanmış öğrenme döngüsünün yürütülebileceği olur. Bu, sınırsız otonom öz-değişim değil; özyinelemeli öz-iyileştirmenin pratik bir yorumudur.
Açıklanan strateji, doğrulayıcılar, tekrarlanabilir ortamlar, altyapı benchmark’ları ve insan kontrolleri olan mühendislik ürünü bir geri besleme sistemi olarak değerlendirilmelidir—sınırsız otonom öz-iyileştirme kanıtı olarak değil.
Full Self-Training ile neler ters gidebilir?
Bir öz-eğitim döngüsü, faydalı deneyimi çoğalttığı kadar hataları da çoğaltabilir. Dört arıza modu özel dikkat gerektirir:
- Hata büyütme: zayıf sentetik trajektöriler geleceğin eğitim verisi haline gelebilir; ikna edici ama yanlış kalıpların pekişmesine izin verir.
- Ödül ve değerlendirici manipülasyonu: aynı sistem hem işi üretip hem yargılarsa, gerçek görev başarısı yerine doğrulayıcıdaki boşlukları optimize edebilir.
- Dağılım daralması: model-üretimli veriden tekrar tekrar öğrenmek çeşitliliği azaltabilir ve nadir gerçek dünya vakalarını zorlaştırabilir.
- Maliyet, güvenlik ve yönetişim baskısı: ortam inşası, araç erişimi ve kalıcı yineleme hesaplama talebini artırır ve saldırı yüzeyini genişletir.
Güvenilir bir GLM-6.0 uygulaması bu nedenle bağımsız doğrulayıcılar, veri kökeni, kabul eşikleri, red team testleri, insan denetimleri ve açık durdurma kurallarına ihtiyaç duyar. Öz-düzeltme, yalnızca düzeltme sinyali, düzeltmeye çalışılan davranıştan daha güvenilir olduğunda faydalıdır.
GLM 6.0 API ne zaman kullanılabilir olur?
Z.AI, GLM 6.0 için API yayın tarihi, model kimliği, bağlam penceresi, maksimum çıktı, belirteç fiyatı, açık ağırlık taahhüdü veya dağıtım gereksinimlerini yayımlamadı. Şu anda herhangi bir somut değer spekülasyondur.
Geliştiriciler, yerel multimodal ve verimlilik odaklı iş yükleri için CometAPI’de GLM-5.3-Flash API, mevcut amiral dalı için CometAPI’de GLM-5.3 API veya önceki nesil karşılaştırma temeli olarak CometAPI’de GLM-5.2 API üzerinden mevcut yönelimi değerlendirebilir.
Sonuç
GLM-6.0, vaat edilen bir ürün olmaktan çok, Z.AI’nin Full Self-Training’i tekrarlanabilir bir mühendislik sistemine dönüştürüp dönüştüremeyeceğinin bir testidir. Yol haritası, öz-üretilmiş deneyimi, aşamalı eğitimi, öz değerlendirmeyi, düzeltmeyi ve kontrollü yinelemeyi birbirine bağlar; belirleyici kanıt, bu mekanizmaların araç kullanan, uzun, gerçek dünya iş akışlarında güvenilirliği artırıp artırmadığı olacaktır.
Bu kanıt hâlâ eksik. Z.AI, GLM-6.0 model kartı, yayın tarihi, API kimliği, fiyatlandırma veya benchmark paketini yayımlamadı. Bu eserler mevcut olana kadar savunulabilir sonuç sınırlıdır: şirket bir eğitim yönelimi açıkladı; bitmiş bir yetenek profili değil.
Full Self-Training’in nihai hedefi test puanlarını artırmak değil, modelin gerçek dünya görevlerini tamamlama yeteneğini geliştirmektir.