CometAPI ile geliştirinBirden çok model için tek bir API mi gerekiyor?İş akışını Playground'da test edin, ardından model ve maliyet kullanım senaryonuza uyduğunda bir API anahtarı oluşturun.
GPT-6.1 Terra ile GPT-6.1 Sol: Kıyaslamalar, fiyatlandırma ve hangisini seçmeli
Resmi kıyaslamalar, akıl yürütme, API fiyatlandırması ve pratik iş yükleri açısından GPT-6.1 Terra ile GPT-6.1 Sol’u karşılaştırın; ayrıca bir CometAPI Python örneği ekleyin.
Yüksek hacimli, doğrulanabilir ve maliyete duyarlı görevler için GPT-6.1 Terra ile başlayın. Karmaşık kodlama, çok adımlı araç kullanımı ve hataların pahalıya mal olduğu iş akışlarında GPT-6.1 Sol’u değerlendirin. Pratik bir varsayılan yaklaşım, önce Terra’yı kullanmak ve önceden tanımlı testler veya doğrulama kontrolleri başarısız olduğunda Sol’a yükseltmektir.
Öne Çıkanlar
Standart token fiyatlandırması: OpenAI Standard’da Terra, milyon başına giriş token’ı için $1 ve çıkış token’ı için $5; Sol ise sırasıyla $2 ve $10’dur.
Göreve özel performans: Maksimum akıl yürütme çabasında Terra, Agents’ Last Exam v1 ve Terminal-Bench-Science 0.1’de kıl payı önde; Sol ise Terminal-Bench 4.0 ve OSWorld 2.1’de önde.
Her iki model de 1,05 milyon token’lık bağlam penceresi sunar ve metin ile görsel girdileri kabul eder.
Netlik, kaynak ataması ve güncel API terminolojisi açısından gözden geçirildi.
Paylaşılan bağlam kapasitesi:
Farklı akıl yürütme kontrolleri: Terra, akıl yürütmenin none ile kapatılmasını destekler; Sol en az low akıl yürütme çabasını gerektirir.
Operasyonel maliyet önemli: Tekrarlamalar ve araç çağrıları dahil olmak üzere başarılı tamamlanan görev başına harcamayı karşılaştırın ve insan inceleme maliyetlerini ayrı izleyin.
GPT-6.1 Terra ve GPT-6.1 Sol: Genel Bakış ve Teknik Özellikler
Aşağıdaki genel bakış, ödünleşimleri özetler. Ayrıntılı bölümler, her seçimin arkasındaki kanıtları, faturalandırma varsayımlarını ve sınırlamaları açıklar.
Karar faktörü
GPT-6.1 Terra
GPT-6.1 Sol
Başlangıç iş yükü
Rutin görsel işler ve tekrarlanabilir ajanlar
Karmaşık kodlama ve sürekli profesyonel akıl yürütme
Bağlam ve modaliteler
Aynı toplam bağlam kapasitesi; metin ve görsel
Aynı toplam bağlam kapasitesi; metin ve görsel
Akıl yürütme kontrolü
Akıl yürütmeyi kapatma seçeneği içerir
En az düşük akıl yürütme çabası gerektirir
Yayınlanmış performans
Tekrarlanabilir ajan görevlerinde düşük maliyet
Zorlayıcı kodlama ve masaüstü testlerinde daha güçlü
API erişimi
OpenAI ve CometAPI
OpenAI ve CometAPI
GPT-6.1 Terra: Verimli Görsel ve Ajan İş Akışları
OpenAI, GPT-6.1 Terra'yı 26 Ekim 2026’da tanıttı. Rutin profesyonel iş akışları için görsel akıl yürütme, bilgisayar kullanımı ve genel amaçlı metin üretimini birleştirir. Daha düşük token oranları, işleri sık olan ve sonuçları doğrulanabilen görevlerde onu kullanışlı bir başlangıç noktası yapar.
GPT-6.1 Sol: Karmaşık Kodlama ve Profesyonel Akıl Yürütme
GPT-6.1 Sol 29 Eylül 2026’da kullanıma sunuldu. Zorlu kodlama ve profesyonel çalışmaları hedefler. Bilinmeyen bir depo, birbirine bağlı uzun eylem zincirleri veya pahalı düzeltmeler, ilave akıl yürütme kabiliyetini değerli kıldığında değerlendirin.
Bağlam, Akıl Yürütme ve API Özellikleri
Özellik
GPT-6.1 Terra
GPT-6.1 Sol
Resmi çıkış tarihi
26 Ekim 2026
29 Eylül 2026
API model ID
gpt-6.1-terra
gpt-6.1-sol
Bağlam penceresi
1,050,000 tokens
1,050,000 tokens
Bilgi kesimi
1 Haziran 2026
30 Nisan 2026
Girdi / çıktı
Metin ve görseller / metin
Metin ve görseller / metin
Akıl yürütme çabası
none, low, medium, high, xhigh, max
low, medium, high, xhigh, max
Varsayılan çaba
medium
medium
API özellikleri: Her iki model de Structured Outputs, akış (streaming) ve Batch API’yi destekler. Araç çağırma, Responses API üzerinden yapılır ve ince ayar (fine-tuning) desteklenmez. Seçtiğiniz sağlayıcı ve uç noktanın uygulamanızın ihtiyaç duyduğu özellikleri sunduğunu doğrulayın.
Her iki model de 1,050,000 token’lık bağlam penceresi içinde 128,000’e kadar çıktı token’ına izin verir. Çıkış için tam ayrımı ayırmak, girişiniz, sistem talimatları ve araç geçmişi dahil olmak üzere geri kalan alışveriş için 922,000 token bırakır. Bu bir planlama hesabıdır, ayrı bir sabit giriş sınırı değildir.
Mimari açıklaması: Bağlantılı genel model özellikleri, güvenilir bir karşılaştırma için yeterli dahili mimari ayrıntısı sağlamaz. Bağlam kapasitesi ve akıl yürütme ayarları, parametre sayısı veya mimari için kanıt olarak görülmemelidir.
Akıl yürütme kontrolleri: Terra’nın none ayarı, düz dönüşümler ve çıkarımlar için kullanışlıdır. İlk karşılaştırma için her iki modelde de aynı desteklenen akıl yürütme ayarını kullanın, ardından her modeli iş yükünüzün gerektirdiği kalite ve gecikmeye göre ayarlayın.
Her iki modelin yayınlanan bağlam kapasitesi aynı olsa da bu, aynı geri getirme doğruluğu veya uzun-bağlam akıl yürütme kalitesi anlamına gelmez. Bu nedenle model seçimi, akıl yürütme kalitesi, iş akışı verimliliği, maliyet ve göreve özel geri getirme performansını dikkate almalıdır.
GPT-6.1 Terra ve GPT-6.1 Sol: Performans
Raporlanan sonuçlar karışık bir tablo sunar: Terra bazı ajan ve bilimsel kodlama değerlendirmelerinde kıl payı öndeyken, Sol genel terminal kodlama, masaüstü otomasyon ve görsel alanlarında daha yüksek puan alır. Aşağıdaki karşılaştırmalar, OpenAI’nin lansman sonuçlarını bağımsız değerlendirmelerden ayırır ve bunların üretim performansı hakkında neleri kanıtlayıp kanıtlamadığını açıklar.
Resmi Kıyaslama Sonuçları ve Test Koşulları
Aşağıdaki sonuçlar OpenAI’nin Terra lansman değerlendirmelerinden alınmıştır. Terra medium ve maksimum akıl yürütme çabasında; Sol maksimum çabada gösterilmiştir. Son sütun yalnızca maksimum çaba yapılandırmalarını karşılaştırır.
OSWorld, çevrimdışı 2.1 değerlendirmesini kullanır. Olgusallık testi, OpenAI’nin kasıtlı olarak hatalara yol açmak için tasarladığı dahili istemleri kullanır. Bunlar, belirli değerlendirme kurulumlarından gelen, üretim iş yükünüzün ölçümü olmayan, satıcı tarafından bildirilen sonuçlardır.
Kıyas
GPT-6.1 Terra (medium)
GPT-6.1 Terra (max)
GPT-6.1 Sol (max)
Maks. çabada karşılaştırma
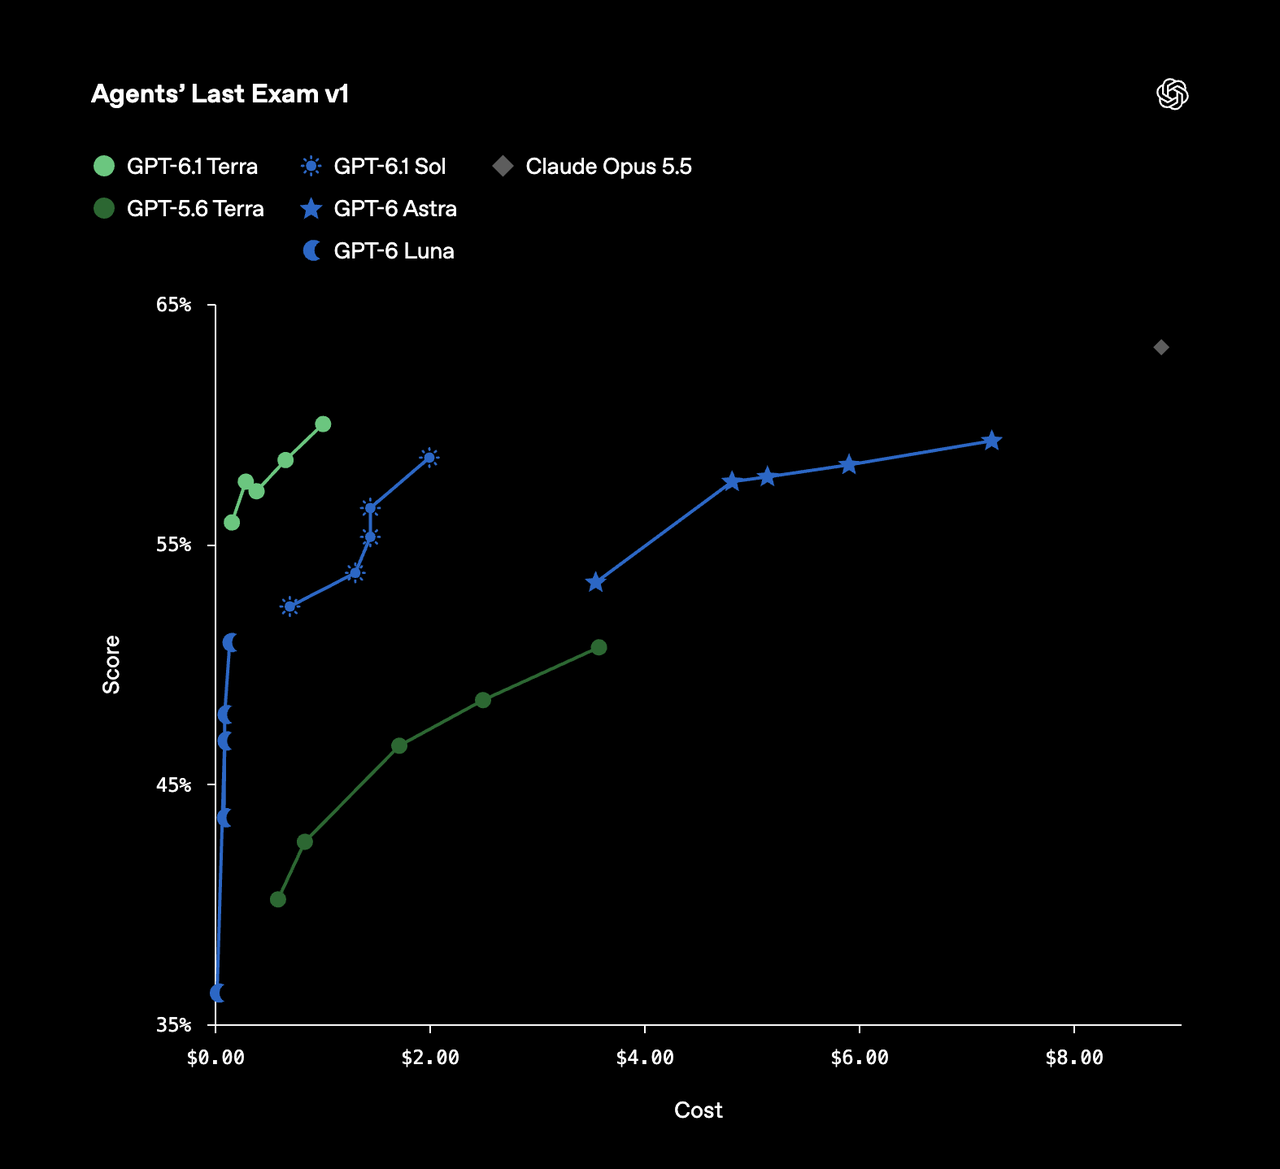
Agents’ Last Exam v1
57.60%
60.00%
58.60%
Terra +1.4 pp
MMMU-Pro (Vision)
84.60%
85.50%
86.30%
Sol +0.8 pp
OSWorld 2.1, offline
66.70%
74.20%
78.00%
Sol +3.8 pp
Terminal-Bench 4.0
35.80%
50.30%
55.90%
Sol +5.6 pp
Terminal-Bench-Science 0.1
34.30%
58.30%
57.00%
Terra +1.3 pp
Zor istemlerde olgusal hata oranı
10.10%
4.30%
4.40%
Terra 0.1 pp daha düşük
Tüm puanlar yüzdeliktir; farklar yüzde puan (pp) cinsinden ifade edilir. Sadece olgusal hata oranında düşük değer daha iyidir. 0.1 puanlık hata oranı farkı tek başına anlamlı bir güvenilirlik üstünlüğü ortaya koymaz.
Yazılım mühendisliği için Sol’un Terminal-Bench’teki üstünlüğü ve Terra’nın Terminal-Bench-Science’ta kıl payı üstünlüğü, sonuçların kodlama görevine bağlı olabileceğini düşündürür. Uygulama iş akışlarında, Sol’un daha yüksek OSWorld puanı masaüstü otomasyonu için değerlendirilmesini desteklerken, Terra’nın Agents’ Last Exam sonucu onu profesyonel ajan görevleri için bir aday yapar. Hiçbiri evrensel bir kazananı ortaya koymaz.
Ajan iskeleti, araç erişimi ve ortam yapılandırması bu sonuçları etkileyebilir. Rakamları test için adayları belirlemek amacıyla kullanın ve ardından depodaki değişiklikler ve gerçekten tamamlamanız gereken uygulama iş akışlarına karşı doğrulayın.
OpenAI’nin Agents’ Last Exam v1 grafiği, skorları model yapılandırmaları arasındaki tahmini görev maliyetlerine karşı çizer. Bu, yukarıdaki skor tablosuna bir maliyet-etkinlik perspektifi ekler; çizilen maliyetler değerlendirme kurulumuna özeldir.
Bağımsız Zekâ ve Kodlama Değerlendirmeleri
Artificial Analysis’in 26 Ekim tarihli değerlendirmesi, maksimum akıl yürütme çabasında Terra’yı Zekâ Endeksi’nde Sol’un dört puan altında konumlandırır. Coding Agent Index v2.0, Terra’ya 48 ve Sol’a 54 verir. Bunlar, kendi yöntem ve puan ölçeklerine sahip ayrı değerlendirmelerdir; OpenAI’nin kıyas sonuçlarıyla sayısal olarak birleştirilmemelidir.
Aynı analiz, zekâ değerlendirmesinde Terra’nın düşük ve medium akıl yürütme ayarlarını özellikle maliyet-etkin olarak tanımlar. Bu, maksimum çaba ayarlarının yanında pratik yapılandırmaların da test edilmesini destekler. Değerlendirme maliyetleri, kurulumuna özgüdür ve uygulamanızın harcamalarının tahmini olarak kabul edilmemelidir.
Hız ve Gecikme: Görev Tamamlama vs. Token Üretimi
OpenAI, Terra’nın değerlendirilen Agents’ Last Exam görevlerini Sol’dan üç kattan fazla hızlı tamamladığını bildiriyor. Bu, akıl yürütme ve yazılım etkileşimlerini içeren uçtan uca bir görev ölçümüdür. Her API isteği için üç kat daha yüksek çıktı-token aktarım hızı anlamına gelmez.
Etkileşimli uygulamalar için, çıktının başlamasına kadar olan beklemeyi ölçen ilk token süresini, yanıtın ne kadar hızlı sürdüğünü ölçen saniye başına çıktı token sayısından ayırın. Ajanlar için, araç çağrıları, yeniden denemeler ve kurtarma dahil uçtan uca tamamlama süresini önceliklendirin.
Her iki modeli de aynı istemler, araçlar, desteklenen akıl yürütme ayarı ve kabul kriterleriyle karşılaştırın. Gecikmeyi görev başarısıyla birlikte kaydedin: düzeltme gerektiren veya iş akışını tamamlamayan daha hızlı bir yanıtın değeri sınırlıdır.
Görüş ve Uzun Bağlam Performansı: Sonuçların Gösterdiği
Sol’un maksimum çabada MMMU-Pro’da 0.8 yüzde puanlık üstünlüğü, her görsel iş akışında daha iyi performans garantisi değil, raporlanan tek bir görsel sonuçtur. Küçük etiketler, kötü taramalar, yoğun diyagramlar ve alışılmadık yerleşimler için temsilî girdilerle test edin.
Yukarıdaki değerlendirmeler, hangi modelin uzun-bağlam geri getirme veya akıl yürütmede daha iyi olduğunu ortaya koymaz. Her ikisinin de yayınlanan bağlam kapasitesi aynı olsa da kapasite tek başına geri getirme doğruluğu veya oturumlar arası bellek göstermez. Her modelin belgelerinizde ilgili kanıtı bulup kullanabildiğini test edin ve uygulama durumunu istekler arasında açıkça sürdürün.
GPT-6.1 Terra ve GPT-6.1 Sol: Maliyet
Token fiyatları maliyet karşılaştırmasının başlangıç noktasıdır. Yeniden denemeler, akıl yürütme token’ları, araç çağrıları ve insan incelemesi de bir görevi başarıyla tamamlamak için harcadığınız tutarı etkiler.
Aşağıdaki oranlar, milyon token başına USD cinsindendir ve fiyatlandırmadır.
Sağlayıcı ve token kategorisi
GPT-6.1 Terra
GPT-6.1 Sol
OpenAI Standard — giriş
$1.00
$2.00
OpenAI Standard — önbellekli giriş
$0.05
$0.10
OpenAI Standard — çıkış
$5.00
$10.00
OpenAI Standard — 30 dak. önbelleğe yazma
$1.25
$2.50
OpenAI Standard — 12 saat önbelleğe yazma
$2.50
$5.00
CometAPI — normal giriş
$0.80
$1.60
CometAPI — normal çıkış
$4.00
$8.00
OpenAI API Fiyatlandırması
Bu kategorilerde Terra’nın listelenen Standard oranları, Sol’un oranlarının yarısıdır. Gerçek ücretler istek yapılandırmasına bağlıdır: uzun-bağlam istekleri, işleme katmanları, bölgesel işleme ve araç kullanımı farklı koşullara sahip olabilir. Üretim maliyetlerini tahmin etmeden önce geçerli OpenAI fiyatlandırma belgelerini kontrol edin.
CometAPI Fiyatlandırması
CometAPI, kendi fiyatlandırması ve özellik kullanılabilirliği olan üçüncü taraf bir erişim yoludur. Listelenen normal giriş ve çıkış oranları ayrıca aşağıda gösterilmiştir.
Bu oranlarda CometAPI’nin normal giriş ve çıkış fiyatları, yukarıdaki OpenAI Standard oranlarının %20 altında kalır. Dağıtımdan önce hesabınız için güncel fiyatları, uzun-bağlam ücretlerini, önbellekleme desteğini ve araç kullanılabilirliğini doğrulayın.
1.000 İstek İçin Örnek Maliyet
Diyelim ki bir uygulama, her biri 2.000 önbelleksiz giriş token’ı ve 500 faturalandırılabilir çıkış token’ı kullanan 1.000 istek yapıyor. Bu, toplamda 2 milyon giriş token’ı ve 500.000 çıkış token’ı üretir.
1.000 istek için, her biri 2.000 önbelleksiz giriş token’ı ve 500 faturalandırılabilir çıkış token’ı kullanıldığında tahmini maliyetler:
OpenAI ile Terra: Giriş için $2.00 ve çıkış için $2.50; toplam $4.50.
OpenAI ile Sol: Giriş için $4.00 ve çıkış için $5.00; toplam $9.00.
CometAPI ile Terra: Giriş için $1.60 ve çıkış için $2.00; toplam $3.60.
CometAPI ile Sol: Giriş için $3.20 ve çıkış için $4.00; toplam $7.20.
Bu hesaplamalar, Batch API indirimi olmadan listelenen normal oranları kullanır. Önbelleğe yazmaları, ayrı araç ücretlerini ve yeniden denemeleri içermez. Çıkış olarak faturalandırılan herhangi bir akıl yürütme token’ı, çıkış toplamına dahil edilmelidir.
Başarılı Görev Başına Etkin Maliyet
Bu yazıda başarılı görev, önceden tanımlı kalite, varsa şema ve tamamlama kontrollerini ek insan düzeltmesi olmadan geçen görevdir.
Daha düşük token fiyatları her zaman daha düşük operasyonel maliyet üretmez. Terra’nın tasarrufu, daha fazla deneme, akıl yürütme token’ı veya insan müdahalesi gerektirirse azalabilir. Sol’un daha yüksek oranları, ilk denemede daha fazla görevi başarıyla tamamlıyorsa değerini bulur.
Etkili model-ve-araç başına başarılı görev maliyeti = tüm denemelerdeki toplam model ve araç harcaması ÷ başarılı görev sayısı.
İnsan inceleme ve düzeltme maliyetlerini ayrı takip edin. Sadece token fiyatlarını karşılaştırmak yerine, hedef kalitenize en düşük birleşik maliyetle ulaşan modeli seçin.
Hangi Modeli Seçmelisiniz: GPT-6.1 Terra mı GPT-6.1 Sol mu?
Görev karmaşıklığı, doğrulanabilir çıktı kalitesi ve toplam tamamlama maliyetine göre seçin. Terra, rutin iş akışları için kullanışlı bir başlangıç noktasıdır; Sol, zorlayıcı akıl yürütme veya pahalı hataların daha yüksek akıl yürütme kabiliyetini haklı çıkardığı durumlarda değerlendirmeye değerdir.
Ne Zaman GPT-6.1 Terra’yı Seçmeli?
Sık yapılan çıkarım, belge taslağı, katalog eşleştirme ve öngörülebilir uygulama iş akışları için Terra ile başlayın. Sonuçların kaynak belgelere, gerekli alanlara veya otomatik doğrulama kurallarına göre kontrol edilebildiği görevler iyi adaylardır.
Terra, izin verilen yeniden deneme ve insan inceleme bütçesi içinde doğruluk ve tamamlama hedeflerinizi karşıladığında onu seçin. Tekrar eden başarısızlıkların tasarrufları silmesi halinde daha düşük token oranlarının faydası azalır.
Ne Zaman GPT-6.1 Sol’u Seçmeli?
Zor hata ayıklama, çok sayıda bağımlılığı içeren depo değişiklikleri ve birbirine bağlı uzun eylem zincirlerine sahip masaüstü iş akışları için Sol’u değerlendirin.
Testler, daha fazla kabul edilen yama ürettiğini, daha fazla testi geçtiğini veya daha az manuel düzeltme gerektirdiğini gösterdiğinde Sol’u seçin. Bu iyileştirmeler işi tamamlama toplam maliyetini düşürdüğünde, daha yüksek token maliyeti haklıdır.
Ne Zaman Önce Terra’yı Kullanıp Sonra Sol’a Yükseltmeli?
Hibrit bir iş akışı, ilk deneme için Terra’yı kullanabilir ve önceden tanımlı kontroller başarısız olduğunda Sol’a yükseltebilir. Yükseltmeyi yalnızca modelin güvenine değil, gözlemlenebilir sonuçlara dayandırın.
Örneğin bir kod üretim iş akışı şu şekilde olabilir:
Terra’dan istenen değişikliği üretmesini isteyin.
İlgili testleri ve doğrulama kontrollerini çalıştırın.
Değişiklik bu kontrolleri geçemezse veya Terra’nın doğrulanmış yeteneğinin dışında kalırsa Sol’a yükseltin.
Yeniden deneme bütçesi tükendiğinde çözümsüz kalan durumları insan incelemesine gönderin.
Yükseltirken, özgün isteği, ilgili bağlamı, başarısız çıktıyı ve doğrulama sonuçlarını koruyun. Maliyet karşılaştırmasına tüm iş akışını dahil etmek için her iki modelin kullanımını da kaydedin.
Üretim Değerlendirme Kontrol Listesi
Varsayılan bir model seçmeden veya bir yükseltme iş akışı dağıtmadan önce:
Temsilî görevler kullanın: Rutin istekleri ve hatanın pahalıya mal olduğu durumları dahil edin.
Karşılaştırmaları kontrollü tutun: Karşılaştırılabilir talimatlar, kanıtlar, araçlar ve kabul kriterleri kullanın. Model ID’lerini, uç noktaları, akıl yürütme ayarlarını ve test tarihlerini kaydedin.
Kabul edilen sonuçları ölçün: Doğruluk, varsa şema geçerliliği, test sonuçları ve manuel düzeltme olmadan tamamlama.
Zaman ve harcamayı ölçün: Medyan ve kuyruk gecikmesini, faturalandırılan token’ları, araç çağrılarını, yeniden denemeleri ve insan inceleme çabasını izleyin.
Karşılaştırmayı tekrarlayın: Görevleri birden çok kez çalıştırın ve tek seferlik sonuçların etkisini azaltmak için model sırasını değiştirin.
İşletim sınırlarını tanımlayın: Yeniden deneme bütçeleri, yükseltme tetikleyicileri ve insan onayı gereksinimlerini dağıtımdan önce belirleyin.
Tüm iş akışını karşılaştırın: Başarısız girişimler ve yükseltme maliyetlerini de dahil ederek başarılı görev başına harcamayı hesaplayın.
GPT-6.1 Terra ve GPT-6.1 Sol’a Nereden Erişebilirsiniz?
Resmi Sağlayıcı Erişimi
Her iki model de OpenAI API aracılığıyla kullanılabilir. Metin istekleri için Chat Completions desteklenir; araç çağırma için Responses API gereklidir. Seçtiğiniz yolun desteklediği parametreleri, hesap limitlerinizi ve mevcut araçları doğrulayın.
CometAPI Erişimi
Her iki modeli CometAPI üzerinden kullanmak için, OpenAI uyumlu SDK’yı kurmak amacıyla quickstart guide'ını izleyin. CometAPI anahtarınızı COMETAPI_KEY ortam değişkeni üzerinden güvenli şekilde sağlayın ve temel URL’yi https://api.cometapi.com/v1 olarak ayarlayın. Model tanımlayıcısı olarak gpt-6.1-terra veya gpt-6.1-sol seçin ve bu yolun hesabınız için etkin olduğunu doğrulayın.
İlk karşılaştırma için, her iki modele de aynı temsilî görevleri verin ve medium akıl yürütme çabasını kullanın. Talimatları ve kabul kriterlerini tutarlı tutun, her görevi tekrarlayın ve model sırasını değiştirin. Tek bir yanıta dayanarak yargılamak yerine, başarılı sonuçları, geçen süreyi, faturalandırılan token’ları ve yeniden denemeleri karşılaştırın.
Sonuç
Sık, doğrulanabilir iş akışları için, daha düşük token fiyatlandırması ve daha hızlı görev tamamlama önemli olduğunda GPT-6.1 Terra ile başlayın. Zorlayıcı kodlama, çok adımlı araç kullanımı veya pahalı hatalar daha yüksek akıl yürütme kabiliyetini değerli kıldığında GPT-6.1 Sol’u değerlendirin. Nihai seçim, fiyat veya tek bir kıyas yerine, temsilî bir değerlendirme setinde kabul edilen görev başına maliyete dayanmalıdır.
Birçok uygulama için faydalı bir sonraki adım, net geçiş koşullarına ve sınırlı bir yükseltme yoluna sahip küçük, temsilî bir denemedir. Kararı fiyata veya tek bir kıyasa güvenmek yerine ölçülen sonuç versin.
GPT-6.1 Terra ile GPT-6.1 Sol: Kıyaslamalar, fiyatlandırma ve hangisini seçmeli - CometAPI