
Özet
GPT-6 Astra manşet puanlarında olağanüstü sonuçlar sergiliyor. En büyük kazanımlar, akıl yürütmenin eyleme dönüştürülmesi gerektiğinde ortaya çıkıyor: terminal işlemleri, yazılım kullanımı, otomasyon, uzun bağlamlı geri getirme, bilimsel iş akışları ve siber güvenlik. Zaten doygun akademik testlerde, önceki OpenAI nesline göre iyileşme çoğu zaman çok daha küçük.
Model, 1.050.000 token’lık bağlam penceresini kapsamlı araç desteğiyle birleştiriyor. OpenAI’nin yayımladığı yürütme benchmark’ları, pratik yükseltmenin uzun ufuklu işlerde en güçlü olduğunu, ancak harness tasarımı, akıl yürütme çabası, gecikme ve araç erişiminin sonucu maddi olarak etkilediğini öne sürüyor.
Temel Çıkarımlar
- Astra’nın en net kazanımları ajan temelli yürütmede; her tür soru cevaplamada değil.
- Terminal-Bench, AutomationBench, bilgisayar kullanımı ve veritabanı geçiş sonuçları, GPQA veya DeepSWE’ye kıyasla çok daha büyük hareket gösteriyor.
- ARC-AGI-3 sonucu, model durumu, bağlam yönetimi ve değerlendirme harness’ının nihai puanı domine edebileceğini gösteriyor.
- Büyük bir bağlam penceresi yalnızca bilgiyi limitin yakınında geri getirilebilir tuttuğunda önemlidir; MRCR, yalnızca ilan edilen kapasiteden daha bilgilendiricidir.
- Daha yüksek token fiyatları, model daha az token, tur, yeniden deneme veya insan düzeltmesi gerektiriyorsa otomatik olarak daha yüksek görev maliyeti anlamına gelmez.
- Üretim kararları, başarı oranını, geçen zamanı, toplam maliyeti, araç güvenilirliğini ve düzeltme yükünü birlikte karşılaştırmalıdır.
GPT-6 Astra’ya Kısa Bakış
OpenAI, 128.000 çıktı token’ına kadar, metin ve görsel girdi, metin çıktı ve düşükten maksimuma kadar akıl yürütme çabası belirtiyor. Bu özellikler büyük, çok adımlı iş akışlarını mümkün kılar, ancak bir modelin doğru kanıtı geri getireceğini veya bir görevi güvenilir şekilde tamamlayacağını kanıtlamaz.
| Resmi özellik | CometAPI'de GPT-6 Astra | Pratik Önemi |
|---|---|---|
| Model ID | gpt-6-astra | API yönlendirme için sabit tanımlayıcı |
| Bağlam penceresi | 1.050.000 token | Büyük depoları, arşivleri ve ajan geçmişlerini destekler |
| Azami çıktı | 128.000 token | Büyük raporlar, yamalar ve yapılandırılmış çıktıları sağlar |
| Bilgi kesimi | 30 Nisan 2026 | Daha yeni olgular için araçlar veya sağlanan kaynaklar gerekir |
| Girdi | Metin ve görseller | Belgeler, ekran görüntüleri, diyagramlar ve karışık kanıtları destekler |
| Çıktı | Metin | Düz yazı, kod ve yapılandırılmış metin üretir |
| Akıl yürütme çabası | low, medium, high, xhigh, max | Daha derin arama için gecikme ve maliyeti değiş tokuş eder |
| Ajan yetenekleri | Function calling, structured outputs, computer use, web/file search, hosted shell, Apply Patch, MCP | İzole yanıtlardan ziyade uçtan uca iş akışlarını etkinleştirir |
| OpenAI Standart girdi | milyon token başına $10 | Girdi boyutu ve önbellek yeniden kullanımı toplam maliyeti etkiler |
| OpenAI önbellekli girdi | milyon token başına $1 | Önbellekten yeniden kullanılan istem öneki için uygulanır |
| OpenAI önbellek yazıları | milyon token başına $12.50 | Önbelleksiz girdi oranının 1,25×’i üzerinden faturalandırılır |
| OpenAI Standart çıktı | milyon token başına $50 | Uzun çıktılar görev maliyetine hakim olabilir |
| 272K girdi token’ını aşan istekler | Girdi ve önbellek oranları ×2; çıktı oranı ×1.5 | Daha yüksek oranlar tüm isteğe uygulanır |
Bir bağlam limiti kapasiteyi ölçer, kullanılabilir hatırlamayı değil. Bir araç listesi kullanılabilirliği ölçer, başarılı yürütmeyi değil. Bu özelliklerin tamamlanan işe dönüşüp dönüşmediğini test etmek için benchmark’lar gerekir.
GPT-6 Astra’nın Benchmark Sonuçları Ne Gösteriyor?
Portföy düzensiz bir desen sergiliyor. Astra, bazı akademik ve yazılım akıl yürütme testlerinde Sol’un çok az ötesine geçerken, terminal çalışmaları, otomasyon, veritabanı geçişi, görsel etkileşim, uzun bağlamlı geri getirme ve ileri matematikte çift haneli kazanımlar üretiyor.
| Yayımlanan benchmark | GPT-6 Astra | GPT-5.6 Sol | Claude Fable 5.1 | Astra vs. Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 57.9% | 37.3% | 55.8% | +20.6 pp |
| DeepSWE v1.1 | 74.1% | 72.7% | 67.4% | +1.4 pp |
| Database Migration Tasks | 63.9% | 42.7% | 57.8% | +21.2 pp |
| OSWorld 2.0 | 72.6% | 65.7% | — | +6.9 pp |
| ScreenSpot-Pro | 92.7% | 76.9% | — | +15.8 pp |
| AutomationBench | 41.4% | 18.1% | 31.4% | +23.3 pp |
| BenchCAD | 95.9% | 83.3% | 84.3% | +12.6 pp |
| FrontierMath Tier 4 v2 | 97.6% | 83.0% | 87.8% | +14.6 pp |
| GPQA Diamond | 96.0% | 94.6% | 93.7% | +1.4 pp |
| MRCR v2, 512K–1M | 96.3% | 73.8% | — | +22.5 pp |
| AA Intelligence Index v4.1.1 | 61.2 | 60.9 | 65.7 | +0.3 |
| ARC-AGI-3, Provider Adapter | 99.9% | 7.8% | — | +92.1 pp |
Üç küme ortaya çıkıyor. Birincisi, DeepSWE ve GPQA’daki 1,4 puanlık boşluklar, güçlü modellerin zaten iyi performans gösterdiği görevlerde sınırlı artışı gösteriyor. İkincisi, Terminal-Bench, AutomationBench, veritabanı geçişi ve milyon token’lık geri getirmede 20 puanın üzerindeki kazanımlar, yürütmede çok daha büyük bir değişimi gösteriyor. Üçüncüsü, ARC-AGI-3, yorumu harness’a bağlı olan bir aykırı değer.
Bağımsız test sonucu
Artificial Analysis, Astra ve Sol’u Intelligence Index’te yaklaşık 61 olarak rapor ederken, Coding Agent Index’te çok daha net bir artış gösteriyor. Bu, OpenAI verilerindeki deseni bağımsız olarak güçlendiriyor: en büyük iyileşme ajan temelli yürütmede yoğunlaşıyor.
Codex harness’ında maksimum çabada, Astra’nın Coding Agent Index’te Sol’un yaklaşık üçte biri kadar token kullandığı bildiriliyor. Intelligence Index token kullanımı yalnızca yaklaşık %10 düşüyor. Astra’nın token başına oranı daha yüksek olduğundan, bu iki verimlilik profili farklı ekonomik sonuçlar doğuruyor.
| Bağımsız değerlendirme | Gözlenen Sonuç | Üretim Yorumlaması |
|---|---|---|
| Intelligence Index | Sol’dan çok az ayrışma | Geniş kapsamlı akıl yürütme büyük bir fiyat primini haklı kılmayabilir |
| Coding Agent Index | Net ajan temelli iyileşme | Daha az token, daha yüksek token oranını telafi edebilir |
| AA-Omniscience | Halüsinasyon oranı maksimum çabada %92’den %51’e düşüyor | Araştırma ve geri getirme sistemleri için daha iyi çekimserlik önemli olabilir |
| Uzun ufuklu bilgi işi | Görevler arasında karışık ilerleme | Yerel değerlendirme gerekli olmaya devam ediyor |
Hiçbir bağımsız benchmark üretim gerçekliğini veya güvenliği sertifikalandırmaz. Ekipler, doğru yanıtlar, gerekçelendirilmiş belirsizlik, desteklenmeyen iddialar ve kaynak kısıtlarına uyulmayan durumları ayrı ayrı puanlamalıdır.
Astra Neden Uzun Ufuklu Ajan Çalışmalarına Daha Uygun?
GPT-6 Astra, çalışırken değişen işlere yönelik üç kontrol ekler. Uzun süreli güvenilirlik ayrıca tüm bağlam sistemine bağlıdır: bağlam penceresi kapasiteyi belirler; sıkıştırma, eski materyalin nasıl yoğunlaştırıldığını kontrol eder; kalıcı akıl yürütme, ilgili model durumunu ileri taşır; geri getirme, önceki kanıtların aranabilir kalmasını sağlar; ve uygulama, önemli araç çıktıları, test sonuçları, başarısız yaklaşımlar ve kullanıcı gereksinimlerini korumalıdır. Bu mekanizmalar ajan harness’ıyla birlikte test edilmelidir.
- Asenkron araç çağırma: Astra, bir uygulama uzun süreli bir aracı yürütürken bağımsız akıl yürütmeye devam edebilir veya diğer araçları çağırabilir.
- Tur ortasında yönlendirme: bir uygulama, tamamlanan işi atmaya gerek kalmadan WebSocket üzerinden bir düzeltme veya yeni gereksinim gönderebilir.
- Konuşma ortasında akıl yürütme ayarı: bir yapılandırma güncellemesi, önbelleğe alınmış istem önekini korurken akıl yürütme çabasını yükseltebilir veya düşürebilir.
Astra’nın Gerçekte İyileştiği Yerler
Ajan Temelli Kodlama: Terminal Çalışması Daha Büyük Yükseltme
Terminal-Bench 4.0, bir ajanın izole bir kod yanıtı üretmekten ziyade zorlu terminal görevlerini çalışıp çalışamadığını değerlendirir. Astra %57.9’a ulaşıyor; Sol’un 20,6 yüzde puan, Fable’ın 2,1 puan üzerinde. Bu, OpenAI için nesiller arası kayda değer bir iyileşme, ancak başka bir sınır ajan sistemi üzerinde daha dar bir üstünlük.
DeepSWE farklı bir hikâye anlatıyor: Astra %74.1, Sol %72.7. 1,4 puanlık fark, tek bir kodlama benchmark’ından genelleme yapılmaması gerektiği konusunda uyarıyor. Astra, kodlama ortam etkileşimi, yineleme, durum koruma ve doğrulama gerektirdiğinde en çok kazanıyor gibi görünüyor.
Database Migration Tasks bunu pekiştiriyor. %63.9’luk sonuç, Sol’un 21,2 ve Fable’ın 6,1 puan üzerinde. Geçiş çalışmaları; kod anlama, araç kullanımı, sıralama ve operasyonel muhakemeyi birleştirir—küçük akıl yürütme iyileştirmelerinin çok daha büyük tamamlama kazanımlarına biriktiği bileşik bir iş akışı türü.
Kodlama ajanları için modeli ve harness’ı birlikte değerlendirin. Depo talimatları, terminal araçları, yeniden deneme davranışı, bağlam koruma ve test yürütmesi ölçülen sonuca hep birlikte katkıda bulunur.
Bilgisayar Kullanımı: Başarı Oranı ve Çalışma Süresi Her İkisi de Önemli
Agents’ Last Exam’de, GPT-6 Astra %59.3 puan alırken, GPT-5.6 Sol %53.6 alıyor: 5,7 puanlık bir artış. Bu, yukarıdaki genel bakışta yer alan OSWorld 2.0 ve ScreenSpot-Pro puanlarına daha geniş bir ajan görev sonucu ekliyor.
Doğruluğun ötesinde, OSWorld çalışma süresi karşılaştırması başka bir pratik boyut ekliyor: OpenAI, Astra için görev başına yaklaşık 40 dakika, Sol için yaklaşık 75 dakika rapor ediyor; bu da görevi daha sık başarıyla tamamlamanın yanı sıra yaklaşık %47 daha az geçen zaman demek.
Sedace biraz daha sık başarı sağlayan ve çok daha hızlı bitiren bir ajan, büyük bir çıktı artışı sağlayabilir. Bu nedenle tedarik testleri yalnızca doğruluğu değil, başarı oranını, geçen zamanı, araç çağrılarını, yeniden denemeleri ve insan müdahalelerini de raporlamalıdır.
Otomasyon ve Profesyonel İş
AutomationBench, %18.1’den %41.4’e yükseliyor; 23,3 puanlık bir artış. Mutlak skor hâlâ mükemmel olmaktan uzak, ancak başarısızlık profilindeki değişim, doygunluk yakınındaki bir puan hareketinden daha anlamlı. BenchCAD’de Astra %95.9’a ulaşıyor; Sol’u 12,6, Fable’ı 11,6 puan geride bırakıyor.
Bu sonuçlar belirli bir iddiayı destekliyor: Astra, talimatları doğrulanmış eylem dizilerine dönüştürmede daha iyi. Bu, her iş süreçleri için eşit kazanımlar kanıtlamaz. Üretim süreçleri, benchmark’ta bulunmayan kimlik doğrulama adımları, mülkiyet arayüzleri, belirsiz politikalar veya veri formatları getirebilir.
Bilim
Bilim, Astra’nın en net yetenek kazanımlarından biri. FrontierMath Tier 4 v2’de, Astra %97.6’ya ulaşırken Sol %83.0, Fable %87.8’de kalıyor. Sol’a karşı 14,6 puanlık fark kayda değer, ancak benchmark seçilmiş bir görev dağılımını kapsıyor; tam bilimsel iş akışını değil.
Siber güvenlik
Siber güvenlik, sıradan bir liderlik tablosu hareketinden daha yüksek riskli ikinci büyük kazanım. June–August 2026 dönemini kapsayan ExploitBench’te Astra %39.0 alırken Sol %5.5’te kalıyor. OpenAI, bu daha yeni setin, tarihsel maruziyeti azaltmak için önceki üç ayın güvenlik açıklarını hedeflediğini rapor ediyor. OpenAI’nin siber güvenlik değerlendirmesinde Astra, kontrollü test sırasında daha önce bilinmeyen iki sıfır-gün güvenlik açığını keşfedip istismar etme yeteneği gösterdi. Bu sonuç, değerlendirme uzun süredir bilinen güvenlik sorunları yerine yakın zamanda açıklanan güvenlik açıklarına göre tasarlandığı için, performansın yalnızca ezberlenmiş örneklerden kaynaklanmış olma ihtimalini azaltması bakımından önemlidir. Sonuç, Astra’nın OpenAI’nin Kritik siber güvenlik yeteneği eşiğine ulaştığını ve bu nedenle dağıtım için gereken korumaları değiştirdiğini gösteriyor. Önemli olan, Astra’nın sınırsız siber operasyonları otonom olarak yürütebilmesi değil; yetenek seviyesinin dağıtım korumaları için gereklilikleri değiştirmesidir. Daha güçlü açık keşfi ve istismarı yeteneğine sahip sistemler, daha sıkı erişim kontrolleri, izleme, sandboxing ve insan inceleme mekanizmaları gerektirir.
Uzun Süreli Görevler: Bağlam Penceresi Her Şey Değil
Astra’nın 1.050.000 token’lık bağlam penceresi kapasiteyi anlatır, sürekliliği değil. Uzun süreli performans ayrıca sıkıştırma, kalıcı durum, aranabilir önceki bağlam, korunmuş akıl yürütme durumu ve araç çıktılarının saklanmasına bağlıdır. MRCR v2’de Astra, 256K–512K’da %100.0, 512K–1M’de %96.3 alırken Sol %91.5 ve %73.8 alıyor. En uzun aralıkta 22,5 puanlık fark, limitin yakınında kullanılabilir geri getirmenin, ilan edilen kapasiteden daha önemli olduğunu gösteriyor.
MRCR yapay bir geri getirme testi olarak kalır; bu yüzden üretim değerlendirmesi, özetlerin sıklıkla kaybettiği kanıtları korumalıdır: bir önceki düzeltmenin neden başarısız olduğu, belirli bir bileşenin davranışı, test sonuçları, tarihsel gereksinimler ve araç çıktısına gömülü ayrıntılar. Depolar ve araştırma arşivleri de yinelenen adlar, çapraz referanslar, bayat politikalar, çelişkili kaynaklar ve uzun dikkat dağıtıcı alanlarla test edilmelidir. Bu, ham bağlam kapasitesini, uzun ufuklu bir ajanın gerçekten ihtiyaç duyduğu bağlam koruma ve geri getirme davranışından ayırır.
Bağlamın korunması: Astra neden geleneksel uzun bağlam sistemlerinden farklı
Geleneksel uzun bağlam iş akışları genellikle şu deseni izler:
context → compaction → summary → continue
Bu yaklaşım token kullanımını azaltır, ancak kritik bir risk getirir: önemli ara bilgiler özetleme sırasında kaybolabilir.
Kayıp bilgi, çoğu zaman nihai yanıtın kendisi değil, gelecekteki kararlar için gerekli operasyonel ayrıntılardır:
- önceki bir düzeltmenin neden başarısız olduğu;
- hangi bileşenin anormal davranış gösterdiği;
- hangi test sonucunun uygulama yönünü değiştirdiği;
- hangi kullanıcı gereksiniminin daha sonra eklendiği;
- hangi araç çıktısının önemli kanıt içerdiği.
GPT-6 Astra, uzun süreli ajan iş akışları içinde bağlam korunumu ve geri getirme mekanizmalarını birleştirerek bu sınırlamayı ele alır.
Sistemin, yalnızca sıkıştırılmış özetlere güvenmek yerine, önemli notları koruyabilmesi, gerektiğinde önceki bilgileri geri getirebilmesi ve birden çok araç etkileşimi arasında sürekliliği sürdürebilmesi mümkündür.
Codex gibi kodlama ajanları için bu, uzun bir hata ayıklama görevinin şunları koruyabileceği anlamına gelir:
- önceki başarısız deneyler;
- depo değişiklikleri;
- test çıktıları;
- mimari kararlar;
- çözülmemiş sorunlar.
Dolayısıyla, Astra’nın 1M token’lık bağlam penceresinin değeri yalnızca alabileceği bilgi miktarı değil, saatler süren etkileşimlerden sonra doğru bilgiyi koruyup geri getirip getiremeyeceğidir.
Akıl Yürütme ve Yorumlama
ARC-AGI-3: Harness Sonucun Bir Parçasıdır
ARC-AGI-3, bir sınır benchmark’ın izole bir modeli değil bir sistemi ölçebileceğini en net şekilde gösterir. ARC Prize, standart harness’ta maksimum çabada %62.7 ve Provider Adapter’la yüksek çabada %99.9 rapor ediyor.
| ARC Prize değerlendirmesi | Standard Harness | Provider Adapter | Adapter Kazancı |
|---|---|---|---|
| max | 62.7% | 98.6% | +35.9 pp |
| xhigh | 59.3% | 98.4% | +39.1 pp |
| high | 54.8% | 99.9% | +45.1 pp |
| medium | 38.6% | 98.4% | +59.8 pp |
| low | 17.5% | 98.0% | +80.5 pp |
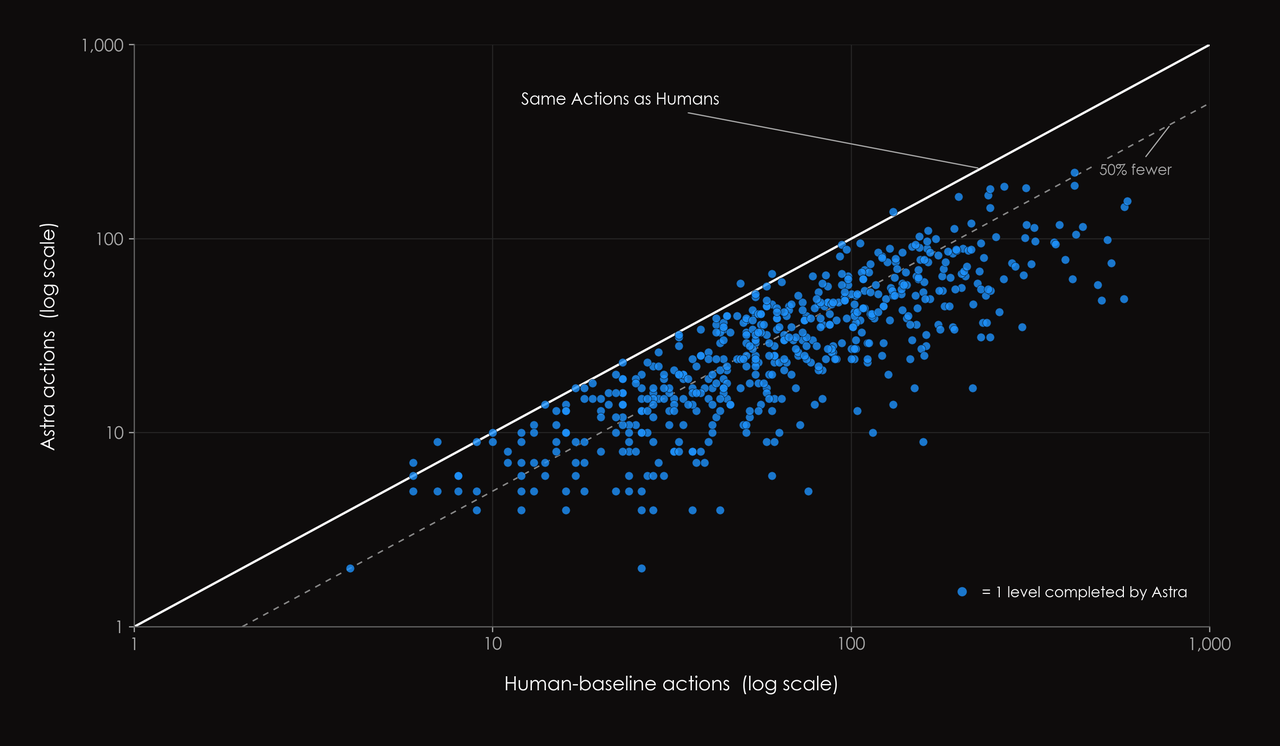
Astra’nın değerlendirme harness’ları arasında eylem verimliliği karşılaştırması (ARC Prize)
Sağlayıcı-nötr harness politikası, modelin önemli bilgileri görünür durumda korumasını gerektirir. Provider Adapter, ek akıl yürütme durumunu korur ve sağlayıcıya özgü bağlam yönetimi kullanır. Ortak çözülen oyun-akıl yürütme çiftlerinde, ARC Prize adapter ile 3,66× daha hızlı yürütme ve toplam token’larda %49 azalma rapor eder.
%99.9’luk sonuç, belirli bir model–sağlayıcı–adapter sistemini ölçer ve ham model zekâsının harness’tan bağımsız bir ölçümü olarak değerlendirilmemelidir. Bağlam mimarisi, benchmark’lanan sistemin bir parçasıdır.
Akıl Yürütme Çabası Doğrusal Ölçeklenmez
ARC tablosu ayrıca maksimum çabanın her zaman en yüksek puanı üretmediğini gösteriyor. Provider Adapter ile “high” çabası %99.9’a ulaşırken, “max” %98.6’da kalıyor. Standart harness’ta “max” en iyi performansı veriyor.
OpenAI, lansman tablosu rakamlarının genel olarak en iyi gözlenen akıl yürütme ayarını kullandığını belirtiyor. Bu yaklaşım bir performans tavanını tahmin eder, ancak en iyi üretim yapılandırmasını belirlemez. Ekipler birkaç çaba seviyesini test etmeli ve ek saniye ve dolar başına marjinal kalite kazanımını hesaplamalıdır.
Matematik ve Akademik Akıl Yürütme
FrontierMath Tier 4 v2, %83.0’dan %97.6’ya yükseliyor; 14,6 puanlık kazanım. Bu büyük bir benchmark iyileşmesi, ancak sınır matematiğin çözüldüğünün kanıtı değil. Değerlendirme seçilmiş bir görev dağılımını kapsar ve matematiksel araştırmanın her aşamasını, problem seçimi, formel ispat doğrulaması, uzun süreli program geliştirme veya adversarial akran değerlendirmesini ölçmez.
GPQA Diamond, zıt bir desen sunar: Astra %96.0, Sol %94.6, Fable %93.7 ve Gemini 3.8 Flash %95.3. Modeller, tavanın yakınında sıkı kümeleniyor. Astra–Sol arasındaki 1,4 puanlık farkı raporlamak doğrudur, ancak bunu geniş bir zekâ devrimi olarak nitelendirmek kanıtı abartır.
Kritik yetenek + korumalar
| Siber güvenlik değerlendirmesi | Astra | Sol | Mutlak Kazanç |
|---|---|---|---|
| ExploitBench | 100.0% | 78.5% | +21.5 pp |
| ExploitGym | 42.4% | 30.3% | +12.1 pp |
| ExploitBench, June–August 2026 | 39.0% | 5.5% | +33.5 pp |
| SRE-Bench | 88.0% | 55.9% | +32.1 pp |
| SEC-Bench Pro | 85.4% | 79.1% | +6.3 pp |
OpenAI, ExploitBench’i (June–August 2026) önceki üç ay içinde açıklanan güvenlik açıklarından oluşturdu; bu, tarihsel maruziyetin sonucu şişirme ihtimalini azaltır. Astra bu sette %39.0 alırken Sol %5.5’te kalıyor ve OpenAI, Astra’nın iki daha önce bilinmeyen sıfır-gün güvenlik açığını bulup istismar ettiğini rapor ediyor. Bu sonuçlar, Astra’nın OpenAI’nin geniş ölçekte dağıtılan ilk modeli olarak Kritik siber güvenlik yeteneği eşiğine ulaşmasına katkıda bulundu; bu da doğrudan korumaları ve erişim politikasını etkiledi.
Doygunluğa Yakın Puanları Nasıl Okumalı?
%90’ın üzerindeki puanlar, orta aralıktaki sonuçlardan daha dikkatli bir dil gerektirir. %50’den %60’a çıkmak, her yüz görevde on ek görevin çözülmesi demektir. %95’ten %96’ya çıkmak, kalan hata sayısını beşten dörde indirir—%20 hata azalması—ama her yüz görevde yalnızca bir ek görevi çözer. Her iki tanım da matematiksel olarak doğrudur, ancak çok farklı manşetleri destekler.
Tersi uyarı, düşük puanlı benchmark’lar için geçerlidir. %18.1’den %41.4’e yükseliş, güvenilir otonom çalışmadan hâlâ uzaktır; ancak başarıların sayısını iki kattan fazla artırır ve denetimli bir iş akışını dönüştürebilir. Mutlak skor, sistemin hazır olup olmadığını belirler; iyileşme büyüklüğü, yeteneğin ne kadar hızlı değiştiğini gösterir. Üretim kararlarının her ikisine de ihtiyacı vardır.
Çok Boyutlu Bir Karşılaştırma
| Boyut | Astra | Sol | Fable | Karar Sinyali |
|---|---|---|---|---|
| Genel akademik akıl yürütme | Mükemmel; sıklıkla doygunluğa yakın | Hemen arkasında | Rekabetçi | Küçük farklar tek başına dağıtımı nadiren belirler |
| Terminal yürütme | En üst düzey | Büyük nesiller arası boşluk | Yakın rakip | Tüm kodlama harness’ını test edin |
| Bilgisayar kullanımı | Daha yüksek başarı ve daha düşük süre | Daha yavaş ve daha az doğru | Lansman tablosunda yeterli karşılaştırma yok | Saat başına başarıyı ölçün |
| Uzun bağlamlı geri getirme | 1M token’a yakın güçlü | Limite yakın belirgin bozulma | Doğrudan karşılaştırılabilir veri yetersiz | Üretim şekilli geri getirme testleri kullanın |
| Akıl yürütme kontrolü | low’dan max’e | Farklı çaba zarfı | Adaptive-thinking yaklaşımı | Sadece model adını değil, yapılandırmayı ayarlayın |
| Siber yetenek | Niteliksel olarak daha yüksek risk katmanı | Daha düşük yayımlanan sonuçlar | Burada karşılaştırılmadı | Korumalar ve erişim politikası önemlidir |
| Token ekonomisi | Daha yüksek oran; bazen daha az token | Daha düşük oran | İş yüküne bağlı | Başarılı görev başına maliyeti karşılaştırın |
Sonuç iş yüküne bağlıdır. Astra, görev araçlar ve ortamlarla sürekli etkileşim, başarısızlıktan sonra toparlanma veya çok büyük bağlamlar arasında güvenilir geri getirme gerektirdiğinde en ikna edicidir. Sol, mütevazı bağlam ve sınırlı yineleme ile sınırlı işlerde daha ekonomik kalabilir. Fable, terminal işlerinde yakın bir rakip ve bazı dış akademik değerlendirmelerde önde; bu nedenle bir sağlayıcı düzeyi sonucundan ziyade uygulama düzeyi benchmark daha yararlıdır.
Kimler GPT-6 Astra’yı Kullanmalı?
| Kullanım Durumu | Öneri |
|---|---|
| Basit Sınıflandırma | Astra’yı kullanmaya gerek olmayabilir |
| Basit Özetleme | Astra’yı kullanmaya gerek olmayabilir |
| Standart RAG | Önce maliyet–performansı benchmark’layın |
| Uzun Belge Sentezi ve Analizi | Astra’yı test etmeye değer |
| Ajan Temelli Kodlama | Test etmeniz şiddetle önerilir |
| Bilgisayar Kullanımı | Test etmeniz şiddetle önerilir |
| Çok Adımlı Otomasyon | Test etmeniz şiddetle önerilir |
| Karmaşık Araştırma | Test etmeye değer |
| Bilimsel Hesaplama / Uzman Yazılımlar | Test etmeye değer |
| Siber güvenlik | Güçlü yetenekler; uygun güvenlik kontrolleri gerekir |
| Yüksek Hacimli, Basit Görevler | Daha düşük maliyetli modeller daha uygun olabilir |
GPT-6 Astra’nın Fiyat Primini Haklı Çıkaracak Performans Kazançları Var mı?
GPT-6 Astra, GPT-5.6 Sol’dan belirgin şekilde daha pahalıdır; ancak benchmark iyileştirmeleri iş yükleri arasında eşit dağılmamıştır. Bu nedenle fiyatlandırma sorusu yalnızca token oranlarını karşılaştırarak yanıtlanamaz.
| Senaryo | Performans Kazancı | Maliyet Gerekçesi |
|---|---|---|
| Basit Soru–Cevap | Küçük iyileşme | Genellikle primi haklı çıkarmaz |
| Kodlama ajanı | Büyük iyileşme | Prim haklı çıkarılabilir |
| Uzun bağlam analizi | Önemli iyileşme | Geri getirme ihtiyacına bağlı |
| Bilgisayar otomasyonu | Güçlü iyileşme | Çoğunlukla test etmeye değer |
| Genel akıl yürütme | Sınırlı iyileşme | Maliyeti dikkatle karşılaştırın |
OpenAI Standart oranlarında, GPT-6 Astra’nın girdi maliyeti milyon token başına $10, önbellekli girdi $1, önbellek yazımı $12.50 ve çıktı $50’dir. Standart girdi ve çıktı, GPT-5.6 Sol için $4 ve $20 olan oranların 2,5×’idir. Bir istek 272K girdi token’ını aştığında, Astra’nın girdi ve önbellek oranları ikiye katlanır ve çıktı oranı 1,5× artar; bu daha yüksek oranlar tüm istek için geçerlidir.
Fiyat primi en net şekilde ajan temelli çalışmayla hizalanır. Astra, Terminal-Bench, AutomationBench, veritabanı geçişi ve en uzun MRCR aralığında 20 puanın üzerinde kazanım elde ediyor; bağımsız testler ayrıca Coding Agent Index’te Sol’un yaklaşık üçte biri kadar token kullandığını bildiriyor. Eşleşme, Intelligence Index’in neredeyse başa baş olduğu ve token kullanımının yalnızca %10 düştüğü geniş akıl yürütmede daha zayıf. Satın alma kararı bu nedenle, çıktı, önbellek etkinliği, araç kullanımı, geçen süre, yeniden denemeler, hatalar ve insan düzeltmesi dahil olmak üzere başarılı görev başına maliyeti karşılaştırmalıdır.
Başarılı görev başına maliyet
Başarılı görev başına maliyet = (Girdi maliyeti + Çıktı maliyeti + Araç maliyeti + Yeniden deneme maliyeti + İnsan inceleme maliyeti) / Başarılı görevler
Beklenen iş maliyeti
Beklenen iş maliyeti = API maliyeti + Araç maliyeti + Yeniden deneme maliyeti + İnsan inceleme maliyeti + Başarısızlık maliyeti
Karar metriği, kabul edilebilir kalite eşiğinde değerlendirilen, başarılı görevler başına toplam maliyet olmalıdır—milyon token başına “etiket” fiyatı değil.
Geliştiriciler Astra’yı Nasıl Benchmark’lamalı?
Kamu liderlik tabloları, neyin test edilmeye değer olduğunu belirlemeli; nihai dağıtım kararını değil. Rutin vakalar, zor vakalar, eksik bağlam vakaları, araç arızaları ve adversarial talimatlarla temsilî bir görev seti oluşturun. Her model için aynı üretim istemini, izinleri, kaynak dosyalarını, zaman bütçesini ve tamamlama kriterlerini kullanın.
| Değerlendirme Boyutu | Ölçüm | Neden Önemli |
|---|---|---|
| Görev başarısı | Kabul kriterlerinin sağlanması | İkna edici ama eksik cevapların başarı olarak sayılmasını önler |
| Güvenilirlik | Tekrarlı çalışmalardaki başarı dağılımı | Dengesiz tek seferlik kazanımları ortaya çıkarır |
| Araç yürütme | Doğrulanmış başarılı eylemler | Araç çağrılarını doğru sonuçlardan ayırır |
| Gerçeklik | Destekli olgusal iddialar | Kanıt kalitesini ve çekimserliği ölçer |
| Gecikme | Medyan ve kuyruk tamamlama süresi | Operasyonel çıktıyı yakalar |
| Maliyet | Başarılı görev başına toplam maliyet | Yeniden denemeler ve başarısız girişimleri içerir |
| İnsan emeği | Düzeltme ve inceleme dakikaları | Gerçek dağıtım maliyetine sıklıkla hakimdir |
| Yönlendirilebilirlik | Değişen gereksinimlerden sonra toparlanma | Uzun süreli ajan davranışını test eder |
CometAPI’de Astra API’si model kimliği olarak gpt-6-astra kullanır. Çoklu model API’si, aynı değerlendirmeyi Astra, Sol, Fable ve Gemini üzerinde, benchmark’ı bir sağlayıcının manşet tablosuna göre yeniden tasarlamak zorunda kalmadan çalıştırmayı pratik kılar. Talepkâr ajan görevlerini primini hak eden modele yönlendirin ve ölçülen avantajın kaybolduğu yerlerde daha düşük maliyetli modelleri kullanın.
Sonuç
Astra’nın benchmark sayfası etkileyici, ancak en şaşırtıcı skorlar otomatik olarak en yararlı olanlar değildir. ARC-AGI-3, sağlayıcıya özgü bir ajan harness’ının potansiyelini gösterir; Standart harness puanı, altyapının sonucu ne kadar güçlü etkilediğini gösterir. GPQA ve bağımsız Intelligence Index, sıradan akıl yürütme kazanımlarının mütevazı olabileceğini gösterir. Terminal çalışmaları, otomasyon, bilgisayar kullanımı, uzun bağlamlı geri getirme, bilimsel iş akışları ve siber güvenlik daha önemli hikâyeyi anlatır.
Bu yayın, her soruda orantılı olarak daha akıllı hale gelen bir sohbet botundan ziyade, sınır zekânın işi tamamlama konusunda daha iyi hale gelmesiyle ilgilidir. Bu yükseltmenin ücrete değer olup olmadığı, tüm model–sistem yapılandırmasına ve başarılı üretim görevlerinin ekonomisine bağlıdır.