CometAPI ile geliştirinBirden çok model için tek bir API mi gerekiyor?İş akışını Playground'da test edin, ardından model ve maliyet kullanım senaryonuza uyduğunda bir API anahtarı oluşturun.
MiniMax M3.1 Flash'ı yerel olarak nasıl çalıştırılır: GPU, vLLM ve SGLang Kılavuzu
MiniMax M3.1 Flash’ı yerel olarak nasıl çalıştıracağınızı öğrenin. 428B/23B MoE mimarisi, GPU gereksinimleri, vLLM ve SGLang kurulumu, benchmarklar, API alternatiflerini keşfedin.
MiniMax M3.1 Flash, talepkâr kodlama ve ajan iş akışlarına açık-ağırlıklı yapay zekâyı getiriyor; ancak yerelde çalıştırmak ciddi donanım gerektirir. 428B parametreli MoE mimarisi, hesaplamayı azaltmak için her token başına yalnızca 23B parametreyi etkinleştirir; bu, tam modelin depolanması gereksinimini ortadan kaldırmaz. Desteklenen çoklu GPU sistemlerine sahip geliştiriciler, vLLM veya SGLang ile dağıtım yapabilir. Altyapı yönetimini atlamak isteyenler için CometAPI’deki MiniMax M3.1 Flash API başlamak için daha basit bir yol sunar.
Öne Çıkanlar
Donanım en büyük engeldir. Yayınlanan vLLM yapılandırmaları, dört desteklenen Blackwell veya AMD MI355X GPU ya da sekiz H100/H200 GPU kullanır.
Netlik, kaynak ataması ve güncel API terminolojisi açısından gözden geçirildi.
Uzun bağlam, bellek maliyetleriyle gelir. Model bir milyon tokene kadar destekler; ancak pratik sunum sınırları mevcut GPU belleğine ve eşzamanlılığa bağlıdır.
Dağıtım donanım-spesifiktir. Genel bir kurulum komutu yerine uyumlu bir çıkarım motoru, quantization formatı ve hızlandırıcı yapılandırması kullanın.
Kıyaslamalar sadece başlangıçtır. Kendi iş yükleriniz altında kodlama doğruluğunu, ajan görev tamamlama oranını, gecikmeyi ve throughput’u değerlendirin.
Yerel ve barındırılan çıkarım farklı ihtiyaçlara hizmet eder. Kendi barındırmanız daha fazla altyapı kontrolü sunar; API erişimi kurulum karmaşıklığını ve bakım yükünü azaltır.
MiniMax M3.1 Flash Nedir?
MiniMax M3.1 Flash, metin, görseller ve videoları kabul eder ve metin üretir. Kodlama, otomasyon, bilgisayar etkileşimi ve güvenlik iş akışları için tasarlanmıştır. Ağırlıklar MiniMax Community License kapsamında dağıtılır. Ticari bir hizmet sunmadan önce kontrol noktasıyla birlikte verilen lisansı okuyun ve kullanımınıza uygulanacak koşulları kontrol edin.
MiniMax M3.1 Flash özellikleri
Özellik
MiniMax M3.1 Flash
Geliştirici
MiniMax
Model ailesi
Yerel çok modlu MoE
Toplam parametre
Yaklaşık 428B
Etkin parametre
Token başına yaklaşık 23B
Maksimum bağlam
1.048.576 token (model yeteneği)
Girdi türleri
Metin, görseller ve video (rota bağımlı)
Çıktı
Metin
Dikkat
Her katmanda MiniMax Sparse Attention
Quantization
MXFP8 yoğun katmanlar / NVFP4 uzmanlar
Taslak kod çözme
DSpark entegre taslak başlığı
Akıl yürütme çabası
Low, medium, high, xhigh, max
Bildirilen çıktı hızı
Elverişli koşullarda 200+ token/s; P50 170+ token/s
Lisans
MiniMax Community License
Belgelenmiş çıkarım
vLLM, SGLang
Tipik topoloji
4 desteklenen Blackwell veya MI355X GPU; 8 H100/H200 GPU
MiniMax M3.1 Flash 428B/23B mimarisini nasıl kullanıyor?
Bir Mixture-of-Experts (MoE) modeli, her token’ı seçili uzmanlardan geçirir. MiniMax M3.1 Flash’ta bir token için yaklaşık 23B parametre etkinken, toplam parametre havuzu yaklaşık 428B’dir. Seyrek etkinleştirme hesaplamayı azaltır; kontrol noktasını yoğun bir 23B modele dönüştürmez.
MiniMax M3.1 Flash’ta Neler Değişti?
Seyrek dikkat: Uzun girdilerde dikkat işini azaltmak için model genelinde uygulanır; fayda, sunum çekirdeklerine ve prompt’a bağlıdır.
Karışık kesinlikte ağırlıklar: MXFP8 yoğun bileşenler ve NVFP4 uzmanlar depolama ve hesaplama taleplerini azaltır, ancak yine de uyumlu donanım ve çekirdekler gerektirir.
DSpark kod çözme: Entegre taslak başlığı, desteklenen tariflerde üretimi hızlandırabilir; sonuçlar token kabulüne ve iş yüküne bağlıdır.
Güç farkında sunum: Altyapı seviyesinde zamanlama, kullanım oranını iyileştirebilir; bu, ağırlıkları indirince otomatik olarak elde edilen bir özellik değildir.
MiniMax M3.1 Flash için Hangi Donanım Gerekir?
GPU belleğini dört bölümde planlayın: kontrol noktası ağırlıkları, önceki token’lar için anahtar-değer (KV) önbelleği, çalışma zamanı tamponları ve iş yükü payı. Aşağıdaki tahminler yalnızca ham parametre depolamasını kapsar. Karışık kesinlik, quantization ölçekleri, çok modlu bileşenler ve sunum yükleri gerçek gereksinimi değiştirir.
Doğrulanmış GPU topolojileri
Hızlandırıcılar
Yayımlanan topoloji
Notlar
NVIDIA GB200/GB300/B200/B300
4 GPU, tensör paralelliği
Blackwell NVFP4-yerel yol
NVIDIA H100/H200
8 GPU, tensör paralelliği
FP8 önbellekler ve Marlin MoE yolu
AMD MI355X
4 GPU, tensör paralelliği
Desteklenen ROCm ve AITER ayarları gerektirir
24–32 GB tüketici GPU
Tam kontrol noktası referansı yok
Basit tek GPU yüklemesi için yeterli değildir
Yalnızca CPU iş istasyonu
Pratik dağıtım doğrulanmadı
Offloading deneyleri üretim rehberi değildir
Bellek tahmini: 428B parametre için ham depolama, BF16’da yaklaşık 856 GB, 8-bit’te 428 GB veya idealize 4-bit’te 214 GB’tır. Resmî kontrol noktası formatları karıştırır; bu rakamlar çalışma zamanı VRAM gereksinimleri değildir. Quantization ölçeklerine, KV önbelleğine, çalışma zamanı tamponlarına ve eşzamanlılığa pay ayırın; sistemi boyutlandırmak için gerçek kontrol noktası dosyalarını ve GPU’nuz için tarifi kullanın.
Kontrol noktası, geçici indirmeler ve geri alma kopyası için NVMe alanı ayırın.
Hangi Dağıtım Yöntemini Seçmelisiniz?
Desteklenen yerel bir küme için vLLM, referans yapılandırmalar ve tanıdık API entegrasyonuyla pratik bir başlangıçtır; SGLang, uyumluluğu kontrol ettikten sonra sunum özelleştirmesini keşfeden ekipler için uygundur; CometAPI ise prototipleme ve model değiştirme için barındırılan bir yol sunar.
Gereksinim
Yerel vLLM
Yerel SGLang
CometAPI
Ağırlıklar ve GPU’lar
Ağırlıkları indirin; destekli GPU’ları işletin
Ağırlıkları indirin; destekli GPU’ları işletin
Sağlayıcı-yönetimli çıkarım; yerel ağırlık yok
Blackwell / AMD MI355X
Donanım-spesifik tarifler
Donanım-spesifik tarifler
Donanım sağlayıcı tarafından yönetilir
H100/H200
Belgelendirilmiş sekiz GPU tarifi
Güncel destek matrisini kontrol edin
Donanım sağlayıcı tarafından yönetilir
Kod çözme ve paralellik
Destekli yollarda DSpark; tensör ve dağıtık sunum
Donanım-spesifik kod çözme; tensör ve uzman paralelliği
Rotanın sunduğu seçeneklerle sınırlı
Kontrol ve veri işleme
Sizin ortamınız; ölçeklemeyi siz yönetirsiniz
Sizin ortamınız; ölçeklemeyi siz yönetirsiniz
Harici sağlayıcı; ölçeklemeyi sağlayıcı yönetir
Donanımınız için doğrulanmış bir tarifi olan çerçeveyi seçin; ardından aynı prompt’lar, kesinlik ve eşzamanlılıkla gecikme ve throughput’u karşılaştırın.
MiniMax M3.1 Flash’ı vLLM ile Yerelde Nasıl Çalıştırırsınız?
Aşağıdaki adımlar, dört uyumlu NVIDIA Blackwell GPU’ya sahip bir Linux ana makinesi, destekli bir sürücü/CUDA ortamı ve resmî kontrol noktasına erişimi varsayar. Doğrulanmış bir vLLM sürümü kullanın; desteklenmeyen GPU donanımında sıradan bir kurulum, paket kurulumu başarılı olsa bile başarısız olabilir.
Kurulu wheel ve CUDA çalışma zamanının GPU ailenizle eşleştiğinden emin olun. Projeye özgü bir geliştirme derlemesi gerekiyorsa, başlatma argümanlarını kullanmadan önce referans kurulum notlarını izleyin.
Sunucu yüklemeyi tamamlayıp hazır olduğunu bildirene kadar bekleyin. Yukarıdaki komut, ilk duman testi için bağlamı 32.768 tokene ve eşzamanlı dizileri dörde sınırlar. Bu azaltılmış sınırlar ölçümlenmiş ayarlar değildir; donanımınızda bellek kullanımını ve istek davranışını ölçtükten sonra ayarlayın.
Sunulan tanımlayıcı dizin adından farklıysa, /v1/models çağrısı yapın ve döndürülen tam ID’yi kullanın. Başarılı bir metin yanıtı yalnızca temel çıkarımı doğrular; görsel, araç çağrıları, eşzamanlılık ve uzun bağlamı ayrı ayrı test edin.
Adım 5: OpenAI uyumlu bir Python istemcisiyle entegre edin
Örnek, yerel test için 127.0.0.1 üzerinde dinler. Uzak istemcileri bağlamadan önce uç noktanın önüne erişim kontrolleri koyun ve istemci zaman aşımlarını, sınırlı yeniden denemeleri ve izlemeyi yapılandırın.
H100/H200 varyantı: sekiz GPU’luk Hopper tarifini kullanın
Sekiz H100/H200 GPU’da, Blackwell NVFP4 yapılandırması yerine Hopper’a özgü FP8 önbelleği ve Marlin MoE yolunu kullanın. Aşağıdaki komut, bağlam ve eşzamanlılığı ilk test için 32K ve dört diziye düşürerek resmî vLLM Hopper tarifini izler. Bu tarif doğrultusunda video girişi devre dışı bırakır. Bu uç noktayı mevcut erişim kontrollerinizin arkasında tutun.
MiniMax M3.1 Flash’ı SGLang ile Nasıl Çalıştırırsınız?
SGLang, donanım-spesifik M3.1 dağıtım tarifleri ve OpenAI uyumlu sunum sunar. 23 Ekim anlık görüntüsünde, belgeler adanmış geliştirme konteyner imajlarını içerir; bu nedenle genel bir SGLang kurulumunun tüm modele özgü desteği içerdiği varsayılmamalıdır.
Adanmış konteyner imajını çekin
# NVIDIA development image
docker pull lmsysorg/sglang:dev-minimax-m31-flash

# AMD MI350X/MI355X development image
docker pull lmsysorg/sglang:dev-minimax-m31-flash-mi35x
Ardından hızlandırıcınız için SGLang MiniMax M3.1 yemek kitabını izleyin. Bir imaj çekmek yalnızca çalışma zamanını indirir; yine de GPU erişimiyle bir konteyner başlatmanız ve içinde eşleşen sunum yapılandırmasını çalıştırmanız gerekir. Yemek kitabındaki tam donanım-spesifik komutu kullanın, hazır olana kadar bekleyin, ardından bir test isteği göndermeden önce uç noktanın model listesini sorgulayın. Belgelenen NVIDIA ve AMD yolları farklı bağımlılıklar kullanır ve ayrı ayrı yapılandırılmalıdır.
MiniMax M3.1 Flash Kıyaslamalarda Nasıl Karşılaştırılır?
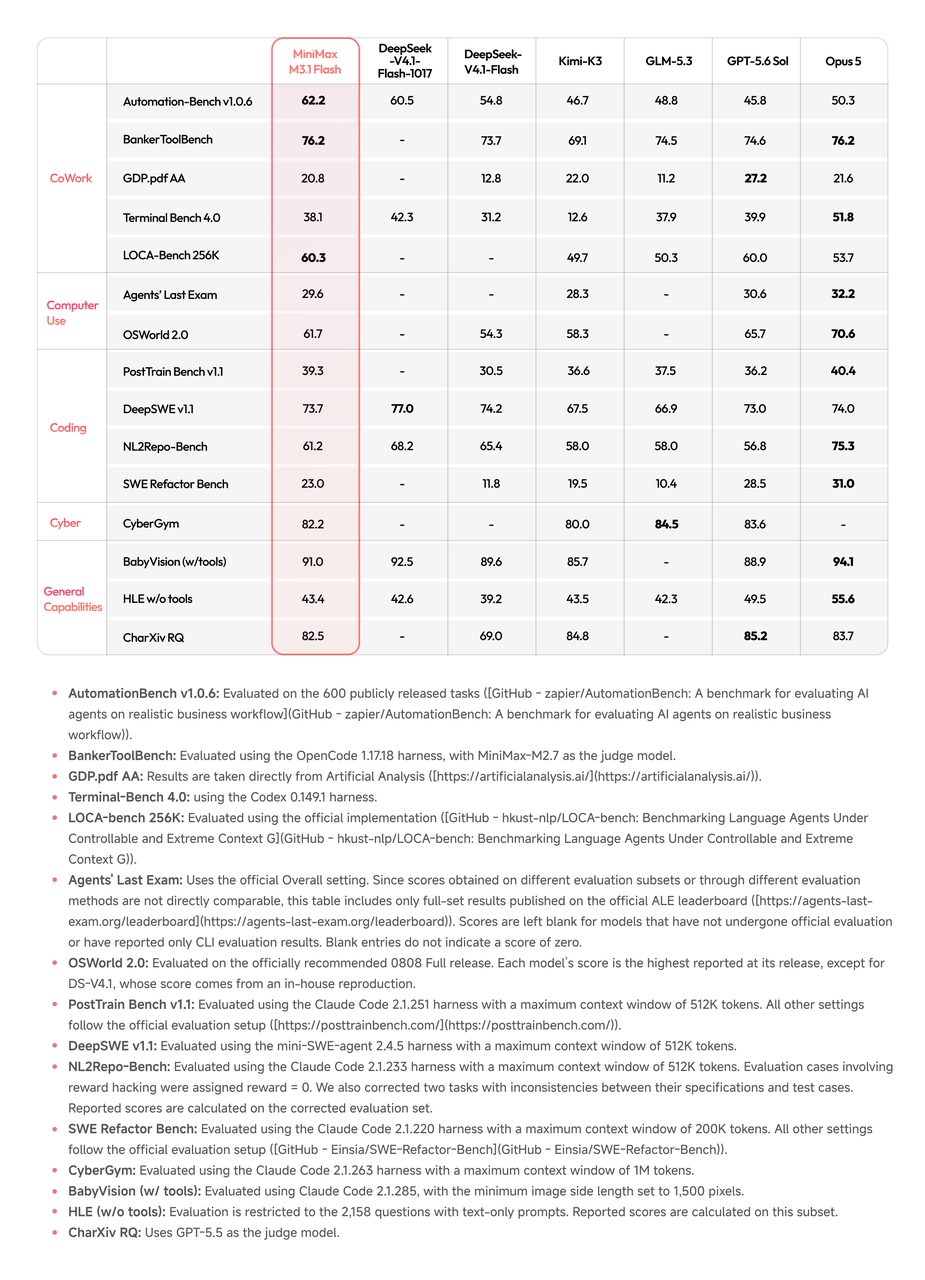
Uç noktanız temel kontrollerden geçtikten sonra, hangi iş yüklerini test edeceğinize karar vermek için yayımlanan kıyaslamaları kullanın. Aşağıdaki rakamlar, satıcı tarafından yayımlanan değerlendirmelerdir; yerel dağıtımınızın ölçümleri değildir.
Kıyaslama
M3.1 Flash
DeepSeek V4.1 Flash 1017
Kimi K3
Automation-Bench v1.0.6
62.8
60.5
46.7
DeepSWE v1.1
73.7
77.0
67.5
Terminal Bench 4.0
38.1
42.3
12.6
OSWorld 2.0
61.7
N/A
58.3
NL2Repo-Bench
61.2
68.2
58.0
BabyVision with tools
91.0
92.5
85.7
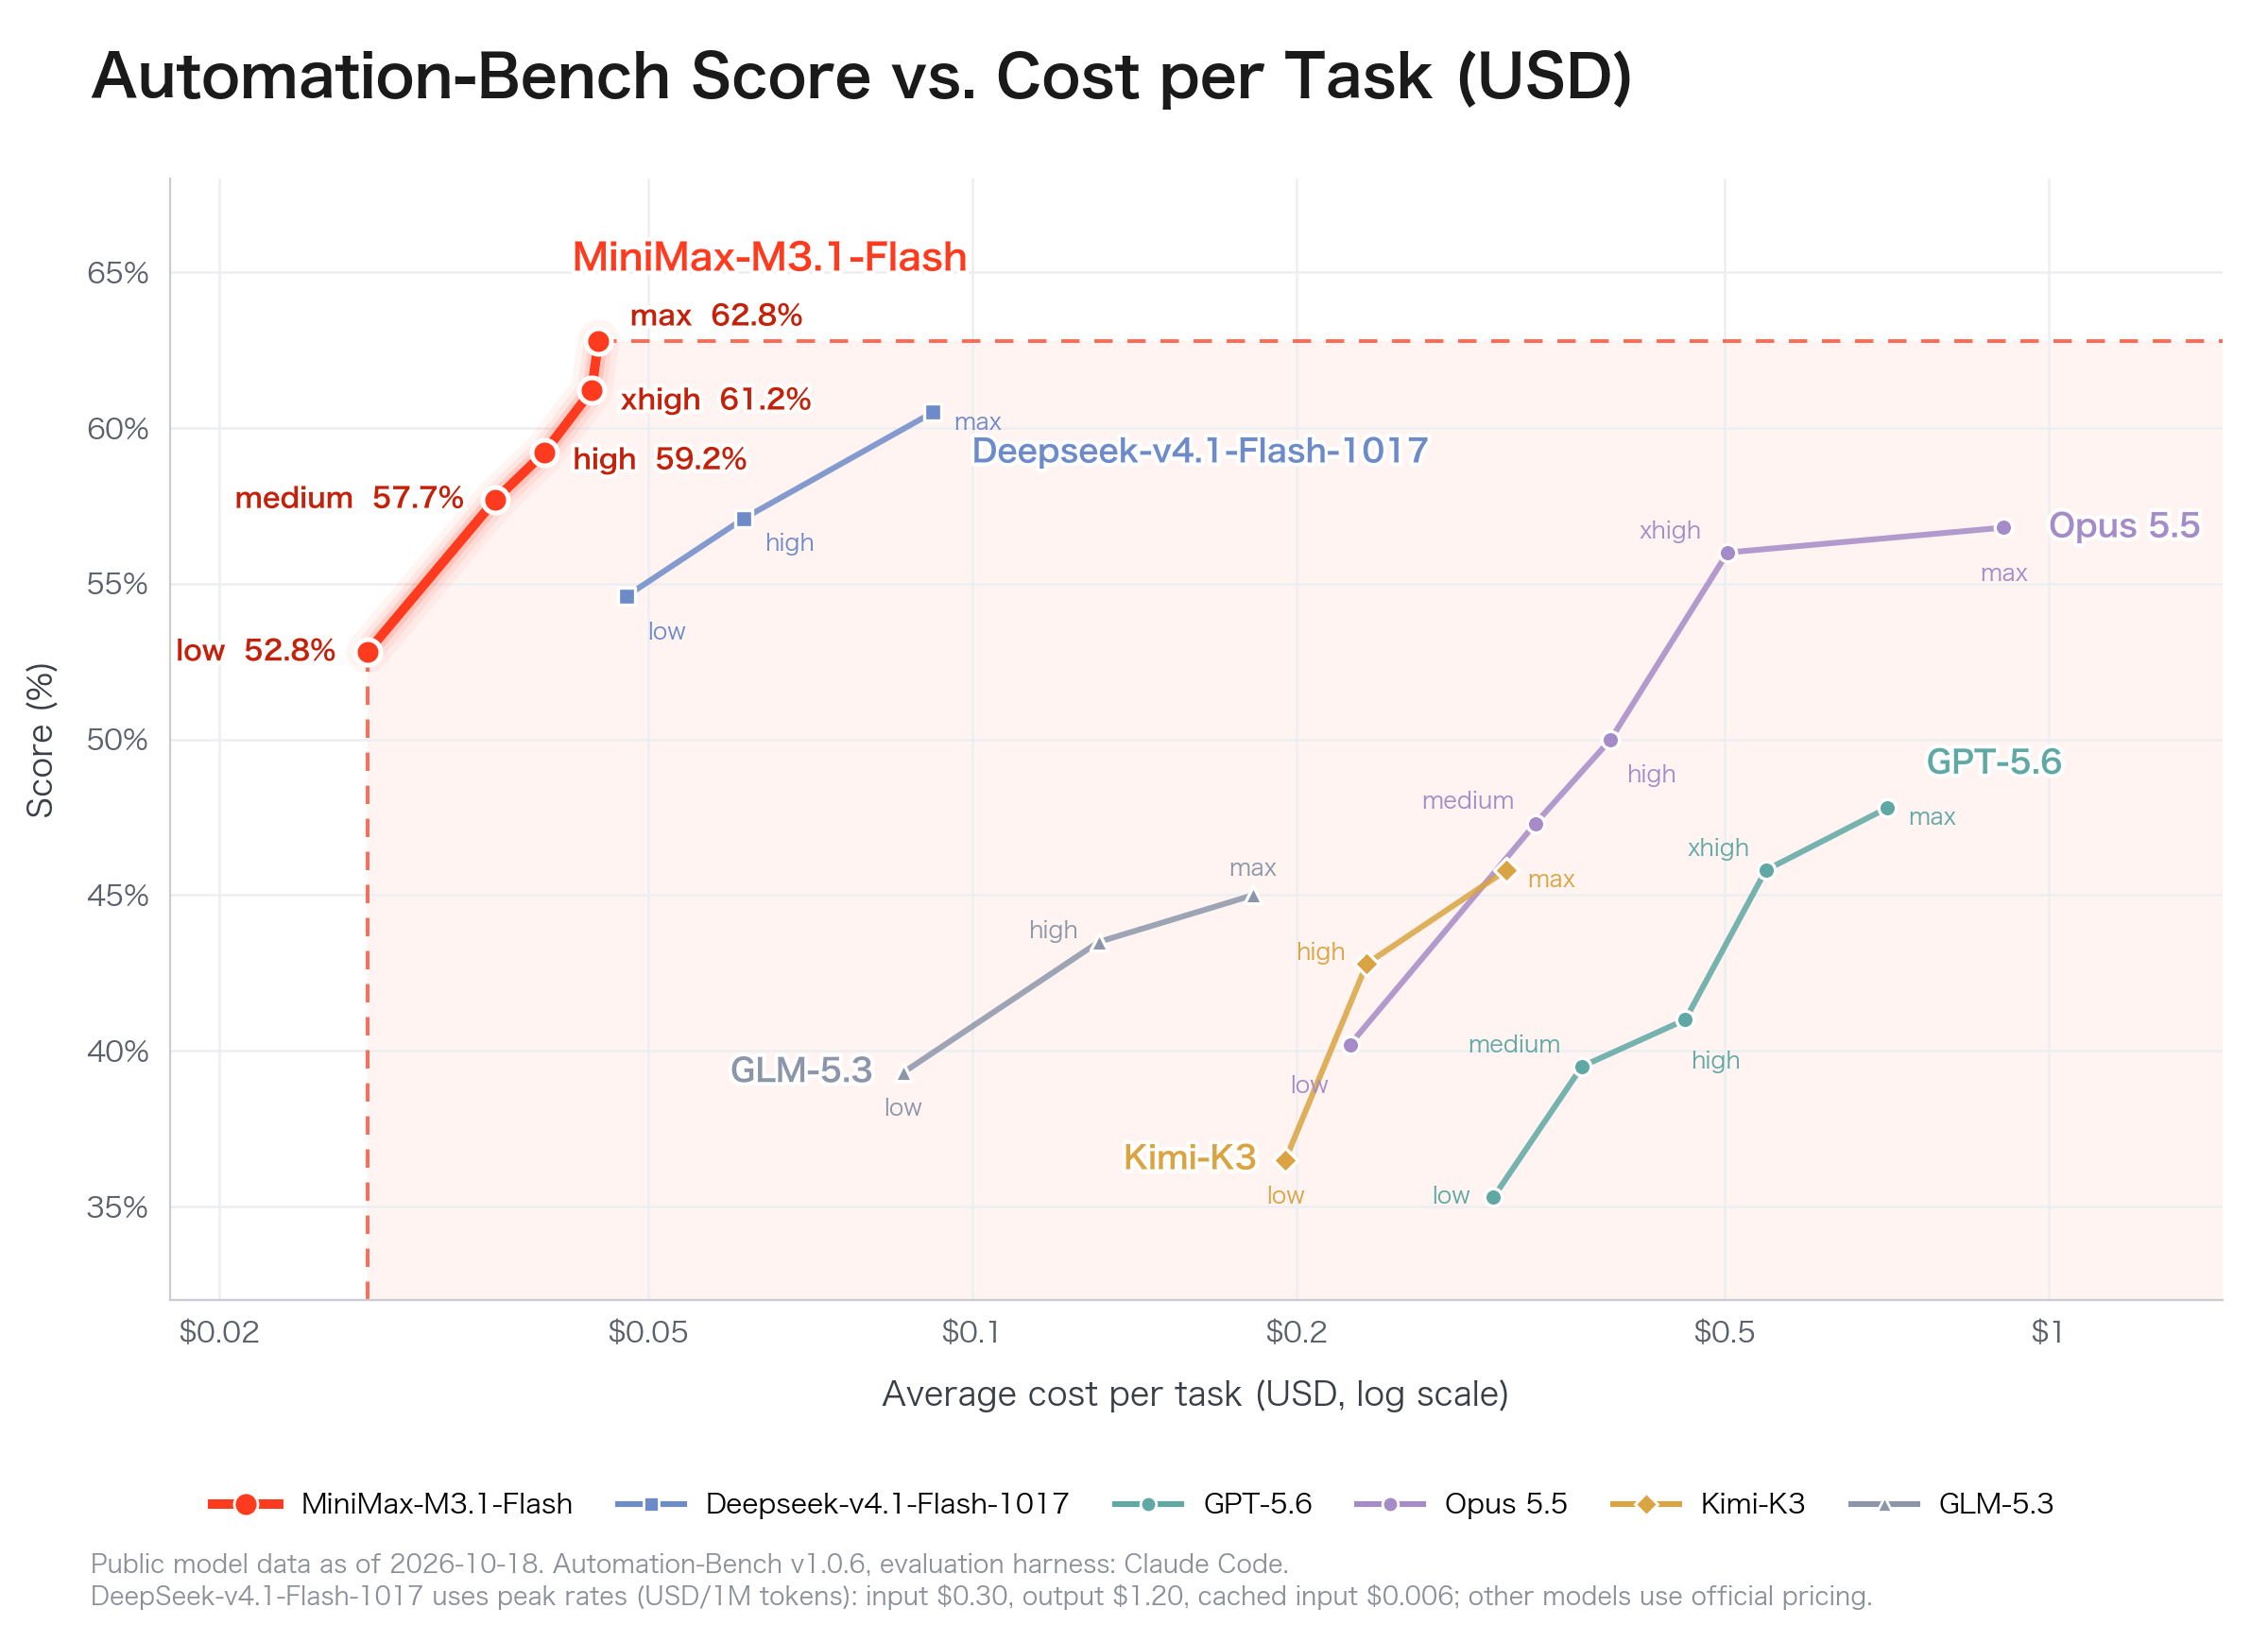
Bu karşılaştırmada, MiniMax listelenen modeller arasında Automation-Bench’te önde, DeepSeek ise birkaç kodlama kıyaslamasında önde yer alıyor. Sonuç çıkarmadan önce model kartını ve değerlendirme ayarlarını okuyun ve uygulamanızın gerçekten kullandığı prompt’ları ve araçları test edin. Farklı kıyaslama sürümleri veya kurulumlardan alınan skorlar doğrudan karşılaştırılabilir değildir.
MiniMax M3.1 Flash Performansını Nasıl Optimize Edebilirsiniz?
Bağlam ve eşzamanlılığı kontrol edin
İlk başarılı isteğin ardından, bir yük değişkenini bir seferde artırın: girdi uzunluğu, çıktı uzunluğu veya eşzamanlı istek sayısı. Her çalıştırma için tepe bellek ve yanıt gecikmesini kaydedin. Hatalı bir deneyin yeni temeliniz haline gelmemesi için son kararlı ayarları geri dönüş noktası olarak saklayın.
Akıl yürütme çabasını bilinçli seçin
M3.1 Flash, low, medium, high, xhigh ve max çabayı destekler. Daha yüksek ayarlar, talepkâr görev skorlarını iyileştirebilir ancak genellikle daha fazla akıl yürütme token’ı ve daha uzun gecikme gerektirir. Görev tamamlama kalitesi ile geçen hesaplama maliyetini birlikte kullanın.
Yerel vLLM istekleri için, tarifte chat_template_kwargs altında reasoning-effort ayarları gösterilir. İstemcinizi doğrularken hem nihai cevabı hem de ayrı olarak döndürülen herhangi bir akıl yürütme alanını kontrol edin; çünkü barındırılan ve yerel uç noktalar bu alanları farklı şekilde ortaya koyabilir.
Tamamlanan görev başına maliyeti takip edin
Ajanlar için saniye başına token yeterli değildir. İlk tokene kadar geçen süreyi, çıktı hızını, spekülatif kod çözme için kabul oranını, eşzamanlı throughput’u, araç çağrısı hatalarını, bellek kullanımını ve tamamlanan görev maliyetini kaydedin. Daha az başarısız araçla daha yavaş bir yanıt, genel ekonomide daha iyi sonuç verebilir.
MiniMax M3.1 Flash’ı CometAPI’deki API ile Nasıl Kullanabilirsiniz?
Adanmış hızlandırıcı altyapısına ihtiyaç duymayan ekipler, OpenAI uyumlu barındırılan bir uç nokta kullanabilir. Bu, kontrol noktası indirme ve GPU işlemlerini ortadan kaldırır ancak istek işlemesini kendi barındırılan ortamınızın dışına taşır.
export COMETAPI_KEY="YOUR_COMETAPI_KEY"

curl https://api.cometapi.com/v1/chat/completions \
  -H "Authorization: Bearer $COMETAPI_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "minimax-m3.1-flash",
    "messages": [{"role":"user","content":"Review this Python function for edge cases."}],
    "max_tokens": 2048
  }'
Bu örneği çalıştırmadan önce CometAPI konsolunuzda model tanımlayıcısını doğrulayın. Uygulamanız için sağlayıcılar arasında ortak bir API yardımcı oluyorsa ağ geçidini kullanın; beklenen kullanımınız için doğrudan erişimle mevcut teklifini karşılaştırın.
MiniMax M3.1 Flash API fiyatlandırması
Milyon token başına fiyat
MiniMax resmî API
CometAPI
Girdi
$0.15
$0.80
Çıktı
$0.60
$3.20
Önbelleğe alınmış girdi
$0.015
Geçerli rota teklifini doğrulayın
MiniMax doğrudan API oranları, 19 October 2026 lansman duyurusunda giride $0.15, çıktıda $0.60 ve önbelleğe alınmış girdide $0.015 / milyon token’dır. CometAPI için, aktif model rotasını, girdi/çıktı oranlarını, önbellekleme kurallarını ve varsa hesap indiriminizi, harcamayı tahmin etmeden önce kontrol edin. Beklenen token karışımınız ve yeniden denemeler için toplam maliyeti karşılaştırın.
MiniMax M3.1 Flash’ı Çalıştırırken Hangi Sorunlar Ortaya Çıkabilir?
Yükleme veya istekler sırasında bellek yetersizliği
Ağırlıklar yüklenemezse: Başlangıç günlüğünde başarısız olan aşamayı kontrol edin, kontrol noktasının eksiksiz olduğunu doğrulayın ve GPU topolojisinin ve quantization backend’inin tarifle eşleştiğini doğrulayın. Ağırlıklar mevcut belleği aşıyorsa, yeterli kapasiteye sahip bir yapılandırma kullanın; bir isteği kısaltmak ağırlık yükleme hatasını düzeltemez.
Ağırlıklar yüklenir ancak başlangıçta önbellek ayırma başarısız olursa: Önbellek ayarlarını ve mevcut belleği kontrol edin, ardından tarif için uygun şekilde yapılandırılmış bağlamı veya eşzamanlılığı azaltın.
Sunucu başlar ancak bir istek bellek yetersizliği verirse: Bir seferde bir istekle kısa bir prompt’u yeniden deneyin; ardından bellek izlenirken girdi uzunluğunu, çıktı uzunluğunu ve eşzamanlılığı ayrı ayrı artırın.
Uyumsuz quantization veya dikkat çekirdekleri
NVFP4 yürütmesi Blackwell, Hopper ve AMD donanımları arasında farklıdır. Çıkarım motoru sürümlerini, quantization backend’lerini, CUDA/ROCm sürümlerini ve hızlandırıcı ailelerini, bayrakları gelişigüzel yeniden kullanmak yerine eşleştirin.
Seyrek-dikkat önbellek yapılandırması
Başlangıçta desteklenmeyen bir önbellek düzeni bildiriliyorsa, tam önbellek yapılandırmasını donanım-spesifik tarifle karşılaştırın. Mevcut vLLM tarifi, MSA seyrek/indeks önbelleği için --block-size 128 gerektirir. Başlangıçta bir önbellek düzeni veya blok boyutu hatası bildirilirse, donanımınız için tarifteki tam yapılandırmayla karşılaştırın.
Beklenmedik model tanımlayıcıları
Yerel bir yol ve uzak ağ geçidi model adı mutlaka aynı değildir. Yerel /v1/models yanıtını sorgulayın ve başka bir uç noktadaki varsayımları sabitlemekten kaçının.
Düşük gözlenen throughput
Yavaş prompt işlemeyi yavaş token üretiminden ayırın. Aynı girdi uzunluğu ve çıktı sınırıyla çalışmaları karşılaştırın; ardından yığın boyutunu artırmadan önce GPU kullanımını ve ara bağlantı davranışını kontrol edin. Bir sağlayıcı tarafından barındırılan hız rakamı, yerel kümeniz için bir temel değildir.
Sonuç
İlk dağıtım yolunuzu bugün işletebileceğiniz donanımdan seçin. Desteklenen yerel bir küme için vLLM yürütmesini kullanın, alternatif bir sunum yığını için donanım-spesifik SGLang yemek kitabını takip edin veya uygulama entegrasyonuna odaklanmak istediğinizde barındırılan bir API kullanın. Görev kalitesi ve gecikme hedeflerinizi sürdürülebilir bir işletim maliyetinde karşılayan yapılandırmayı koruyun.
Bir sunum yöntemini seçmenin en güvenilir yolu, yalnızca tepe saniye başına token’a değil, tamamlanan doğru iş başına dolar ve dakika optimizasyonudur.
SSS
Çalışma zamanını yükselttikten sonra dağıtımı nasıl yeniden üretilebilir kılarım?
Kontrol noktası revizyonunu, çalışma zamanı imajını veya paket sürümlerini, sürücü yığınını ve başlatma ayarlarını sabitleyin. Her yükseltmeden önce aynı küçük kabul setini çalıştırın ve geri alma için bir önceki çalışan yapılandırmayı hazır tutun.
Bir ajan araçları çağırdığında yeniden denemeleri nasıl ele almalıyım?
Modeli yeniden denemeyi, bir araç eylemini tekrarlamaktan ayırın. Veriyi değiştiren eylemler için idempotency anahtarları kullanın, ilk girişimin başarıya ulaşıp ulaşmadığını kontrol edin ve yürütmeden önce tam araç argümanlarını doğrulayın.
Yerel bir uç nokta ile CometAPI arasında uygulama davranışını değiştirmeden geçiş yapabilir miyim?
Uç noktayı, kimlik bilgilerini ve model ID’sini yapılandırılabilir tutun. Her iki yolda da akış, araç çağrıları, akıl yürütme alanları ve çok modlu girdileri test edin ve geri dönüşü etkinleştirmeden önce veri yönlendirme gereksinimlerinizi doğrulayın.
Çok modlu girdileri kabul etmeden önce neyi test etmeliyim?
Temsil edici görselleri ve videoları, düşük kaliteli ve desteklenmeyen dosyalar dahil test edin. Ön işleme, boyut sınırları, yanıt kalitesi ve zaman aşımlarını ayrı ayrı kontrol edin; başarılı bir metin isteği, çok modlu yolu doğrulamaz.
Bir dağıtımın gerçek kullanıcılar için hazır olduğunu nasıl anlarım?
Görev başarısı, geçerli araç çağrıları, gecikme, hatalar ve maliyet için hedefler belirleyin. Gerçekçi trafik testleri yapın, izleme ve geri dönüş davranışını doğrulayın; ardından yalnızca bu hedefler sağlanırken küçük bir yayılımdan genişletin.