
TL;DR
Kimi K3.1 Pro, Moonshot AI’nin 24 Ekim 2026 tarihinde Kimi K3’e yaptığı yükseltmedir. Ek sonradan eğitim, yaklaşık bir milyon tokenlik bağlam kapasitesini korurken özerk kodlama, finansal araştırma ve genişletilmiş araç-kullanım iş akışlarını geliştirir.
Bağımsız değerlendirmeler genel performansta güçlenme gösteriyor ve resmi standart giriş/çıkış token ücretleri üçte bir oranında düşüyor. Yükseltme yine de iş yükü testini gerektirir: daha derin akıl yürütme görev gecikmesini ve toplam harcamayı artırabilir; bu arada K3, AA-LCR’de küçük bir üstünlüğünü korur ve kendi altyapınızda barındırma için mevcut ağırlıklara sahiptir.
Öne Çıkanlar
- En net kazanımlar ajan odaklı yürütmede. Artificial Analysis, K3 için yaklaşık %13’e karşılık K3.1 Pro için yaklaşık %67 Terminal-Bench 4.0 skorları bildiriyor; Moonshot’ın dahili Finansal Araştırma skorları 58.8’den 70.4’e yükseliyor.
- Daha düşük token fiyatları daha düşük görev maliyetlerini garanti etmez. Standart resmi giriş/çıkış oranları milyon token başına $3/$15’ten $2/$10’a düşer, ancak ek akıl yürütme, araç çağrıları ve yeniden denemeler tasarrufu dengeleyebilir.
- Bağlam penceresi aynı kalır. Her iki model de 1,048,576 tokene kadar destekler. Alıntılanan AA-LCR v1.1 değerlendirmesinde K3 hafifçe önde, bu nedenle uzun bağlam doğruluğunu kendi belgeleriniz üzerinde test edin.
- Ağırlık kullanılabilirliği seçimi belirleyebilir. 24 Ekim 2026 itibarıyla K3 ağırlıkları mevcut; K3.1 Pro ağırlıklarının 4 Kasım’a kadar yayımlanması planlanıyor. Hemen kendi altyapınızda barındırmaya ihtiyaç duyan ekipler bu farkı hesaba katmalıdır.
Kimi K3.1 Pro ve Kimi K3: Genel Bakış ve Teknik Özellikler
Kimi K3.1 Pro, K3 üzerine ek sonradan eğitimle inşa edilmiştir; iyileştirmeler kodlama, finansal araştırma ve genişletilmiş ajan iş akışlarına odaklanır. Her ikisi de yaklaşık bir milyon token bağlamını korur. Ana farklar görev performansı, token fiyatlandırması, sunum seçenekleri ve ağırlık kullanılabilirliğidir.
| Özellik | Kimi K3.1 Pro | Kimi K3 |
|---|---|---|
| Geliştirici | Moonshot AI | Moonshot AI |
| Yayın tarihi | 24 Ekim 2026 | 16 Temmuz 2026 |
| Mimari | K3-türevli MoE, ek sonradan eğitimli | KDA, AttnRes ile MoE |
| Model boyutu | 3T sınıfı ve 104B etkin parametre | 2.8T toplam ve 104B etkin parametre |
| Bağlam penceresi | 1,048,576 tokene kadar | 1,048,576 tokene kadar |
| Standart API giriş/çıkış fiyatı | milyon token başına $2 / $10 | milyon token başına $3 / $15 |
| Highspeed sürümü | Mevcut | Ayrı bir K3 Highspeed varyantı listelenmiyor |
| Ağırlık kullanılabilirliği | 4 Kasım 2026’ya kadar yayın planlı | Kimi K3 Lisansı altında mevcut |
Ağırlık kullanılabilirliği, 24 Ekim 2026 tarihindeki bilgilere dayanmaktadır. API fiyatları, önbelleğe yazma ücretleri, vergiler ve diğer geçerli ücretler hariç, düzenli giriş ve çıkış için USD cinsindendir.
Mimari ve Sonradan Eğitim
K3, Kimi Delta Attention, Attention Residuals ve Stable LatentMoE’yi birleştiren 2.8 trilyon parametreli bir mimari tanıttı. Token başına yaklaşık 104 milyar parametreyi etkinleştirir.
Moonshot, K3.1 Pro’yu, önemli ölçüde daha büyük sonradan eğitim hesaplamasıyla geliştirilmiş, K3’ün sonradan eğitilmiş bir sürümü olarak tanımlıyor. Yükseltme, araç kullanımı, hata ayıklama ve sonuç doğrulama dahil çok adımlı görevlerde model yeteneklerinin uygulanmasına odaklanır. Duyuruda ayrı adlandırılmış bir temel mimari tanıtılmamıştır.
Ortak Yetenekler ve API Gereksinimleri
Her iki model de çok modlu girdileri, araç çağrısını, yapılandırılmış çıktıları ve bağlam önbelleğini destekler. Görsel ve video girdi formatları seçilen API rotasına bağlıdır. Her ikisi de her zaman akıl yürütür ve low, high ve max akıl yürütme çabasını destekler; varsayılan max’tır.
Çok turlu konuşmalar ve araç çağrıları için, entegrasyonların API’nin gerektirdiği şekilde akıl yürütme içeriği ve araç çağrıları dahil olmak üzere eksiksiz asistan mesajlarını koruması gerekir. Gerçek bağlam limitleri ve özellik kullanılabilirliği de seçilen sağlayıcı, ürün ve abonelik katmanı için kontrol edilmelidir.
Kimi K3.1 Pro ve Kimi K3: Performans
Kanıtlar, Moonshot’ın dahili testleri ve bildirdiği karşılaştırmaların yanı sıra bağımsız üçüncü taraf değerlendirmelerinden gelir.
Bunlar ayrı yorumlanmalıdır; çünkü kıyas düzenekleri, test setleri, akıl yürütme ayarları ve puanlama ölçütleri farklılık gösterebilir.
Artificial Analysis lansman değerlendirmesi, bileşik Intelligence Index’te 11 puanlık artış bildiriyor; özellikle terminal tabanlı kodlama ve ajan odaklı iş akışlarında büyük iyileşmeler var.
| Bağımsız Kıyas (Artificial Analysis) | Kimi K3 | Kimi K3.1 Pro | Fark |
|---|---|---|---|
| Intelligence Index | 44 | 55 | +11 |
| Terminal-Bench 4.0 | ~%13 | ~%67 | +54 yüzde puan |
| AutomationBench-AA | %58 | %73 | +15 yp |
| GDPval-AA Elo | 1,534 | 1,846 | +312 |
| AA-Omniscience Index | 20 | 30 | +10 |
| Humanity's Last Exam | ~%47 | ~%52 | +5 yp |
| AA-Omniscience halüsinasyon oranı | %53 | %44 | −9 yp |
| AA-LCR v1.1 | %88.7 | %86.3 | −2.4 yp |
Bunlar bağımsız değerlendirme sonuçlarıdır. Değerlendiricinin yuvarladığı skorlar yuvarlanmış değerlerle kullanılmıştır. Daha düşük halüsinasyon oranları daha iyidir.
En büyük iyileşme terminal tabanlı kodlamada gerçekleşir. K3.1 Pro, komut yürütme, ortam etkileşimi, hata ayıklama ve tekrarlanan doğrulama gerektiren görevlerde belirgin şekilde daha iyi performans gösterir.
AutomationBench-AA de önemli bir artış sergileyerek yazılım-hizmet iş akışlarında daha güçlü yürütmeye işaret eder.
Moonshot’ın yayın kıyasları kodlama, bilim, 3B rekonstrüksiyon, finans, bilgi işi ve özerk ajanları kapsar.
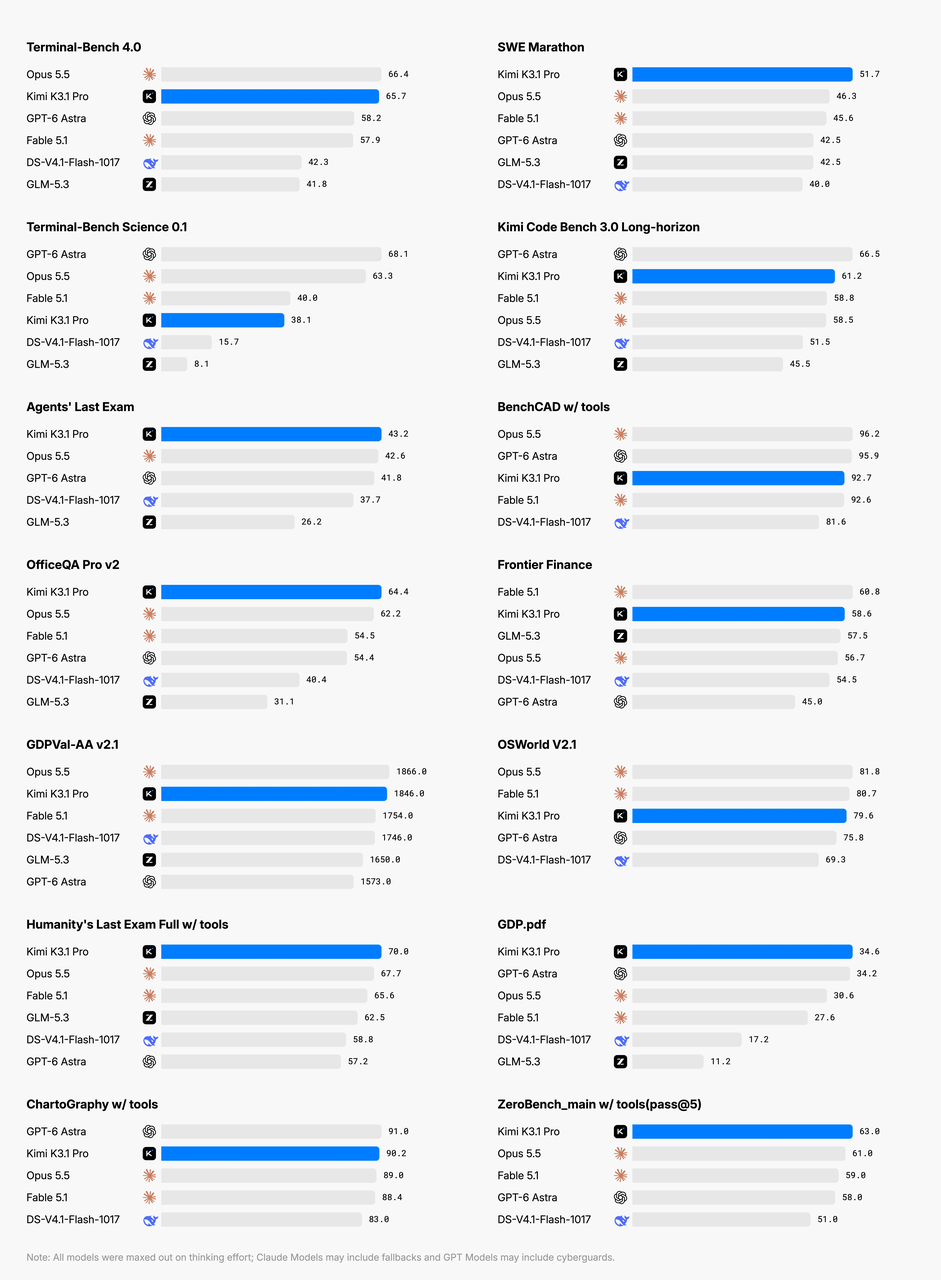
Seçilen karşılaştırmalar arasında Claude Opus 5.5 ve GPT-6 Astra yer alır. Her sonucu adlandırılmış kıyas ve belirtilen yapılandırma içinde karşılaştırın.
| Kıyas (Moonshot AI) | Kimi K3.1 Pro | Diğer Model | Karşılaştırma Model Skoru |
|---|---|---|---|
| Terminal-Bench 4.0 | %65.7 | Claude Opus 5.5 | %66.4 |
| Terminal-Bench 4.0 | %65.7 | GPT-6 Astra | %58.2 |
| SWE-Marathon | %51.7 | Claude Opus 5.5 | %46.3 |
| Kimi Code Bench 3.0 | %61.2 | GPT-6 Astra | %66.5 |
| BenchCAD with tools | %92.7 | Claude Opus 5.5 | %96.2 |
| OfficeQA Pro v2 | 64.4 | Claude Opus 5.5 | 62.2 |
| Frontier Finance | 58.6 | Claude Opus 5.5 | 56.7 |
| OSWorld 2.1 | %79.6 | Claude Opus 5.5 | %81.8 |
K3.1 Pro, seçili görevlerde bazı önde gelen tescilli modellere yaklaşır veya onları aşar. Ancak her kategoride baskın değildir.
Örneğin, tedarikçi tarafından bildirilen BenchCAD ve OSWorld karşılaştırmalarında Claude Opus 5.5’in gerisinde kalmaya devam eder ve resmi grafik Terminal-Bench Science’ta daha büyük bir zayıflık gösterir.
Değerlendirme kurulumları farklıdır: Artificial Analysis, Terminal-Bench 4.0 için mini-swe-agent test çerçevesini kullanırken Moonshot, Claude Code’u kullanır. Skorları aynı test kurulumunda karşılaştırın; çerçeveler, akıl yürütme çabası ve çalışma süresi sınırları sonuçları etkileyebilir.
Kodlama ve Yazılım Mühendisliği
Karmaşık özerk kodlama için, K3.1 Pro genel olarak daha güçlü bir seçenektir.
Moonshot’ın dahili Kimi Code Bench 3.0 Long-horizon sonuçları K3 için %55.95’ten K3.1 Pro için %61.2’ye yükselir; yaklaşık 5.25 yüzde puanlık bir artış.
Bağımsız Terminal-Bench sonuçları da ciddi bir kazanım gösterir. Bu testler çok adımlı yürütmeyi değerlendirir: bir depoyu anlama, dosyaları değiştirme, komut çalıştırma, hataları teşhis etme ve sonucu doğrulama.
K3.1 Pro, çok dosyalı geliştirme, özerk terminal çalışması ve genişletilmiş hata ayıklama için daha güçlü adaydır. Basit kod üretiminde, her iki modeli de kendi görevleriniz üzerinde karşılaştırın; K3, anında kendi altyapınızda barındırma gerektiğinde geçerli bir seçenektir.
Önemli bir ayrım, kodlama kıyas skorlarının ajan çerçevesine güçlü biçimde bağlı olmasıdır. Araçlar, istemler, çalışma süresi sınırları ve test ortamları sonucu etkiler.
Üretim yazılım geliştirme için en iyi değerlendirme hâlâ kendi depolarınız üzerinde eşleştirilmiş bir karşılaştırmadır.
Finansal Araştırma ve İş Operasyonları
Finansal modelleme, iki model arasında en net doğrudan karşılaştırmalardan bazılarını sunar.
Moonshot, her iki modeli de elektronik tablo oluşturma, araştırma kalitesi ve simüle edilmiş iş operasyonlarını kapsayan dahili değerlendirmelerde test etti.
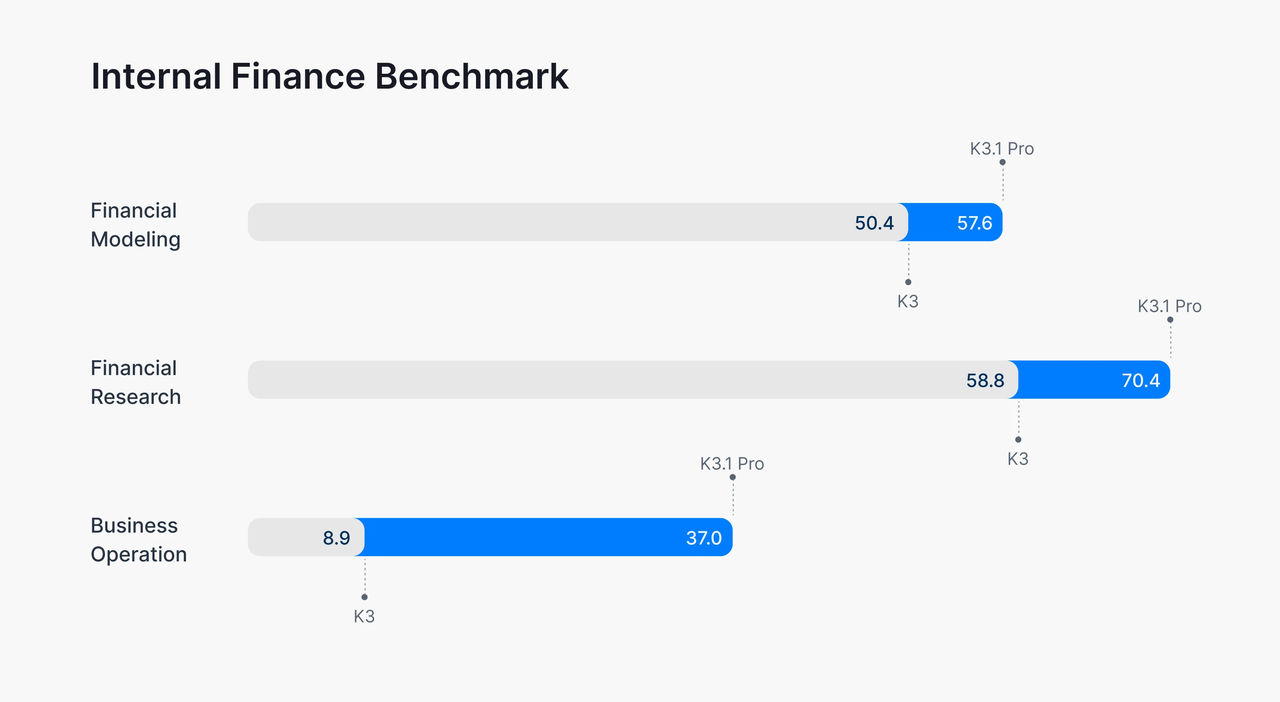
Moonshot’ın dahili finans sonuçları, finansal modelleme, araştırma ve simüle edilmiş iş operasyonlarını kapsar. Bu tedarikçi tarafından raporlanan görev skorları, yatırım getirilerinin ölçütleri değildir. Görev başına ayarlar, ilgisiz kıyaslarla aynı varsayılmamalıdır.
Moonshot’ın dahili testlerinde, Financial Modeling 50.4’ten 57.6’ya çıkarak 7.2 puan kazandı ve Financial Research 58.8’den 70.4’e yükselerek 11.6 puan kazandı. Business Operation 8.9’dan 37.0’a çıktı; bu da K3 skorunun yaklaşık 4.2 katıdır.
Bu kıyas, simüle edilmiş bir iş ortamında uzun ufuklu yönetim ve karar almayı değerlendirir. Bu nedenle, basit finansal soru-cevaplamadan ziyade ajan odaklı planlamayla daha yakından ilişkilidir.
Financial Research, kaynak gerekliliklerine ve bilgi kesim tarihlerine saygı gösterirken kanıta dayalı araştırma üretme yeteneğini ölçer. Financial Modeling, matematiksel ilişkiler, elektronik tablo mantığı ve çalışma kitabı kalitesine odaklanır.
Bu desen, finansal görevler sürdürülebilir akıl yürütme, doğrulama ve yapılandırılmış teslimatlar gerektirdiğinde K3.1 Pro’nun özellikle değerli olduğunu önerir.
Yatırımcılar, analistler ve iş kullanıcıları için pratik fayda, çok belgeli iş akışlarını daha iyi ele alma potansiyelidir. Hiçbir model finansal kararlar için sorgusuz otorite olarak kullanılmamalıdır.
Uzun Bağlam Akıl Yürütme ve Olgusal Güvenilirlik
Bununla birlikte, AA-LCR uzun bağlam sonuçları K3’ün hafifçe önde olduğunu gösterir. Bu, daha yeni bir modelin genel olarak önemli ölçüde iyileşebileceği halde her uzmanlaşmış görevde kazanamayabileceğinin yararlı bir hatırlatıcısıdır.
Raporlanan değerlendirmeler kendi test setlerinde daha az olgusal hata gösterir.
Kimi Hallu Bench Hard with tools üzerinde, Moonshot iddia düzeyi hata oranının K3 için %23.4’ten K3.1 Pro için %8.3’e düştüğünü bildiriyor.
Bu, Moonshot’ın kasıtlı olarak zor stres testi üzerindeki yaklaşık %65’lik göreli azalmadır; günlük hata oranlarının tahmini değildir. Ayrı olarak, Artificial Analysis AA-Omniscience halüsinasyon oranında %53’ten %44’e bir düşüş raporlar. Bu iki değerlendirme farklı yöntemler kullandığından, yüzdeleri doğrudan karşılaştırılamaz.
Pratik ders, K3.1 Pro’nun değerlendirilen görevlerde daha güvenilir göründüğüdür; ancak olgusal iyileştirmeler, sonuç doğuran iş akışlarında alma, atıflar, hesap kontrolü ve insan incelemesi gerekliliğini ortadan kaldırmaz.
Veri Analizi: Plotly’nin Değerlendirmesinden Kanıt
Plotly, OpenRouter üzerinden standart K3.1 Pro’yu, sentetik bir rüzgar enerjisi veri ambarı üzerinde özel 43 soruluk bir testle değerlendirdi. Highspeed test edilmedi. Sonuçlar, o belirli SQL tabanlı analitik iş akışında yanıt kalitesi, tamamlama süresi ve maliyet arasındaki değiş tokuşu gösterir.
| Plotly Veri Analitiği Ölçütü | Kimi K3 | Kimi K3.1 Pro |
|---|---|---|
| Doğru cevaplar | 35/43 | 42/43 |
| Doğruluk | %81.4 | %97.7 |
| Keşfedilen gizli desenler | 0/5 | 5/5 |
| Belirlenen veri kalitesi sorunları | 1/3 | 3/3 |
| Tam değerlendirme maliyeti | $5.01 | $13.47 |
| Soru başına medyan süre | 43 saniye | 2.5 dakika |
Bu değerlendirmede K3.1 Pro daha fazla soruyu doğru yanıtladı ve daha fazla gizli deseni ve veri kalitesi sorununu belirledi; ancak daha yüksek maliyet ve daha uzun medyan tamamlama süresi ortaya çıktı.
Raporlanan ücretler, Moonshot’ın standart API fiyatlarından hesaplanan tahminler değil, gözlemlenen değerlendirme maliyetleridir. Yayınlanan kurulum, iki model çalıştırması arasında tüm sağlayıcı ayarlarının aynı olduğunu kanıtlamaz; bu nedenle farklar yalnızca modele atfedilemez.
Bu sonuçlar, ek bulguların daha fazla zaman ve harcamayı haklı çıkarabileceği analitik görevlerde K3.1 Pro’nun değerlendirilmesini destekler. Aynı doğruluk veya maliyet avantajını kanıtlamaz.
Kimi K3.1 Pro, Kimi K3’ten Daha Hızlı mı?
Çıkış-token verimini uçtan uca görev gecikmesinden ayırın.
Artificial Analysis, Kimi’nin API’sini kullanarak maksimum akıl yürütme çabasında K3.1 Pro için saniyede 73.5 çıkış tokeni, K3 için ise 38.5 bildiriyor. Bunlar 24 Ekim 2026’da kontrol edilen token üretim ölçümleridir; toplam görev gecikmesi ayrıca akıl yürütme uzunluğuna ve araç yürütümüne bağlıdır.
Ancak daha hızlı token üretimi daha hızlı görev tamamlamayı garanti etmez.
Moonshot ayrıca K3.1 Pro Highspeed’i sunuyor ve bunun standart varyanttan yaklaşık iki ila üç kat daha hızlı çıktı verdiğini belirtiyor. Bu, ayrı doğrulanmış bir zekâ yükseltmesi değil, sunum hızı iyileştirmesidir.
K3.1 Pro’nun rapor edilen çıkış-token verimi daha yüksektir, ancak görevleri mutlaka daha hızlı tamamlamaz. Token üretim hızını, akıl yürütme, araç çağrıları ve işi bitirmek için gereken zamandan ayırın.
Çıkış Hızı vs. Görev Tamamlama Süresi
Artificial Analysis, Kimi’nin API’sini kullanarak maksimum akıl yürütme çabasında K3.1 Pro için saniyede 73.5 ve K3 için 38.5 token çıkış hızları bildiriyor. Bu ölçümler, uçtan uca görev gecikmesi yerine token üretim verimini tanımlar ve 24 Ekim 2026’da kontrol edilmiştir.
Bir model daha fazla akıl yürütme tokeni üretiyor veya ek araç çağrıları yapıyorsa, tokenleri daha hızlı ürettiği halde genel olarak daha uzun sürebilir. Yukarıda tartışılan Plotly değerlendirmesinde, K3.1 Pro’nun medyan tamamlama süresi soru başına 2.5 dakikaydı; K3 için 43 saniyeydi ve bu daha yüksek doğrulukla birlikte geldi.
Etkileşimli uygulamalar için, ilk token süresi ve toplam görev tamamlama süresini gerçek sağlayıcı rotasında ölçün. Yalnızca çıkış verimi, tepkiselliği öngörmek için yeterli değildir.
K3.1 Pro Highspeed’i Düşünün
Moonshot, K3.1 Pro Highspeed’in standart K3.1 Pro’ya göre yaklaşık iki ila üç kat çıkış hızı sunduğunu duyurur. Bu iddia sunum hızına ilişkindir; toplam görev tamamlama süresinin iki ila üç kat azalması olarak yorumlanmamalıdır.
Kullanıcıların yanıt beklediği etkileşimli kodlama veya asistanlar için Highspeed’i değerlendirin. Standart uç noktaya karşı uçtan uca gecikme, görev başarısı ve toplam faturalandırılan maliyeti karşılaştırın. Highspeed’in düzenli giriş ve çıkış token fiyatları daha yüksektir; önbelleğe alınmış giriş ücreti aynıdır.
Kimi K3.1 Pro ve Kimi K3: Maliyet
Resmi API ve CometAPI Oranları
Standart K3.1 Pro’nun resmi giriş, çıkış ve önbellek isabet oranları K3’ünkinden üçte bir daha düşüktür. Listelenen CometAPI giriş ve çıkış oranları, karşılık gelen resmi oranlardan ayrıca %20 daha düşüktür.
| Model | Resmi Giriş / 1M | Resmi Çıkış / 1M | Resmi Önbellekli Giriş / 1M | CometAPI Giriş / 1M | CometAPI Çıkış / 1M |
|---|---|---|---|---|---|
| Kimi K3.1 Pro | $2.00 | $10.00 | $0.20 | $1.60 | $8.00 |
| Kimi K3 | $3.00 | $15.00 | $0.30 | $2.40 | $12.00 |
| Kimi K3.1 Pro Highspeed | $4.00 | $20.00 | $0.20 | Güncel fiyatı kontrol edin | Güncel fiyatı kontrol edin |
Milyon token başına USD; oranlar 24 Ekim 2026’da kontrol edilmiştir. Giriş sütunları düzenli önbelleksiz giriş oranlarını gösterir. Vergiler ve ayrı faturalandırılan ücretler hariçtir.
Resmi Kimi fiyatlandırması ayrıca önbelleğe yazma ücretlerini listeler: standart Pro için 5 dakika/1 saat saklama için milyon token başına $2/$4 ve Highspeed için $4/$8. Önbellek isabetleri, önbelleğe yazmalar ve düzenli giriş ayrı, birbirini dışlayan faturalandırma kategorileridir.
Resmi Kimi ve CometAPI ayrı sağlayıcı rotalarıdır. Seçtiğiniz rota için güncel fiyatlandırmayı ve önbellek desteğini, Highspeed kullanılabilirliği dahil, doğrulayın. Yalnızca token oranlarını değil, toplam faturalandırılan görev maliyetini de karşılaştırın.
Sabit Token Maliyet Örneği
100,000 önbelleksiz giriş tokeni ve 20,000 çıkış tokeni tüketen bir iş yükünü düşünün.
Bu sabit iş yükü için resmi API maliyeti K3 ile $0.60, K3.1 Pro ile $0.40’tır. Listelenen CometAPI oranlarında aynı token sayıları sırasıyla $0.48 ve $0.32 tutar. Bu toplamlar yalnızca belirtilen giriş ve çıkış tokenlerini içerir.
Ancak bu sabit token karşılaştırmasıdır. Karmaşık ajan iş akışları, modele bağlı olarak farklı miktarlarda akıl yürütme tokenleri ve araç çağrıları tüketebilir.
Token Tasarrufu Kaybolabilir
I aynı önbelleksiz giriş tokeni sayısı, O Kimi K3’ün faturalandırılan çıkış tokeni sayısı ve P Kimi K3.1 Pro’nun faturalandırılan çıkış tokeni sayısı olsun; hepsi milyon olarak ölçülsün. Fiyatlandırma tablosundaki standart resmi oranlarda ücretler sırasıyla 3I + 15O ve 2I + 10P dolardır. P = 1.5O + 0.1I olduğunda eşittirler.
Çıkış ağırlıklı isteklerde, K3.1 Pro bu nedenle fiyat avantajını kaybetmeden yaklaşık %50 daha fazla faturalandırılan çıkış tokeni kullanabilir. Bu hesaplama değişmeyen oranları varsayar ve önbellekleme, araç ücretleri ve diğer ayrı ücretlendirmeleri dışlar. Görünür yanıt uzunluğu yerine fiili faturalandırılan token kategorilerini kullanın.
Başarıyla Tamamlanan Görev Başına Maliyet
Başarıyla tamamlanan görev başına maliyeti, tüm değerlendirme denemelerinin toplam faturalandırılan maliyetinin, önceden tanımlanmış bir kabul kriterini karşılayan benzersiz görev sayısına bölünmesi olarak hesaplayın. Sağlayıcının faturalandırdığı başarısız denemelerden, yeniden denemelerden ve zaman aşımlarından kaynaklanan ücretleri dahil edin; yalnızca başarılı çalıştırmaların maliyetini sayıp bunu sayısına bölmek, başarı başına maliyeti olduğundan düşük gösterebilir.
Görev setini, kabul kriterlerini, yeniden deneme limitini ve zaman aşımı politikasını Kimi K3 ve K3.1 Pro arasında sabit tutun. Zor görevlerin düşürülmesinin bir modeli yapay olarak ekonomik gösterememesi için başarı oranını, başarı başına maliyetle birlikte raporlayın. Hiçbir görev başarılı değilse, başarı başına maliyet tanımsızdır, sıfır değil.
Kimi K3.1 Pro ve Kimi K3: Karşılaştırma ve Seçim
Çoğu barındırılan ajan odaklı iş yükü için K3.1 Pro daha güçlü bir başlangıç noktasıdır. Yine de karar, görev karmaşıklığını ve dağıtım gereksinimlerini yansıtmalıdır.
| Kullanım Durumu | Önerilen Model | Gerekçe |
|---|---|---|
| Özerk kodlama | Kimi K3.1 Pro | Çok dosyalı değişiklikler, terminal çalışması, hata ayıklama ve nihai test sonuçlarını değerlendirin. |
| Çok belgeli finansal araştırma | Kimi K3.1 Pro | Gelişmiş araştırma ve iş operasyonu kıyasları |
| Karmaşık veri analizi | Kimi K3.1 Pro | Daha iyi sorun keşfi ve veri kalitesi testleri |
| 3B oluşturma ve CAD iş akışları | Kimi K3.1 Pro | Güçlü uzmanlaşmış araç destekli yetenekler |
| Basit metin görevleri | Her ikisini kıyaslayın | Rutin metin ve basit kodlama görevlerini iki modelde de karşılaştırın; ek akıl yürütme, kabul edilebilir sonucu iyileştirmeden gecikme ekleyebilir. |
| Uzun bağlam alma doğruluğu | Her ikisini kıyaslayın | K3, AA-LCR’de hafifçe önde |
| Hemen kendi altyapınızda barındırma | Kimi K3 | İndirilebilir ağırlıklar zaten mevcut |
| Etkileşimli yüksek kapasiteli ajanlar | K3.1 Pro Highspeed | Daha hızlı sunum, maliyet doğrulamasına tabidir |
| Maliyet duyarlı üretim iş akışları | Her ikisini kıyaslayın | Daha düşük token fiyatlandırması daha düşük görev maliyeti anlamına gelmeyebilir |
Barındırılan Otomasyon ve Profesyonel İş Akışları
Barındırılan kodlama ajanları ve analitik iş akışları için, K3.1 Pro’yu işin zor kısımlarında değerlendirin: çok dosyalı değişiklikler, kanıt toplama, hesap kontrolü ve başarısız bir araç çağrısından sonra toparlanma. Yalnızca daha yüksek bir başlık skorundan ziyade, başarısız görevlerde veya düzeltici çalışmada ölçülen azalmaları tercih edin.
Yerleşik K3 uygulamaları için mevcut rotayı karşılaştırma temeli olarak koruyun. Rutin görevler halihazırda kabul eşiğini karşılıyor olabilir; uzmanlaşmış uzun bağlam görevleri, toplu kıyaslardan farklı davranabilir. Yükseltmenin ölçülebilir fayda sağladığı iş yükü segmentlerine öncelik verin.
Kendi Altyapınızda Barındırma ve Dağıtım Kısıtları
24 Ekim 2026 itibarıyla, K3’ün tam ağırlıkları model lisansı ve donanım gereksinimlerine tabi olarak dağıtım için mevcuttur. K3.1 Pro’nun tam ağırlıkları henüz yayımlanmamıştır.
Moonshot, K3.1 Pro ağırlıklarını 4 Kasım 2026’ya kadar yayımlamayı planlıyor. Bu, mevcut bir kontrol noktası değil, duyurulmuş bir yayın planıdır; kendi altyapınızda barındırmayı planlamadan önce yayımlanan ağırlıkları ve geçerli koşulları doğrulayın.
Üretim Değerlendirme Kriterleri
Aynı istemleri, araçları, kabul kriterlerini, yeniden deneme limitlerini ve zaman aşımlarını kullanarak K3 ve K3.1 Pro’yu temsilî görevlerde karşılaştırın. Sağlayıcı ve akıl yürütme ayarlarını kaydedin ve API’nin gerektirdiği şekilde eksiksiz asistan mesajlarını koruyun.
Görev başarısını, gecikmeyi, token kullanımını ve başarı başına maliyeti ölçün; faturalandırılan başarısızlıklar ve yeniden denemeler dahil. K3’ün başarılı olduğu, ancak K3.1 Pro’nun başarısız olduğu vakaları gözden geçirin. İnsan değerlendirmesi için, model etiketlerini gizleyin ve çıktı sırasını rastgeleleştirin.
K3.1 Pro kalite, gecikme ve maliyet eşiklerinizi karşılıyorsa, test edilmiş bir K3 geri dönüş (fallback) ile kademeli olarak yayına alın.
Kontrollü Geçiş ve Geri Dönüşler
Pratik bir yaklaşım, üretim trafiğinin küçük bir yüzdesiyle K3.1 Pro’da başlamaktır.
Doğrulama sırasında K3’ü geri dönüş olarak kullanılabilir tutun. K3.1 Pro kullanımını artırmadan önce görev kalitesi, gecikme, hata oranları ve harcamaları karşılaştırın.
Araç çağrısı şemalarına, akıl yürütme ile ilgili mesaj alanlarına, çok modlu girdilere ve çıktı ayrıştırmasına özel dikkat gösterin. API uyumluluğu, otomatik olarak aynı uygulama davranışını garanti etmez.
Kıyas Kazanımları ve Gerilemeler
Her iki model de aynı 43 soruyu yanıtlayıp 35 ve 42 skorlarını aldıysa, K3.1 Pro gerileme olmadan K3’ün yedi hatasını düzeltebilir veya bir önceki doğru cevabı kaybederken sekiz hatayı düzeltebilir. Toplam skor tek başına bu sonuçları ayırt edemez.
Eşleştirilmiş yanıtları inceleyin ve her ikisi doğru, yalnızca K3 doğru, yalnızca K3.1 Pro doğru veya her ikisi yanlış olarak sınıflandırın. Geçişten önce en yüksek etkili görevlerinizde K3’e özgü başarıları gözden geçirin. 42/43 sonucu o test setini açıklar; farklı bir iş yükünde %97.7 başarı oranını garanti etmez.
Model Çıktılarının Kör Değerlendirmesi
Model etiketlerini gizleyin ve değerlendiricilerin çıktıları görme sırasını rastgeleleştirin. Değerlendirme öncesinde kabul rubriğini tanımlayın: kod için çalıştırılabilir testler ve regresyon kontrollerini; araştırma için kaynak desteği, hesaplamalar ve istenen teslimatın tam olup olmadığını kullanın. Sunumu veya yazım stilini dikkate almadan önce doğruluğu puanlayın.
Kalite değerlendirmesi kaydedildikten sonra model kimliğini, gecikmeyi ve faturalandırılan maliyeti açıklayın. Bu, çıktı kalitesini daha yeni modele dair beklentilerden ayırır. Değerlendirici anlaşmazlıklarını aynı testlere veya kaynak malzemeye göre çözün ve kararları saklayın ki daha sonraki bir model veya istem değişikliğini tutarlı şekilde değerlendirebilesiniz.
Kimi K3.1 Pro ve Kimi K3’e Nereden Erişebilirsiniz?
Resmi Sağlayıcı Erişimi
Doğrudan sağlayıcı entegrasyonu için Moonshot’ın belgelenmiş Kimi K3 API’sini veya Kimi K3.1 Pro API’sini kullanın. Seçilen uç noktanın model tanımlayıcısını, desteklenen istek alanlarını ve hesap limitlerini kontrol edin. Genel API erişimi ve indirilebilir model ağırlıkları, ayrı dağıtım seçenekleridir.
CometAPI Üzerinden Erişim
Geliştiriciler, CometAPI’nin birleşik arayüzü üzerinden Kimi K3.1 Pro API’sine ve Kimi K3 API’sine erişebilir ve her iki rotayı da aynı uygulama iş yüküyle karşılaştırabilir.
Bu, özellikle halihazırda OpenAI uyumlu bir sohbet arayüzü kullanan uygulamalar için K3’ten K3.1 Pro’ya geçişi nispeten kolaylaştırır.
CometAPI’yi kullanmak için bir hesap ve API anahtarı oluşturun, ardından uygulamanızı entegrasyon dokümantasyonundaki uç nokta ve model tanımlayıcısıyla yapılandırın. K3 için kimi-k3, standart K3.1 Pro için kimi-k3.1-pro veya desteklenen yerlerde Highspeed rotası için kimi-k3.1-pro-highspeed seçin. Küçük bir istekle başlayın, ardından dönen sonuçları, gecikmeyi ve faturalandırılan kullanımı kontrol ederken aynı iş yükünü modeller arasında karşılaştırın.
Sonuç
Bu incelemede değerlendirilen koşullarda Kimi K3.1 Pro, zorlu özerk kodlama, finansal araştırma ve genişletilmiş ajan iş akışları için daha güçlü adaydır. Kimi K3, derhal kendi altyapınızda barındırma ve mevcut doğruluk veya gecikme profili gereksinimleri karşılayan iş yükleri için geçerliliğini korur.
Temsili görevler ve fiili sağlayıcı rotasıyla seçim yapın. Başarılı çıktıları, gecikmeyi ve toplam harcamayı karşılaştırın, ardından kademeli olarak geçiş yapın. Daha düşük token fiyatları ve daha yüksek toplu kıyas skorları yararlı başlangıç noktalarıdır; ancak her uygulama için en iyi yapılandırmayı otomatik olarak belirlemezler.