

TL;DR
MiMo-V2.5 çok modlu işler, rutin ajanlar ve maliyet duyarlı üretim için daha güçlü varsayılandır. MiMo-V2.5-Pro zor akıl yürütme, depo ölçeğinde kodlama ve uzun süreli araç kullanımı için uzmanlaşmış seçenektir. Her ikisi de 1M-belirteç bağlam penceresi ve 128K’ya kadar çıktı belirteçleri sunar, ancak Pro sıradan giriş ve çıkış belirteçlerinde yaklaşık 3.1× daha pahalı olan çok daha büyük bir dil omurgası kullanır.
MiMo-V2.5 vs. Pro: Hızlı Karar
| Specification — official release | MiMo-V2.5 | MiMo-V2.5-Pro | Recommended model | Reason |
|---|---|---|---|---|
| Primary positioning | Omni-modal model and efficient agents | Flagship agent and complex coding | Choose by workload | Omni-modal inputs favor V2.5; sustained difficult text work favors Pro. |
| Architecture | Sparse MoE | Sparse MoE | Choose by workload | Model size alone does not establish a better choice for every task. |
| Total parameters | 310B | 1.02T | Choose by workload | The larger model targets difficult reasoning, but total size is not a task outcome. |
| Activated parameters | 15B | 42B | Choose by workload | Use task completion and cost to decide. |
| LLM layers | 48 | 70 | Choose by workload | Layer count describes architecture, not a universal win. |
| Routed experts | 256 | 384 | Choose by workload | The difference matters only if it improves the target workload. |
| Experts activated per token | 8 | 8 | Either | Both activate eight experts per token. |
| Context window | 1M tokens | 1M tokens | Either | Both advertise a 1M-token window; test effective retrieval. |
| Maximum output | 128K tokens | 128K tokens | Either | Both advertise up to 128K output tokens. |
| Input modalities | Text, image, video, and audio | Text | MiMo-V2.5 | It accepts image, video, and audio input; Pro is text-input focused. |
| Tool calling | Yes | Yes | Choose by workload | Both call tools; test success rate on the actual trajectory. |
| Open weights and license | Yes; MIT | Yes; MIT | Either | Both offer open weights under MIT; serving costs differ. |
Belirleyici Fark: Çok Modlu vs Ajan-Öncelikli
V2.5 yerel olarak metin, görüntü, video ve ses kabul eder. Xiaomi, dil omurgasını 729M parametreli bir görsel kodlayıcı ve 261M parametreli bir ses kodlayıcı ile eşleştirerek çok modlu bilgilerin aynı akıl yürütme iş akışına doğrudan katılmasını sağlar.
- Araç çağırmadan önce ekran görüntülerini analiz edin.
- Bir videoyu ve ses parçasını birlikte anlayın.
- Diyagramlardan ve belge görüntülerinden bilgi çıkarın.
- Görsel arayüz ve çok modlu destek ajanlarını işletin.
- Uzun video dizileri üzerinde akıl yürütün.
V2.5-Pro farklı bir tasarımı izler. Xiaomi şu anda girdi modunu metin olarak belirtir ve derin akıl yürütme, kod geliştirme ve uzun süreli araç orkestrasyonunu vurgular.
İş akışının kendisi görüntü, video veya ses girdisi içeriyorsa V2.5 ile başlayın. Zorlayıcı kısım metin, kaynak kod, araçlar veya uzun bir ajan yörüngesi üzerinde akıl yürütmek olduğunda Pro’yu test edin.

Resmi Xiaomi çok modlu kıyaslama karşılaştırması.
V2.5-Pro Zor Görevlerde Neden Daha İyi Olabilir
Model Ölçeği: 310B/15B vs. 1.02T/42B
Her iki model de seyrek Uzman Karışımı (MoE) omurgaları, hibrit kaydırmalı pencere ve küresel dikkat ile üç Multi-Token Prediction modülü kullanır. Xiaomi’nin V2.5 model kartı, 310B toplam, 15B aktif bir omurgayı belgeliyor; Pro model kartı bunu 1.02T toplam parametreye ve belirteç başına 42B etkin parametreye ölçekler.
| Architecture — official model card | V2.5 | Pro | Difference |
|---|---|---|---|
| Total parameters | 310B | 1.02T | About 3.3× |
| Active parameters | 15B | 42B | 2.8× |
| Hidden size | 4,096 | 6,144 | 1.5× |
| LLM layers | 48 | 70 | 22 more |
| Attention heads | 64 | 128 | 2× |
| Routed experts | 256 | 384 | 1.5× |
| Experts per token | 8 | 8 | Same |
| MTP layers | 3 | 3 | Same |
V2.5 bir 5:1 dikkat kalıbı kullanırken Pro 6:1 yerel-küresel kalıbına geçer. Xiaomi, bu tasarımların, ağ genelinde tam dikkatle karşılaştırıldığında KV önbelleği gereksinimlerini sırasıyla yaklaşık 6× ve 7× azalttığını söylüyor.
Toplam parametreler yanıt kalitesine doğrusal olarak dönüşmez. Pro’nun daha büyük omurgası en çok akıl yürütme zorluğu veya yörünge uzunluğu küçük adım başına güvenilirlik artışlarının bileşik etkisini doğurduğunda önem kazanır.
Küçük Güvenilirlik Artışları Neden Bileşik Etki Yapar
Uzun bir ajan görevi birçok bağımlı adımdan oluşur. Erken bir araç çağrısındaki hata yeniden denemeleri zorunlu kılabilir veya sonraki çalışmaları geçersiz kılabilir; bu nedenle adım başına mütevazı bir güvenilirlik artışı uçtan uca tamamlama üzerinde daha büyük bir etkiye sahip olabilir. Model boyutunun bunu garanti ettiğini varsaymak yerine temsili görevlerde bu etkiyi değerlendirin.
V2.5-Pro Gerçekte Nerede İyileşiyor?
En temiz sayısal karşılaştırma, her iki modelin de aynı ayarlar altında göründüğü Xiaomi’nin temel model değerlendirmesidir. Bu, ilgisiz çerçeveler veya eğitim sonrası yapılandırmalar tarafından üretilen sonuçları birleştirmeyi önler.
Genel Bilgi: Küçükten Orta Seviye Kazançlara
Xiaomi’nin temel model karşılaştırmasında Pro, BBH’de 1.2, MMLU’da 3.1 ve MMLU-Pro’da 2.7 puan kazanır. Bunlar ölçülebilir, ancak daha zor akıl yürütme görevlerindeki kazançlarından daha küçüktür.
Matematik ve Bilim: Daha Büyük Kazançlar
Aynı temel model değerlendirmesinde Pro, GPQA-Diamond’da 8.6, GSM8K’de 16.3 ve MATH’te 18.5 puan kazanır. Bu, zor akıl yürütmenin görev başarısını belirlediği durumlarda Pro’yu seçmek için en net kanıttır.
Kodlama: Daha İyi, Ancak Her Zaman Değil
Bildirilmiş kazançlar HumanEval+’ta 4.3, MBPP+’ta 3.2, LiveCodeBench v6’da 4.1 ve SWE-Bench AgentLess’te 4.9 puandır. Depo düzeyi görevleri ve araç kullanımını ayrı ayrı test edin: bu temel model skorları her üretim ajan iş akışını ölçmez.
Kıyas sonucu: Pro, yaklaşık üç kat daha pahalı olduğu için üç kat daha iyi değildir. Akıl yürütme zorluğu ve görev süresi arttıkça kademeli olarak daha değerli hale gelir.
Bu satırlar temel model değerlendirmeleridir; bir üretim API’sinin aynı skorları yeniden üreteceğine dair bir vaat değildir. Ajan sonuçları araçlara, istemlere, yeniden denemelere, yürütme ortamına ve belirteç bütçelerine bağlıdır.
Eğitim Sonrası ve Uzun Süreli Ajanlar
Üretim modelleri, gözetimli ince ayar, ajanik pekiştirmeli öğrenme ve Multi-Teacher On-Policy Distillation ekler. Xiaomi, V2.5 için eğitim sonrası skorlar olarak SWE-bench Pro’da 56.1, Terminal-Bench 2.0’da 65.8 ve Claw-Eval’in genel bölümünde 62.1 Pass³ bildiriyor.
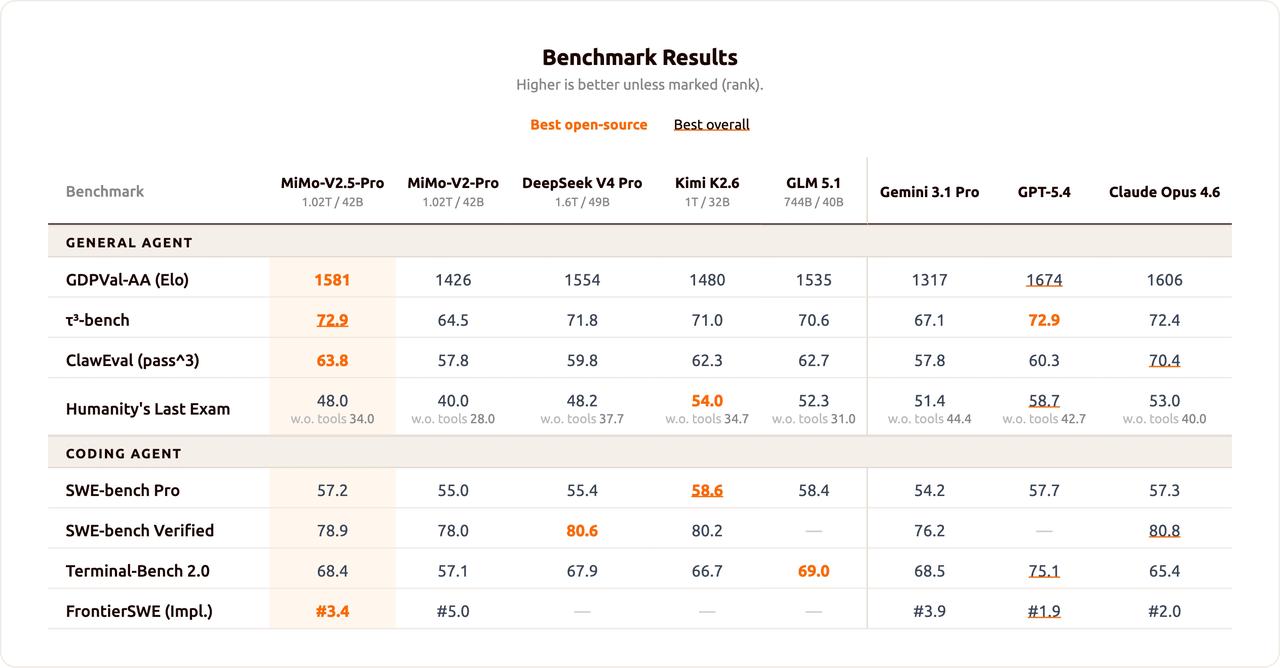
Pro, uzun süreli yazılım mühendisliği için daha açıkça optimize edilmiştir. Xiaomi, yüzlerce araç çağrısını içeren sürdürülen yörüngeleri vurgular ve 78.9% SWE-bench Verified sonucu yayınlar.
Resmi bir vaka çalışması, Pro’nun 4.3 saatte 672 araç çağrısı ile tüm 233 testin geçtiği bir SysY derleyicisini tamamladığını gösteriyor. Buradan çıkarılacak ders, her kodlama talebinin Pro’ya ihtiyaç duyduğu değil; yüzlerce bağımlı eylem içeren bir iş akışının tamamlanıp tamamlanmayacağını küçük güvenilirlik farklarının belirleyebileceğidir.

Resmi Xiaomi kodlama ve ajan kıyaslama grafiği.
Uzun Bağlam: Aynı Kapasite, Farklı İş Yükleri
Her iki model de Xiaomi’nin mevcut API’si üzerinden 1M-belirteç bağlam penceresi ve 128K’ya kadar çıktı belirteçleri sağlar. Ham bağlam boyutu bu nedenle onları ayırmaz.
V2.5, uzun bağlamın video, belge görüntüleri veya görsel ajan izleri gibi çok modlu materyal içermesi durumunda caziptir. Bağlamın kendisi akıl yürütme problemine dönüştüğünde: büyük bir depo, uzun bir sözleşme, bir araştırma korpusu veya çok sayıda ardışık eylem içeren bir ajan yörüngesi, test edilmesi gereken model Pro’dur.
Büyük bir bağlam penceresi kapasiteyi açıklar, garantili akıl yürütme sadakatini değil. Uygulama için önemli uzunluklarda alınabilirliği, talimat tutulumunu ve kanıt kullanımını değerlendirin.
Fiyat ve Maliyet Verimliliği
Xiaomi’nin yurtdışı kullandıkça öde fiyatları değiş tokuşu netleştirir.
| Pricing — official price sheet | V2.5 | Pro | Ratio |
|---|---|---|---|
| Uncached input per 1M tokens | $0.14 | $0.435 | 3.11× |
| Cached input per 1M tokens | $0.0028 | $0.0036 | 1.29× |
| Output per 1M tokens | $0.28 | $0.87 | 3.11× |
| Context window | 1M | 1M | Same |
| Maximum output | 128K | 128K | Same |
1M önbelleksiz giriş belirteci ve 200K çıktı belirteci içeren bir isteğin tahmini maliyeti, önbellek isabetleri, web arama ücretleri veya sağlayıcıya özgü faturalama öncesinde V2.5’te $0.196 ve Pro’da $0.609’dur.
Önbellek fiyat farkı daha küçüktür: Pro, önbellek isabetli girdi için yaklaşık %29 daha pahalıdır; standart belirteçlerdeki %211’den değildir. Sabit sistem istemleri, araç tanımları veya depo ön ekleri bulunan uzun süreli ajanlar bu nedenle gerçek önbellek isabet oranlarını ölçmelidir.
Başarılı görev başına maliyeti tahmin edin. Zor bir iş akışını bir kerede tamamlayan bir Pro ajanı, daha ucuz bir modelde yinelenen başarısız denemelerden daha az maliyetli olabilir.
Hangi Modeli Kullanmalısınız?
| Workload — official guidance | Better choice | Why |
|---|---|---|
| Routine text chat | V2.5 | Lower cost; Pro often unnecessary |
| High-volume generation | V2.5 | About 3.1× lower standard token price |
| Image, video, or audio understanding | V2.5 | Native multimodal input |
| Routine tool calling | V2.5 | Strong agent capability at lower cost |
| Difficult mathematics and science | Pro | Larger benchmark gains |
| Repository-scale coding | Pro | Designed for complex software engineering |
| Hundreds of dependent tool calls | Pro | Better fit for sustained execution |
| Cost-sensitive 1M context | V2.5 | Same nominal context at much lower cost |
Seçim sonucu: V2.5, çok modlu uygulamalar, rutin ajanlar ve maliyet duyarlı iş yükleri için varsayılandır. Pro, zor akıl yürütme, karmaşık yazılım mühendisliği ve uzun özerk yörüngeler için yükseltmedir.
Daha İyi Bir Üretim Stratejisi: İkisi Arasında Yönlendirme
Tek bir küresel model seçimi çoğu zaman gereksizdir. Çok modlu ve rutin istekleri V2.5’e yönlendirin, ardından yalnızca zor metin akıl yürütmesi, karmaşık kodlama veya uzun süreli yürütme taleplerini Pro’ya yükseltin.
| Evaluation dimension | Measure | Why it matters | Routing signal |
|---|---|---|---|
| Completion | Successful tasks / attempts | Captures end-to-end reliability | Escalate low-completion classes |
| Quality | Human or rubric score | Prevents token cost from dominating | Escalate high-stakes tasks |
| Tool reliability | Errors and retries | Small errors compound in agents | Escalate long trajectories |
| Latency | Time to accepted result | Includes retry overhead | Keep interactive tasks lightweight |
| Cost | Spend per accepted task | Reflects failures and reruns | Use the cheapest model that succeeds |
CometAPI’de Her İki API’yi de Test Edin
MiMo-V2.5 API CometAPI’de ve MiMo-V2.5-Pro API CometAPI’de, tek bir toplama katmanı üzerinden yan yana değerlendirmeyi destekler. Aynı istemleri, sistem talimatlarını, araçları ve çıktı sınırlarını her iki modele de gönderin, ardından görev başarısı ve maliyeti karşılaştırın.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

models = ["mimo-v2.5", "mimo-v2.5-pro"]
prompt = """
Review this implementation plan.
Identify hidden technical risks and propose the three highest-priority fixes.
"""

for model in models:
    response = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        max_tokens=2000,
    )
    print(f"\n--- {model} ---")
    print(response.choices[0].message.content)
Düz isteklerden, zor akıl yürütmeden, kod düzenlemeden, uzun bağlam görevlerinden ve ajan araç çağrılarından oluşan temsili bir parti çalıştırın. Tamamlama oranını, belirteçleri, gecikmeyi, araç hatalarını, yeniden denemeleri, yanıt kalitesini ve başarılı görev başına maliyeti kaydedin.
Sınırlamalar
V2.5 sınırlamaları
Daha küçük dil omurgası, akıl yürütme zorluğu arttıkça performansı sınırlı bırakır. Boşluk BBH’de mütevazıdır, ancak GPQA-Diamond ve MATH’te çok daha büyür. 1M-belirteç bağlam penceresi de garantili 1M-belirteç akıl yürütme sadakatiyle karıştırılmamalıdır.
Pro sınırlamaları
Pro’nun standart giriş ve çıkış fiyatları V2.5’inkilerin yaklaşık 3.1×’idir ve yalnızca metin girişi, onu çok modlu uygulamalar için birebir bir yedek olmaktan çıkarır. 1.02T-parametreli açık ağırlık modeli, belirteç başına 42B parametre etkinleştirilmesine rağmen kendi kendine barındırma açısından da talepkardır.
Nihai Karar
Çok modlu uygulamalar, rutin ajanlar ve maliyet duyarlı üretim için V2.5’i seçin. Zor akıl yürütme, karmaşık yazılım mühendisliği ve uzun süreli özerk ajanlar için Pro’yu seçin. Karma iş yüklerinde, trafiğin çoğunu V2.5’e yönlendirin ve yalnızca zorluk düzeyi veya yörünge uzunluğu ek maliyeti haklı çıkaran istekleri Pro’ya yükseltin.
SSS
Pro her zaman V2.5’ten daha mı iyi?
Hayır. Pro, zor metin akıl yürütmesi ve kodlama üzerinde daha güçlüdür; ancak V2.5 görüntü, video ve ses girişini destekler ve önemli ölçüde daha ucuzdur.
Her iki model de 1M-belirteç bağlam penceresini destekliyor mu?
Evet. Her ikisi de 1M belirteçlik bağlamı ve 128K’ya kadar çıktı belirteçlerini duyurur. Uygulamalar yine de kendi gerçek çalışma uzunluklarında alınabilirliği ve akıl yürütmeyi test etmelidir.
Çok modlu bir ajan hangi modeli kullanmalı?
V2.5 ile başlayın çünkü yerel olarak görsel ve sesli girişi kabul eder. Pro şu anda metin girdi iş akışlarını hedefler.
Pro daha yüksek fiyatına ne zaman değer?
Daha iyi akıl yürütme güvenilirliğinin zor matematik, depo ölçeğinde kodlama veya çok sayıda bağımlı araç çağrısı içeren uzun yörüngelerin tamamlanmasını etkilediği durumlarda en savunulabilir olandır.
Üretim sistemleri yalnızca bir model mi kullanmalı?
Gerekli değil. Bir yönlendirme katmanı, rutin ve çok modlu çalışmayı V2.5’te tutarken, zor metin ve ajan görevlerini Pro’ya yükseltebilir.