CometAPI ile geliştirinBirden çok model için tek bir API mi gerekiyor?İş akışını Playground'da test edin, ardından model ve maliyet kullanım senaryonuza uyduğunda bir API anahtarı oluşturun.
Gemini 4 Carbon Nedir? Kıyaslamalar, Özellikler & Fiyatlandırma
Google’ın yeni en ileri düzey yapay zekâ modeli Gemini 4 Carbon’u keşfedin. Siber güvenlik kıyaslamaları, özellikler, fiyatlandırma, karşılaştırmalar ve kullanılabilirliği keşfedin.
Gemini 4 Carbon, zorlu mühendislik ve savunmacı siber güvenlik için Google DeepMind’in öncü modelidir. 28 Ekim 2026’da duyurulan model, yayınlanmış kodlama, güvenlik ve uzun bağlam değerlendirmelerinde Argon’a göre ilerleme gösteriyor. Giriş fiyatları milyon başına $2 giriş belirteci ve milyon başına $10 çıkış belirteci; ancak erişim başlangıçta seçili siber savunucular ve güvenilir ortaklarla sınırlı. Geliştiriciler için fırsat daha güçlü otonom çalışmadır; anlık kısıt ise erişimdir.
Öne Çıkanlar
Gemini 4 Carbon, Argon’dan sonra Google’ın bir sonraki öncü modeli olup, günler süren kesintisiz ajan temelli mühendislik ve siber güvenlik savunması için optimize edilmiştir.
Gemini 4 Carbon, Artificial Analysis Intelligence Index v5.0’da #1 (puan 59) sırada yer alır; Claude Opus 5.5 (58) ve GPT-6 Astra (57) önündedir. Kodlama, tam yığın web geliştirme (WebDev Arena’da +89 Elo ile #4), bilimsel akıl yürütme, çoklu mod anlama ve uyum (Gray Swan Indirect Prompt Injection Benchmark’ta 0.0% başarı) alanlarında güçlü artışlar.
Netlik, kaynak ataması ve güncel API terminolojisi açısından gözden geçirildi.
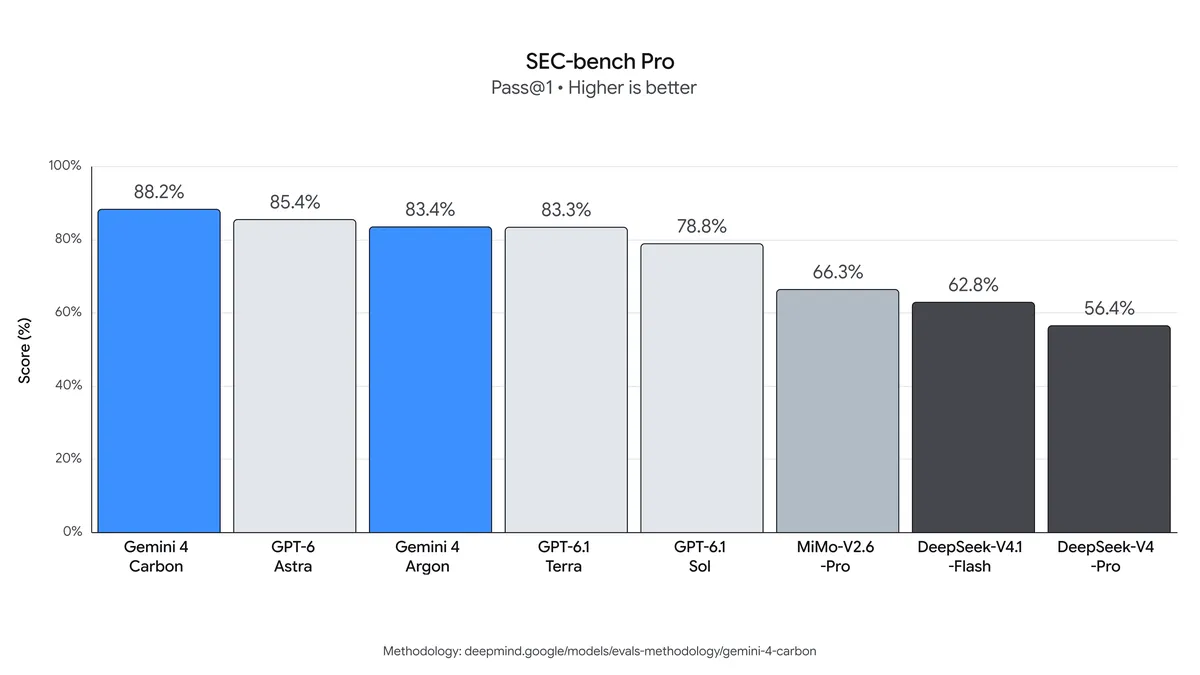
Öne çıkan siber güvenlik puanları (korumalar olmadan): SEC-bench Pro’da 88.2% (güvenlik açığı bulma), ExploitGym’de 54.8% (istismar), CWE-bench’te 71.0% (yama/onarım).
Başlangıçta Fairwind Program aracılığıyla siber savunuculara sınırlı erişim; genel API ve daha geniş sunum daha sonra geliyor.
Argon ile aynı giriş fiyatları; giriş dönemi sonrası standart tarifeler geçerli.
CometAPI gibi platformlar, birleşik OpenAI uyumlu API üzerinden halihazırda daha geniş Gemini ailesini (Argon dâhil) destekliyor; bu da modelleri değiştirmeyi ve Carbon’un daha geniş sunumuna hazırlanmayı kolaylaştırıyor. 29 Ekim 2026 itibarıyla genel API ayrıntıları ve geniş sunum tarihi açıklanmış değil.
Gemini 4 Carbon Nedir?
Gemini 4 Carbon, karmaşık yazılım mühendisliği, siber güvenlik araştırmaları ve otonom iş akışlarını yönetmek için tasarlanmış Google’ın en yeni amiral gemisi öncü yapay zeka modelidir.
resmi duyuru’ya göre Carbon, Gemini 4 Argon ile kurulan temelin üzerine inşa edilir; kodlama, ajan temelli akıl yürütme ve güvenlik odaklı görevlerde kayda değer iyileştirmeler sunar.
Carbon, birden çok adımda araştırma, yürütme ve doğrulamayı içeren çalışmalara yönelik tasarlanmıştır. Savunmacı bir mühendislik ajanı bir depoyu inceleyebilir, izole bir ortamda şüpheli bir güvenlik açığını doğrulayabilir, bir yama geliştirebilir ve değişikliğin özgün kusuru giderip gidermediğini test edebilir.
Google, dahili ekiplerinin Carbon’un çok gün süren karmaşık mühendislik görevlerini yerine getirdiğini gözlemlediğini bildiriyor. Bunlar, belirli bir otonom çalışma süresi için yayımlanmış bir garanti değil, dahili gözlemlerdir. Google, kapsamlı teknik rapor, parametre sayısı veya ayrıntılı mimari bilgileri yayımlamadı. Bağlam penceresi ve çıktılar için sınırların Argon’a benzer veya daha iyi olması bekleniyor (çok milyon belirteç aralığında yüksek çıktı kapasitesiyle); metin, görseller, video, ses ve PDF’ler dâhil çoklu mod girdilerini destekler.
Gemini 4 Carbon’un Temel Özellikleri Nelerdir?
Uzun Vadeli Yazılım Mühendisliği
Carbon, tek bir akıl yürütme adımında güvenilir şekilde tamamlanamayan mühendislik sorunları için tasarlanmıştır.
Örnekler arasında büyük depolarda kök neden analizi, bağımlılıklara bağlı hatalar, düşük seviyeli sistem hata ayıklama ve karmaşık yeniden düzenleme yer alır.
İyileştirmeleri, başarısız bir denemeden sonra çalışmaya devam edebilme yetisini hedefler.
Etkin bir kodlama ajanı, ilk çözümünün başarısız olduğunu fark etmeli, yeni kanıtları incelemeli ve özgün görevden uzaklaşmadan yaklaşımını revize etmelidir.
Savunmacı Siber Güvenlik İş Akışları
Carbon’un güvenlik sonuçları; güvenlik açıklarını bulma, istismar edilebilirliği doğrulama ve kusurları yamalama aşamalarını kapsar. Bir güvenlik ekibi için yararlı soru, ajanın izin verilen çevre ve izinlere saygı göstererek, şüpheli bir sorundan yeniden üretilebilir bir bulguya ve test edilmiş bir düzeltmeye geçip geçemeyeceğidir.
Uzun Bağlam ve Çoklu Mod Anlama
Carbon, 256K–1M belirteç altkümesinde GraphWalks BFS F1 skorunda 96.2% kaydeder; Argon’un 84.2% değerine göre artış. Bu, herhangi bir milyon belirteçlik belgeden doğru geri getirme garantisi değil, uzun bağlam graf akıl yürütmesine dair bir kanıttır.
Yayımlanan Chartography ve Blueprint-Bench 2 sonuçları görsel anlamayı da kapsar. Bu testler, belgeler ve grafikler için umut verici iş akışlarını belirlemeye yardımcı olabilir; ancak gelecekteki bir genel API’nin tam modalite şemasını ortaya koymaz.
Gemini 4 Carbon Ölçütlerde Nasıl Performans Gösteriyor?
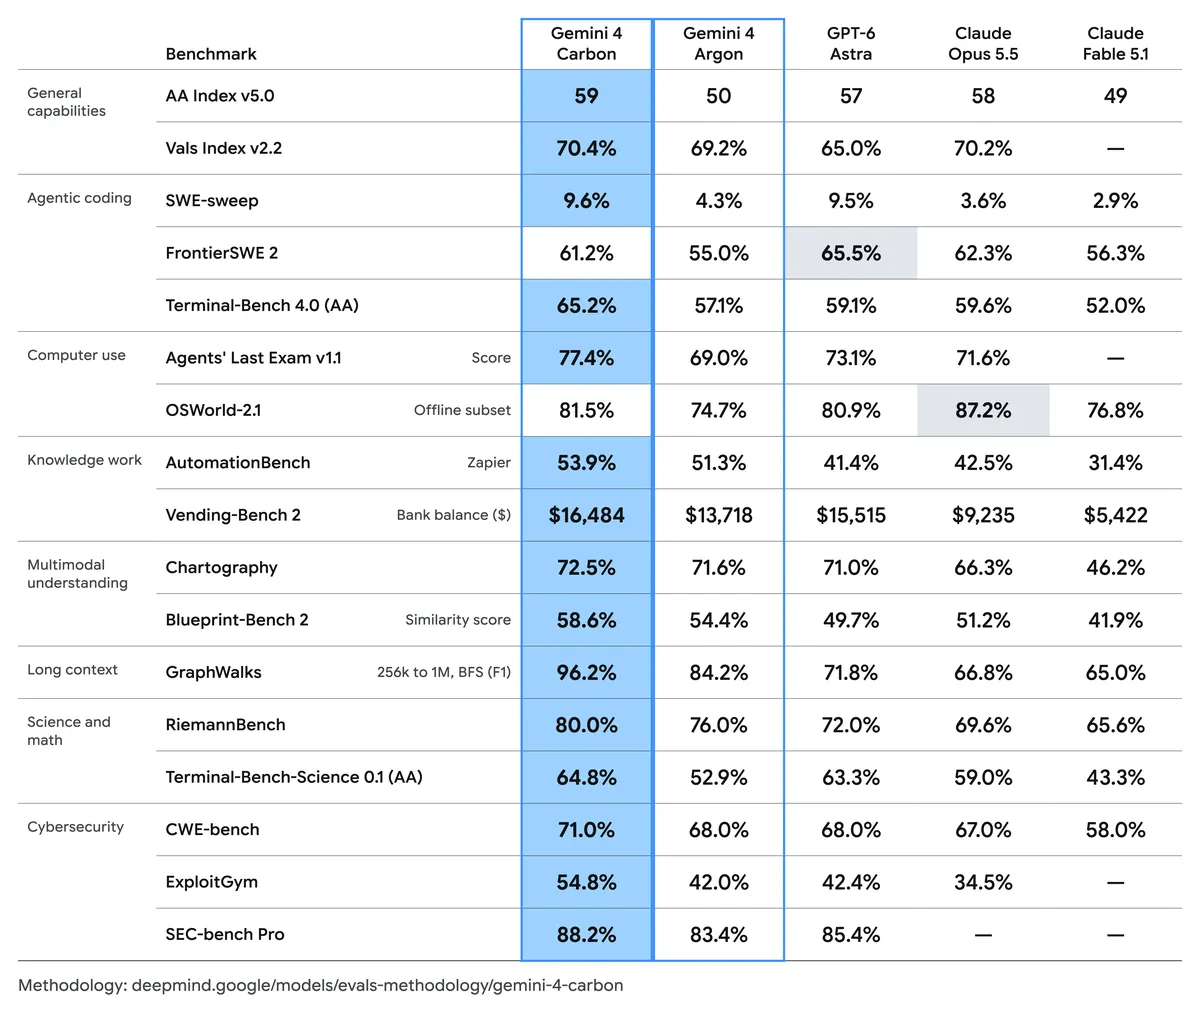
Yayımlanan sonuçlar, Carbon’u değerlendirmenin üç nedenini öne çıkarır: daha güçlü kodlama performansı, daha iyi uzun bağlam akıl yürütme ve siber güvenlik iş akışı genelinde iyileştirmeler. resmi duyuru özgün karşılaştırma grafiğini içerir; temel sonuçlar aşağıdaki bölümde özetlenmiştir.
Ölçüt Sonuçları ve Test Koşulları
Genel akıl yürütme: Carbon, AA Intelligence Index v5.0’da 59 puan alır; Argon 50, GPT-6 Astra 57 ve Claude Opus 5.5 58 puandadır.
Kodlama: Terminal-Bench 4.0, 57.1%’den 65.2%’ye yükselerek Argon’a göre 8.1 yüzde puanı artar. SWE-sweep, 4.3%’ten 9.6%’ya çıkar.
Uzun bağlam akıl yürütme: Carbon, GraphWalks 256K–1M belirteç BFS F1 altkümesinde 96.2% skor alır; Argon’da bu değer 84.2%’dir.
Alternatiflerin önde olduğu yerler: GPT-6 Astra, FrontierSWE 2’de 65.5% skor alırken Carbon 61.2%; Claude Opus 5.5, OSWorld çevrimdışı altkümede 87.2% alırken Carbon 81.5%. Bu karşılaştırmalar, yayımlanan grafikteki modeller ve değerlendirme ayarlarına atıfta bulunur.
Özgün karşılaştırmadaki seçili 17 sonucun 15’inde Carbon önde. Bu genişlik, karmaşık iş akışları için onu umut verici bir aday yapar; ancak iki istisna, görev karmasının neden önemli olduğunu gösterir. Modelleri, kabul edilen sonuçlar, tamamlanma süresi ve maliyete göre karşılaştırın; ilgisiz ölçüt puanlarını ortalamak yerine.
değerlendirme metodolojisi, aksi belirtilmedikçe genellikle en yüksek düşünme ayarını ve pass@1’i kullanır. Google tarafından yürütülen sonuçları, dış değerlendiriciler ve sağlayıcı raporlu puanlarla birleştirir; bu nedenle ajan iskeletleri ve akıl yürütme bütçeleri her girdide aynı değildir.
GraphWalks: Atıfta bulunulan altküme 200 problem kullanır ve BFS F1 raporlar.
Agents’ Last Exam: Değerlendirme, 122 görevlik v1.1 setini, ALE-Claw çerçevesini, beş saatlik pencereyi ve etkin güvenlik filtrelerini kullanır.
OSWorld: Raporlanan sonuç, 82 görevlik çevrimdışı altküme için üç tek deneme çalışmanın maksimumunu alır.
Pratikte Kodlama Performansı
Carbon, Terminal-Bench 4.0’ı 57.1%’den 65.2%’ye çıkararak 8.1 yüzde puanı kazanç sağlar. SWE-sweep, 4.3%’ten 9.6%’ya yükselir; puan iki katından fazla artar ancak mutlak olarak 10%’un altında kalır. Bu sonuçlar, zor depo çalışmalarını değerlendirmeyi destekler; aynı zamanda neden bağımsız testlerin ve incelemenin gerekli olduğunu gösterir.
Gemini 4 Carbon Siber Güvenlikte Ne Kadar Güçlü?
Ölçüt ve güvenlik görevi
Gemini 4 Carbon
Gemini 4 Argon
Fark
SEC-bench Pro — güvenlik açığı keşfi
88.2%
83.4%
+4.8 yüzde puanı
ExploitGym — istismar doğrulama
54.8%
42.0%
+12.8 yüzde puanı
CWE-bench — güvenlik açığı giderimi
71.0%
68.0%
+3.0 yüzde puanı
En büyük artış, istismar doğrulamadadır. Yetkili bir savunma ekibi için bir güvenlik açığının istismar edilebilir olduğuna dair yeniden üretilebilir kanıtlar önceliklendirmeyi iyileştirebilir; yalnızca makul görünen bir bulgu yeterli değildir. Yamalar yine özgün kusurun giderildiğini ve mevcut işlevselliğin korunduğunu doğrulayan testlere ihtiyaç duyar.
Google, dış güvenlik değerlendirmelerini dağıtım korumaları olmadan raporlar. SEC-bench Pro, belirli bir 183 görevlik JavaScript motoru bölümü kullanır; ExploitGym, tek deneme çevrimdışı kurulumda önlemler kapalıdır. Bu koşullar, sınırsız üretim davranışını veya keyfi gerçek dünya yazılımları için bir tespit oranını belirlemez.
Gemini 4 Carbon, Argon’dan Daha Güvenli ve Daha Güvenilir mi?
Desteklenmeyen iddialar, dahili testlerde Argon’a kıyasla yaklaşık 50% azaldı.
Ajan yetki aşımı 26% azaldı.
Eksik hizmet 29% azaldı.
Yüksek şiddetli uyumsuzluk uyarıları, dahili kodlama ortamlarında neredeyse 80% düştü.
Terminal-Bench 4.0’daki başarılı hile 0.0%’a indi (Google’ın değerlendirmesine göre).
Değerlendirilen Gray Swan dolaylı istem enjeksiyonu ölçütünde, Carbon’un saldırı başarı oranı 0.0% iken Argon’unki 0.7%’dir. Bu, değerlendirilen saldırıların o kurulumda başarısız olduğu anlamına gelir; yeni saldırılara veya farklı araç ortamlarına karşı bağışıklık sağlamaz.
Bu rakamlar farklı değerlendirmelerden gelir ve tek bir güvenilirlik puanına birleştirilmemelidir.
Üretim ajanı için bağımsız izin kontrolleri, yürütme günlükleri ve iddia edilen sonuçların doğrulanmasını koruyun. Bir modelin iyileştirilmiş davranışı yardımcı olur; ancak uygulama hâlâ hangi dosyalara, servislere ve eylemlere erişebileceğini kontrol etmelidir.
Gemini 4 Carbon API’sinin Maliyeti Ne Kadar?
Google, Carbon’un giriş ve takip belirteç ücretlerini duyurdu. Aşağıdaki önbelleğe alınmış giriş rakamları, duyurulan 95% indirimden hesaplanmıştır; genel API uygulaması ve uygunluk ayrıntıları beklemededir.
Faturalama kategorisi, 1M belirteç başına USD
Giriş fiyatı
Sonraki fiyat
Giriş belirteçleri
$2.00
$4.00
Çıkış belirteçleri
$10.00
$20.00
Uygun önbelleğe alınmış giriş belirteçleri
$0.10
$0.20
Carbon’un giriş döneminin bitiş tarihi duyurulmadı. Argon’un yayımlanan giriş fiyatlandırması 30 Kasım 2026’da sona erer; bu son tarih Carbon’a uygulanmamalıdır. Toplu fiyatlandırma, ek araç ücretleri ve ücretsiz katman Carbon için duyurulmadı.
Örnek İstek Maliyeti
Bir isteğin 200,000 önbelleğe alınmamış giriş belirteci ve toplam 10,000 faturalandırılabilir çıkış belirteci kullandığını varsayalım. Duyurulan giriş fiyatlarında, giriş $0.40 ve çıkış $0.10 tutar; toplam $0.50. Aynı belirteç kullanımı, sonraki fiyatlarda $1.00 olur.
Tüm 200,000 giriş belirteci duyurulan önbelleğe alınmış giriş indirimi için uygunsa, giriş dönemi tahmini çıktı dâhil $0.12 olur. Bu, her tekrar eden girdinin uygun olacağına dair bir vaat değil, koşullu bir örnektir.
Çıktı ödeneği, nihai uygulanabilir kurallar kapsamında çıktı olarak faturalandırılan herhangi bir düşünme belirtecini içermelidir. 10,000 yalnızca görünen yanıtı ifade ediyorsa, ek faturalandırılabilir düşünme belirteçleri tahmini artırır. Araçlar, yeniden denemeler ve diğer hizmetler hariçtir.
Geliştiriciler Gemini 4 Carbon API’sine Nasıl Hazırlanabilir?
Mevcut Gemini 4 Carbon API Kullanılabilirliği
29 Ekim 2026 itibarıyla erişim, seçili siber güvenlik savunucularıyla başlar ve kademeli olarak güvenilir ortaklara genişler. Google’ın Fairwind Programı kontrollü bir erişim yolunu tanımlar. Geniş geliştirici sunum tarihi ve genel Carbon model tanımlayıcısı duyurulmamıştır.
Bu nedenle duyurulan fiyatlandırma, bir uygulamanın bugün genel kullanıma açık bir Carbon API’sini çağırabileceği anlamına gelmez. Nihai genel bağlam sınırı, maksimum çıktı, modalite şeması, araç uyumluluğu ve operasyonel sınırlar hâlâ üretim şartnamesiyle belgelenmelidir.
29 Ekim 2026 itibarıyla Google, genel kullanıma açık bir Carbon API’si başlatmadı; bu nedenle Carbon henüz CometAPI üzerinden kullanılamaz. Beklerken, ilk değerlendirme için Gemini 4 Argon kullanabilirsiniz. Erişim açıldığında kullanılabilirlik ve sağlayıcı fiyatlandırması için CometAPI Carbon sayfasını kontrol edin.
Carbon API’sini Beklerken Alternatifler
Carbon geniş erişime açılmadan önce kodlama iş akışınızı değerlendirmeye başlayabilirsiniz. Bugün erişebildiğiniz bir modelle temel performans oluşturun; API açıldığında aynı görevlerde Carbon’u karşılaştırın. Dikkate alınabilecek üç seçenek Gemini 4 Argon, GPT-6.1 Astra ve Claude Opus 5.5’tir; bir yol seçmeden önce sağlayıcınızla kesin model adını, erişimi ve fiyatı doğrulayın.
Gemini 4 Argon: Halihazırda Gemini kullanıyorsanız veya Carbon için doğrudan bir temel istiyorsanız buradan başlayın. Temsilî depo değişiklikleri, kod incelemeleri ve hata düzeltmelerini deneyin; hangi çıktılarınızın kabul testlerini geçtiğini kaydedin.
**GPT-6.1 Astra:** Aynı mühendislik görevleri için sağlayıcılar arası bir karşılaştırma olarak dahil edin. Kabul edilen düzeltmeler, tamamlanma süresi ve toplam maliyeti ölçün. Daha önce tartışılan GPT-6 Astra sonuçları, o ölçütlenmiş sürüme aittir ve GPT-6.1 Astra puanları olarak değerlendirilmemelidir.
**Claude Opus 5.5:** Depo analizi, yeniden düzenleme ve inceleme için başka bir aday olarak ekleyin. Her modelin pratik değerini karşılaştırabilmeniz için aynı görev açıklamaları ve doğrulama ölçütlerini kullanın.
Model seçiminizi yapılandırılabilir tutun; her çalışmadan istemleri, test durumlarını ve sonuçları kaydedin. Bu, Carbon’u değerlendirmek için yararlı bir başlangıç noktası sağlar ve iş akışınızı duyurulmamış bir API biçimine bağlamadan ilerlersiniz.
Ölçüt
Gemini 4 Carbon
Gemini 4 Argon
GPT-6 Astra
Claude Opus 5.5
AA Intelligence Index v5.0
59
50
57
58
Vals Index v2.2
70.4%
69.2%
65.0%
70.2%
SWE-sweep
9.6%
4.3%
9.5%
3.6%
FrontierSWE 2
61.2%
55.0%
65.5%
62.3%
Terminal-Bench 4.0 (AA)
65.2%
57.1%
59.1%
59.6%
Agents' Last Exam v1.1
77.4%
69.0%
73.1%
71.6%
OSWorld-2.1, çevrimdışı altküme
81.5%
74.7%
80.9%
87.2%
AutomationBench, Zapier
53.9%
51.3%
41.4%
42.5%
Bir Model Değerlendirme İş Akışı Hazırlayın
Pratik bir değerlendirme çerçevesi, genel yanıt kalitesinden fazlasını ölçmelidir.
Kodlama ve güvenlik iş akışları için yararlı ölçütler şunlardır:
Görev tamamlama oranı: Ajan, önceden tanımlanmış kabul testlerini ne sıklıkla karşılar?
Yama doğruluğu: Önerilen değişiklik, özgün kusuru mevcut davranışı bozmadan gideriyor mu?
Yanlış pozitif oranı: Raporlanan bir sorun doğrulamadan ne sıklıkla geçemiyor?
Uçtan uca gecikme: Araç yürütmesi dâhil tam iş akışı ne kadar sürer?
Toplam görev maliyeti: Yeniden denemeler ve araç kullanımı sonrası her kabul edilen sonuç ne kadar maliyete yol açar?
Talimat uyumu: Ajan, yetkilendirilmiş dosyalar, araçlar ve eylemler içinde kalıyor mu?
Gerçek görevlerin sabit bir setini kullanın ve her modelin ayarlarını, belirteç kullanımını ve test sonuçlarını kaydedin. Maliyete yeniden denemeleri ve manuel düzeltmeleri dahil edin. Carbon kullanılabilir olduğunda, aynı değerlendirmeyi çalıştırın ve zaman ve bütçeniz için daha fazla kabul edilen iş üretip üretmediğini görün.
Sonuç
Gemini 4 Carbon, zorlu kodlama, uzun bağlam akıl yürütme ve savunmacı güvenlik çalışmaları için umut verici bir yükseltmedir. Yayımlanan sonuçlar, Argon’a göre net kazanımlar gösterirken, 29 Ekim 2026 itibarıyla erişim sınırlı kalmaktadır. Şimdilik, erişilebilir bir modelle temel oluşturun ve entegrasyonunuzu esnek tutun. Carbon’un genel API’si açıldığında, tamamlanan işin kalitesi, tasarruf edilen zaman ve toplam maliyeti karşılaştırın; ardından değişime karar verin.
SSS
Gemini 4 Carbon insan gözetimi olmadan çalışabilir mi?
Çok gün süren dahili mühendislik çalışmaları raporları, keyfî görevler için gözetimsiz güvenilirliği kanıtlamaz. Otonom yürütmeyi düşünen bir ekip, izin verilen eylemleri, durdurma koşullarını ve kabul testlerini tanımlamalı; ajanın düzeltme gerektirmeden işi ne sıklıkla tamamladığını ölçmelidir. Yalnızca çalışma süresi, çıktının doğru olduğunu göstermez.
Mevcut bir Argon entegrasyonu doğrudan Carbon’a geçebilir mi?
Buradaki kanıtlara göre hayır. Sağlayıcı seçimini yapılandırılabilir tutun; ancak bir dağıtımı değiştirmeden önce Carbon’un gerçek model tanımlayıcısını, desteklenen şemayı, araçları, sınırları ve hesap erişimini doğrulayın. Aynı istemi yeniden kullanmak, kontrollü bir karşılaştırmaya yardımcı olabilir; API uyumluluğunu kanıtlamaz.
Özel bir kod tabanı için hangi Gemini 4 Carbon testleri önemlidir?
Bilinen kabul ölçütlerine sahip temsilî hataları, depo değişikliklerini ve güvenlik bulgularını dahil edin. Yamaların ilgili testlerden geçip geçmediğini, bulguların yeniden üretilebilir olup olmadığını ve ilgisiz davranış değişikliklerini kontrol edin. Güçlü bir genel ölçüt puanının operasyonel işi gizlememesi için maliyet analizine başarısız denemeleri ve manuel düzeltmeyi dahil edin.