MiniMax M3.1 Flash يقدّم ذكاءً مفتوح الأوزان لسيناريوهات الترميز الصعبة وتدفقات عمل الوكلاء، لكن تشغيله محلياً يتطلب عتاداً قوياً. تعتمد بنيته MoE ذات 428 مليار مُعامِل على تنشيط نحو 23 مليار مُعامِل لكل رمز، ما يقلّل الحساب من دون إلغاء الحاجة إلى تخزين النموذج كاملاً. يمكن للمطورين الذين يمتلكون أنظمة متعددة وحدات GPU مدعومة نشره عبر vLLM أو SGLang. ولمن يرغب في تفادي إدارة البنية التحتية، توفّر واجهة MiniMax M3.1 Flash في CometAPI طريقة أبسط للبدء.
أهم النقاط
الأجهزة هي العائق الأكبر. تستخدم إعدادات vLLM المنشورة أربع وحدات GPU Blackwell أو AMD MI355X مدعومة، أو ثماني وحدات H100/H200.
تمت المراجعة للوضوح ودقة المصدر ومصطلحات API الحالية.
السياق الطويل يأتي بتكاليف في الذاكرة. يدعم النموذج حتى مليون رمز، لكن حدود الخدمة العملية تعتمد على ذاكرة GPU المتاحة والتوازي.
النشر يعتمد على العتاد. استخدم محرك استدلال متوافقاً، وصيغة تكميم مناسبة، وتكوين المسرّع الملائم بدلاً من أمر تثبيت عام.
المعايير هي نقطة انطلاق فقط. قيّم دقة الترميز، وإكمال مهام الوكلاء، والزمن الكامن، ومعدل الإنتاج وفق أعباء عملك الخاصة.
الاستدلال المحلي والمستضاف يخدمان احتياجات مختلفة. يمنح الاستضافة الذاتية تحكماً أكبر بالبنية التحتية، بينما يقلّل الوصول عبر واجهة API من تعقيد الإعداد وأعباء الصيانة.
ما هو MiniMax M3.1 Flash؟
MiniMax M3.1 Flash يقبل النصوص والصور والفيديو وينتج نصاً. صُمّم لسيناريوهات الترميز والأتمتة والتفاعل الحاسوبي وأمن المعلومات. تُوزَّع الأوزان بموجب MiniMax Community License. قبل تقديم خدمة تجارية، اقرأ الترخيص المرفق مع نقطة التحقق وتحقّق من الشروط التي تنطبق على استخدامك.
مواصفات MiniMax M3.1 Flash
المواصفة
MiniMax M3.1 Flash
المطوّر
MiniMax
عائلة النموذج
MoE متعدد الوسائط أصيل
إجمالي المعاملات
حوالي 428 مليار
المعاملات الفعّالة
حوالي 23 مليار لكل رمز
الحد الأقصى للسياق
1,048,576 رمزاً (قدرة النموذج)
أنواع المدخلات
نصوص وصور وفيديو (حسب المسار)
المخرجات
نص
آلية الانتباه
انتباه متناثر MiniMax في كل طبقة
التكميم
طبقات كثيفة MXFP8 / خبراء NVFP4
فكّ ترميز المسودة
رأس مسودة مدمج DSpark
جهد الاستدلال
منخفض، متوسط، عالٍ، أعلى جداً، أقصى
سرعة المخرجات المبلغ عنها
أكثر من 200 رمز/ثانية في ظروف مواتية؛ P50 أكثر من 170 رمز/ثانية
الترخيص
MiniMax Community License
الاستدلال الموثّق
vLLM، SGLang
البنية النموذجية
4 وحدات GPU Blackwell أو MI355X مدعومة؛ 8 وحدات GPU H100/H200
كيف يستخدم MiniMax M3.1 Flash بنية 428B/23B؟
يوجّه نموذج خليط الخبراء (MoE) كل رمز عبر خبراء محدّدين. في MiniMax M3.1 Flash، تكون حوالي 23 مليار مُعامِل فعّالة لكل رمز، بينما يبلغ إجمالي المعاملات نحو 428 مليار. يقلّل التنشيط المتناثر من الحساب؛ ولا يحوّل نقطة التحقق إلى نموذج كثيف بـ 23 مليار.
ماذا تغيّر في MiniMax M3.1 Flash؟
الانتباه المتناثر: يُطبَّق في جميع طبقات النموذج لتقليل عمل الانتباه على المدخلات الطويلة؛ تعتمد الفائدة على نوى الخدمة والمحفّز.
أوزان دقيقة مختلطة: تقلّل مكوّنات MXFP8 الكثيفة وخبراء NVFP4 من متطلبات التخزين والحوسبة، لكنها لا تزال تحتاج إلى عتاد ونوى متوافقة.
فكّ ترميز DSpark: يمكن لرأس المسودة المدمج تسريع التوليد في الوصفات المدعومة؛ تعتمد النتائج على قبول الرموز وأعباء العمل.
خدمة واعية للطاقة: يمكن لجدولة على مستوى البنية التحتية تحسين الاستفادة، لكنها ليست ميزة تحصل عليها تلقائياً بمجرد تنزيل الأوزان.
ما العتاد المطلوب لـ MiniMax M3.1 Flash؟
قسّم ذاكرة GPU إلى أربعة أجزاء: أوزان نقطة التحقق، مخبأ القيم الأساسية/المفتاح (KV) للرموز السابقة، وسائط وقت التشغيل، وهامش عبء العمل. التقديرات أدناه تغطي تخزين المعاملات الخام فقط. تغيّر الدقة المختلطة، ومقاييس التكميم، والمكوّنات متعددة الوسائط، والحمولات الإضافية للخدمة المتطلبات الفعلية.
طوبولوجيات GPU المُتحقق منها
المسرّعات
الطوبولوجيا المنشورة
ملاحظات
NVIDIA GB200/GB300/B200/B300
4 وحدات GPU، توازي الموتر
مسار أصيل NVFP4 على Blackwell
NVIDIA H100/H200
8 وحدات GPU، توازي الموتر
مخابئ FP8 ومسار Marlin MoE
AMD MI355X
4 وحدات GPU، توازي الموتر
يتطلب ROCm مدعومة وإعدادات AITER
GPU استهلاكي 24–32 GB
لا توجد وصفة مرجعية لنقطة تحقق كاملة
غير كافٍ للتحميل البسيط على GPU واحدة
محطة عمل بمعالج فقط
لا يوجد نشر عملي مُتحقق منه
تجارب التفريغ ليست دليلاً للإنتاج
تقدير الذاكرة: يبلغ التخزين الخام لـ 428 مليار مُعامِل نحو 856 جيجابايت عند BF16، و428 جيجابايت عند 8-بت، أو 214 جيجابايت عند 4-بت مثالي. يمزج ملف نقطة التحقق الرسمي بين صيغ متعددة، لذا هذه الأرقام ليست متطلبات VRAM التشغيلية. اسمح بمقاييس التكميم، ومخبأ KV، ووسائط وقت التشغيل، والتوازي؛ استخدم ملفات نقطة التحقق الفعلية والوصفة المناسبة لوحدة GPU لديك لتقدير حجم النظام.
احجز مساحة NVMe لنقطة التحقق، والتنزيلات المؤقتة، ونسخة تراجع.
أي طريقة نشر يجب أن تختار؟
بالنسبة لعناقيد محلية مدعومة، يُعد vLLM نقطة انطلاق عملية مع تكوينات مرجعية وتكامل API مألوف؛ يناسب SGLang الفرق التي تستكشف تخصيص الخدمة بعد التحقق من التوافق، بينما يوفّر CometAPI مساراً مستضافاً للنمذجة الأولية والتبديل بين النماذج.
المتطلب
vLLM المحلي
SGLang المحلي
CometAPI
الأوزان ووحدات GPU
تنزيل الأوزان؛ تشغيل وحدات GPU مدعومة
تنزيل الأوزان؛ تشغيل وحدات GPU مدعومة
استدلال مُدار من المزوّد؛ لا أوزان محلية
Blackwell / AMD MI355X
وصفات خاصة بالعتاد
وصفات خاصة بالعتاد
العتاد مُدار من المزوّد
H100/H200
وصفة موثّقة لثماني وحدات GPU
تحقّق من مصفوفة الدعم الحالية
العتاد مُدار من المزوّد
الترميز والتوازي
DSpark على المسارات المدعومة؛ خدمة موزّعة وتوازي موتر
ترميز خاص بالعتاد؛ توازي موتر وخبراء
خيارات محدودة بما يتيحه المسار
التحكم ومعالجة البيانات
بيئتك؛ أنت تدير التوسّع
بيئتك؛ أنت تدير التوسّع
مزوّد خارجي؛ المزوّد يدير التوسّع
اختر الإطار الذي لديه وصفة مُتحقق منها لعتادك، ثم قارن زمن الاستجابة ومعدل الإنتاج باستخدام المحفّزات ذاتها، والدقة ذاتها، والتوازي ذاته.
كيف تشغّل MiniMax M3.1 Flash محلياً باستخدام vLLM؟
تفترض الخطوات التالية مضيف Linux مجهّز بأربع وحدات GPU NVIDIA Blackwell متوافقة، وبيئة برنامج تشغيل/CUDA مدعومة، وإمكانية الوصول إلى نقطة التحقق الرسمية. استخدم بناء vLLM مُتحقق منه؛ قد يفشل التثبيت العادي على عتاد GPU غير مدعوم حتى إن نجح تثبيت الحزمة.
تأكد من تطابق الحزمة المثبّتة ووقت تشغيل CUDA مع عائلة وحدة GPU لديك. إذا لزم بناء تطوير خاص بالمشروع، اتبع ملاحظات التثبيت المرجعية قبل استخدام معاملات التشغيل.
انتظر حتى ينتهي الخادم من التحميل ويبلّغ أنه جاهز قبل إرسال الطلب. يحدّ الأمر أعلاه السياق إلى 32,768 رمزاً وتسلسلات متزامنة إلى أربعة للاختبار الأولي. هذه الحدود المخفضة ليست إعدادات مُعايرة؛ اضبطها بعد قياس استخدام الذاكرة وسلوك الطلب على عتادك.
يستمع المثال على 127.0.0.1 للاختبار المحلي. قبل ربط عملاء عن بُعد، ضع ضوابط وصول أمام نقطة النهاية وتهيئة مهلات العملاء، ومحاولات محدودة، ورصد الأداء.
إصدار H100/H200: استخدم وصفة Hopper ذات الثماني وحدات GPU
على ثماني وحدات GPU H100/H200، استخدم مخبأ FP8 الخاص بـ Hopper ومسار Marlin MoE بدلاً من تكوين NVFP4 الخاص بـ Blackwell. يتبع الأمر أدناه الوصفة الرسمية لـ vLLM على Hopper مع تقليل السياق والتوازي إلى 32K وأربعة تسلسلات للاختبار الأولي. يعطّل إدخال الفيديو وفق تلك الوصفة. أبقِ نقطة النهاية خلف ضوابط الوصول الحالية لديك.
يوفّر SGLang وصفات نشر M3.1 خاصة بالعتاد وخدمة متوافقة مع OpenAI. في لقطة 23 أكتوبر، تتضمن الوثائق صور حاويات تطوير مخصصة، لذا لا يُفترض أن يحتوي تثبيت SGLang العام على كل الدعم الخاص بالنموذج.
سحب صورة الحاوية المخصصة
# NVIDIA development image
docker pull lmsysorg/sglang:dev-minimax-m31-flash

# AMD MI350X/MI355X development image
docker pull lmsysorg/sglang:dev-minimax-m31-flash-mi35x
بعد ذلك، اتبع دليل SGLang لنموذج MiniMax M3.1 الخاص بالمسرّع لديك. سحب الصورة يُنزّل بيئة التشغيل فقط؛ لا بدّ من بدء الحاوية مع إتاحة الوصول إلى وحدة GPU وإطلاق التكوين المطابق داخلها. استخدم الأمر الكامل الخاص بالعتاد من الدليل، وانتظر الجاهزية، ثم استعلم عن قائمة نموذج نقطة النهاية قبل إرسال طلب اختبار. تستخدم المسارات المُوثّقة لـ NVIDIA وAMD تبعيات مختلفة ويجب تهيئتها بشكل منفصل.
كيف يقارن MiniMax M3.1 Flash على المعايير؟
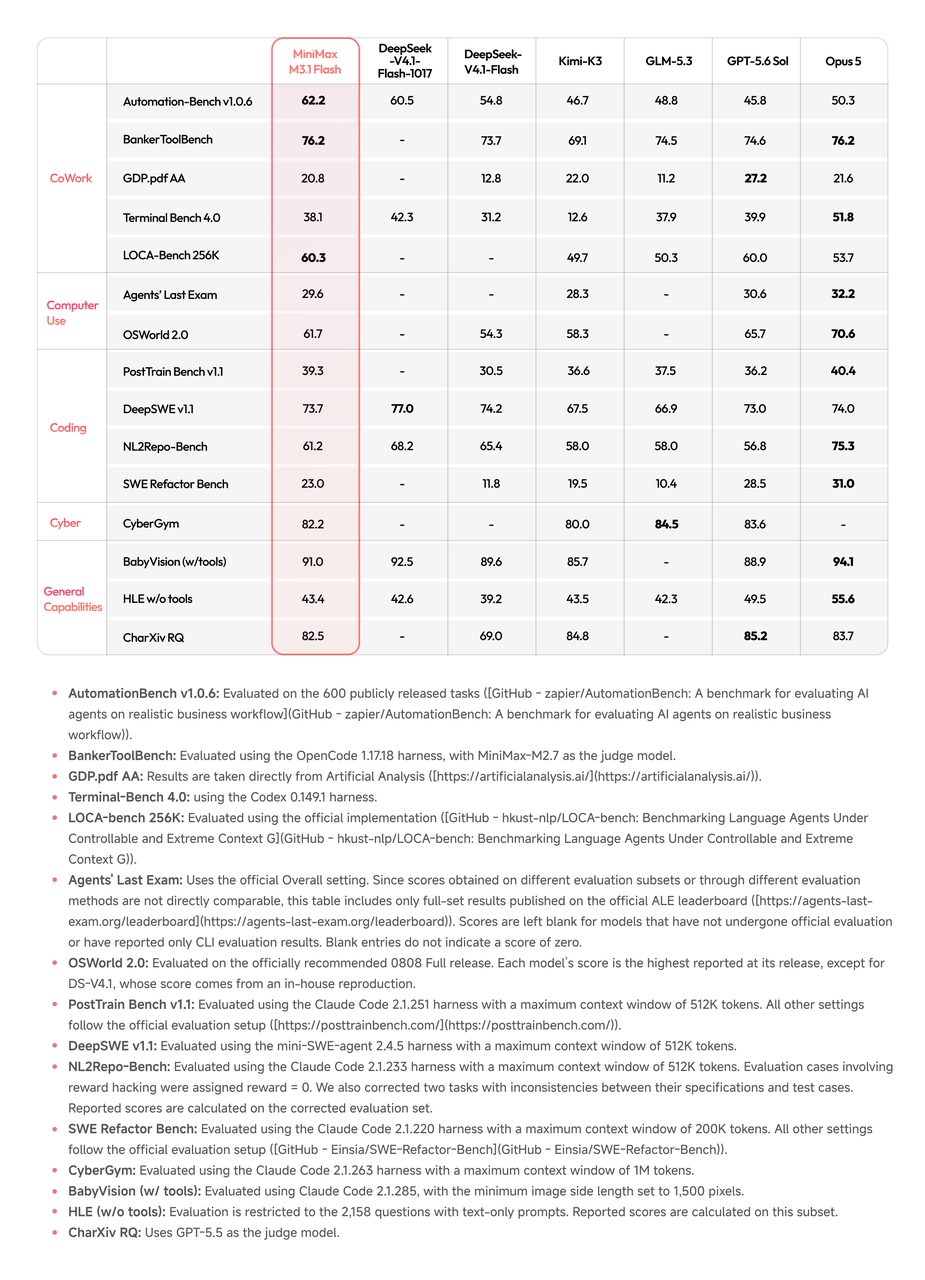
بعد اجتياز نقطة النهاية اختبارات الأساس، استخدم المعايير المنشورة لتحديد أعباء العمل التالية المراد اختبارها. الأرقام أدناه هي تقييمات منشورة من المورّد، وليست قياسات نشرك المحلي.
المعيار
M3.1 Flash
DeepSeek V4.1 Flash 1017
Kimi K3
Automation-Bench v1.0.6
62.8
60.5
46.7
DeepSWE v1.1
73.7
77.0
67.5
Terminal Bench 4.0
38.1
42.3
12.6
OSWorld 2.0
61.7
N/A
58.3
NL2Repo-Bench
61.2
68.2
58.0
BabyVision with tools
91.0
92.5
85.7
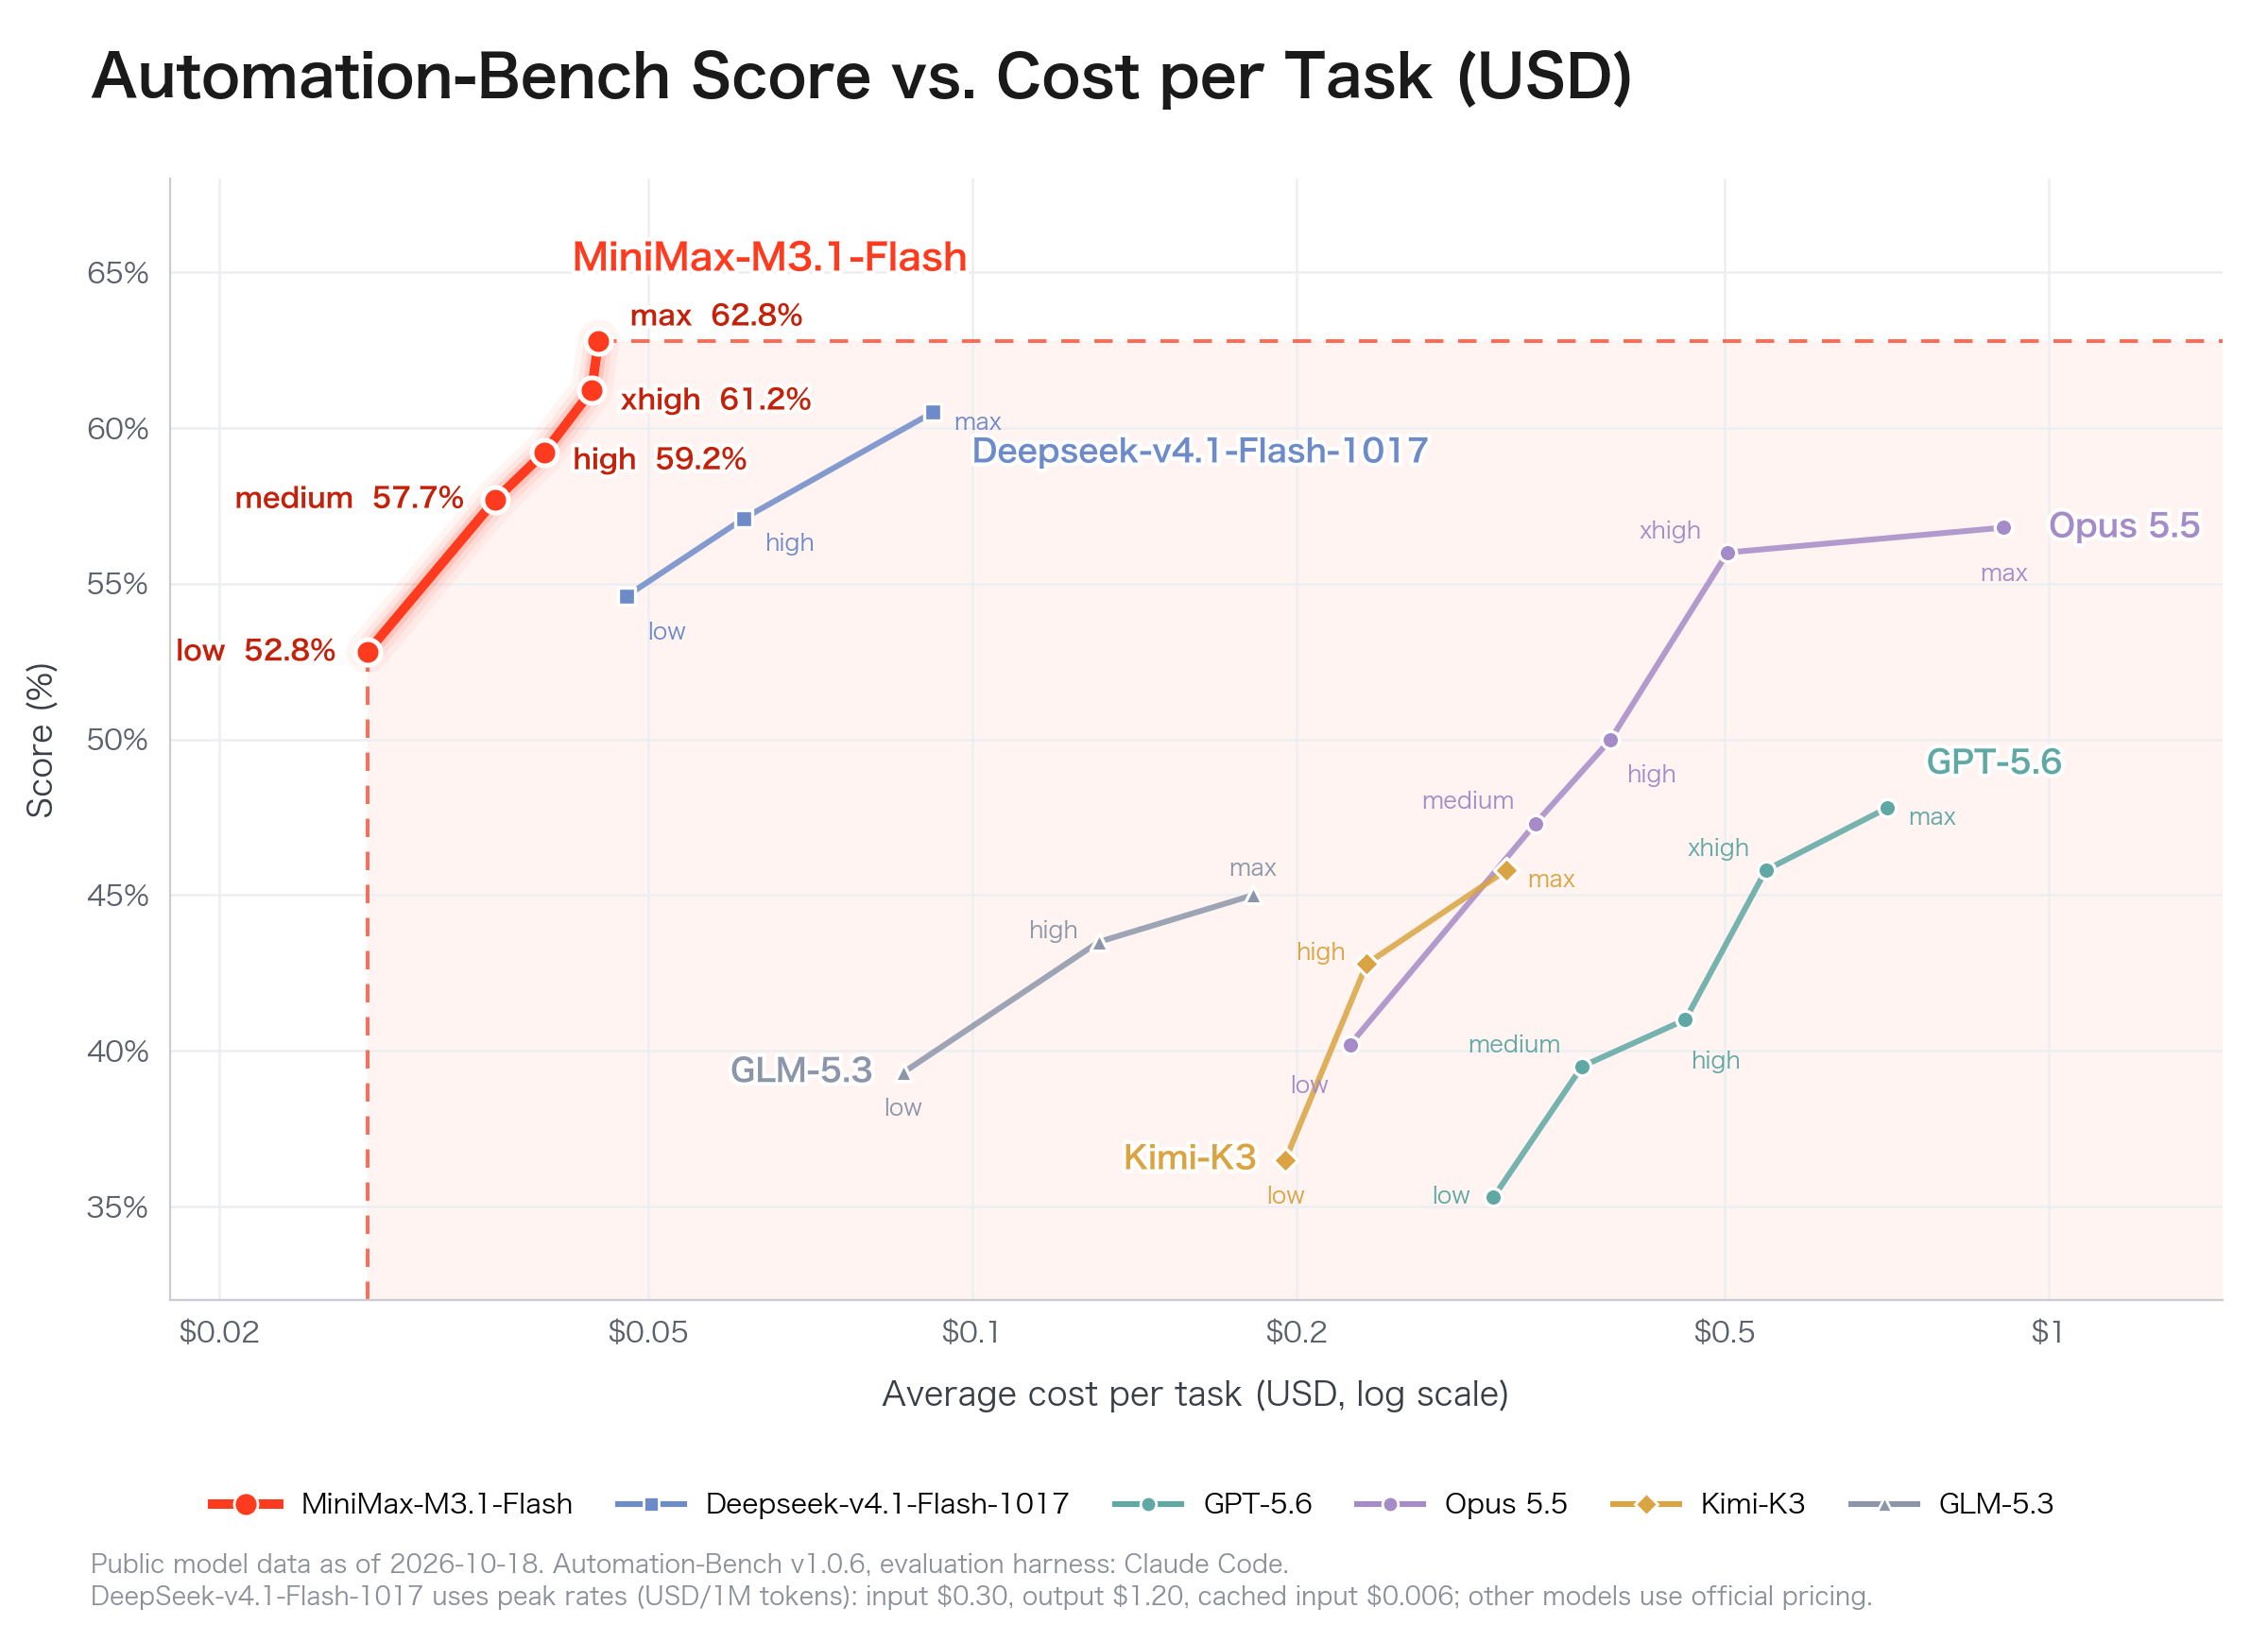
في هذه المقارنة، تتصدر MiniMax النموذجين المدرجين على Automation-Bench، بينما تتصدر DeepSeek عدة معايير ترميز. اقرأ بطاقة النموذج وإعدادات التقييم قبل استخلاص النتائج، واختبر المحفّزات والأدوات التي يستخدمها تطبيقك فعلياً. الدرجات من نسخ أو إعدادات معيار مختلفة ليست قابلة للمقارنة مباشرة.
كيف تُحسّن أداء MiniMax M3.1 Flash؟
التحكّم في السياق والتوازي
بعد أول طلب ناجح، زد متغيّراً واحداً في الحمولة في كل مرة: طول الإدخال، طول الإخراج، أو الطلبات المتزامنة. سجّل ذروة الذاكرة وزمن الاستجابة لكل تشغيل. احتفظ بالإعدادات المستقرة الأخيرة كنقطة تراجع، حتى لا يصبح اختبار فاشل خطّك الأساسي الجديد.
اختر جهد الاستدلال بعناية
يدعم M3.1 Flash جهود الاستدلال منخفضة ومتوسطة وعالية وأعلى جداً وأقصى. يمكن أن تحسّن الإعدادات الأعلى درجات المهام الصعبة لكنها غالباً تتطلب مزيداً من رموز الاستدلال وزمن كامن أطول. استخدم جودة إكمال المهمة وتكلفة الحوسبة المستغرَقة معاً.
بالنسبة لطلبات vLLM المحلية، تعرض الوصفة إعدادات الجهد الاستدلالي ضمن chat_template_kwargs. تحقّق من الإجابة النهائية وأي حقل استدلال مُعاد بشكل منفصل عند التحقق من عميلك، لأن نقاط النهاية المستضافة والمحلية قد تعرض هذه الحقول بشكل مختلف.
تتبّع التكلفة لكل مهمة مكتملة
بالنسبة للوكلاء، معدل الرموز في الثانية لا يكفي. سجّل زمن الوصول لأول رمز، ومعدل الإخراج، ومعدل قبول فكّ الترميز التكّهنّي، والإنتاجية المتزامنة، وإخفاقات استدعاء الأدوات، واستخدام الذاكرة، وتكلفة المهام المكتملة. قد يقدّم ردّ أبطأ مع إخفاقات أدوات أقل اقتصاداً إجمالياً أفضل.
كيف تستخدم MiniMax M3.1 Flash API في CometAPI؟
الفرق التي لا تحتاج إلى بنية مسرّعات مخصصة يمكنها استخدام نقطة نهاية مستضافة متوافقة مع OpenAI. هذا يُلغي تنزيل نقطة التحقق وتشغيل GPU لكنه ينقل معالجة الطلب خارج البيئة ذاتية الاستضافة.
export COMETAPI_KEY="YOUR_COMETAPI_KEY"

curl https://api.cometapi.com/v1/chat/completions \
  -H "Authorization: Bearer $COMETAPI_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "minimax-m3.1-flash",
    "messages": [{"role":"user","content":"Review this Python function for edge cases."}],
    "max_tokens": 2048
  }'
أكّد مُعرّف النموذج في وحدة تحكم CometAPI قبل تشغيل هذا المثال. استخدم البوابة عندما يُسهل API مشترك عبر المزوّدين تطبيقك؛ قارن عرض السعر الحالي مع الوصول المباشر لحجم استخدامك المتوقع.
تسعير MiniMax M3.1 Flash API
السعر لكل مليون رمز
MiniMax الرسمي API
CometAPI
الإدخال
$0.15
$0.80
الإخراج
$0.60
$3.20
الإدخال المخبأ
$0.015
أكّد تسعير المسار الحالي
أسعار MiniMax API المباشرة في إعلان الإطلاق بتاريخ 19 أكتوبر 2026 هي $0.15 للإدخال، $0.60 للإخراج، و$0.015 للإدخال المخبأ لكل مليون رمز. بالنسبة لـ CometAPI، تحقّق من مسار النموذج النشط، وأسعار الإدخال/الإخراج، وقواعد التخزين المؤقت، وأي خصم للحساب قبل تقدير الإنفاق. قارن التكلفة الإجمالية لمزيج الرموز وعمليات إعادة المحاولة المتوقعة لديك.
ما المشاكل التي قد تحدث عند تشغيل MiniMax M3.1 Flash؟
نفاد الذاكرة أثناء التحميل أو الطلبات
إذا فشلت الأوزان في التحميل: تحقّق من المرحلة الفاشلة في سجلّ بدء التشغيل، وتأكد من اكتمال نقطة التحقق، وتحقّق من تطابق طوبولوجيا GPU وخلفية التكميم مع الوصفة. إذا تجاوزت الأوزان الذاكرة المتاحة، استخدم تكويناً بسعة كافية؛ تقصير الطلب لا يصلح فشل تحميل الأوزان.
إذا حمّلت الأوزان لكن فشل تخصيص المخبأ في بدء التشغيل: تحقّق من إعدادات المخبأ والذاكرة المتاحة، ثم قلّل السياق المكوَّن أو التوازي وفقاً للوصفة.
إذا بدأ الخادم لكن نفدت الذاكرة أثناء الطلب: أعد المحاولة بمحفّز قصير مع طلب واحد في كل مرة، ثم زد طول الإدخال، وطول الإخراج، والتوازي بشكل منفصل مع مراقبة الذاكرة.
نوى تكميم أو انتباه غير متوافقة
يختلف تنفيذ NVFP4 بين عتاد Blackwell وHopper وAMD. طابق إصدارات محرك الاستدلال، وخلفيات التكميم، وإصدارات CUDA/ROCm، وعائلات المسرّعات بدلاً من إعادة استخدام الأعلام بشكل عشوائي.
تهيئة مخبأ الانتباه المتناثر
إذا أبلغ بدء التشغيل عن مخطط مخبأ غير مدعوم، قارن تكوين المخبأ الكامل مع الوصفة الخاصة بالعتاد. تتطلب وصفة vLLM الحالية --block-size 128 لمخبأ الانتباه المتناثر/الفهرسة MSA. إذا أبلغ بدء التشغيل عن خطأ في مخطط المخبأ أو حجم الكتلة، قارن التكوين الكامل مع وصفة العتاد لديك.
معرّفات نماذج غير متوقعة
المسار المحلي واسم نموذج البوابة البعيدة ليسا متطابقين بالضرورة. استعلم عن استجابة /v1/models المحلية وتجنب ترميز افتراضات من نقطة نهاية أخرى بشكل صلب.
إنتاجية منخفضة ملحوظة
افصل بين معالجة المحفّز البطيئة وتوليد الرموز البطيء. قارن تشغيلات بالطول نفسه للإدخال وحدّ الإخراج، ثم تحقق من استخدام وحدة GPU وسلوك التوصيل البيني قبل زيادة حجم الدفعة. رقم السرعة المنشور من المزوّد ليس خطاً أساسياً لعنقودك المحلي.
الخلاصة
اختر مسار النشر الأول بناءً على العتاد الذي يمكنك تشغيله اليوم. استخدم إرشاد vLLM لعناقيد محلية مدعومة، ودليل SGLang الخاص بالعتاد لمكدّس خدمة بديل، أو واجهة API مستضافة عندما ترغب في التركيز على تكامل التطبيق. احتفظ بالتكوين الذي يلبّي أهداف جودة المهام وزمن الاستجابة بتكلفة تشغيل مستدامة.
أوثق طريقة لاختيار أسلوب الخدمة هي التحسين للحصول على عمل مكتمل صحيح لكل دولار ودقيقة، وليس فقط ذروة الرموز في الثانية.
الأسئلة الشائعة
كيف أجعل النشر قابلاً للاستنساخ بعد ترقية وقت التشغيل؟
ثبّت نسخة نقطة التحقق، وإصدار صورة وقت التشغيل أو الحزم، وحزمة برامج التشغيل، وإعدادات الإطلاق. شغّل مجموعة قبول صغيرة نفسها قبل كل ترقية، واحتفظ بالتكوين العامل السابق متاحاً للتراجع.
كيف أتعامل مع المحاولات عند استدعاء وكيل للأدوات؟
افصل بين إعادة محاولة النموذج وتكرار إجراء الأداة. استخدم مفاتيح عديمة الأثر للإجراءات التي تغيّر البيانات، وتحقّق مما إذا كانت المحاولة الأولى ناجحة، وصحّح معايير الأداة كاملة قبل التنفيذ.
هل يمكنني التبديل بين نقطة نهاية محلية وCometAPI دون تغيير سلوك التطبيق؟
اجعل نقطة النهاية والاعتمادات ومعرّف النموذج قابلة للتهيئة. اختبر البث، واستدعاء الأدوات، وحقول الاستدلال، والمدخلات متعددة الوسائط على كلا المسارين، وتحقّق من متطلبات توجيه البيانات قبل تمكين المسار البديل.
ماذا يجب أن أختبر قبل قبول المدخلات متعددة الوسائط؟
اختبر صوراً وفيديوهات ممثلة، بما فيها منخفضة الجودة والملفات غير المدعومة. تحقّق من المعالجة المسبقة، وحدود الحجم، وجودة الإجابة، والمهلات بشكل منفصل؛ فالطلب النصي الناجح لا يُثبت المسار متعدد الوسائط.
كيف أعرف أن النشر جاهز للمستخدمين الحقيقيين؟
حدّد أهدافاً لنجاح المهام، واستدعاءات أدوات صحيحة، وزمن كامن، وأخطاء، وتكلفة. اختبر حركة مرور واقعية، وتحقّق من الرصد والسلوك الاحتياطي، ثم وسّع من طرح صغير فقط طالما أنّ تلك الأهداف قائمة.