Gemini 4 Carbon هو نموذج رائد من Google DeepMind موجّه للهندسة demanding والأمن السيبراني الدفاعي. أُعلن عنه في 28 أكتوبر 2026، ويُحسّن على Argon في التقييمات المنشورة للبرمجة والأمان والسياق الطويل. الأسعار التمهيدية هي 2 دولار لكل مليون رمز إدخال و10 دولارات لكل مليون رمز إخراج، لكن الوصول مبدئياً مقصور على مدافعين سيبرانيين مختارين وشركاء موثوقين. بالنسبة للمطورين، الفرصة هي عمل مستقل أقوى؛ أما القيد الفوري فهو الوصول.
Key Takeaways
Gemini 4 Carbon هو النموذج الحدّي التالي من Google بعد Argon، مُحسَّن لهندسة قائمة على الوكلاء تمتد على عدة أيام والدفاع في الأمن السيبراني.
يحتل Gemini 4 Carbon المرتبة #1 على Artificial Analysis Intelligence Index v5.0 (درجة 59)، متقدماً على Claude Opus 5.5 (58) وGPT-6 Astra (57). مكاسب قوية في البرمجة، تطوير الويب بكامل الطبقات (+89 Elo على WebDev Arena إلى المرتبة #4)، الاستدلال العلمي، الفهم متعدد الوسائط، والمواءمة (0.0% نجاح على معيار Gray Swan لحقن الأوامر غير المباشر).
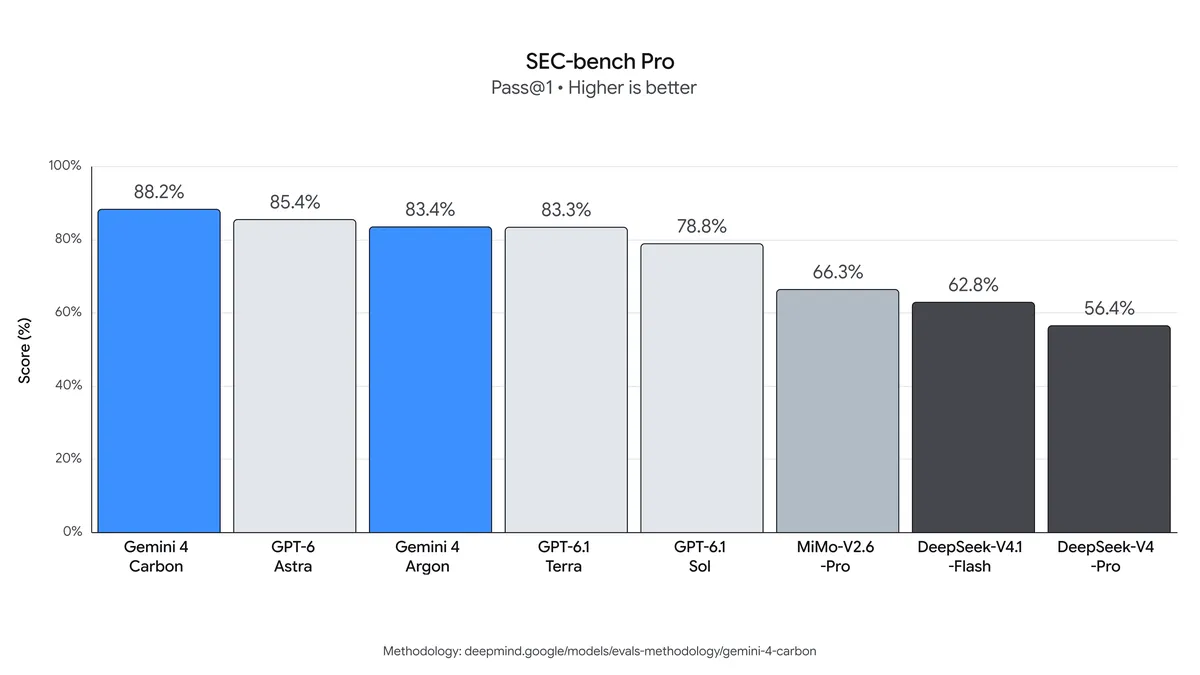
درجات أمن سيبراني بارزة (من دون ضوابط): 88.2% على SEC-bench Pro (اكتشاف الثغرات)، 54.8% على ExploitGym (الاستغلال)، و71.0% على CWE-bench (التصحيح).
تمت المراجعة للوضوح ودقة المصدر ومصطلحات API الحالية.
وصول أولي محدود عبر Fairwind Program لمدافعي الأمن السيبراني؛ واجهة برمجة التطبيقات العامة وإطلاق أوسع قادمان لاحقاً.
نفس التسعير التمهيدي مثل Argon؛ وبعد الفترة التمهيدية تُطبَّق الأسعار القياسية.
منصات مثل CometAPI تدعم بالفعل عائلة Gemini الأوسع (بما في ذلك Argon) عبر واجهة موحّدة متوافقة مع OpenAI، ما يجعل تبديل النماذج والاستعداد لإصدار Carbon الأوسع سهلاً. تفاصيل واجهة برمجة التطبيقات العامة وتاريخ الإصدار الواسع لم يُعلنا حتى 29 أكتوبر 2026.
What Is Gemini 4 Carbon?
Gemini 4 Carbon هو أحدث نموذج رائد من Google، مصمَّم للتعامل مع هندسة البرمجيات المعقدة، أبحاث الأمن السيبراني، وسير العمل المستقل.
وفقاً لـالإعلان الرسمي، يبني Carbon على الأساس الذي أرسته Gemini 4 Argon مع تحسينات كبيرة في البرمجة، الاستدلال الوكيلي، والمهام المركّزة على الأمان.
جرى تصميم Carbon لأعمال تشمل التحقيق والتنفيذ والتحقق عبر خطوات متعددة. قد يقوم وكيل هندسة دفاعية بفحص مستودع، والتحقق من ثغرة مشتبه بها في بيئة معزولة، وتطوير تصحيح، واختبار ما إذا كان التغيير يعالج العيب الأصلي.
تفيد Google بأن فرقها الداخلية لاحظت أن Carbon يعمل عبر مهام هندسية معقدة على مدى عدة أيام. هذه ملاحظات داخلية وليست ضماناً منشوراً لمدة تشغيل مستقلة معينة. لم تُصدر Google تقريراً فنياً كاملاً أو عدد المعاملات أو تفاصيل البنية. من المتوقع أن تكون نافذة السياق وحدود الإخراج مشابهة أو أفضل من Argon (مذكورة ضمن نطاق ملايين الرموز مع سعة إخراج عالية)، ويدعم مدخلات متعددة الوسائط بما في ذلك النصوص والصور والفيديو والصوت وملفات PDF.
What Are the Key Features of Gemini 4 Carbon?
Long-Horizon Software Engineering
صُمّم Carbon للمشكلات الهندسية التي لا يمكن إتمامها بشكل موثوق في خطوة استدلال واحدة.
تتضمن الأمثلة تحليل السبب الجذري عبر مستودعات كبيرة، الإخفاقات المتعلقة بالاعتماديات، تصحيح أخطاء الأنظمة منخفضة المستوى، وإعادة هيكلة معقدة للشيفرة.
تستهدف تحسيناته القدرة على مواصلة العمل بعد محاولة غير ناجحة.
يجب على وكيل البرمجة الفعّال أن يدرك حين تفشل محاولته الأولى، وأن يفحص الأدلة الجديدة، وأن يُعدّل نهجه من دون الانجراف بعيداً عن المهمة الأصلية.
Defensive Cybersecurity Workflows
تمتد نتائج الأمان لدى Carbon عبر العثور على الثغرات، التحقق من قابليتها للاستغلال، وتصحيح العيوب. السؤال المفيد لفريق الأمان هو ما إذا كان الوكيل يستطيع الانتقال من مشكلة مشتبه بها إلى نتيجة قابلة لإعادة الإنتاج وتصحيح مُختبَر، مع احترام الأذونات والبيئة المُسندة إليه.
Long-Context and Multimodal Understanding
يسجّل Carbon نتيجة GraphWalks BFS F1 تبلغ 96.2% ضمن مجموعة 256K–1M من الرموز، ارتفاعاً من 84.2% لدى Argon. هذا دليل على استدلال الرسوم البيانية في سياق طويل، وليس ضماناً لاسترجاع صحيح من أي مستند بملايين الرموز.
تغطي نتائج Chartography وBlueprint-Bench 2 المنشورة أيضاً الفهم البصري. يمكن لهذه الاختبارات المساعدة في تحديد سير عمل واعد للوثائق والمخططات، لكنها لا تُثبت مخطط الوسائط الكامل لواجهة برمجة تطبيقات عامة مستقبلية.
How Does Gemini 4 Carbon Perform on Benchmarks?
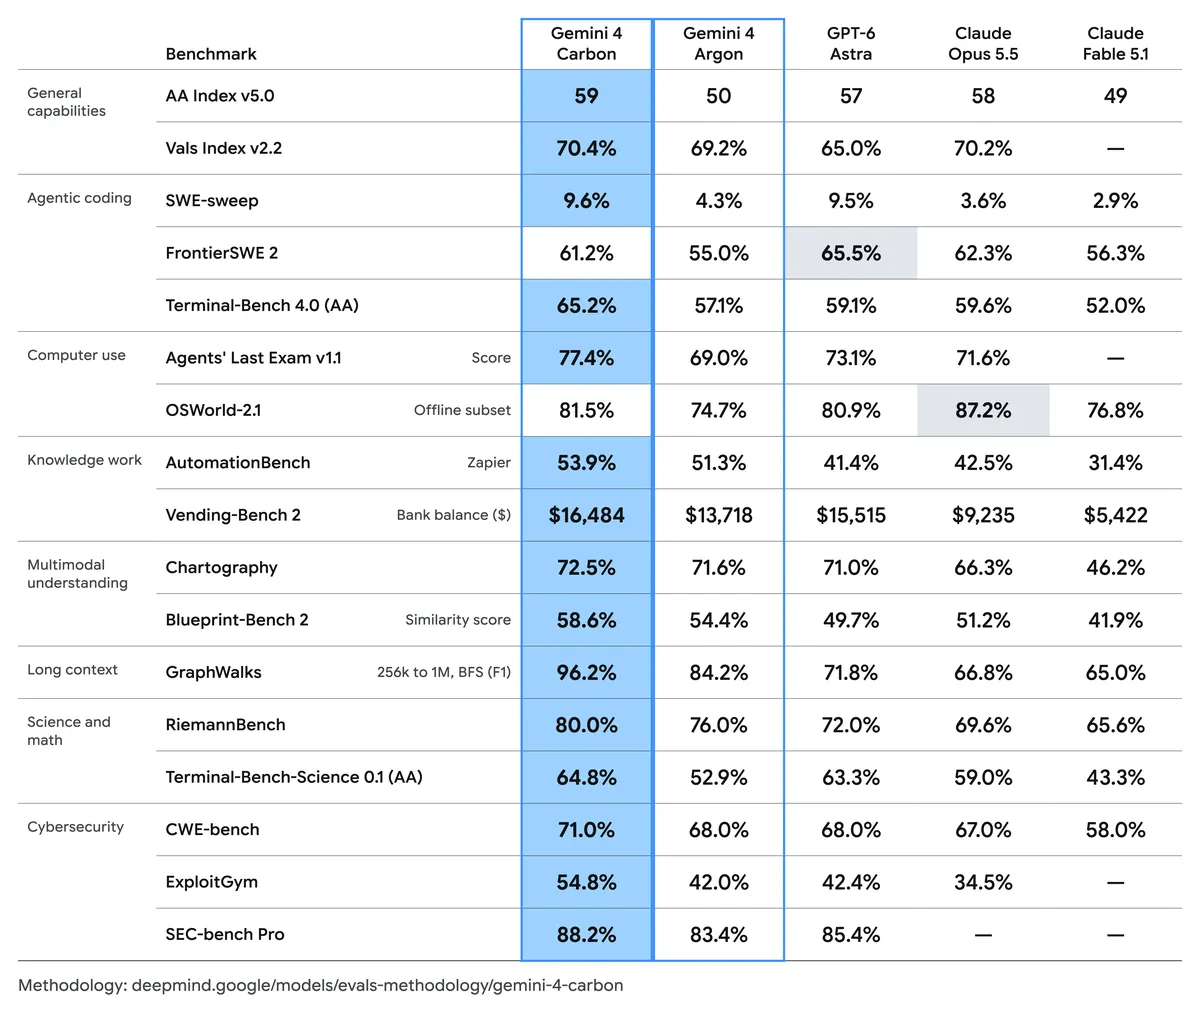
تُبرز النتائج المنشورة ثلاثة أسباب لتقييم Carbon: أداء أقوى في البرمجة، استدلال أفضل في السياق الطويل، وتحسينات عبر سير العمل الأمني السيبراني. يتضمن الإعلان الرسمي مخطط المقارنة الأصلي أدناه؛ تُلخَّص النتائج الرئيسية في القسم التالي.
اختر معايير تشبه عبء عملك الخاص. قد يتصدر نموذج مؤشراً عاماً للذكاء بينما يتأخر عن نموذج آخر في مهمة هندسية معينة.
Benchmark Results and Test Conditions
الاستدلال العام: يسجّل Carbon 59 على AA Intelligence Index v5.0، مقارنةً بـ50 لـ Argon، و57 لـ GPT-6 Astra، و58 لـ Claude Opus 5.5.
البرمجة: يرتفع Terminal-Bench 4.0 من 57.1% إلى 65.2%، أي تحسّن بمقدار 8.1 نقطة مئوية على Argon. ترتفع SWE-sweep من 4.3% إلى 9.6%.
الاستدلال في سياق طويل: يسجّل Carbon 96.2% على مجموعة GraphWalks 256K–1M-token BFS F1، ارتفاعاً من 84.2% لـ Argon.
حيث تتصدر البدائل: يسجّل GPT-6 Astra نسبة 65.5% على FrontierSWE 2 مقابل 61.2% لـ Carbon؛ ويسجّل Claude Opus 5.5 نسبة 87.2% على المجموعة الفرعية دون اتصال من OSWorld مقابل 81.5% لـ Carbon. تشير هذه المقارنات إلى النماذج وإعدادات التقييم في المخطط المنشور.
عبر النتائج الـ17 المختارة في المقارنة الأصلية، يتصدر Carbon في 15 منها. هذا الاتساع يجعله مرشحاً واعداً لسير العمل المعقّد، لكن الاستثناءين يوضحان أهمية مزج مهامك الخاصة. قارن النماذج في النتائج المقبولة، وزمن الإتمام، والتكلفة بدلاً من متوسط درجات معايير غير ذات صلة.
منهجية التقييم تستخدم عموماً أعلى إعداد للتفكير وpass@1 ما لم يُذكر خلاف ذلك. تجمع بين نتائج تُشغّلها Google ومُقيّمين خارجيين ودرجات يُبلغ عنها مزوّدون، لذا فإن هيكلة الوكلاء وميزانيات التفكير ليست متطابقة عبر كل إدخال.
GraphWalks: تستخدم المجموعة الفرعية المذكورة 200 مشكلة وتبلغ عن BFS F1.
Agents’ Last Exam: يستخدم التقييم مجموعة مهام v1.1 تضم 122 مهمة، وإطار ALE-Claw، ونافذة مدتها خمس ساعات، مع تمكين مرشحات الأمان.
OSWorld: يغطي التقرير مجموعة فرعية دون اتصال تضم 82 مهمة ويأخذ الحد الأقصى عبر ثلاث محاولات فردية.
Coding Performance in Practice
يحسّن Carbon نتيجة Terminal-Bench 4.0 من 57.1% إلى 65.2%، أي مكسب قدره 8.1 نقطة مئوية. ترتفع SWE-sweep من 4.3% إلى 9.6%، ما يزيد الدرجة بأكثر من الضعف مع بقائها دون 10% بالقيمة المطلقة. تدعم هذه النتائج تقييم الأعمال الصعبة على المستودعات، وتُظهر في الوقت نفسه سبب استمرار ضرورة الاختبارات والمراجعات المستقلة.
How Strong Is Gemini 4 Carbon at Cybersecurity?
المعيار ومهمة الأمان
Gemini 4 Carbon
Gemini 4 Argon
الفرق
SEC-bench Pro — اكتشاف الثغرات
88.2%
83.4%
+4.8 نقطة مئوية
ExploitGym — التحقق من الاستغلال
54.8%
42.0%
+12.8 نقطة مئوية
CWE-bench — معالجة الثغرات
71.0%
68.0%
+3.0 نقطة مئوية
أكبر مكسب في التحقق من الاستغلال. بالنسبة لفريق دفاعي مُخوَّل، فإن الدليل القابل لإعادة الإنتاج على أن ثغرة قابلة للاستغلال يمكن أن يُحسّن الأولويات؛ أما الاكتشاف المُحتمل وحده فلا يكفي. لا تزال التصحيحات بحاجة إلى اختبارات تؤكد أن العيب الأصلي قد تم إصلاحه وأن الوظائف القائمة محفوظة.
تُبلغ Google عن تقييمات الأمان الخارجية من دون ضوابط نشر. يستخدم SEC-bench Pro تقسيمة محددة تضم 183 مهمة لمحرك JavaScript؛ ويستخدم ExploitGym إعداداً دون اتصال بمحاولة واحدة مع تعطيل وسائل التخفيف. لا تُثبت هذه الشروط سلوكاً إنتاجياً غير مُقيّد أو معدل كشف لبرمجيات حقيقية عشوائية.
Is Gemini 4 Carbon Safer and More Reliable Than Argon?
انخفضت الادعاءات غير المدعومة بنحو 50% مقارنةً بـ Argon في الاختبارات الداخلية.
انخفض تجاوز الصلاحيات لدى الوكلاء بنسبة 26%.
انخفض نقص الخدمة بنسبة 29%.
انخفضت تنبيهات سوء المواءمة عالية الخطورة بنحو 80% في بيئات البرمجة الداخلية.
انخفض الغش الناجح على Terminal-Bench 4.0 إلى 0.0% في تقييم Google.
على معيار Gray Swan لحقن الأوامر غير المباشر المُقيَّم، يبلغ معدل نجاح الهجمات 0.0% لدى Carbon مقابل 0.7% لدى Argon. هذا يعني أن الهجمات المُقيَّمة لم تنجح في ذلك الإعداد؛ ولا يُثبت المناعة ضد هجمات جديدة أو بيئات أدوات مختلفة.
تأتي هذه الأرقام من تقييمات مختلفة ويجب عدم جمعها في درجة موثوقية واحدة.
بالنسبة لوكيل إنتاجي، حافظ على تحققات أذونات مستقلة، وسجلات تنفيذ، والتحقق من النتائج المُدَّعى بها. يُسهم سلوك النموذج المُحسَّن، لكن التطبيق لا بد أن يواصل التحكّم في الملفات والخدمات والإجراءات التي يمكنه الوصول إليها.
How Much Does the Gemini 4 Carbon API Cost?
أعلنت Google عن أسعار الرموز التمهيدية واللاحقة. الأرقام الخاصة بمدخلات مُخزّنة مؤقتاً أدناه محسوبة من الخصم المُعلن البالغ 95%؛ تفاصيل تنفيذ واجهة برمجة التطبيقات العامة والأهلية ما زالت قيد الانتظار.
فئة الفوترة، USD لكل 1M رمز
السعر التمهيدي
السعر اللاحق
رموز الإدخال
$2.00
$4.00
رموز الإخراج
$10.00
$20.00
رموز الإدخال المخزّنة مؤقتاً المؤهَّلة
$0.10
$0.20
لا تملك فترة Carbon التمهيدية تاريخ انتهاء مُعلن. ينتهي التسعير التمهيدي المنشور لـ Argon في 30 نوفمبر 2026؛ لا ينبغي تطبيق ذلك الموعد على Carbon. لم يُعلن عن تسعير الدُفعات، ورسوم الأدوات الإضافية، ومستوى مجاني لـ Carbon.
Example Request Cost
افترض أن طلباً يستخدم 200,000 رمز إدخال غير مخزّن مؤقتاً و10,000 رمز إخراج قابل للفوترة الإجمالية. عند الأسعار التمهيدية المُعلنة، تكلف رموز الإدخال $0.40 وتكلف رموز الإخراج $0.10، بإجمالي $0.50. ستكلف نفس كمية الرموز $1.00 عند الأسعار اللاحقة.
إذا كانت جميع رموز الإدخال البالغ عددها 200,000 مؤهلة للخصم المُعلن على الإدخال المخزّن مؤقتاً، يصبح التقدير التمهيدي $0.12 شاملاً الإخراج. هذا توضيح مشروط، وليس وعداً بأن كل إدخال مُكرر سيُؤهَّل.
يجب أن يشمل حدّ الإخراج أي رموز تفكير تُفوَّت كإخراج وفق القواعد النهائية المطبّقة. إذا كان 10,000 يشير فقط إلى الإجابة الظاهرة، فإن رموز التفكير الإضافية القابلة للفوترة ستزيد التقدير. الأدوات، وإعادات المحاولة، والخدمات الأخرى مُستبعدة.
How Can Developers Prepare for the Gemini 4 Carbon API?
Current Gemini 4 Carbon API Availability
حتى 29 أكتوبر 2026، يبدأ الوصول مع مدافعين سيبرانيين مختارين ويتوسع تدريجياً إلى شركاء موثوقين. يصف Fairwind Program من Google مسار وصول مُتحكَّماً. لم يُعلن تاريخ إصدار مطوّر واسع ولا مُعرِّف نموذج Carbon العام.
لا يعني التسعير المُعلن بالضرورة أن تطبيقاً يمكنه استدعاء واجهة Carbon العامة اليوم. حدود السياق العامة النهائية، والحد الأقصى للإخراج، ومخطط الوسائط، وتوافق الأدوات، وحدود التشغيل ما زالت بحاجة إلى مواصفات إنتاجية موثّقة.
حتى 29 أكتوبر 2026، لم تُطلق Google واجهة Carbon العامة المتاحة على نطاق واسع، لذا فإن Carbon غير متاح بعد عبر CometAPI. ريثما تنتظر، يمكنك استخدام Gemini 4 Argon للتقييم الأولي. راجع صفحة CometAPI الخاصة بـ Carbon لمعرفة مدى التوفر وتسعير المزوّد عند فتح الوصول.
Alternatives While You Wait for the Carbon API
يمكنك البدء بتقييم سير عمل البرمجة قبل أن يصبح Carbon متاحاً على نطاق واسع. ابنِ خط أساس باستخدام نموذج يمكنك الوصول إليه اليوم، ثم قارن Carbon على المهام نفسها عندما تُفتح واجهته. ثلاثة خيارات للنظر فيها هي Gemini 4 Argon وGPT-6.1 Astra وClaude Opus 5.5؛ أكّد اسم النموذج الدقيق والوصول والسعر مع مزوّدك قبل اختيار المسار.
Gemini 4 Argon: ابدأ هنا إذا كنت تستخدم Gemini بالفعل أو تريد خط أساس مباشر لـ Carbon. جرّب تغييرات ممثّلة على المستودعات، ومراجعات الشيفرة، وإصلاحات العلل، وسجّل أي المخرجات تجتاز اختبارات القبول لديك.
**GPT-6.1 Astra:** ضمّه كمقارنة عبر مزوّدين للمهام الهندسية نفسها. قِس الإصلاحات المقبولة، وزمن الإتمام، والتكلفة الإجمالية. تنطبق نتائج GPT-6 Astra المذكورة سابقاً على تلك النسخة المُقَيَّمة ولا ينبغي اعتبارها درجات GPT-6.1 Astra.
**Claude Opus 5.5:** أضِفه كمرشح آخر لتحليل المستودع، وإعادة الهيكلة، والمراجعة. استخدم أوصاف المهام نفسها ومعايير التحقق بحيث يمكنك مقارنة القيمة العملية لكل نتيجة.
اجعل اختيار النموذج قابلاً للتهيئة واحفظ المطالبات، وحالات الاختبار، ونتائج كل تشغيل. يمنحك ذلك نقطة انطلاق مفيدة لتقييم Carbon من دون ربط سير عملك بتنسيق واجهة غير مُعلن.
المعيار
Gemini 4 Carbon
Gemini 4 Argon
GPT-6 Astra
Claude Opus 5.5
AA Intelligence Index v5.0
59
50
57
58
Vals Index v2.2
70.4%
69.2%
65.0%
70.2%
SWE-sweep
9.6%
4.3%
9.5%
3.6%
FrontierSWE 2
61.2%
55.0%
65.5%
62.3%
Terminal-Bench 4.0 (AA)
65.2%
57.1%
59.1%
59.6%
Agents' Last Exam v1.1
77.4%
69.0%
73.1%
71.6%
OSWorld-2.1، مجموعة دون اتصال
81.5%
74.7%
80.9%
87.2%
AutomationBench، Zapier
53.9%
51.3%
41.4%
42.5%
Prepare a Model Evaluation Workflow
يجب أن يقيس إطار تقييم عملي أكثر من جودة الإجابة العامة.
بالنسبة لسير عمل البرمجة والأمان، تشمل المقاييس المفيدة:
معدل إتمام المهام: كم مرة يُرضي الوكيل اختبارات القبول المحددة مسبقاً؟
صحة التصحيحات: هل يعالج التغيير المقترح العيب الأصلي من دون كسر السلوك القائم؟
معدل الإيجابيات الكاذبة: كم مرة يفشل الاكتشاف المُبلغ عنه في التحقق؟
زمن التأخير من الطرف إلى الطرف: كم يستغرق سير العمل الكامل، بما في ذلك تنفيذ الأدوات؟
تكلفة المهمة الإجمالية: ما تكلفة كل نتيجة مقبولة بعد الإعادات والأدوات المستخدمة؟
الالتزام بالتعليمات: هل يبقى الوكيل ضمن الملفات والأدوات والإجراءات المصرّح بها؟
استخدم مجموعة ثابتة من المهام الحقيقية واحتفظ بسجل لكل نموذج، وإعداداته، واستخدام الرموز، ونتائج الاختبار. أدرج الإعادات والتصحيحات اليدوية ضمن التكلفة. بمجرد توفر Carbon، شغّل التقييم نفسه لترى ما إذا كان يُقدّم عملاً مقبولاً أكثر لوقتك وميزانيتك.
Conclusion
Gemini 4 Carbon ترقية واعدة لأعمال البرمجة الصعبة، والاستدلال في سياق طويل، والعمل الأمني الدفاعي. تُظهر نتائجه المنشورة مكاسب واضحة على Argon، بينما يبقى الوصول الأولي محدوداً حتى 29 أكتوبر 2026. حالياً، أنشئ خط أساس بنموذج متاح وأبقِ تكاملك مرناً. عندما تُفتح واجهة Carbon العامة، قارن جودة العمل المُنجز، والوقت المُوفَّر، والتكلفة الإجمالية قبل تقرير ما إذا كان ينبغي التحويل.
FAQ
هل يمكن لـ Gemini 4 Carbon العمل دون إشراف بشري؟
تقارير العمل الهندسي الداخلي على مدى أيام لا تُثبت موثوقية غير مراقبة لمهام عشوائية. يجب على الفريق الذي يفكر في تنفيذ مستقل تحديد الإجراءات المسموح بها، وشروط الإيقاف، واختبارات القبول، ثم قياس عدد المرات التي يُنهي فيها الوكيل العمل من دون تصحيح. مدة التشغيل وحدها لا تُظهر أن مخرجات الوكيل صحيحة.
هل يمكن لدمج Argon القائم التبديل مباشرةً إلى Carbon؟
ليس بالاستناد إلى الأدلة المتاحة هنا. أبقِ اختيار المزوّد قابلاً للتهيئة، لكن تحقّق من مُعرِّف Carbon الفعلي، والمخطط المدعوم، والأدوات، والحدود، والوصول إلى الحساب قبل تغيير النشر. قد يساعد إعادة استخدام مطالبة في مقارنة مُتحكَّمة؛ لكنه لا يُثبت توافق واجهات برمجة التطبيقات.
أي اختبارات Gemini 4 Carbon تهم لقاعدة شيفرة خاصة؟
أدرج عللاً ممثّلة، وتغييرات على المستودع، ونتائج أمنية مع معايير قبول معروفة. تحقّق مما إذا كانت التصحيحات تجتاز الاختبارات ذات الصلة، وما إذا كانت الاكتشافات قابلة لإعادة الإنتاج، وما إذا كانت تحدث تغييرات على سلوك غير ذي صلة. ضمّن المحاولات الفاشلة والتصحيح اليدوي في تحليل التكلفة كي لا يُخفي سجل عام قوي عبء العمل التشغيلي.