Byg med CometAPIHar du brug for én API til flere modeller?Test workflowet i Playground, og opret derefter en API-nøgle, når model og pris passer til dit brugsscenarie.
Sådan bruger du GPT-6 Astra API: Komplet udviklerguide - CometAPI
Sådan bruger du GPT-6 Astra API: Komplet udviklerguide
Sådan bruger du GPT-6 Astra API via CometAPI med eksempler på Responses API, styring af ræsonnering, billedinput, struktureret output, værktøjer, prissætning og migrering.
GPT-6 Astra API in CometAPI er bedst egnet til svære, værktøjsrige arbejdsgange, hvor kvalitetsniveauet betyder mere end laveste tokenpris. Modellen understøtter et kontekstvindue på 1.050.000 tokens, 128.000 outputtokens, billedinput, strukturerede output, streaming, funktionskald og fem ræsonneringsniveauer. Start med Responses API, medium ræsonnering, et snævert sæt værktøjer og en evaluering, der måler omkostning pr. accepteret opgave. CometAPIs aktuelle basistakster pr. token er 20% under de tilsvarende OpenAI-takster.
Key Takeaways
Astra er optimeret til hårdt end-to-end-arbejde, inkl. kodning, computerbrug, research og professionel automatisering.
Brug Responses API til nye, værktøjsdrevne integrationer.
Vælg det laveste ræsonneringsniveau, der består din arbejdsmængdeevaluering; understøttes ikke.
Gennemgået for klarhed, kildeangivelse og aktuel API-terminologi.
none
Hold prompts under 272K-grænsen for lang kontekst, når det er muligt, da den højere takst gælder for hele forespørgslen.
Offentlige evalueringer viser højere resultater og lavere estimeret API-omkostning pr. opgave i flere svære arbejdsmængder, men produktionruting bør baseres på din egen accepteringsrate.
GPT-6 Astra API Quick Start
Opret en CometAPI-nøgle og gem den i en miljøvariabel.
Installer OpenAI SDK.
Send en Responses API-anmodning med model="gpt-6-astra".
Tilføj en stram outputkontrakt og valider resultatet.
Tilslut kun de værktøjer, som arbejdsgangen kræver.
Test integrationen på repræsentative opgaver før produktion.
What Is the GPT-6 Astra API?
OpenAIs mest kapable model til det hårdeste end-to-end-arbejde er designet til kompleks ræsonnering, kodning, computerbrug, research og dokumentoprettelse. I en API-applikation ligger Astras værdi i at bevare intentionen på tværs af lange arbejdsgange, kalde værktøjer, fortolke resultater og fortsætte, indtil applikationens fuldførelseskriterier er opfyldt.
Udfordringen ved integration er orkestrering: giv den rette kontekst, udfør de ønskede værktøjer, inspicér deres resultater og stop, når applikationens fuldførelseskriterier er opfyldt.
GPT-6 Astra API vs GPT-5.6 Sol: What Is New?
OpenAIs aktuelle modelvejledning beskriver Astra som stærkere på vanskelige flertrins arbejdsgange og ofte med færre outputtokens. Den tilføjer også kontroller, der betyder noget for langvarige agenter: asynkrone værktøjsopkald, styring midt i turen, ændring af ræsonnering under en samtale og misalignment-overvågning.
Dimension
GPT-6 Astra
GPT-5.6 Sol
Primær rolle
Det sværeste end-to-end-arbejde
Komplekst professionelt arbejde til lavere tokenpris
Kontekst / maks. output
1,05M / 128K
1,05M / 128K
Vidensafskæring
30. april 2026
16. februar 2026
Asynkrone værktøjsopkald
Understøttet
Brug konventionel koordinering af værktøjsresultater
Styring midt i turen
Understøttet via Responses WebSocket
Brug efterfølgende tur eller applikationsstyret restart
Ændre ræsonnering midt i samtale
configuration_update i kompatible flows
Sæt niveau på forespørgselsniveau
reasoning none
Ikke understøttet
Understøttet
OpenAI Standard input / output
$10 / $50 pr. 1M
$4 / $20 pr. 1M
Bedste routing-rolle
Eskalering til højkompleks arbejde
Standard til bredere komplekst trafikbillede
Opgraderingen er ikke en blanket-erstatning. Brug Sol, når den pålideligt klarer opgaven; rout til Astra, når værktøbsdybde, lang kontekst, retries eller menneskelig korrektion gør den billigere model dyrere i praksis.
En eksisterende OpenAI SDK-integration kan beholde sit klientbibliotek og blot ændre nøgle, base_url og model-ID. Brug samme gateway, når du router egnet arbejde til GPT-5.6 Sol.
Step 1: Get a CometAPI API Key
Opret en nøgle i CometAPI-dashboardet og gem den uden for kildekoden. Brug en sekretmanager i produktion.
export COMETAPI_KEY="your_api_key"
$env:COMETAPI_KEY = "your_api_key"
Step 2: Install the OpenAI SDK
Installer det aktuelle SDK til dit applikationssprog.
python -m pip install -U openai
npm install openai
Step 3: Make Your First Request
Brug /v1/responses til nye integrationer, særligt når arbejdsgangen senere skal tilføje værktøjer eller strukturerede output.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
    timeout=120.0,
    max_retries=2,
)

response = client.responses.create(
    model="gpt-6-astra",
    input="Give three practical ways to reduce API latency.",
    reasoning={"effort": "medium"},
)

if response.status != "completed":
    raise RuntimeError(f"Unexpected status: {response.status}")

print(response.output_text)
Step 4: Test Before Production
Kør repræsentative opgaver gennem både kandidat- og fallbackruter. Registrér accepteringsrate, latenstid, retries, input- og outputtokens, værktøjsfejl og tid til menneskelig korrektion. Promovér Astra kun dér, hvor resultatet forbedrer arbejdsgangens reelle fuldførelsesøkonomi.
Betragt ikke en vellykket demoprompt som produktionsvalidering. Medtag tvetydige input, værktøjsfejl, manglende data og langvarige forespørgsler i testsettet.
How to Choose Reasoning Effort
De understøttede ræsonneringsniveauer er low, medium, high, xhigh og max. Brug det laveste niveau, der konsekvent opfylder dine acceptkriterier.
Indsatsniveau
Praktisk udgangspunkt
low
Klassifikation, omskrivning og ligefrem udtræk
medium
Generel udvikling, analyse og de fleste første evalueringer
high
Kompleks fejlfinding, arkitektur og multisource-syntese
xhigh
Svær research og lang, flertrins kodningsarbejde
max
Et lille antal af de hårdeste opgaver efter evaluering
How to Use Image Input
Brug en tilgængelig billed-URL eller en understøttet uploadet fil. Kombinér billedet med en specifik inspektionsopgave i stedet for at bede om en generisk beskrivelse.
vision = client.responses.create(
    model="gpt-6-astra",
    input=[{
        "role": "user",
        "content": [
            {"type": "input_text", "text": "Identify one UI defect and propose a fix."},
            {"type": "input_image", "image_url": os.environ["SCREENSHOT_URL"]}
        ]
    }]
)

print(vision.output_text)
How to Use Structured Outputs and Stream Responses
Strukturerede output giver en maskinlæsbar kontrakt; streaming forbedrer den oplevede responsivitet. De løser forskellige problemer og kan bruges sammen. Livscyklusbegivenheder og tekstdeltaer bør håndteres separat.
For portabel historik, gensend de brugerinput og de modeloutput-elementer, der kræves til næste tur. Hvor det understøttes af udbyderen, kan previous_response_id henvise til et lagret svar i stedet.
history = [{"role": "user", "content": "Give three latency improvements."}]
history.extend(
    item.model_dump(exclude={"id"}, exclude_none=True)
    for item in response.output
)
history.append({"role": "user", "content": "Turn them into a checklist."})

follow_up = client.responses.create(
    model="gpt-6-astra",
    input=history,
)
print(follow_up.output_text)
How to Use Function Calling
En komplet funktionsløkke har fire dele: definér skemaet, modtag et værktøjsopkald, udfør det i din applikation, og returnér et function_call_output-element med den originale call_id. Hold værktøjstilladelser minimale og validér alle argumenter før udførelse.
import json
history = [{"role": "user", "content": "Check order A-1042."}]
turn = client.responses.create(model="gpt-6-astra", input=history, tools=tools)
history.extend(item.model_dump(exclude={"id"}, exclude_none=True) for item in turn.output)
for item in turn.output:
if item.type == "function_call"and item.name == "get_order_status":
args = json.loads(item.arguments)
tool_result = {"order_id": args["order_id"], "status": "shipped"}
history.append({
"type": "function_call_output",
"call_id": item.call_id,
"output": json.dumps(tool_result),
})
final = client.responses.create(model="gpt-6-astra", input=history, tools=tools)
print(final.output_text)
How to Use Async Tool Calling
Asynkrone værktøjsopkald lader Astra fortsætte uafhængigt arbejde, mens en langvarig funktion eller et brugerdefineret værktøj er i gang. Sæt async: true i værktøjsdefinitionen, behold den oprindelige call_id, og returnér resultatet, når det eksterne arbejde er færdigt. Din applikation er fortsat ansvarlig for jobkø, timeout-politik, idempotens og genopretning.
Indsend ikke det samme langvarige job igen blot fordi et polling-vindue udløb. Gem job-ID’et og genoptag hentningen.
How to Prompt the GPT-6 Astra API
OpenAIs promptvejledning fremhæver initiativ, instruktionsprioritet, stil, delegering og kalibreret verifikation. En nyttig produktionsprompt bør angive opgaven, tilgængelige ressourcer, fuldførelsestest, grænser, forventet format og hvordan manglende oplysninger håndteres.
Promptkomponent
Hvad der skal specificeres
Opgave
Det konkrete resultat, der skal produceres
Ressourcer
Filer, værktøjer, data og kontekst, der må bruges
Fuldførelsestest
Betingelser, der gør arbejdet færdigt
Grænser
Handlinger tilladt, forbudt eller kræver godkendelse
Stil og format
Længde, struktur, tone og outputskema
Usikkerhed
Hvad må antages, og hvad skal afklares
Verifikation
Hvilke tjek kræves, og hvornår test ophører
Task: Review this API design and identify the three highest-impact migration risks.
Resources: Use the attached schema and deployment notes.
Completion test: Return three risks, evidence for each, and one acceptance test per risk.
Boundaries: Do not change production systems. Infer routine implementation details.
Clarification rule: Ask only if a missing requirement would materially change the result.
Style: Use concise prose and a final three-row table.
Verification: Check that every risk has an executable acceptance test.
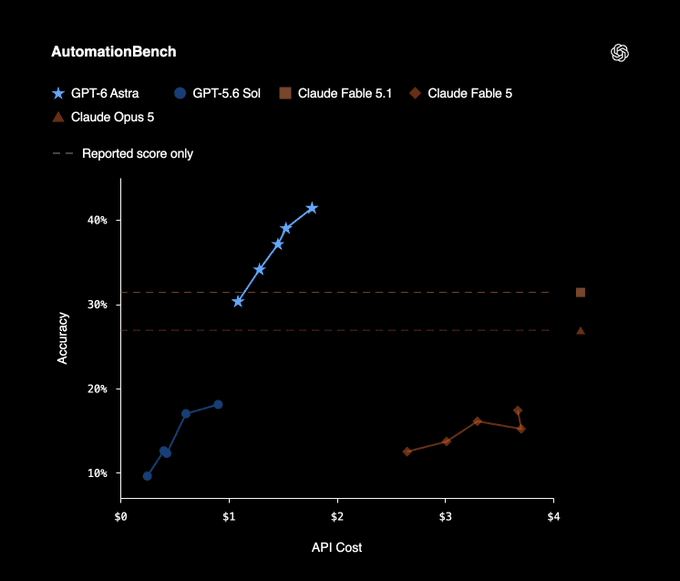
Offentlige evalueringer er mest nyttige, når kvalitet og opgaveøkonomi læses sammen. Benchmarkresultaterne nedenfor viser, hvor Astras gevinster er store; de rapporterede besparelser er konfigurationsspecifikke estimater og ikke garantier for enhver arbejdsmængde.
Offentlig evaluering
Astra
Sol
Forskel
AutomationBench
41,4%
18,1%
+23,3 point
OSWorld 2.0
72,6%
65,7%
+6,9 point
Terminal-Bench 4.0
57,9%
37,3%
+20,6 point
MRCR v2, 512K-1M
96,3%
73,8%
+22,5 point
Officielt OpenAI AutomationBench-diagram: nøjagtighed plottet mod estimeret API-omkostning.
Sammenligning af omkostning pr. opgave
Kvalitetskonfiguration
Sparede API-omkostninger vs Sol
DeepSWE v1.1
74,1% vs 72,7%; højest scorende konfigurationer
Ca. 32%
Database migration
63,4% vs 42,7%; billigere Astra-indstilling
Ca. 38%
Terminal-Bench 4.0
57,9% vs 37,3%; rapporterede konfigurationer
Ca. 9%
Forbindelsen til pris er todelt. For det første kan færre outputtokens og færre fejlede forsøg sænke estimeret API-omkostning pr. fuldført opgave, selv når Astra har en højere pris pr. token. For det andet er CometAPIs aktuelle listede takster 20% under de tilsvarende udbydertakster. Disse effekter er separate: læg ikke procenterne sammen, og antag ikke, at en benchmarkbesparelse reproduceres i produktion.
GPT-6 Astra API Pricing
Prissætning måles pr. million tokens. Når input overstiger 272K tokens, gælder lang-konteksttaksten for hele forespørgslen.
Aktuel prissætning
CometAPI kort kontekst
CometAPI lang kontekst
OpenAI Standard
Input
$8
$16
$10 kort / $20 lang
Cache-læsning
$0,80
$1,60
$1 kort / $2 lang
Cache-skrivning
$10
$20
$12,50 kort / $25 lang
Output
$40
$60
$50 kort / $75 lang
Priser og gateway-politikker kan ændre sig. Bekræft den aktuelle prisopsætning før budgettering eller hardcodede takster.
How to Reduce API Costs
Hold stabile præfikser cache-venlige. Placer fælles instruktioner og værktøjsskemaer før anmodningsspecifikt indhold.
Undgå utilsigtet at krydse 272K. Hent og dedupliker kun den kontekst, der kan ændre svaret.
Brug det lavest beståede ræsonneringsniveau. Eskalér kun, når accepteringsraten forbedres.
Rout enkel trafik andetsteds. Reserver Astra til arbejde, der drager fordel af dets fuldførelsesreliabilitet.
Mål omkostning pr. accepteret opgave. Medtag retries, værktøjsgebyrer og monetariseret menneskelig gennemgang.
How to Migrate to GPT-6 Astra
Når du flytter fra GPT-5.6 Sol, foretag den mindste kompatible ændring og kør samme evalueringssæt igen.
Sæt modellen til gpt-6-astra.
Hvis den gamle rute brugte none eller minimal ræsonnering, start ved low.
Brug Responses til værktøjsopkalds-arbejdsgange.
Fjern ikke-understøttede samplingparametre: temperature, top_p og top_logprobs; fjern også Chat Completions logprobs.
Retest struktureret output, caching, streaming, værktøjssløjfer og udbyderspecifik adfærd.
Sammenlign accepteringsrate, latenstid, retries, tokens og menneskelig korrektion, før du ændrer standardruten.
prompt = "Review this API design and identify migration risks."

baseline = client.responses.create(
    model="gpt-5.6-sol",
    input=prompt,
)

candidate = client.responses.create(
    model="gpt-6-astra",
    input=prompt,
    reasoning={"effort": "medium"},
)
When Should You Use GPT-6 Astra?
Brug Astra, når opgavefejl er dyr, og arbejdsgangen kombinerer ræsonnering med værktøjer, lang kontekst eller flertrins eksekvering.
Fejlfinding i repository-skala, migrering samt test-og-retry-sløjfer.
Browser- eller computerbrugsagenter.
Dyb research på tværs af flere kilder og værktøjer.
Meget lang dokument- eller kodebaseanalyse.
Videnskabelige og tekniske arbejdsgange, der bruger kode eller eksternt software.
Professionel automatisering, hvor en mislykket kørsel skaber væsentlig genopretningsomkostning.
Brug en billigere rute til simpel omskrivning, korte resuméer, klassifikation og rutinemæssig udtrækning, når den allerede opfylder kvalitetsmålet.
Common API Errors
401 Authentication Error
Bekræft, at anmodningen sender Authorization: Bearer <COMETAPI_KEY>, og at processen læser den korrekte miljøvariabel.
400 Bad Request
Tjek for ikke-understøttede samplingparametre, et ugyldigt skema eller en ikke-understøttet ræsonneringsværdi såsom none.
404 Model or Endpoint Error
Bekræft model="gpt-6-astra" og /v1/responses-ruten.
429 Rate Limit
Brug eksponentiel backoff med jitter og et begrænset antal retries.
1 s -> 2 s -> 4 s -> 8 s -> capped retry window
5xx Server Error
Prøv igen ved forbigående serverfejl, men forsøg ikke igen med uændrede, fejlformede 4xx-anmodninger. Log anmodnings-id’er uden unødigt at gemme følsomt promptindhold.
FAQ
What model ID should I use?
Brug gpt-6-astra.
Should I use Responses API or Chat Completions?
Brug Responses til nye integrationer, især til værktøjer, strukturerede output, streaming, tilstand og agentarbejdsgange. Behold Chat Completions kun, hvor kompatibilitetskrav retfærdiggør det.
Which reasoning effort should I start with?
Start med medium, evaluer derefter low til rutinetrafik og high eller derover til opgaver, der målbart gavner af dybere ræsonnering.
Can Astra accept images?
Ja. Den accepterer tekst- og billedinput og returnerer tekstoutput.
Is the CometAPI route always 20% cheaper per completed task?
Nej. De listede tokenrater er 20% under de tilsvarende udbyderrater, men den samlede opgaveomkostning afhænger også af kontekststørrelse, outputlængde, værktøjsopkald, retries og gennemgangsindsats.
Should Astra replace Sol everywhere?
Nej. Sol forbliver det billigere valg for mange afgrænsede arbejdsbelastninger. Brug Astra, hvor stærkere eksekvering, lang-kontekstreliabilitet eller færre fejlforsøg ændrer den samlede økonomi.
Conclusion
Astra er mest værdifuld, når et API-kald er ét trin i en vanskelig arbejdsgang frem for enden af en. Dets lange kontekst, fem ræsonneringsniveauer, strukturerede output, streaming, funktionskald og nye agentkontroller giver udviklere flere måder at føre komplekst arbejde til afslutning på.
Begynd med Responses, medium ræsonnering, klare fuldførelseskriterier og minimumsadgang til værktøjer. Mål accepteringsrate og omkostning pr. accepteret opgave, og øg derefter ræsonneringen eller rout mere trafik til Astra kun, når evidensen understøtter det.