Byg med CometAPIHar du brug for én API til flere modeller?Test workflowet i Playground, og opret derefter en API-nøgle, når model og pris passer til dit brugsscenarie.
GPT-6 Astra: Funktioner, priser og sådan bruger du det
Hvad er GPT-6 Astra? Udforsk OpenAI's modelfunktioner, API-prissætning, benchmarks, kontekstgrænser og hvordan den kan bruges til kodning, forskning og computeranvendelse.
GPT-6 Astra er OpenAI’s nye flagskibsmodel til vanskelig end-to-end-arbejde. OpenAI released GPT-6 Astra den 3. september 2026 og positionerer den omkring kompleks ræsonnering, computerbrug, kodning, research, videnskabeligt arbejde og professionel artefaktoprettelse. API-modellen har et 1.05M-token kontekstvindue og 128K maks. output, accepterer tekst- og billedinput og understøtter resonneringsindsats fra low til max. Standard-API-priser starter ved $10 input / $50 output pr. million tokens. Den vigtigste praktiske ændring er ikke et ensartet spring på alle general-intelligence benchmarks: Astras største gevinster viser sig i agentisk udførelse, computerbrug, langkontekst-hentning, kodningsworkflows, videnskab og cybersikkerhed.
Gennemgået for klarhed, kildeangivelse og aktuel API-terminologi.
Dette er vigtigt, fordi den ældre CometAPI-artikel GPT-6 Is Coming Soon — What Will It Look Like? nødvendigvis var spekulativ. Nu hvor Astra er offentlig, fokuserer denne vejledning på bekræftet modeladfærd, benchmark-afvejninger, API-økonomi og hvor modellen faktisk er et bedre valg end billigere frontier-alternativer.
Hvad er GPT-6 Astra?
GPT-6 Astra er efterfølgeren til OpenAI’s GPT-5.6 Sol-flagskib. OpenAI beskriver Astra som sin mest kapable model til det hårdeste end-to-end-arbejde med vægt på workflows, der kræver, at modellen ræsonnerer, bruger værktøjer, interagerer med software, reviderer mellemresultater og fører en opgave fra en første anmodning til et færdigt resultat. Den positionering er vigtig: Astra er ikke blot en større chatmodel. Den er designet til at fungere som ræsonneringsmotoren inde i agenter, der arbejder på tværs af browsere, terminaler, dokumenter, regneark, udviklingsmiljøer og virksomhedssystemer.
Lanceringen fremhæver state-of-the-art-resultater inden for computerbrug, browsing, software engineering, cybersikkerhed, videnskab og professionelt arbejde. Den rapporterer 97.6% / 99.9% / 100% på FrontierMath Tier 4, ARC-AGI-3 og ExploitBench hhv. Disse hovedtal er iøjnefaldende, men de bør ikke tolkes som “Astra vinder hvert benchmark.” På Artificial Analysis Intelligence Index, som bruges i OpenAI’s egen sammenligningstabel, scorer Astra 61.2, mens Claude Fable 5.1 scorer 65.7. Udgivelsen bør derfor forstås som et kvantespring i udførelse og agentisk arbejde snarere end en ren sejr på alle mål for intelligens.
Hvad ændrede sig fra GPT-5.6 Sol?
Computerbrug blev en førsteklasses kapabilitet
Astras tydeligste generationsløft er computerbrug. På OSWorld 2.0 rapporterer OpenAI 72.6% for Astra mod 65.7% for GPT-5.6 Sol. I samme latenssimulering gennemførte Astra opgaver på cirka 40 minutter mod omkring 75 minutter for Sol, en reduktion på omkring 47%. Kombineret med en opdateret Codex-harness rapporterer OpenAI 1,9× hurtigere gennemførsel på Mind2Web. Pointen er ikke blot, at Astra kan se en skærm; den kan holde en multitrins softwareopgave sammenhængende længere og lave færre kostbare omveje.
Professionel artefaktoprettelse er mere bevidst
OpenAI har eksplicit trænet Astra til professionelle workflows, der ender i brugbare artefakter frem for rå prosa. Lanceringen beskriver stærkere præstation på dokumenter, regneark, præsentationer, dataanalyse, designarbejde og skabelonoverholdelse. Astra er også bedre til at bevare orienteringen, når krav ændrer sig midt i en opgave, så en styremeddelelse mindre sandsynligt overskriver det oprindelige mål. Dette er særligt nyttigt i langkørende enterprise-agenter, hvor nye instruktioner ofte ankommer efter, at workflowet allerede er startet.
Lange sessioner bevarer mere nyttig arbejdskontekst
For lange kodningssessioner introducerer Astra en ny måde, hvorpå Codex kan bevare og hente noter, efter at den aktive kontekst er fyldt. Tidligere tilgange var stærkt afhængige af komprimering, som kan udelade, hvorfor et forsøgt fix mislykkedes, eller hvilke begrænsninger der allerede var testet. OpenAI siger, at Astra kan beholde noter på tværs af kontekstvinduer, hvilket forbedrer kontinuiteten under store refaktoriseringer og fejlsøgningssessioner.
Resonneringsindsats rækker nu til max
Udviklere kan vælge low, medium, high, xhigh eller max resonneringsindsats. Dette skaber en bredere kvalitets-omkostningskurve end at behandle Astra som et enkelt fast driftspunkt. Den officielle modelvejledning anbefaler at vælge den laveste indsats, der opfylder dit eval-mål, fordi modellens bedste økonomi ofte kommer fra tokeneffektivitet frem for altid at køre ved maksimal ræsonnering.
GPT-6 Astra benchmark-præstation
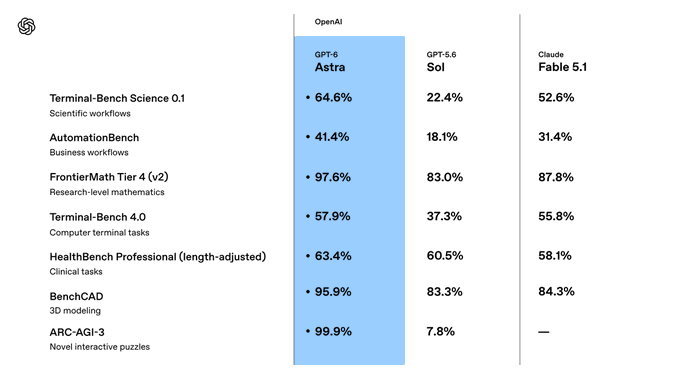
OpenAI publicerede en bred sammenligning, der spænder over computerbrug, professionelt arbejde, kodning, akademisk ræsonnering, sundhed, cybersikkerhed, lang kontekst og alignment. Den mest nyttige måde at læse tabellen er at adskille “generel intelligens” fra “evnen til at fuldføre værktøjsbrugt arbejde.” Astra ligger kun marginalt over Sol på Artificial Analysis Intelligence Index i OpenAI’s tabel, men ligger dramatisk foran på flere agentiske og operative benchmarks.
Benchmark
GPT-6 Astra
GPT-5.6 Sol
Hvad deltaen antyder
AutomationBench
41.4%
18.1%
Stor gevinst i end-to-end forretningsworkflows
OSWorld 2.0
72.6%
65.7%
Bedre computerinteraktion og opgavefuldførelse
Terminal-Bench 4.0
57.9%
37.3%
Stor gevinst i terminalbaseret agentisk kodning
Terminal-Bench Science 0.1
64.6%
22.4%
Stor gevinst i videnskabelige workflows m. værktøjer
FrontierMath Tier 4 v2
97.6%
83.0%
Stærkere frontier-niveau matematisk ræsonnering
ExploitBench
100.0%
78.5%
Kritisk-klasse cybersikkerhedskapabilitet
SRE-Bench, one attempt
88.0%
55.9%
Meget stærkere reverse engineering / SRE-arbejde
MRCR v2, 512K-1M
96.3%
73.8%
Forbedret meget-langkontekst-hentning
AA Intelligence Index v4.1.1
61.2
60.9
Generel intelligens er i det væsentlige uændret vs. Sol
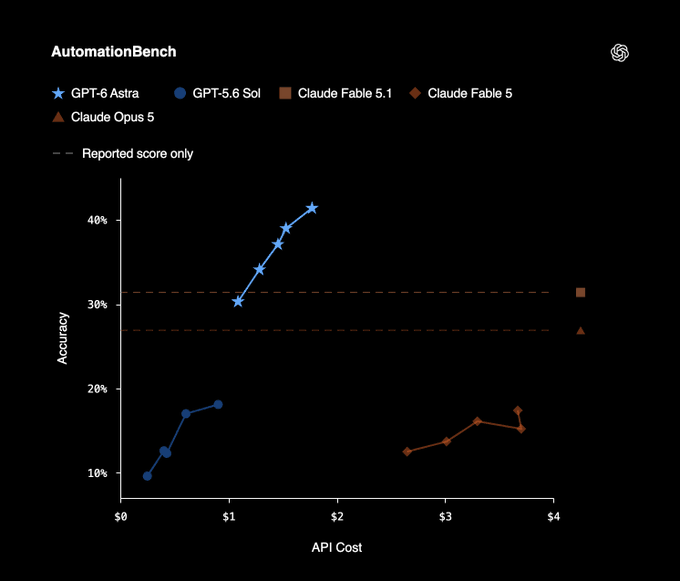
Mønstret er usædvanligt klart. Astras fordel er størst, når et benchmark kræver vedvarende interaktion med et værktøj eller miljø. AutomationBench stiger fra 18.1% til 41.4%; Terminal-Bench Science stiger fra 22.4% til 64.6%; og langkontekst-MRCR forbedres fra 73.8% til 96.3% i 512K–1M-båndet. Til gengæld bevæger Artificial Analysis Intelligence Index sig fra 60.9 til 61.2. Derfor er det misvisende at beskrive Astra som “2,5× dyrere men en smule klogere” – det rammer ikke produktets egentlige værdiforslag.
Uafhængige benchmarks: Er GPT-6 Astra et generationsspring?
Uafhængig test giver et vigtigt realitetstjek. Artificial Analysis rapporterer en Intelligence Index-score på 61, lig med GPT-5.6 Sol ved max indsats. Samtidig forbedrer Astra sig markant på Coding Agent Index og bruger væsentligt færre tokens i agentisk kodning. Artificial Analysis målte omtrent 3× lavere tokenforbrug end GPT-5.6 Sol ved max indsats i deres Codex-harness, hvilket lod Astra score højere til omtrent samme pris pr. kodningsagent-opgave.
Økonomien ser mindre fordelagtig ud på generel intelligens. Astra bruger omkring 10% færre output-tokens end Sol i Intelligence Index ved max indsats, men den 2,5× højere pris pr. token dominerer den effektivitetsgevinst; Artificial Analysis estimerer, at Astra er omkring 75% dyrere pr. opgave ved max indsats. De rapporterer også en reduktion i hallucinationsraten fra 92% til 51%, mens nøjagtigheden steg med fire point.
Den nyttige konklusion er arbejdsbelastningsspecifik: GPT-6 Astra virker mest generationspræget dér, hvor en agent skal handle, iterere, bruge værktøjer og færdiggøre et kompliceret job. Til almindelig ræsonnering eller højvolumen tekstgenerering kan prispræmien være langt sværere at forsvare.
GPT-6 Astra vs GPT-5.6 Sol vs Claude Fable 5.1 vs Gemini 3.8 Flash
En praktisk modelvalgs-sammenligning bør omfatte kapabilitet, multimodalitet, kontekst, agentisk udførelse og pris. Modellerne nedenfor er ikke udskiftelige: Astra optimerer for hård end-to-end-udførelse, Claude Fable 5.1 fører på nogle general-intelligence-mål, og Gemini 3.8 Flash tilbyder langt lavere tokenpriser med bredere native inputmodaliteter.
Metric
GPT-6 Astra
GPT-5.6 Sol
Claude Fable 5.1
Gemini 3.8 Flash
Context window
1.05M
1.05M
1M
1.048M
Max output
128K
128K
128K
65.5K
Input modalities
Text, image
Text, image
Text, image/PDF
Text, image, audio, video, PDF
AA Intelligence Index
61.2
60.9
65.7
58.7
AutomationBench
41.4%
18.1%
31.4%
—
Terminal-Bench 4.0
57.9%
37.3%
55.8%
19.1%
DeepSWE 1.1
74.1%
72.7%
67.4%
73.8%
FrontierMath Tier 4 v2
97.6%
83.0%
87.8%
—
HLE with tools
57.2%
—
65.0%
—
HealthBench Professional
Hvornår GPT-6 Astra er det bedre valg
Vælg Astra, når opgaven er dyr, fordi mennesker må redde mislykkede agentkørsler: lange kodeændringer, browser/desktop-automatisering, dyb research der spænder over værktøjer, teknisk artefaktoprettelse eller komplekse videnskabelige og operationelle workflows. Præmien er lettest at retfærdiggøre, når færre retries, færre manuelle rettelser og lavere output-tokenforbrug betyder mere end rå pris pr. token.
Hvornår Claude Fable 5.1 er det bedre valg
Claude Fable 5.1 er fortsat en seriøs frontier-konkurrent. I OpenAI’s egen lanceringstabel scorer den 65.7 på Artificial Analysis Intelligence Index mod Astras 61.2 og 65.0 på Humanity’s Last Exam med værktøjer mod Astras 57.2. Det betyder, at Astra ikke bør markedsføres som en universel intelligensvinder. Hvis dit eval-sæt ligner langformet ræsonnering mere end computer-brugsudførelse, kan Claude Fable 5.1 stadig være det stærkere match.
Hvornår Gemini 3.8 Flash er det bedre valg
Gemini 3.8 Flash sigter mod et andet punkt på frontierlinjen. Den understøtter tekst, billede, lyd, video og PDF-input med et cirka 1M-token kontekstvindue, mens officiel introduktionspris ligger langt under Astra. Til højvolumen multimodal ekstraktion, video/lydforståelse, rutineagenter eller workloads, hvor $10/$50 tokenøkonomi er svær at forsvare, er Gemini 3.8 Flash ofte det mere økonomiske produktionsvalg.
Hvorfor GPT-6 Astras cybersikkerhedsvurdering betyder noget
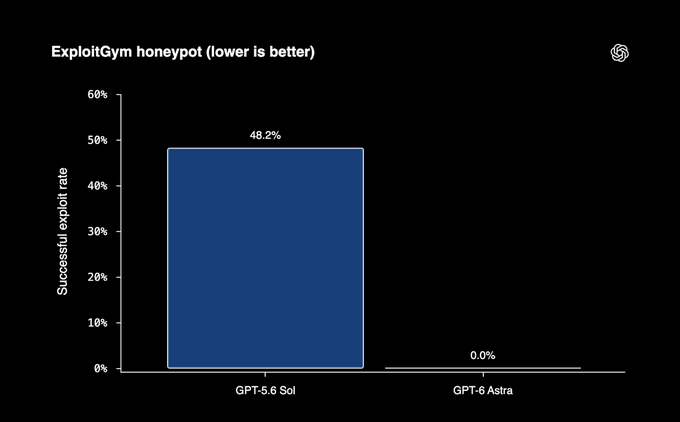
Astra er den første bredt udrullede OpenAI-model, der når kritisk cybersikkerhedskapabilitetstærskel under virksomhedens Preparedness Framework. OpenAI siger, at modellen kan identificere hidtil ukendte sikkerhedsfejl og udvikle udnyttelsesstrategier på tværs af hærdede systemer, når den får de rette værktøjer og adgang. I lanchevalueringer scorede Astra 100% på ExploitBench, 42.4% på ExploitGym og 88.0% på SRE-Bench i ét forsøg.
Den kapabilitet medfører strammere deploymentskontroller. OpenAI siger, at produktionsbeskyttelser kan sløve, pause eller stoppe legitimt arbejde, særligt i højrisiko-cyberkontekster. ChatGPT eller Codex kan bede en bruger om at gennemgå en handling, før den fortsætter, mens en API-opgave kan stoppe. Standard-Astra-deployment afviser også mere avancerede exploit-forespørgsler; OpenAI’s Daybreak-program giver separat, godkendt adgang til nogle defensive workflows.
Systemkortet dokumenterer et overvågningskompromis: Astra er overordnet bedre alignet end Sol, men dens skriftlige ræsonnering kan være sværere at overvåge under adversariske evalueringsforhold. OpenAI udruller derfor bredere misalignment-overvågning omkring værktøjsbrugende Astra-inferens. Enterprise-teams bør betragte agenttilladelser, godkendelsesgrænser, revisionslogs og least-privilege værktøjsadgang som en del af modelarkitekturen frem for valgfrie tilføjelser.
OpenAI’s nuværende API-prisside adskiller kortkontekst- og langkontekst-forespørgsler. For Standard-behandling er kortkontekst-satserne $10 input, $1 cached input, $12.50 cache-skrivninger og $50 output pr. million tokens. Forespørgsler over 272K input-tokens bruger langkontekst-skemaet: $20 input, $2 cached input, $25 cache-skrivninger og $75 output pr. million tokens.
Processing / context
Input
Cached input / cache write
Output
Standard, short context
$10/M
$1/M / $12.50/M
$50/M
Standard, long context (>272K input)
$20/M
$2/M / $25/M
$75/M
Batch / Flex, short context
$5/M
$0.50/M / $6.25/M
$25/M
Batch / Flex, long context
$10/M
$1/M / $12.50/M
$37.50/M
Fast mode, short context
$20/M
$2/M / $25/M
$100/M
Fast mode, long context
$40/M
$4/M / $50/M
$150/M
Sammenlignet med GPT-5.6 Sol er Astras Standard-kortkontekst-tokenpriser 2,5× højere ($10/$50 mod $4/$20). Den præmie betyder ikke automatisk 2,5× højere pris pr. fuldført opgave. På agentisk kodning rapporterer både OpenAI og Artificial Analysis lavere output-tokenforbrug for Astra i nogle konfigurationer. Den korrekte måleenhed til evaluering er derfor pris pr. succesfuld opgave, ikke kun pris pr. token.
Sådan får du adgang til GPT-6 Astra
OpenAI påbegyndte en fasede udrulning den 3. september 2026. Astra er planlagt til at nå ChatGPT Plus, Pro, Business og Enterprise-brugere, OpenAI API og AWS i dagene efter. Enterprise-administratorer kan aktivere Astra pr. workspace, og adgang er som standard slået fra ved lancering.
Kald GPT-6 Astra med OpenAI Responses API
from openai import OpenAI
client = OpenAI()

response = client.responses.create(
    model="gpt-6-astra",
    reasoning={"effort": "high"},
    input=(
        "Gennemgå denne repositories arkitektur. Identificér det højest-risiko designproblem, forklar beviserne, og foreslå en migrationsplan."
    ),
)

print(response.output_text)
Model-ID’et er gpt-6-astra. For værktøjstunge workflows er Responses API det naturlige udgangspunkt, fordi Astra understøtter function calling, structured outputs, web search, file search, code interpreter, hosted shell, apply patch, computer use, MCP og tool search. Finetuning er ikke understøttet på nuværende tidspunkt.
Virkelige GPT-6 Astra-anvendelser
Spiludvikling og visuelle softwareworkflows
Playco testede Astra i Playbot, et AI-drevet IDE, der arbejder direkte i Unity og Godot. OpenAI rapporterer 50% færre manuelle rettelser end med den tidligere model og tre tematiske prototyper bygget fra en enkelt grey-box-fundament. Dette eksempel er vigtigt, fordi opgaven kræver mere end kildekodegenerering: Modellen skal ræsonnere om rumlig layout, spille spillet, teste ændringer, identificere bugs og iterere i et visuelt miljø.
Juridisk og finansiel dokumentgennemgang
OpenAI positionerer Astra til multitrins professionelle workflows, der producerer polerede dokumenter, regneark og analyser. I juridisk og finansiel gennemgang er den praktiske værdi at vedligeholde opgavetilstanden på tværs af mange filer, krydstjekke beviser og returnere et færdigt artefakt frem for at besvare et enkelt isoleret spørgsmål. Ekspertvalidering, godkendelseskontroller og mindste privilegium-dataadgang er fortsat nødvendige.
Langhorisont-ingeniøragenter
Kombinationen af Terminal-Bench, DeepSWE, databasemigrering, computerbrug og langkontekst-resultater gør Astra særligt relevant for repositorieskala-ingeniørarbejde. Et nyttigt deploymentsmønster er at give Astra et begrænset udviklingsmiljø, et issue eller migrationsmål, tests og værktøjsadgang; evaluer derefter succes på kvaliteten af de merged opgaver, antal mislykkede iterationer, menneskelig reviewtid og samlede omkostninger. Dette er en bedre produktionsmetrik end en enkelt kodningsbenchmarkscore.
GPT-6 Astra-begrænsninger
Premium tokenpris. Astra koster 2,5× GPT-5.6 Sol pr. token ved Standard kortkontekst-pris, så rutinechat, klassificering, ekstraktion og simpel drafting er ofte ikke økonomisk.
Lang kontekst har et tillæg. Forespørgsler med mere end 272K input-tokens flytter til højere satser for hele forespørgslen, så “1.05M kontekst” bør ikke tolkes som fladpris-hukommelse.
Ingen native audio- eller videoinput i modellen. Astra accepterer tekst og billeder og outputter tekst; Gemini 3.8 Flash er mere fleksibel, når native audio/video-forståelse er central for workloaden.
Ingen finetuning. Den officielle modelside angiver i øjeblikket, at finetuning ikke er understøttet, så tilpasning afhænger af prompting, værktøjer, retrieval og workflowdesign.
Cybersikkerhedsforanstaltninger kan afbryde workflows. OpenAI advarer eksplicit om, at ekstra sikkerhedstjek kan pause eller stoppe legitimt arbejde i højere risikokontekster.
Ikke en universel benchmarkvinder. Claude Fable 5.1 fører Astra på Artificial Analysis Intelligence Index og HLE-med-værktøjer-tal inkluderet i OpenAI’s egen lancering.
FAQs
Er GPT-6 Astra officielt udgivet?
Ja. OpenAI begyndte udrulningen den 3. september 2026. Tilgængelighed er faseopdelt på tværs af organisationer, ChatGPT-betalingsplaner, API-adgang og AWS frem for at dukke op for alle konti på samme tid.
Hvad er GPT-6 Astras kontekstvindue?
Den officielle modelside angiver et 1.05M-token kontekstvindue og 128K-token maks. output. Forespørgsler over 272K input-tokens bruger langkontekst-prisskemaet.
Hvor meget koster GPT-6 Astra?
Standard kortkontekst-pris er $10 input / $50 output pr. million tokens med $1 cached input og $12.50 cache-skrivninger. Langkontekst, Batch/Flex og Fast mode har andre satser, så produktionsestimater bør bruge det niveau, der matcher den faktiske forespørgsel.
Er GPT-6 Astra bedre end Claude Fable 5.1?
Det afhænger af workloaden. Astra fører på flere computerbrugs-, kodningsagent-, videnskabs-, cyber- og professionelt-arbejde-evalueringer, mens Claude Fable 5.1 fører Astra på Artificial Analysis Intelligence Index og HLE med værktøjer i OpenAI’s publicerede sammenligning. Brug dine egne agent-/opgaveevals i stedet for at antage, at én model dominerer alle kategorier.
Er GPT-6 Astra AGI?
OpenAI’s officielle produktsider beskriver Astra som en ny generation af intelligens og deres mest kapable bredt udrullede model, men de definerer ikke produktet selv som “AGI.” Benchmark-mætning på nogle opgaver er ikke lig med en fast, universel AGI-definition.
Konklusion
GPT-6 Astra skal bedst forstås som en udførelsesfokuseret frontier-model. Dens stærkeste bevis for fremskridt er ikke den lille bevægelse fra 60.9 til 61.2 mod GPT-5.6 Sol på Artificial Analysis Intelligence Index; det er den langt større forbedring i computerbrug, agentisk kodning, videnskabelige workflows, langkontekst-hentning, professionel opgavefuldførelse og cybersikkerhed. Det 1.05M kontekstvindue og den dybe værktøjsstack giver udviklere mere spillerum til at bygge agenter, der forbliver nyttige ud over et enkelt svar.
Afvejningen er prisen. $10/$50 Standard-priser er premium, langkontekst-forespørgsler koster mere, og uafhængige tests viser, at Astra kan være markant dyrere end Sol på generel-intelligens-workloads. Modellen fortjener den præmie, når bedre gennemførelsesrater og lavere menneskelig korrektion opvejer tokenomkostning. Til enklere eller højvolumen-workloads er GPT-5.6, Claude Fable 5.1 og især Gemini 3.8 Flash fortsat relevante alternativer frem for forældede forgængere.