
TL;DR
Z.AI ha nombrado públicamente GLM-6.0 y ha situado Full Self-Training en el centro de su hoja de ruta de próxima generación. La dirección divulgada conecta la experiencia autogenerada a través del preentrenamiento, entrenamiento intermedio y posentrenamiento con autoevaluación y corrección, convirtiendo el entrenamiento en un bucle de retroalimentación controlado en lugar de una única pasada de generación de datos.
La parte difícil es el control: GLM-6.0 necesitaría depurar datos sintéticos, detectar y reparar errores, detener iteraciones improductivas y evitar que su evaluador recompense atajos. Esos mecanismos plantean preguntas prácticas sobre verificación independiente, seguridad, coste y gobernanza. Dado que no se ha hecho pública ninguna ficha del modelo, conjunto de benchmarks, especificación de API, precio ni fecha de lanzamiento completos, el artículo evalúa la arquitectura de entrenamiento y sus evidencias, no especificaciones especulativas.
Conclusiones clave para GLM 6.0
- La evidencia pública más sólida se refiere al sistema de Full Self-Training, no a un recuento de parámetros filtrado o a un resultado de benchmark.
- La dirección divulgada abarca datos autogenerados, entornos de entrenamiento autoconstruidos y optimización de infraestructura asistida por modelos.
- El bucle de retroalimentación previsto se extiende por el preentrenamiento, entrenamiento intermedio y posentrenamiento, en lugar de tratar el autoentrenamiento como una técnica exclusiva del posentrenamiento.
- El modelado multimodal nativo, el aprendizaje por refuerzo de mayor horizonte temporal, la planificación, el uso de herramientas, la recuperación y la verificación son direcciones de investigación relevantes, pero aún no son especificaciones publicadas de GLM 6.0.
- Ox Alpha no es evidencia de un rendimiento filtrado de GLM 6.0; Z.AI lo identificó como la identidad previa al lanzamiento de GLM-5.3-Flash.
¿Qué ha confirmado realmente Z.AI sobre GLM 6.0?
El material público de Z.AI establece cuatro señales concretas: el nombre GLM-6.0, Full Self-Training como la dirección central de entrenamiento, un bucle previsto que abarca preentrenamiento, entrenamiento intermedio y posentrenamiento, y un mecanismo de autoevaluación y corrección. La empresa también afirma que aproximadamente el 60% de los ingresos netos están destinados a apoyar modelos de próxima generación, Full Self-Training, entrenamiento a gran escala, inferencia, cómputo e infraestructura relacionada.
Marco de Full Self-Training de Z.AI
Full Self-Training se presenta como la idea organizadora de GLM-6.0, no como una pequeña característica de posentrenamiento. El sistema previsto generaría experiencia de entrenamiento, aprendería de los resultados, filtraría muestras débiles y repetiría el ciclo bajo controles de calidad explícitos.
Autoentrenamiento de GLM-6.0 en pre-, medio y posentrenamiento
La secuencia divulgada —preentrenamiento, entrenamiento intermedio y posentrenamiento— implica que la experiencia autogenerada podría influir en el conocimiento fundacional, el modelado de capacidades y la alineación con tareas, en lugar de aparecer solo durante la afinación final. Z.AI no ha divulgado los conjuntos de datos, límites entre etapas ni proporciones de mezcla, por lo que esto debe tratarse como una dirección confirmada, no como una receta completa.
Mecanismo de autoevaluación y corrección de GLM-6.0
La hoja de ruta vincula Full Self-Training con autoevaluación, detección de errores, corrección y autopurificación de datos. En términos prácticos, el modelo necesitaría juzgar trayectorias, revisar pasos fallidos, descartar datos no confiables y decidir cuándo la iteración adicional ya no mejora el rendimiento medido de forma independiente. El diseño del evaluador y las reglas de detención no han sido divulgados.
El GLM-6.0 and Full Self-Training disclosure debe leerse junto con la public proceeds allocation de Z.AI.
Lo que sabemos vs lo que no sabemos
El registro público respalda una hoja de ruta, pero no una especificación terminada. La tabla separa la dirección confirmada de las preguntas abiertas para que el artículo no convierta la intención divulgada en una afirmación de producto no respaldada.
| Afirmación | Estado de la evidencia | Qué está respaldado | Qué sigue siendo desconocido |
|---|---|---|---|
| Nombre GLM-6.0 | Identificado públicamente | Z.AI ha nombrado el modelo de próxima generación GLM-6.0. | Fecha de lanzamiento y posicionamiento final. |
| Full Self-Training | Hoja de ruta confirmada | Es una prioridad estratégica declarada. | Detalles de implementación y comportamiento de escalado. |
| Preentrenamiento → Entrenamiento medio → Posentrenamiento | Dirección confirmada | Se pretende que el autoentrenamiento abarque el ciclo de entrenamiento. | Conjuntos de datos, validadores, límites de etapa y proporciones de datos. |
| Autoevaluación y corrección | Objetivo confirmado | La hoja de ruta incluye autopurificación, detección de errores y corrección. | Fiabilidad, verificación independiente y criterios de detención. |
| Especificaciones | No divulgadas | No hay especificación pública completa. | Parámetros, ventana de contexto, modalidades, precio e identificador de API. |
| Benchmarks | No divulgados | No hay conjunto de resultados oficial de GLM-6.0. | Puntuaciones, metodología y resultados reproducibles de forma independiente. |
Qué es Full Self-Training y cómo funciona
Full Self-Training es un bucle de aprendizaje cerrado en el que un modelo ayuda a crear tareas o entornos, las intenta, evalúa las trayectorias resultantes, corrige pasos débiles e introduce la experiencia aceptada de nuevo en el entrenamiento. El cambio importante es pasar de una canalización de datos sintéticos de una sola vez a un proceso continuamente controlado.
- Generar: construir problemas, entornos de herramientas y rutas de solución candidatas.
- Actuar: completar tareas y conservar acciones, observaciones y razonamientos intermedios como trayectorias.
- Evaluar y corregir: puntuar resultados con verificadores, detectar errores, revisar pasos fallidos y rechazar muestras de baja confianza.
- Entrenar y detener: aprender de la experiencia aceptada y continuar solo mientras evaluaciones independientes muestren mejoras útiles.
Extender este bucle a través del preentrenamiento, entrenamiento intermedio y posentrenamiento permitiría a GLM-6.0 mejorar la calidad de los datos, el modelado de capacidades y la alineación con tareas en diferentes etapas. La arquitectura aún depende de evaluadores confiables: sin comprobaciones independientes, el autoentrenamiento puede recompensar sus propios puntos ciegos.
¿Cómo podría cambiar Full Self-Training a GLM 6.0?
El diseño divulgado se entiende mejor como una arquitectura de sistema que como un único bloque Transformer nuevo. Intenta cerrar el bucle alrededor del modelo para que el propio modelo ayude cada vez más a generar los recursos necesarios para el siguiente ciclo de entrenamiento.
¿Cómo podría GLM 6.0 producir datos de entrenamiento?
El primer bucle es la autoproducción de datos. En lugar de depender solo de conjuntos de datos escritos por humanos o recopilados externamente, los modelos pueden usar auto-juego, comprobaciones basadas en reglas, resultados de ejecución, evaluación por modelos y verificaciones puntuales humanas para generar y filtrar nuevos ejemplos. Los ejemplos aceptados vuelven a fluir al preentrenamiento, entrenamiento intermedio y posentrenamiento.
La restricción importante es la verificación: la generación sintética de bajo coste solo es útil cuando el sistema puede identificar ejemplos correctos, diversos y no degenerados. Un bucle práctico es generación del modelo → ejecución de tareas → verificación por reglas o herramientas → filtrado → reentrenamiento.
¿Cómo podría GLM 6.0 construir entornos de entrenamiento?
El segundo bucle es la autoconstrucción de entornos. Los agentes pueden recopilar o transformar tareas del mundo real, intentar esas tareas, crear validadores y comprobar si la tarea es realmente resoluble antes de que se convierta en material de entrenamiento. Esto es especialmente importante para programación y trabajo de agentes, donde el estado del terminal, la salida de herramientas, el estado del navegador, los resultados de pruebas y la recuperación ante fallos proporcionan una supervisión más sólida que las respuestas solo de texto.
El objetivo de evaluación cambia de si una respuesta suena plausible a si una acción tiene éxito, el resultado es verificable de forma independiente y el agente puede recuperarse tras el fallo.
¿Cómo podría GLM 6.0 optimizar su infraestructura de entrenamiento?
El tercer bucle es la auto-optimización de la infraestructura. En la práctica, esto se interpreta mejor como ingeniería de sistemas asistida por IA: un modelo de programación sólido propone cambios en operadores, kernels, planificación, caché o código de servicio, mientras que benchmarks automatizados y validación controlada por humanos determinan qué cambios se aceptan.
El ciclo resultante es mejor modelo → mejores propuestas de sistemas → ganancias de eficiencia validadas → más experimentos de entrenamiento → mejor modelo. La revisión humana y los benchmarks reproducibles siguen siendo puntos de control, no extras opcionales.
¿Qué nos dice la línea base actual de GLM 5.3 Flash sobre GLM 6.0?
Dado que GLM 6.0 no tiene ficha del modelo pública, la comparación más defendible separa las capacidades GLM actuales y medidas de la dirección de próxima generación. Z.AI describe GLM-5.3-Flash como un modelo MoE de 320B total y 18B activo entrenado en un corpus multimodal de 30T tokens. Estas son especificaciones de GLM-5.3-Flash, no especificaciones de GLM 6.0.
| Dimensión de comparación | API de GLM-5.3-Flash en CometAPI | Dirección divulgada de GLM 6.0 |
|---|---|---|
| Estado de lanzamiento | Disponible | En desarrollo; el nombre del producto final no está establecido de forma independiente por el documento citado |
| Parámetros | 320B total / 18B activo | No divulgados |
| Arquitectura principal | MoE; atención dispersa híbrida + lineal; mHC | No divulgada a nivel de bloque |
| Datos de entrenamiento | Corpus multimodal de 30T tokens | Se pretende que los datos autogenerados entren en un bucle recursivo |
| Multimodalidad | Entrada multimodal nativa | El modelado multimodal unificado es una dirección de investigación, no una especificación publicada |
| Etapas de entrenamiento | Receta de entrenamiento por etapas publicada | Autoentrenamiento en pre-, medio y posentrenamiento |
| Entornos de entrenamiento | Entornos diseñados y evaluados por investigadores | Los agentes ayudan a construir y validar entornos |
| Verificación | Canalizaciones de evaluación y entrenamiento existentes | Juicio más fuerte del propio modelo, feedback de ejecución y autoverificación |
| Infraestructura | Pila de inferencia optimizada | Los modelos ayudan con la optimización de la infraestructura |
| Detalles de la API | ID de modelo publicado y API activa | No divulgados |
El texto de lanzamiento de Z.AI informa aproximadamente 3.0× menos cómputo de atención y un tamaño de KV-cache 4.4× menor para GLM-5.3-Flash que para GLM-5.3 API . El gráfico oficial adjunto etiqueta la comparación de un millón de tokens como 3.40× para el cómputo de atención y 3.80× para la caché KV por capa. Dado que los dos materiales oficiales usan cifras diferentes, deben informarse con sus respectivos contextos en lugar de fusionarse en una única medición.
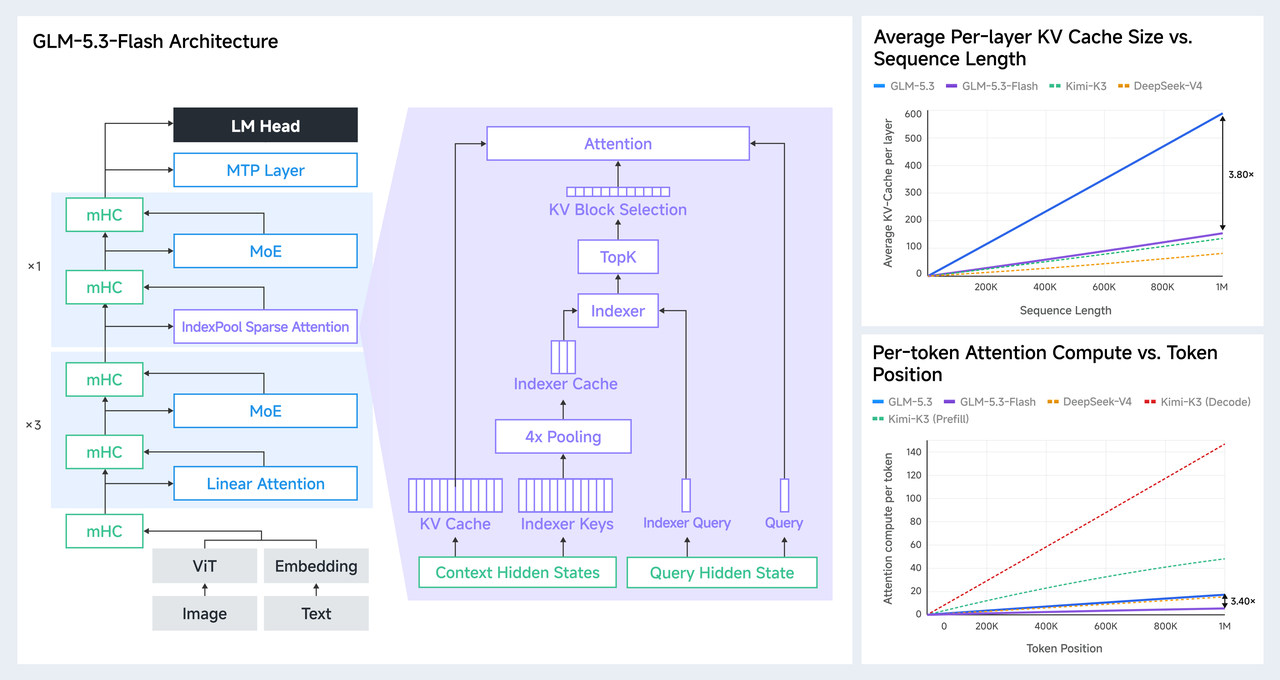
Comparación oficial de arquitectura y eficiencia de GLM-5.3-Flash publicada por Z.AI
¿Qué resultados de benchmark forman la línea base de GLM 6.0?
No hay una tabla verificada de benchmarks de GLM 6.0 pública. La generación GLM actual solo es útil como línea base porque las evaluaciones a continuación miden planificación, programación, uso de herramientas, automatización y ejecución de largo horizonte, las capacidades más relevantes para la dirección divulgada de Full Self-Training.
| Evaluación oficial de Z.AI | GLM-5.3-Flash | GLM-5.2 | Diferencia reportada |
|---|---|---|---|
| Terminal Bench 2.1 | 84.3 | 81.0 | +3.3 |
| DeepSWE v1.1 | 63.4 | 46.2 | +17.2 |
| NL2Repo | 56.3 | 48.9 | +7.4 |
| Toolathlon Verified | 78.4 | 59.9 | +18.5 |
| AutomationBench v1.0.6 | 48.8 | 26.2 | +22.6 |
| Agents’ Last Exam | 26.3 | 20.4 | +5.9 |
| HLE with Tools | 55.3 | 54.7 | +0.6 |
| GDPval-AA v2 | 1773 Elo | 1504 Elo | +269 Elo |
La comparación es multidimensional en lugar de un ranking de puntuación única. GLM-5.3-Flash muestra sus mayores ganancias reportadas en AutomationBench (+22.6), Toolathlon Verified (+18.5) y DeepSWE (+17.2), mientras que la diferencia en HLE-with-Tools es solo +0.6. Este patrón sugiere mayores ganancias en tareas de agente intensivas en ejecución que en todas las formas de razonamiento asistido por herramientas. No predice las puntuaciones de GLM 6.0.
Por qué estos benchmarks importan
Los benchmarks importan aquí solo si revelan las capacidades que Full Self-Training pretende mejorar. Las seis categorías de la tabla insertada forman una progresión desde producir trabajo correcto hasta mantener un comportamiento efectivo en entornos reales. La programación prueba si el modelo puede ejecutar una tarea compleja; el uso de herramientas prueba si puede convertir una acción en feedback y elegir el siguiente paso; y la automatización prueba si puede preservar ese bucle a lo largo de un flujo de trabajo largo.
| Categoría de benchmark | Por qué importa para GLM-6.0 |
|---|---|
| Programación | Prueba la ejecución de tareas complejas |
| Uso de herramientas | Prueba el bucle acción→feedback |
| Automatización | Prueba la ejecución de flujos de trabajo de largo horizonte |
| HLE | Prueba la resolución de problemas complejos a nivel experto |
| GDPval | Prueba la calidad del trabajo profesional |
| Multimodal | Prueba el uso de feedback visual |
HLE eleva la dificultad de los problemas a resolver, GDPval pregunta si la salida es útil en trabajo profesional, y la evaluación multimodal prueba si las observaciones visuales pueden guiar acciones posteriores. Leídas en conjunto, las seis categorías pasan de la competencia aislada a la finalización de tareas de extremo a extremo: generar un plan, actuar, observar feedback, corregir errores y continuar hasta cumplir el objetivo.
Un futuro resultado de GLM-6.0 sería significativo no porque produzca una puntuación agregada más alta, sino porque las mejoras en estas dimensiones mostrarían que la experiencia de entrenamiento autogenerada se transfiere a una ejecución real confiable. El objetivo último de Full Self-Training no es mejorar las puntuaciones de prueba, sino mejorar la capacidad del modelo para completar tareas del mundo real.
¿Por qué podría importar Full Self-Training para GLM 6.0?
La verdadera promesa no es que GLM 6.0 simplemente “se entrene solo”. El cambio más significativo es que partes más grandes de la canalización de desarrollo podrían volverse generadas y verificadas por máquina. Hoy, los investigadores aún hacen gran parte del trabajo alrededor del modelo: recopilar datos, diseñar tareas, construir evaluadores, construir entornos, diagnosticar fallos y ajustar el software de sistemas. Full Self-Training empuja al modelo a más de esas etapas.
Si el enfoque funciona, la variable de escalado importante pasa a ser menos cuántos parámetros pueden añadirse y más cuántos ciclos de aprendizaje útiles y verificados pueden ejecutarse por unidad de cómputo. Esa es una interpretación práctica de la auto-mejora recursiva, no la versión de ciencia ficción de la auto-modificación autónoma sin restricciones.
La estrategia divulgada debe evaluarse como un sistema de retroalimentación ingenierizado con validadores, entornos reproducibles, benchmarks de infraestructura y controles humanos, no como evidencia de auto-mejora autónoma sin restricciones.
¿Qué podría salir mal con Full Self-Training?
Un bucle de autoentrenamiento puede amplificar errores con la misma eficiencia con la que compone experiencia útil. Cuatro modos de fallo merecen especial atención:
- Amplificación de errores: trayectorias sintéticas débiles pueden convertirse en datos de entrenamiento futuros, permitiendo que patrones plausibles pero incorrectos se refuercen a sí mismos.
- Recompensas y gaming del evaluador: si el mismo sistema genera trabajo y lo juzga, puede optimizar lagunas del verificador en lugar del éxito genuino de la tarea.
- Estrechamiento de la distribución: aprender repetidamente de datos generados por el modelo puede reducir la diversidad y dificultar el manejo de casos poco comunes del mundo real.
- Presión de coste, seguridad y gobernanza: la construcción de entornos, el acceso a herramientas y la iteración persistente aumentan la demanda de cómputo y amplían la superficie de ataque.
Una implementación creíble de GLM-6.0 necesita por tanto validadores independientes, procedencia de datos, umbrales de aceptación, pruebas de red team, auditorías humanas y reglas explícitas de detención. La autocorrección solo es útil cuando la señal de corrección es más confiable que el comportamiento que se corrige.
¿Cuándo podría estar disponible la API de GLM 6.0?
Z.AI no ha publicado una fecha de lanzamiento del API de GLM 6.0, ID de modelo, ventana de contexto, salida máxima, precio por token, compromiso de pesos abiertos ni requisitos de despliegue. Cualquier valor específico sería actualmente especulación.
Los desarrolladores pueden evaluar la dirección actual a través de la API de GLM-5.3-Flash en CometAPI para cargas de trabajo multimodales nativas y orientadas a la eficiencia, la API de GLM-5.3 en CometAPI para la rama insignia actual, o la API de GLM-5.2 en CometAPI como línea base de comparación de la generación anterior.
Conclusión
GLM-6.0 importa menos como un producto prometido que como una prueba de si Z.AI puede convertir Full Self-Training en un sistema de ingeniería repetible. La hoja de ruta conecta experiencia autogenerada, entrenamiento por etapas, autoevaluación, corrección e iteración controlada; la evidencia decisiva será si esos mecanismos mejoran la fiabilidad en flujos de trabajo largos, con uso de herramientas y del mundo real.
Esa evidencia sigue incompleta. Z.AI no ha publicado una ficha del modelo GLM-6.0, fecha de lanzamiento, identificador de API, precios ni conjunto de benchmarks. Hasta que existan esos artefactos, la conclusión defendible es estrecha: la empresa ha divulgado una dirección de entrenamiento, no un perfil de capacidades terminado.
El objetivo último de Full Self-Training no es mejorar las puntuaciones de prueba, sino mejorar la capacidad del modelo para completar tareas del mundo real.