
Resumen
GPT-6 Astra obtiene puntuaciones de titular excepcionales. Las mayores ganancias aparecen cuando el razonamiento debe convertirse en acción: operación en terminal, uso de software, automatización, recuperación en contextos largos, flujos de trabajo científicos y ciberseguridad. En pruebas académicas ya saturadas, la mejora frente a la generación anterior de OpenAI suele ser mucho menor.
El modelo combina una ventana de contexto de 1,050,000 tokens con amplio soporte de herramientas. Los benchmarks de ejecución publicados por OpenAI sugieren que la mejora práctica es más fuerte en trabajo de largo horizonte, pero el diseño del arnés, el esfuerzo de razonamiento, la latencia y el acceso a herramientas afectan materialmente el resultado.
Puntos clave
- Las mejoras más claras de Astra se dan en ejecución agentiva, no en todas las formas de preguntas y respuestas.
- Los resultados en Terminal-Bench, AutomationBench, uso de computadora y migración de bases de datos muestran movimientos sustancialmente mayores que GPQA o DeepSWE.
- El resultado en ARC-AGI-3 demuestra que el estado del modelo, la gestión del contexto y el arnés de evaluación pueden dominar la puntuación final.
- Una ventana de contexto grande solo importa cuando la información sigue siendo recuperable cerca del límite; MRCR es más informativo que la capacidad anunciada por sí sola.
- Precios de token más altos no implican automáticamente mayor costo por tarea si el modelo necesita menos tokens, turnos, reintentos o correcciones humanas.
- Las decisiones de producción deben comparar conjuntamente tasa de éxito, tiempo transcurrido, costo total, fiabilidad de herramientas y carga de corrección.
GPT-6 Astra de un vistazo
OpenAI especifica hasta 128,000 tokens de salida, entrada de texto e imagen, salida de texto y esfuerzo de razonamiento desde low hasta max. Estas especificaciones hacen posibles flujos de trabajo grandes y multietapa, pero no prueban que un modelo recuperará la evidencia correcta o completará una tarea de forma fiable.
| Especificación oficial | GPT-6 Astra en CometAPI | Significado práctico |
|---|---|---|
| Model ID | gpt-6-astra | Identificador estable para enrutamiento de API |
| Context window | 1,050,000 tokens | Soporta grandes repositorios, archivos e historiales de agente |
| Maximum output | 128,000 tokens | Permite informes extensos, parches y artefactos estructurados |
| Knowledge cutoff | 30 de abril de 2026 | Hechos posteriores requieren herramientas o fuentes suministradas |
| Input | Text and images | Admite documentos, capturas de pantalla, diagramas y evidencia mixta |
| Output | Text | Produce prosa, código y texto estructurado |
| Reasoning effort | low, medium, high, xhigh, max | Intercambia latencia y costo por una búsqueda más profunda |
| Agent capabilities | Function calling, structured outputs, computer use, web/file search, hosted shell, Apply Patch, MCP | Habilita flujos de trabajo de extremo a extremo, no solo respuestas aisladas |
| OpenAI Standard input | $10 per million tokens | El tamaño de la entrada y la reutilización de caché afectan el costo total |
| OpenAI cached input | $1 per million tokens | Se aplica cuando se reutiliza desde caché el prefijo del prompt |
| OpenAI cache writes | $12.50 per million tokens | Facturado a 1.25× la tarifa de entrada sin caché |
| OpenAI Standard output | $50 per million tokens | Salidas verbosas pueden dominar el costo de la tarea |
| Requests above 272K input tokens | Input and cache rates ×2; output rate ×1.5 | Las tarifas más altas se aplican a toda la solicitud |
Un límite de contexto mide capacidad, no recuerdo utilizable. Una lista de herramientas mide disponibilidad, no ejecución exitosa. Se necesitan benchmarks para probar si esas especificaciones se traducen en trabajo completado.
¿Qué muestran los resultados de benchmark de GPT-6 Astra?
El portafolio muestra un patrón desigual. Astra apenas supera a Sol en algunas pruebas académicas y de razonamiento de software, pero produce mejoras de dos dígitos en trabajo de terminal, automatización, migración de bases de datos, interacción visual, recuperación en contextos largos y matemáticas avanzadas.
| Benchmark publicado | GPT-6 Astra | GPT-5.6 Sol | Claude Fable 5.1 | Astra vs. Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 57.9% | 37.3% | 55.8% | +20.6 pp |
| DeepSWE v1.1 | 74.1% | 72.7% | 67.4% | +1.4 pp |
| Database Migration Tasks | 63.9% | 42.7% | 57.8% | +21.2 pp |
| OSWorld 2.0 | 72.6% | 65.7% | — | +6.9 pp |
| ScreenSpot-Pro | 92.7% | 76.9% | — | +15.8 pp |
| AutomationBench | 41.4% | 18.1% | 31.4% | +23.3 pp |
| BenchCAD | 95.9% | 83.3% | 84.3% | +12.6 pp |
| FrontierMath Tier 4 v2 | 97.6% | 83.0% | 87.8% | +14.6 pp |
| GPQA Diamond | 96.0% | 94.6% | 93.7% | +1.4 pp |
| MRCR v2, 512K–1M | 96.3% | 73.8% | — | +22.5 pp |
| AA Intelligence Index v4.1.1 | 61.2 | 60.9 | 65.7 | +0.3 |
| ARC-AGI-3, Provider Adapter | 99.9% | 7.8% | — | +92.1 pp |
Surgen tres grupos. Primero, las brechas de 1.4 puntos en DeepSWE y GPQA indican movimiento incremental limitado en tareas donde los modelos fuertes ya funcionan bien. Segundo, ganancias superiores a 20 puntos en Terminal-Bench, AutomationBench, migración de bases de datos y recuperación con un millón de tokens muestran un cambio mucho mayor en ejecución. Tercero, ARC-AGI-3 es un valor atípico cuya interpretación depende del arnés.
Resultado de pruebas independientes
Artificial Analysis sitúa a Astra y Sol aproximadamente en 61 en su Intelligence Index, mientras muestra una mejora mucho más clara en su Coding Agent Index. Esto refuerza de forma independiente el patrón en los datos de OpenAI: la mayor mejora se concentra en la ejecución agentiva.
A esfuerzo máximo en el arnés de Codex, Astra supuestamente usa alrededor de un tercio de los tokens que Sol en el Coding Agent Index. Su uso de tokens en el Intelligence Index cae solo alrededor de un 10%. Dado que la tarifa por token de Astra es más alta, estos dos perfiles de eficiencia crean economías diferentes.
| Evaluación independiente | Resultado observado | Interpretación para producción |
|---|---|---|
| Intelligence Index | Poca separación respecto de Sol | El razonamiento general puede no justificar una prima de precio elevada |
| Coding Agent Index | Mejora agentiva clara | Menos tokens pueden compensar una tarifa de token más alta |
| AA-Omniscience | Tasa de alucinación cae del 92% al 51% a esfuerzo máx. | Mejor abstención puede importar en sistemas de investigación y recuperación |
| Trabajo de conocimiento de largo horizonte | Progreso mixto en tareas | La evaluación local sigue siendo necesaria |
Ningún benchmark independiente certifica la factualidad o seguridad de producción. Los equipos deben puntuar por separado respuestas correctas, incertidumbre justificada, afirmaciones sin soporte y fallos al seguir las restricciones de fuente.
¿Por qué Astra se adapta mejor al trabajo agentivo de largo horizonte?
GPT-6 Astra añade tres controles diseñados para trabajo que cambia mientras se ejecuta. La fiabilidad en ejecuciones largas también depende de todo el sistema de contexto: la ventana de contexto establece la capacidad; la compactación controla cómo se condensa material antiguo; el razonamiento persistente transporta el estado relevante del modelo; la recuperación mantiene buscable la evidencia anterior; y la aplicación debe preservar salidas importantes de herramientas, resultados de pruebas, enfoques fallidos y requisitos del usuario. Estos mecanismos deben probarse junto con el arnés de agente.
- Llamadas de herramientas asíncronas: Astra puede continuar con razonamiento independiente o llamar a otras herramientas mientras una aplicación ejecuta una herramienta de larga duración.
- Corrección a mitad de turno: una aplicación puede enviar una corrección o un requisito nuevo por WebSocket sin descartar el trabajo completado.
- Ajuste de razonamiento en medio de la conversación: una actualización de configuración puede subir o bajar el esfuerzo de razonamiento preservando el prefijo del prompt en caché.
Dónde mejora realmente GPT-6 Astra
Programación agentiva: el trabajo en terminal es la mejora mayor
Terminal-Bench 4.0 evalúa si un agente puede trabajar a través de tareas difíciles en terminal en lugar de simplemente generar una respuesta de código aislada. Astra alcanza 57.9%, 20.6 puntos porcentuales por encima de Sol y 2.1 puntos por encima de Fable. Es una mejora sustancial de generación en generación para OpenAI, pero una ventaja mucho más estrecha sobre otro sistema agentivo de frontera.
DeepSWE cuenta otra historia: 74.1% para Astra y 72.7% para Sol. La brecha de 1.4 puntos aconseja no generalizar a partir de un solo benchmark de programación. Astra parece ganar más cuando la programación requiere interacción con el entorno, iteración, preservación de estado y verificación.
Database Migration Tasks refuerza esa interpretación. El 63.9% está 21.2 puntos por encima de Sol y 6.1 puntos por encima de Fable. El trabajo de migración combina comprensión de código, uso de herramientas, secuenciación y criterio operativo: el tipo de flujo compuesto donde pequeñas mejoras de razonamiento pueden acumularse en ganancias de finalización mucho mayores.
Para agentes de programación, evalúe el modelo y el arnés juntos. Instrucciones del repositorio, herramientas de terminal, comportamiento de reintento, preservación del contexto y ejecución de pruebas contribuyen todas al resultado medido.
Uso de computadora: importan tanto la tasa de éxito como el tiempo de ejecución
En Agents’ Last Exam, GPT-6 Astra obtiene 59.3%, frente a 53.6% para GPT-5.6 Sol: una ganancia de 5.7 puntos porcentuales. Esto añade un resultado más amplio de tareas de agente a las puntuaciones de OSWorld 2.0 y ScreenSpot-Pro en la visión general de benchmarks anterior.
Más allá de la precisión, la comparación de tiempo de ejecución de OSWorld añade otra dimensión práctica: OpenAI informa aproximadamente 40 minutos por tarea para Astra frente a unos 75 minutos para Sol, o aproximadamente 47% menos tiempo transcurrido, aumentando además el éxito de la tarea.
Un agente que acierta ligeramente más y termina mucho más rápido puede ofrecer una gran mejora de rendimiento. Las pruebas de adquisición deberían informar tasa de éxito, tiempo transcurrido, llamadas a herramientas, reintentos e intervenciones humanas, no solo precisión.
Automatización y trabajo profesional
AutomationBench sube de 18.1% a 41.4%, una ganancia de 23.3 puntos. La puntuación absoluta sigue lejos de la perfección, pero el cambio en el perfil de fallos es más significativo que un movimiento de un punto cerca de la saturación. En BenchCAD, Astra alcanza 95.9%, aventajando a Sol por 12.6 puntos y a Fable por 11.6 puntos.
Estos resultados apoyan una afirmación específica: Astra es mejor convirtiendo instrucciones en secuencias de acciones validadas. No prueban ganancias iguales para cada flujo de trabajo empresarial. Un proceso de producción puede introducir pasos de autenticación, interfaces propietarias, políticas ambiguas o formatos de datos ausentes en el benchmark.
Ciencia
La ciencia es una de las mejoras de capacidad más claras de Astra. En FrontierMath Tier 4 v2, Astra alcanza 97.6%, frente a 83.0% de Sol y 87.8% de Fable. La ventaja de 14.6 puntos sobre Sol es sustancial, aunque el benchmark cubre una distribución de tareas seleccionada y no el flujo científico completo.
Ciberseguridad
La ciberseguridad es una segunda gran mejora, con implicaciones más serias que un movimiento ordinario en un ranking. En ExploitBench que cubre de junio a agosto de 2026, Astra obtiene 39.0% frente al 5.5% de Sol. OpenAI informa que este conjunto más reciente apunta a vulnerabilidades de los tres meses anteriores para reducir la exposición histórica. En la evaluación de ciberseguridad de OpenAI, Astra demostró la capacidad de descubrir y explotar dos vulnerabilidades zero-day previamente desconocidas durante pruebas controladas. Este resultado es importante porque la evaluación se diseñó alrededor de vulnerabilidades divulgadas recientemente en lugar de problemas de seguridad conocidos desde hace tiempo, reduciendo la posibilidad de que el rendimiento en el benchmark se debiera simplemente a ejemplos memorizados. El resultado contribuyó a que Astra alcanzara el umbral de capacidad de ciberseguridad Critical de OpenAI y, por lo tanto, cambia las salvaguardas requeridas para el despliegue. La importancia no es que Astra pueda realizar operaciones cibernéticas irrestrictas de forma autónoma, sino que su nivel de capacidad cambia los requisitos de las salvaguardas de despliegue. Los sistemas con mayor capacidad de descubrimiento y explotación de vulnerabilidades requieren controles de acceso más estrictos, monitoreo, sandboxing y mecanismos de revisión humana.
Tareas de larga duración: la ventana de contexto no lo es todo
La ventana de contexto de 1,050,000 tokens de Astra describe capacidad, no continuidad. El rendimiento a largo plazo también depende de la compactación, el estado persistente, el contexto anterior buscable, el estado de razonamiento retenido y la preservación de salidas de herramientas. En MRCR v2, Astra obtiene 100.0% a 256K–512K y 96.3% a 512K–1M, mientras que Sol registra 91.5% y 73.8%. La brecha de 22.5 puntos en el rango más largo muestra que la recuperación utilizable cerca del límite importa más que la capacidad anunciada.
MRCR sigue siendo una prueba sintética de recuperación, por lo que la evaluación en producción debe preservar la evidencia que los resúmenes suelen perder: por qué falló una corrección anterior, el comportamiento de un componente específico, resultados de pruebas, requisitos históricos y detalles enterrados en la salida de herramientas. También deben probarse repositorios y archivos de investigación con nombres duplicados, referencias cruzadas, políticas obsoletas, fuentes contradictorias y largos tramos distractores. Esto separa la capacidad de contexto bruta del comportamiento de preservación y recuperación que un agente de largo horizonte realmente necesita.
Preservación de contexto: por qué Astra es diferente de los sistemas tradicionales de contexto largo
Los flujos de trabajo tradicionales de contexto largo suelen seguir un patrón:
context → compaction → summary → continue
Este enfoque reduce el uso de tokens, pero introduce un riesgo crítico: información intermedia importante puede desaparecer durante la resumización.
La información perdida a menudo no es la respuesta final en sí, sino los detalles operativos necesarios para decisiones futuras:
- por qué falló una corrección anterior;
- qué componente mostró comportamiento anómalo;
- qué resultado de prueba cambió la dirección de la implementación;
- qué requisito del usuario se añadió después;
- qué salida de herramienta contenía evidencia importante.
GPT-6 Astra aborda esta limitación combinando mecanismos de preservación y recuperación de contexto dentro de flujos de trabajo de agentes que se ejecutan por largo tiempo.
En lugar de depender solo de resúmenes comprimidos, el sistema puede preservar notas importantes, recuperar información anterior cuando sea necesario y mantener la continuidad entre múltiples interacciones con herramientas.
Para agentes de programación como Codex, esto significa que una tarea larga de depuración puede retener:
- experimentos fallidos anteriores;
- cambios en el repositorio;
- salidas de pruebas;
- decisiones de arquitectura;
- issues sin resolver.
Por lo tanto, el valor de la ventana de contexto de 1M tokens de Astra no es solo la cantidad de información que puede recibir, sino si el sistema puede preservar y recuperar la información correcta tras horas de interacción.
Razonamiento e interpretación
ARC-AGI-3: el arnés es parte del resultado
ARC-AGI-3 proporciona la demostración más clara de que un benchmark de frontera puede medir un sistema y no un modelo aislado. ARC Prize informa 62.7% con el arnés Standard a esfuerzo máximo y 99.9% con Provider Adapter a esfuerzo high.
| Evaluación ARC Prize | Arnés estándar | Provider Adapter | Ganancia del Adapter |
|---|---|---|---|
| max | 62.7% | 98.6% | +35.9 pp |
| xhigh | 59.3% | 98.4% | +39.1 pp |
| high | 54.8% | 99.9% | +45.1 pp |
| medium | 38.6% | 98.4% | +59.8 pp |
| low | 17.5% | 98.0% | +80.5 pp |
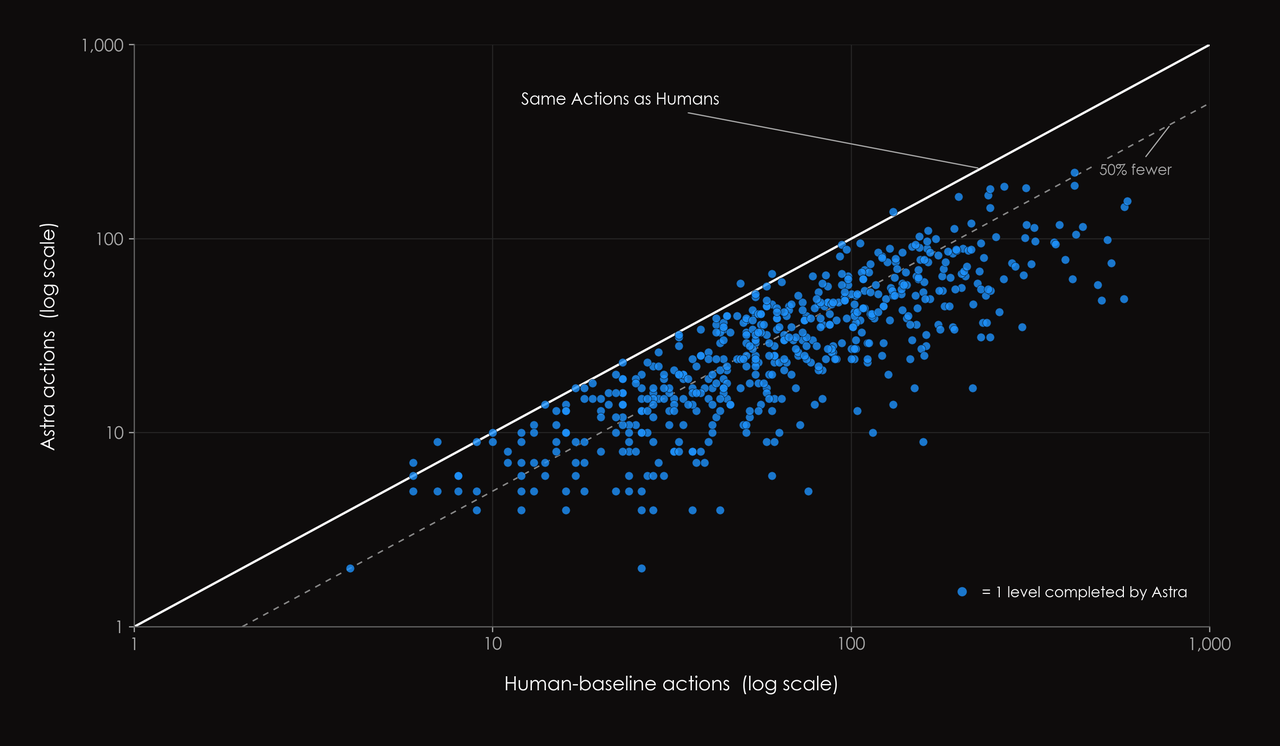
Comparación de ARC Prize de la eficiencia de acción de Astra a través de arneses de evaluación
La política de arnés neutral al proveedor requiere que el modelo preserve información importante en estado visible. El Provider Adapter retiene estado de razonamiento adicional y usa gestión de contexto específica del proveedor. En pares compartidos de juegos resueltos, ARC Prize informa una ejecución 3.66× más rápida y 49% menos tokens totales con el adapter.
El resultado del 99.9% mide un sistema específico modelo–proveedor–adapter y no debe tratarse como una medida independiente del arnés de la inteligencia cruda del modelo. La arquitectura de contexto es parte del sistema evaluado.
El esfuerzo de razonamiento no escala linealmente
La tabla de ARC también muestra que el esfuerzo máximo no siempre produce la mayor puntuación. High alcanza 99.9% con el Provider Adapter, mientras que max llega a 98.6%. En el arnés estándar, max funciona mejor.
OpenAI señala que las cifras de la tabla de lanzamiento generalmente usan la mejor configuración de razonamiento observada. Ese enfoque estima un techo de rendimiento, pero no identifica la mejor configuración de producción. Los equipos deben probar varios niveles de esfuerzo y calcular la calidad marginal obtenida por cada segundo y dólar adicionales.
Matemáticas y razonamiento académico
FrontierMath Tier 4 v2 sube de 83.0% a 97.6%, una ganancia de 14.6 puntos. Es una mejora importante de benchmark, pero no evidencia que las matemáticas de frontera estén resueltas. La evaluación cubre una distribución de tareas seleccionada y no mide todas las etapas de la investigación matemática, incluida la selección de problemas, verificación formal de pruebas, desarrollo de programas a largo plazo o revisión por pares adversarial.
GPQA Diamond ofrece el patrón opuesto: 96.0% para Astra, 94.6% para Sol, 93.7% para Fable y 95.3% para Gemini 3.8 Flash. Los modelos se agrupan estrechamente cerca del techo. Informar la diferencia de 1.4 puntos Astra–Sol es correcto, pero llamarlo una revolución amplia de inteligencia exageraría la evidencia.
Capacidad crítica + salvaguardas
| Evaluación de ciberseguridad | Astra | Sol | Ganancia absoluta |
|---|---|---|---|
| ExploitBench | 100.0% | 78.5% | +21.5 pp |
| ExploitGym | 42.4% | 30.3% | +12.1 pp |
| ExploitBench, junio–agosto 2026 | 39.0% | 5.5% | +33.5 pp |
| SRE-Bench | 88.0% | 55.9% | +32.1 pp |
| SEC-Bench Pro | 85.4% | 79.1% | +6.3 pp |
OpenAI creó ExploitBench (junio–agosto de 2026) a partir de vulnerabilidades divulgadas durante los tres meses anteriores, reduciendo la probabilidad de que la exposición histórica inflara el resultado. Astra obtiene 39.0% en este conjunto frente al 5.5% de Sol, y OpenAI informa que Astra encontró y explotó dos vulnerabilidades zero-day previamente desconocidas. Estos resultados contribuyeron a que Astra se convirtiera en el primer modelo de despliegue amplio de OpenAI en alcanzar el umbral de capacidad de ciberseguridad Critical, lo que afectó directamente las salvaguardas y la política de acceso.
Cómo leer puntuaciones cerca de la saturación
Las puntuaciones por encima de 90% requieren un lenguaje más cuidadoso que los resultados de rango medio. Pasar de 50% a 60% resuelve diez tareas adicionales por cada cien. Pasar de 95% a 96% resuelve solo una tarea adicional por cada cien, aunque reduce el número de errores restantes de cinco a cuatro, una reducción del 20%. Ambas descripciones son matemáticamente correctas, pero sustentan titulares muy diferentes.
La cautela opuesta se aplica a benchmarks de baja puntuación. Un aumento de 18.1% a 41.4% sigue muy por debajo de una operación autónoma fiable, pero más que duplica el número de casos exitosos y puede transformar un flujo de trabajo supervisado. La puntuación absoluta determina si el sistema está listo; el tamaño de la mejora indica qué tan rápido está cambiando la capacidad. Las decisiones de producción necesitan ambas.
Una comparación multidimensional
| Dimensión | Astra | Sol | Fable | Señal para la decisión |
|---|---|---|---|---|
| Razonamiento académico general | Excelente; a menudo cerca de saturación | Muy cerca | Competitivo | Brechas pequeñas rara vez deciden el despliegue |
| Ejecución en terminal | De primer nivel | Gran salto generacional | Competidor cercano | Probar el arnés de programación completo |
| Uso de computadora | Mayor éxito y menor tiempo | Más lento y menos preciso | Datos comparables insuficientes en la tabla de lanzamiento | Medir éxito por hora |
| Recuperación de contexto largo | Fuerte cerca de 1M tokens | Degradación material cerca del límite | Datos directamente comparables insuficientes | Usar pruebas de recuperación con forma de producción |
| Control de razonamiento | low a max | Envolvente de esfuerzo diferente | Enfoque de pensamiento adaptativo | Ajustar configuración, no solo el nombre del modelo |
| Capacidad cibernética | Riesgo cualitativamente mayor | Resultados publicados menores | No comparado aquí | Importan salvaguardas y política de acceso |
| Economía de tokens | Tarifa mayor; a veces menos tokens | Tarifa menor | Dependiente de la carga | Comparar costo por tarea exitosa |
El resultado depende de la carga. Astra es más convincente cuando la tarea requiere interacción sostenida con herramientas y entornos, recuperación tras fallos o recuperación fiable a través de contextos muy grandes. Sol puede seguir siendo más económico para trabajo acotado con contexto modesto y poca iteración. Fable es un competidor cercano en trabajo de terminal y lidera algunas evaluaciones académicas externas, por lo que un benchmark a nivel de aplicación es más útil que una conclusión a nivel de proveedor.
¿Quién debería usar GPT-6 Astra?
| Caso de uso | Recomendación |
|---|---|
| Clasificación simple | No necesariamente vale la pena usar Astra |
| Resumen simple | No necesariamente vale la pena usar Astra |
| RAG estándar | Primero comparar costo vs. rendimiento |
| Síntesis y análisis de documentos largos | Vale la pena probar Astra |
| Programación agentiva | Muy recomendado probar |
| Uso de computadora | Muy recomendado probar |
| Automatización multietapa | Muy recomendado probar |
| Investigación compleja | Vale la pena probar |
| Computación científica / software especializado | Vale la pena probar |
| Ciberseguridad | Capacidades fuertes, pero requiere controles de seguridad adecuados |
| Tareas simples de alto volumen | Modelos de menor costo pueden ser más rentables |
¿Justifican los incrementos de rendimiento de GPT-6 Astra el precio más alto?
GPT-6 Astra es significativamente más caro que GPT-5.6 Sol, pero las mejoras de benchmark no se distribuyen de manera uniforme en todas las cargas. Por lo tanto, la cuestión del precio no puede responderse comparando solo las tarifas por token.
| Escenario | Ganancia de rendimiento | Justificación del costo |
|---|---|---|
| Preguntas y respuestas simples | Mejora pequeña | Usualmente no vale la prima |
| Agente de programación | Mejora grande | La prima puede justificarse |
| Análisis de contexto largo | Mejora significativa | Depende de las necesidades de recuperación |
| Automatización computacional | Mejora fuerte | A menudo vale la pena probar |
| Razonamiento general | Mejora limitada | Comparar costo cuidadosamente |
A tarifas OpenAI Standard, GPT-6 Astra cuesta $10 por millón de tokens de entrada, $1 por millón de tokens de entrada en caché, $12.50 por millón de tokens de escritura en caché y $50 por millón de tokens de salida. La entrada y salida Standard son 2.5× las tarifas de $4 y $20 de GPT-5.6 Sol. Cuando una solicitud supera 272K tokens de entrada, las tarifas de entrada y caché de Astra se duplican y su tarifa de salida aumenta 1.5× para toda la solicitud.
La prima de precio se alinea más claramente con trabajo agentivo. Astra gana más de 20 puntos porcentuales en Terminal-Bench, AutomationBench, migración de bases de datos y MRCR de mayor alcance; pruebas independientes también informan aproximadamente un tercio del uso de tokens de Sol en el Coding Agent Index. La correspondencia es más débil en razonamiento general, donde el Intelligence Index está casi empatado y el uso de tokens cae solo ~10%. La decisión de compra debe, por lo tanto, comparar el costo por tarea exitosa, incluyendo salida, actividad de caché, uso de herramientas, tiempo transcurrido, reintentos, fallos y corrección humana.
Costo por tarea exitosa
Costo por tarea exitosa = (Costo de entrada + Costo de salida + Costo de herramientas + Costo de reintentos + Costo de revisión humana) / Tareas exitosas
Costo empresarial esperado
Costo empresarial esperado = Costo de API + Costo de herramientas + Costo de reintentos + Costo de revisión humana + Costo de fallos
La métrica de decisión debe ser el costo total dividido por las tareas exitosas, evaluado en un umbral de calidad aceptable, no el precio por millón de tokens.
Cómo deberían los desarrolladores evaluar Astra
Los rankings públicos deberían determinar qué merece ser probado, no tomar la decisión final de despliegue. Construya un conjunto de tareas representativo con casos rutinarios, casos difíciles, casos con contexto ausente, fallos de herramientas e instrucciones adversariales. Use el mismo prompt de producción, permisos, archivos fuente, presupuesto de tiempo y criterios de finalización para cada modelo.
| Dimensión de evaluación | Medida | Por qué importa |
|---|---|---|
| Éxito de la tarea | Criterios de aceptación superados | Evita que respuestas persuasivas pero incompletas puntúen como éxito |
| Fiabilidad | Distribución de éxito en ejecuciones repetidas | Expone victorias inestables puntuales |
| Ejecución de herramientas | Acciones exitosas verificadas | Separa llamadas a herramientas de resultados correctos |
| Factualidad | Afirmaciones fácticas soportadas | Mide calidad de evidencia y abstención |
| Latencia | Tiempo de finalización mediano y cola | Captura rendimiento operativo |
| Costo | Costo total por tarea exitosa | Incluye reintentos e intentos fallidos |
| Esfuerzo humano | Minutos de corrección y revisión | A menudo domina el costo real de despliegue |
| Dirigibilidad | Recuperación tras requisitos cambiantes | Prueba el comportamiento del agente en ejecuciones largas |
La API de Astra en CometAPI usa el ID de modelo gpt-6-astra. Una API multimodelo hace práctico ejecutar la misma evaluación en Astra, Sol, Fable y Gemini sin rediseñar el benchmark alrededor de la tabla de titulares de un proveedor. Enrute tareas agentivas exigentes al modelo que se gana su prima, y use modelos de menor costo donde la ventaja medida desaparece.
Conclusión
La hoja de benchmarks de Astra es impresionante, pero las puntuaciones más espectaculares no son automáticamente las más útiles. ARC-AGI-3 demuestra el potencial de un arnés de agente específico del proveedor; la puntuación con el arnés estándar muestra cuán fuertemente contribuye la infraestructura. GPQA y el Intelligence Index independiente muestran que las ganancias en razonamiento ordinario pueden ser modestas. El trabajo en terminal, la automatización, el uso de computadora, la recuperación en contextos largos, los flujos científicos y la ciberseguridad cuentan la historia más importante.
El lanzamiento tiene menos que ver con que un chatbot se vuelva proporcionalmente más inteligente en cada pregunta y más con que la inteligencia de frontera mejore en completar trabajo. Si esa mejora vale la pena pagarla depende de toda la configuración del sistema del modelo y de la economía de las tareas exitosas en producción.