
TL;DR
DeepSeek V4.1 Flash est le modèle multimodal de DeepSeek orienté efficacité pour le codage, le raisonnement, les agents et les charges de travail à long contexte. La documentation technique officielle précise une architecture Mixture-of-Experts de 552B avec 8B de paramètres actifs pour l’entrée et 16B pour la sortie, ainsi qu’une compréhension visuelle native et une empreinte de KV-cache bien plus réduite.
Pour les développeurs utilisant l’API DeepSeek V4.1 Flash via CometAPI, l’intégration pratique est compatible avec OpenAI : utilisez https://api.cometapi.com/v1 comme URL de base, définissez le modèle sur deepseek-v4.1-flash et appelez l’interface standard Chat Completions.
Une différence de nommage est importante : l’API first-party de DeepSeek utilise deepseek-flash, tandis que CometAPI utilise deepseek-v4.1-flash. Considérez les identifiants de modèle comme une configuration propre au fournisseur.
Points clés
- DeepSeek V4.1 Flash combine une base MoE de 552B, une compréhension d’image native et un profil de calcul asymétrique entrée/sortie.
- Dans CometAPI, utilisez deepseek-v4.1-flash ; sur l’API first-party de DeepSeek, utilisez deepseek-flash.
- CometAPI publie un tarif de base à partir de $0.12/M tokens d’entrée, tandis que DeepSeek indique un prix hors pointe pour cache-miss d’entrée à $0.15/M.
- Les écarts les plus importants mesurés se concentrent sur le codage, le terminal, les dépôts, l’automatisation et les benchmarks d’agents assistés par outils.
- Avant le déploiement en production, validez les champs avancés tels que les contrôles de “thinking”, les charges utiles vision, le streaming, les appels d’outils et la sortie structurée sur la route fournisseur exacte que vous utiliserez.
Qu’est-ce que l’API DeepSeek V4.1 Flash ?
DeepSeek V4.1 Flash est le dernier modèle Flash, construit sur une architecture Mixture-of-Experts de 552B paramètres. Son design Causal Encoder-Decoder active 8B de paramètres pour le traitement d’entrée et 16B pour la génération de sortie.
Pour la planification d’intégration, l’API officielle DeepSeek expose une fenêtre de contexte de 1M tokens et une sortie maximale de 384K tokens. Le service amont prend en charge les APIs Chat Completions et Responses compatibles OpenAI, une API compatible Anthropic, le streaming, la sortie JSON, les appels d’outils et l’entrée d’image native. Ce guide utilise la route Chat Completions de CometAPI ; vérifiez donc le passage des fonctionnalités sur cette route avant le déploiement en production.
| Spécification | Détails officiels de l’API DeepSeek V4.1 Flash |
|---|---|
| Architecture | 552B MoE, Causal Encoder-Decoder |
| Paramètres actifs | 8B pour l’entrée ; 16B pour la sortie |
| Longueur de contexte | 1M tokens |
| Sortie maximale | 384K tokens |
| Interfaces | Chat Completions, API Responses, API compatible Anthropic |
| Streaming | Pris en charge |
| Sortie structurée | Sortie JSON et JSON Schema via les endpoints supportés |
| Appels d’outils | Pris en charge, y compris l’usage d’outils en mode thinking |
| Entrée vision | JPEG, PNG, GIF et WebP |
| Limites d’image | 32 MiB inline ; 64 MiB par fichier ; jusqu’à 600 images par requête |
| ID modèle first-party | deepseek-flash |
| ID modèle CometAPI | deepseek-v4.1-flash |
Note fournisseur : les identifiants de modèle et les champs de requête avancés sont spécifiques aux routes. Utilisez deepseek-v4.1-flash pour les exemples CometAPI de ce guide et testez la vision, les appels d’outils, la sortie structurée et les contrôles de thinking sur l’endpoint déployé.
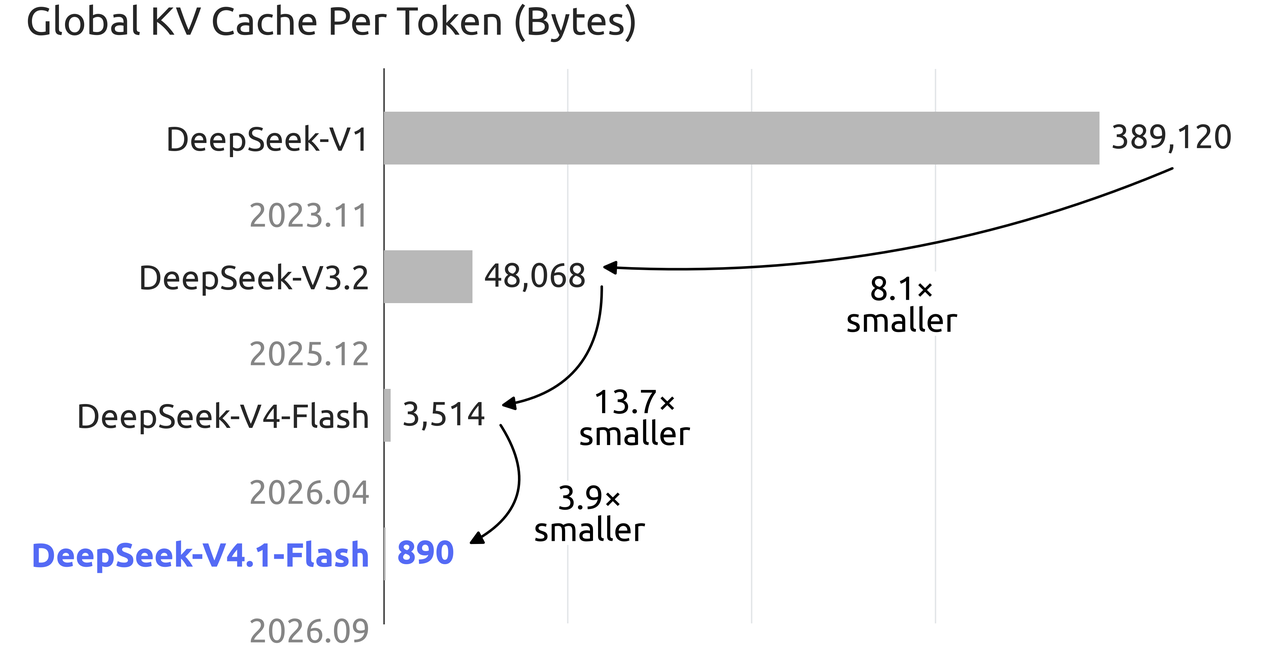
DeepSeek indique également que le KV cache global est d’environ 890 octets par token, contre 3 514 octets par token pour la génération précédente V4 Flash. Cette réduction est particulièrement importante pour les agents longue durée qui réutilisent à répétition de grands prompts, des schémas d’outils et l’historique de conversation.
Comparaison officielle du KV-cache de DeepSeek ? source de l’image officielle
Quelle est la performance de DeepSeek V4.1 Flash pour le codage et les agents IA ?
Ce guide met l’accent sur des preuves de benchmark qui éclairent directement le choix d’API. DeepSeek caractérise V4.1 Flash comme dépassant les modèles phares, y compris V4 Pro, dans son paquet d’évaluations publié. Les gains les plus actionnables apparaissent dans le travail en terminal, l’ingénierie logicielle, les tâches sur dépôts, l’automatisation et les agents assistés par outils ; les équipes de production doivent toutefois valider le modèle sur leurs propres prompts et critères de complétion.
| Benchmark | DeepSeek V4.1 Flash | DeepSeek V4 Pro | DeepSeek V4 Flash |
|---|---|---|---|
| GPQA Diamond | 90.9 | 92.4 | 89.9 |
| Terminal-Bench 2.1 | 90.6 | 87.9 | 82.7 |
| DeepSWE v1.1 | 74.2 | 62.7 | 54.4 |
| NL2Repo-Bench | 65.4 | 61.5 | 54.2 |
| HLE with tools | 63.9 | 60.0 | 51.5 |
| Automation-Bench | 54.8 | 43.2 | 37.7 |
| Agents' Last Exam | 31.8 | 25.7 | 25.2 |
La conclusion pratique est plus nuancée que « V4.1 est plus intelligent ». DeepSeek V4.1 Flash est particulièrement attractif pour l’usage répété d’outils, les actions en terminal, le codage à l’échelle des dépôts, l’automatisation et les trajectoires d’agents longues. Les charges de travail purement liées à la connaissance ou au raisonnement peuvent produire un classement différent.
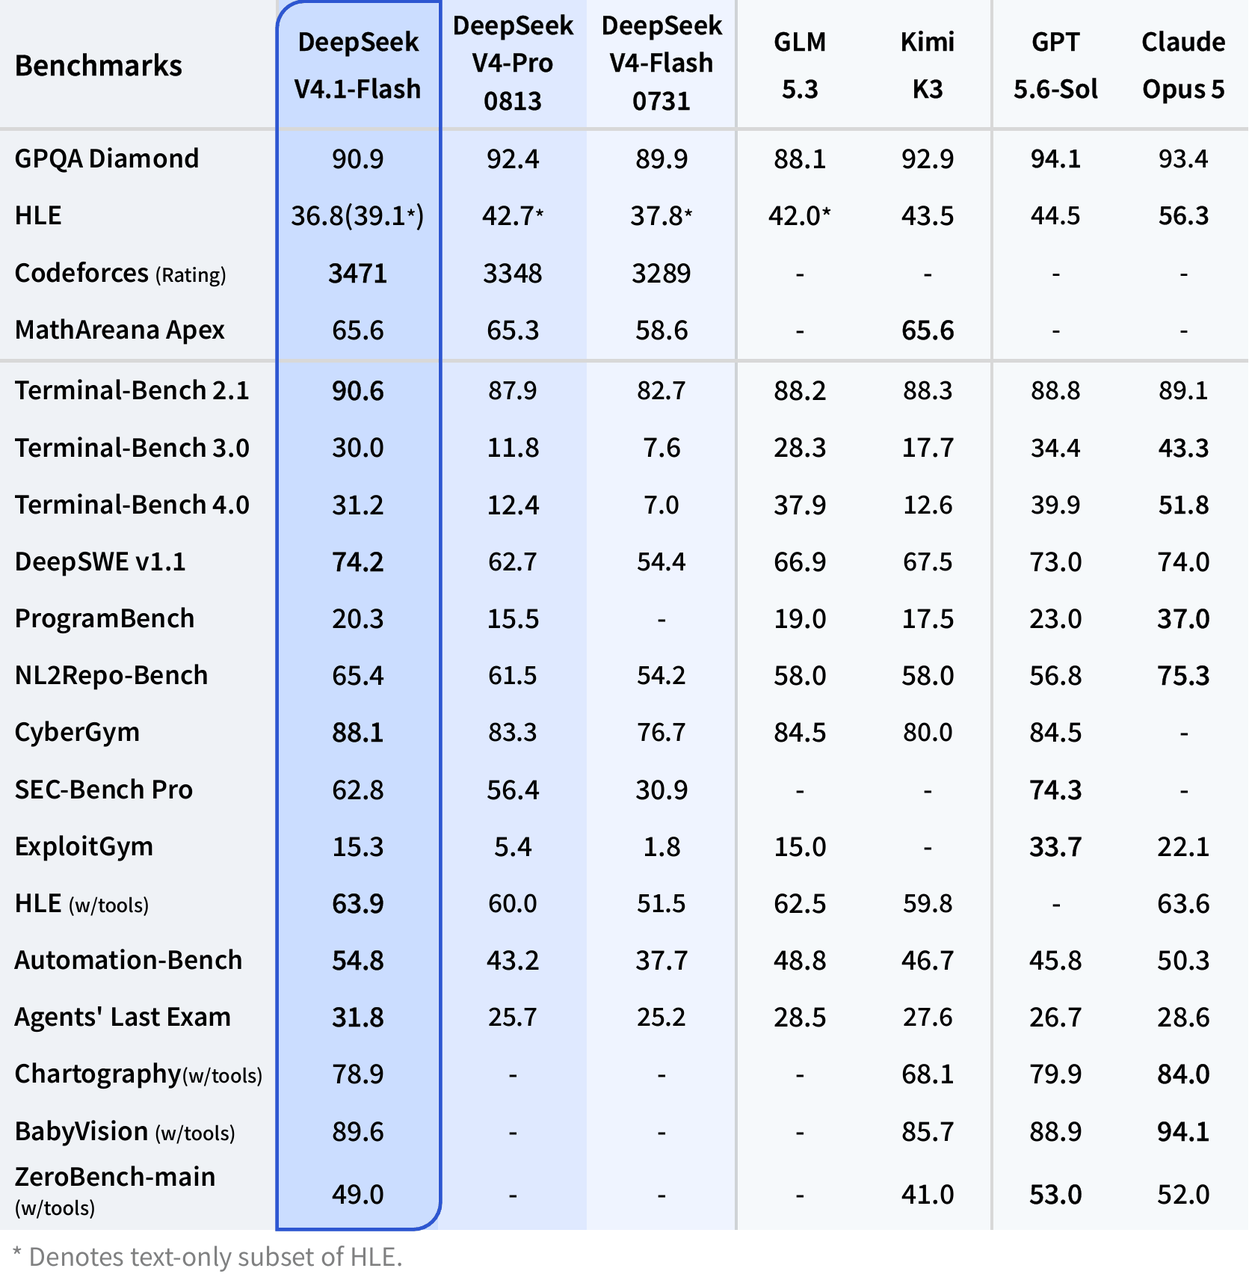
Résultats officiels des benchmarks DeepSeek ? source de l’image officielle
Pourquoi utiliser l’API DeepSeek V4.1 Flash via CometAPI ?
L’avantage principal d’intégration est que l’API DeepSeek V4.1 Flash dans CometAPI peut être appelée avec le même schéma client compatible OpenAI utilisé pour d’autres modèles, réduisant les changements de SDK dans les applications multi-modèles.
| Paramètre | Valeur |
|---|---|
| URL de base | https://api.cometapi.com/v1 |
| Endpoint Chat | /chat/completions |
| ID du modèle | deepseek-v4.1-flash |
| Authentification | Clé API Bearer |
| SDK Python | Compatible OpenAI |
| SDK JavaScript | Compatible OpenAI |
Cela évite également une erreur d’intégration fréquente : copier l’identifiant first-party de DeepSeek dans une requête CometAPI. Les routes fournisseur renvoient à la même famille de modèles, mais les identifiants documentés diffèrent.
| Dimension | CometAPI DeepSeek V4.1 Flash | API officielle DeepSeek |
|---|---|---|
| URL de base | https://api.cometapi.com/v1 | https://api.deepseek.com |
| Modèle | deepseek-v4.1-flash | deepseek-flash |
| Interface | Compatible OpenAI | Compatible OpenAI |
| Entrée base/off-peak | $0.12/M base | $0.15/M hors pointe cache miss |
| Sortie base/off-peak | $0.48/M base | $0.60/M hors pointe |
| Lecture cache/hit | $0.0024/M base | $0.003/M hors pointe |
Se connecter à DeepSeek V4.1 Flash avec CometAPI
Configurer votre clé API et l’URL de base
Créez une clé API CometAPI, stockez-la dans une variable d’environnement et configurez l’URL de base compatible OpenAI comme https://api.cometapi.com/v1. N’intégrez pas d’identifiants de production dans le code source.
export COMETAPI_KEY="YOUR_COMETAPI_KEY"
``````sh
$env:COMETAPI_KEY="YOUR_COMETAPI_KEY"
Effectuer votre première requête API
Utilisez l’identifiant de modèle CometAPI deepseek-v4.1-flash avec l’endpoint standard Chat Completions.
curl "https://api.cometapi.com/v1/chat/completions"
  -H "Content-Type: application/json"
  -H "Authorization: Bearer ${COMETAPI_KEY}"
  -d '{
    "model": "deepseek-v4.1-flash",
    "messages": [
      {
        "role": "user",
        "content": "Explain three ways to reduce latency in a high-throughput API service."
      }
    ]
  }'
Une réponse réussie utilise la structure familière de complétion style OpenAI ; les applications lisant déjà choices[0].message.content nécessitent peu de travail de migration.
Exemple SDK Python
pip install openai
``````python
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[
        {
            "role": "user",
            "content": "Write a Python retry helper with exponential backoff."
        }
    ],
)

print(response.choices[0].message.content)
En production, ajoutez des délais explicites, des retours limités, une journalisation des requêtes et un suivi d’usage.
Exemple SDK JavaScript
npm install openai
``````js
import OpenAI from "openai";

const client = new OpenAI({
  apiKey: process.env.COMETAPI_KEY,
  baseURL: "https://api.cometapi.com/v1",
});

const response = await client.chat.completions.create({
  model: "deepseek-v4.1-flash",
  messages: [
    {
      role: "user",
      content: "Create a typed rate limiter interface for an Express API."
    }
  ],
});

console.log(response.choices[0].message.content);
L’abstraction client reste inchangée tandis que l’URL de base et l’ID du modèle deviennent des paramètres de configuration fournisseur.
Fonctionnalités de l’API DeepSeek V4.1 Flash
Configurer le raisonnement et le mode thinking
DeepSeek documente des modes de fonctionnement avec et sans “thinking”. Lors d’un routage via CometAPI, vérifiez que les champs spécifiques au fournisseur sont transmis exactement comme prévu avant de les considérer comme un contrat de production.
response = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[
        {
            "role": "user",
            "content": "Design a fault-tolerant distributed job scheduler."
        }
    ],
    reasoning_effort="high",
    extra_body={
        "thinking": {"type": "enabled"}
    },
)
Testez chaque niveau d’effort pris en charge par rapport à vos objectifs de latence, d’usage de tokens et de réussite des tâches, car les correspondances fournisseur peuvent différer.
Analyser des images avec l’entrée vision
DeepSeek V4.1 Flash accepte les images JPEG, PNG, GIF et WebP. Les limites officielles incluent 32 MiB par image inline, 64 MiB par image fichier, jusqu’à 600 images par requête, et une limite de 8 192 caractères pour les URLs d’images externes. Les images appartiennent aux messages user ou developer, pas aux messages system ou assistant.
response = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[
        {
            "role": "user",
            "content": [
                {"type": "text", "text": "Identify the three most important anomalies."},
                {
                    "type": "image_url",
                    "image_url": {"url": "https://example.com/dashboard.png"}
                }
            ]
        }
    ],
)
Validez la taille de l’image, l’accessibilité de l’URL, le prétraitement, l’usage de tokens et la latence sur la route CometAPI exacte utilisée en production.
Diffuser des réponses en streaming avec SSE
Le streaming réduit la latence perçue en livrant une sortie incrémentale aux interfaces interactives de codage, de chat et d’agents.
stream = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[
        {
            "role": "user",
            "content": "Explain distributed-cache invalidation."
        }
    ],
    stream=True,
)

for chunk in stream:
    if chunk.choices and chunk.choices[0].delta.content:
        print(chunk.choices[0].delta.content, end="", flush=True)
Les clients de production doivent gérer les flux interrompus, les deltas vides, la récupération après timeout, les limites de retries et la comptabilisation finale de l’usage.
Combien coûte l’API DeepSeek V4.1 Flash ?
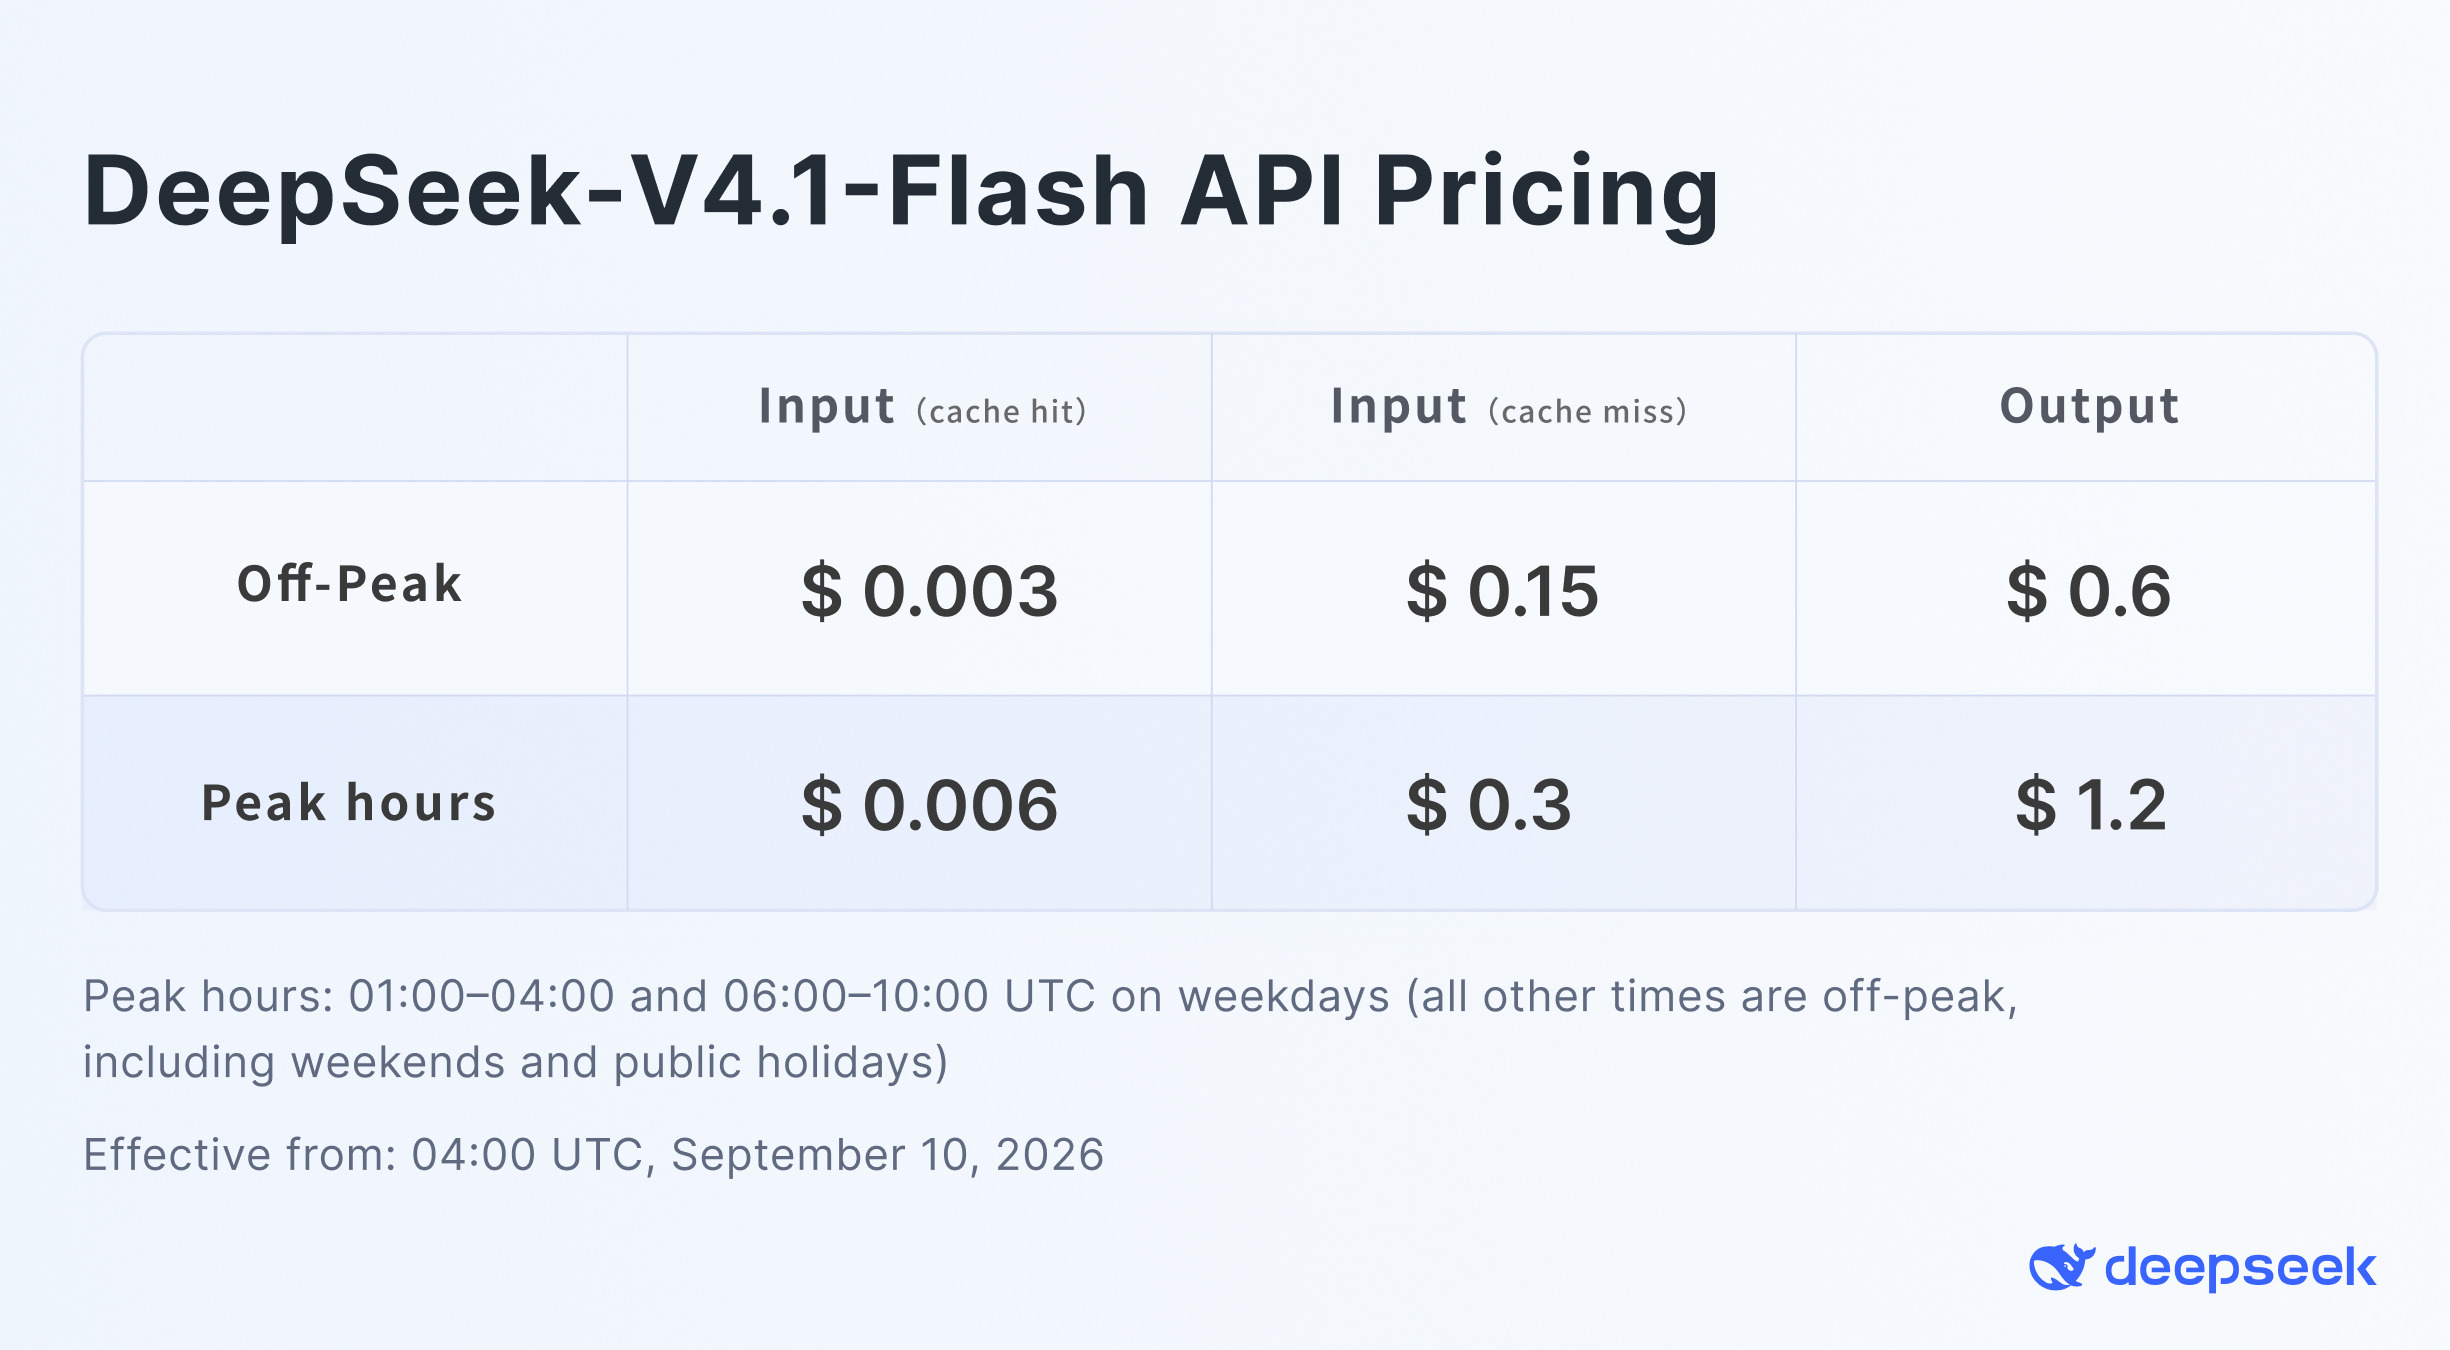
La tarification documentée par DeepSeek utilise des fenêtres de pointe et hors pointe. L’image officielle de tarification indique des tarifs hors pointe de $0.003/M pour cache-hit d’entrée, $0.15/M pour cache-miss d’entrée, et $0.60/M pour la sortie ; les tarifs de pointe sont doublés.
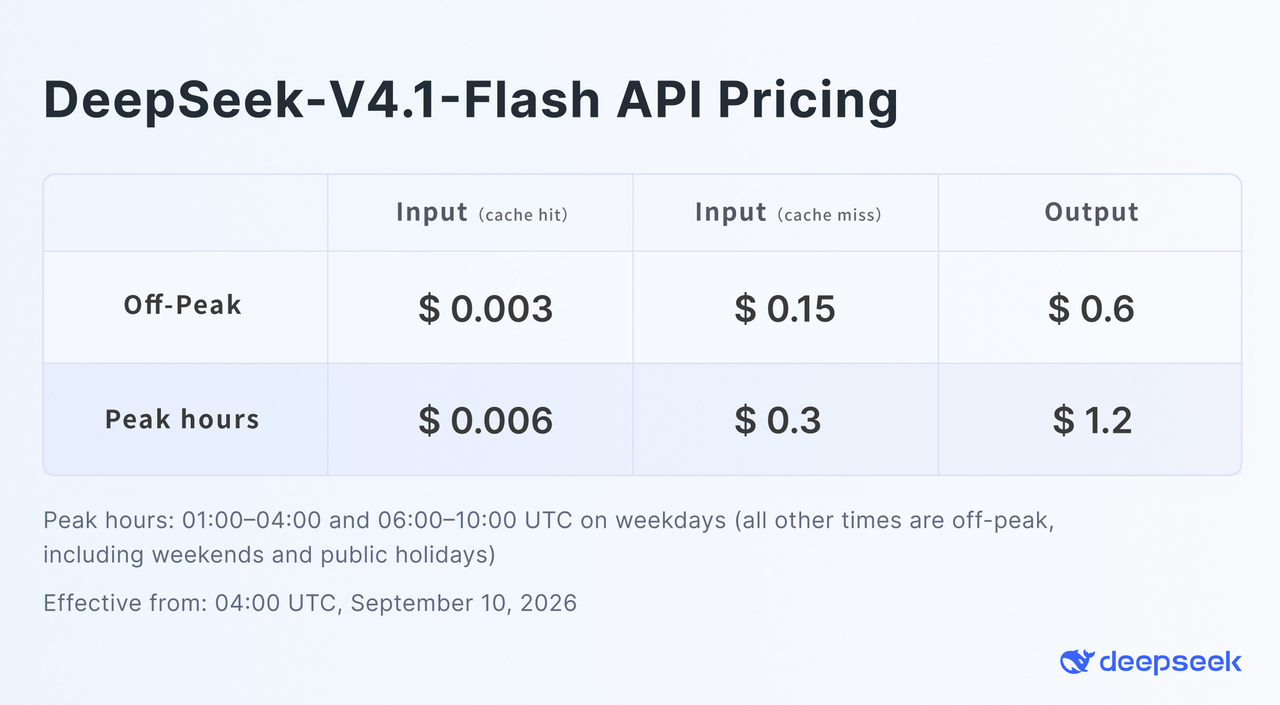
Tarification officielle de l’API DeepSeek V4.1 Flash ? source de l’image officielle
| Catégorie de tokens | CometAPI DeepSeek V4.1 Flash | Tarification officielle DeepSeek |
|---|---|---|
| Entrée / cache miss | $0.1200/M base | $0.15/M hors pointe |
| Sortie | $0.4800/M base | $0.60/M hors pointe |
| Lecture cache / cache hit | $0.0024/M base | $0.003/M hors pointe |
| Multiplicateur de pointe | 2x pendant les fenêtres correspondantes | 2x pendant les fenêtres correspondantes |
| Fenêtre de pointe en semaine 1 | 01:00-04:00 UTC | 01:00-04:00 UTC |
| Fenêtre de pointe en semaine 2 | 06:00-10:00 UTC | 06:00-10:00 UTC |
Un exemple simple au tarif de base pour 100M tokens d’entrée cache-miss et 20M tokens de sortie est :
Input:
100 x $0.12 = $12.00

Output:
20 x $0.48 = $9.60

Total base cost:
$21.60
Le coût réel en production dépend du mix de tokens mis en cache, des multiplicateurs de pointe, des conditions de requête et du tarif fournisseur courant. La grande différence entre les tarifs cache-hit et cache-miss rend les préfixes réutilisables stables — instructions système, schémas d’outils et contexte commun — un levier de coût important.
API DeepSeek V4.1 Flash vs V4 Pro vs V4 Flash
| Dimension | DeepSeek V4.1 Flash | DeepSeek V4 Pro | DeepSeek V4 Flash |
|---|---|---|---|
| Positionnement principal | Raisonnement efficace, agents, vision | Raisonnement V4 haut de gamme | Ancien palier V4 rapide |
| Vision native | Oui | Dépend du modèle / route spécifique | Route vision séparée dans la génération précédente |
| Thinking | Oui | Oui | Oui |
| Performance agents | La plus forte des trois sur de nombreux tests publiés | Forte | Inférieure à V4.1 sur les tests publiés |
| ID canonique first-party | deepseek-flash | deepseek-v4-pro | Alias hérités/compatibilité |
| ID CometAPI | deepseek-v4.1-flash | deepseek-v4-pro | deepseek-v4-flash |
| Meilleur usage | Nouvelles charges agents/codage à haut volume | Charges validées spécifiquement sur Pro | Compatibilité héritée et comparaisons |
Statut actuel : la
documentation Models & Pricing en ligne
indique que DeepSeek V4 Pro reste disponible après le 14 septembre 2026, avec une facturation inchangée. Vérifiez la documentation live avant de vous appuyer sur le routage ou le comportement de migration.
Que faut-il tester avant de mettre l’API DeepSeek V4.1 Flash en production ?
- Routage du modèle : confirmez deepseek-v4.1-flash dans CometAPI et conservez les IDs spécifiques au fournisseur dans la configuration plutôt que dans la logique applicative.
- Régression de prompt : exécutez des prompts de production représentatifs et comparez la réussite des tâches, pas seulement les scores de benchmark.
- Sortie structurée : validez chaque réponse JSON par rapport au schéma de l’application et définissez un chemin de réparation ou de retry.
- Appels d’outils : testez les types d’arguments, les appels malformés, les appels parallèles et les conditions de terminaison de boucles.
- Contrôles de thinking : vérifiez quels champs CometAPI transmet et mesurez l’impact en latence et tokens de chaque paramètre.
- Vision : testez de vraies captures d’écran et documents, y compris les limites de taille, les URLs inaccessibles et les rôles de message non pris en charge.
- Streaming : gérez les deltas vides, les connexions interrompues, les limites de retry et la comptabilisation finale de l’usage.
- Long contexte et caching : mesurez la qualité de réponse, le ratio cache-hit et le coût à mesure que la longueur du prompt augmente.
- Fiabilité : enregistrez les latences p50, p95 et p99 ; exercez les chemins 429, 5xx, timeout et fallback.
- Contrôle des coûts : suivez les tokens d’entrée, d’entrée mise en cache, de raisonnement et de sortie par tâche terminée.
Pour les charges d’agents, comparez le coût par tâche terminée — pas seulement les dollars par million de tokens. Un modèle peut être plus cher par token de sortie et rester moins coûteux de bout en bout s’il réduit les retries et les appels d’outils ; l’inverse est aussi vrai quand un effort de raisonnement plus élevé ajoute des tokens sans améliorer la réussite.
L’API DeepSeek V4.1 Flash vaut-elle la peine d’être utilisée ?
Pour les nouvelles intégrations DeepSeek, DeepSeek V4.1 Flash est un solide candidat par défaut pour la famille Flash, car il combine une meilleure performance agentique publiée avec une vision native et des tarifs agressifs.
Ses cas d’usage les plus forts ne sont pas le chat générique seul. L’adéquation est meilleure pour les agents de codage, l’ingénierie logicielle automatisée, l’analyse long contexte, les assistants multimodaux, l’automatisation de flux à haut volume et les agents utilisant des outils où le contexte réutilisé peut dominer le coût total.
Pour les développeurs souhaitant conserver une architecture de SDK style OpenAI, l’API DeepSeek V4.1 Flash dans CometAPI offre le schéma d’intégration utilisé dans tout ce guide : conservez l’interface client standard, pointez-la vers https://api.cometapi.com/v1 et utilisez deepseek-v4.1-flash.
FAQ de l’API DeepSeek V4.1 Flash
Comment organiser les IDs de modèle spécifiques au fournisseur ?
Stockez le fournisseur, l’URL de base et l’ID de modèle ensemble dans une configuration spécifique à l’environnement. Cela évite qu’un ID first-party tel que deepseek-flash soit envoyé par erreur à une route CometAPI qui attend deepseek-v4.1-flash.
Comment améliorer la réutilisation du cache dans des agents longue durée ?
Conservez des instructions système stables, des schémas d’outils et un contexte de référence partagé au début du prompt. Ajoutez ensuite l’entrée utilisateur volatile et les résultats d’outils pour que le préfixe réutilisable change moins souvent.
Quelle est la manière la plus sûre de comparer V4.1 Flash à V4 Pro ?
Rejouez le même ensemble de tâches de production, plafonnez les budgets de retry et comparez le taux de complétion, la latence, le nombre d’appels d’outils et le total de tokens. Un prix par token plus bas ne garantit pas un coût inférieur par tâche réussie.
Quelle politique de fallback un agent doit-il utiliser ?
Définissez quelles erreurs sont retentables, fixez un plafond strict de retries, et sélectionnez un modèle de fallback seulement après avoir préservé l’état d’outil nécessaire pour reprendre en sécurité. Journalisez chaque fallback afin que les dérives silencieuses de qualité soient visibles.
Comment les entrées d’image doivent-elles être validées avant l’envoi ?
Vérifiez la véritable signature du fichier, le format pris en charge, la taille en octets, l’accessibilité de l’URL et le rôle de message. Supprimez les métadonnées inutiles et évitez d’envoyer des images sensibles sauf si vos politiques de rétention et d’accès l’autorisent explicitement.
Quand envisager l’API Responses plutôt que Chat Completions ?
Utilisez Chat Completions pour maintenir un workflow de messages compatible OpenAI existant. Envisagez l’API Responses lorsque l’application bénéficie d’items d’entrée typés, d’images de sortie d’outils ou de sortie JSON Schema, puis confirmez que la route fournisseur sélectionnée prend en charge les champs requis.
Comment gérer les échecs de validation de schéma ?
Rejetez la sortie invalide avant qu’elle n’atteigne les systèmes en aval, enregistrez l’erreur de validation et réessayez avec un prompt de réparation borné. Si la réparation échoue de manière répétée, orientez la tâche vers un fallback sûr plutôt que d’accepter un JSON plausible mais invalide.