
Réponse d'abord
Kimi K4 n’a pas été officiellement publié, et Moonshot AI n’a pas communiqué ses spécifications finales, ses résultats de benchmark, sa tarification API ou sa date de sortie. Le signal public le plus solide à ce jour provient d’informations rapportant que Moonshot cherche des capacités supplémentaires Blackwell de Nvidia pour un successeur attendu significativement plus grand que Kimi K3. C’est une preuve significative qu’un modèle de prochaine génération est en préparation, mais ce n’est pas une annonce officielle de produit.
Ce qui peut être abordé de manière responsable, c’est la direction que K4 pourrait prendre. L’actuel Kimi K3 à 2,8 billions de paramètres combine déjà une mise à l’échelle clairsemée de type Mixture-of-Experts, une vision native, une fenêtre de contexte d’un million de tokens et des capacités d’agents à long horizon. Kimi K4 sera donc plus vraisemblablement évalué sur l’exécution agentique fiable, la profondeur en codage, le raisonnement multimodal et l’efficacité de mise à l’échelle plutôt que sur le seul nombre de paramètres.
La conclusion centrale est simple : Kimi K4 semble être en développement, mais presque toutes les spécifications numériques circulant en dehors de l’entreprise restent non confirmées. Toute prévision crédible doit distinguer les faits vérifiés de K3, les informations rapportées sur K4 et les inférences prospectives.
Qu’est-ce que Kimi K4 ?4
Kimi K4 est le nom public utilisé pour désigner le successeur attendu par Moonshot AI de Kimi K3. Il doit actuellement être considéré comme un modèle en développement plutôt qu’un produit API annoncé. Moonshot AI n’a publié ni fiche modèle K4, ni rapport technique, ni identifiant API, ni page de prix, ni licence, ni tableau de benchmarks.
The Information rapporte que Moonshot AI discute des plans pour Kimi K4. Citant deux personnes au fait du dossier, le rapport décrit K4 comme significativement plus grand que K3 et indique que Moonshot cherche à accéder à des puces Nvidia Blackwell supplémentaires pour préparer le modèle. Toutefois, il ne confirme pas un nombre exact de paramètres — cinq billions, six billions, ou autre — et n’établit pas si K4 sera publié en poids ouverts, offert uniquement via des produits hébergés, ou décliné en plusieurs variantes.
Cette incertitude est importante car les sorties Kimi ont historiquement combiné des poids de modèle, des APIs hébergées, des produits destinés aux utilisateurs finaux et des systèmes d’agents spécialisés. Une future annonce K4 pourrait désigner un modèle, une famille de modèles, ou un système plus large construit autour du routage, des outils, de la mémoire et de composants multimodaux.
Pourquoi Kimi K4 attire-t-il l’attention si tôt ?
Kimi K3 a relevé le plafond de mise à l’échelle en poids ouverts
Kimi K3 a établi une base inhabituellement ambitieuse. Son résumé officiel mentionne 2,8 billions de paramètres totaux, 104 milliards de paramètres activés, 93 couches, 896 experts routés, 16 experts sélectionnés par token, deux experts partagés, et une longueur de contexte de 1 048 576 tokens. Le modèle inclut aussi un encodeur de vision MoonViT-V2 de 401 millions de paramètres.
Cette combinaison rend K3 important pour deux raisons distinctes. Premièrement, elle montre que des modèles à poids ouverts peuvent se hisser dans la même grande classe de capacités que les systèmes propriétaires leaders. Deuxièmement, son design clairsemé démontre que le nombre total de paramètres et le coût d’inférence ne sont pas la même chose : seul un sous-ensemble d’experts est actif pour chaque token.
Des rapports indiquent un successeur encore plus grand
Des informations industrielles indiquent que Moonshot AI recherche davantage de compute de classe Blackwell pour K4 et décrivent le modèle prévu comme significativement plus grand que K3. Ce rapport constitue la meilleure preuve publique que K4 est plus qu’une simple spéculation communautaire, mais il laisse non résolus l’architecture finale, le calendrier d’entraînement, la taille du modèle et le plan de déploiement.
La question du compute est pertinente car l’échelle crée deux goulots distincts. L’entraînement nécessite suffisamment d’accélérateurs, de réseau, de stockage et de stabilité d’ingénierie pour mener à bien une exécution de pointe. La mise en service requiert ensuite une stratégie d’inférence séparée capable d’assurer une latence et un coût acceptables. Un K4 plus grand aurait donc besoin d’améliorations architecturales et systèmes, pas seulement de davantage de matériel.
L’architecture de K3 a été conçue pour aller plus loin
Le blog technique de Kimi K3 de Moonshot décrit Kimi Delta Attention et Attention Residuals comme l’ossature d’un modèle conçu pour passer à l’échelle au-delà du régime du billion de paramètres. Kimi Delta Attention fournit une base d’attention efficace, tandis que les Attention Residuals récupèrent sélectivement des représentations à travers la profondeur du modèle au lieu de les accumuler uniformément.
K3 utilise aussi Stable LatentMoE, activant effectivement 16 des 896 experts routés. Quantile Balancing détermine l’allocation des experts à partir des quantiles des scores du routeur, et Per-Head Muon optimise indépendamment les têtes d’attention. Ces choix pointent vers les problèmes que K4 doit résoudre : un routage stable, une utilisation équilibrée des experts, une attention long-contexte efficace et un entraînement prévisible à l’échelle extrême.
Pourquoi Kimi K4 importerait-il si Kimi K3 est déjà un modèle à 2,8 T ?
Kimi K3 opère déjà à une échelle inhabituellement grande, de sorte que K4 ne peut pas être évalué simplement en demandant s’il a plus de paramètres. La question plus pertinente est de savoir si un compute d’entraînement supplémentaire produit une meilleure complétion de tâches, une fiabilité plus forte à long horizon, et un coût d’inférence effectif plus bas.
Une évaluation utile de K4 devrait donc se concentrer sur quatre métriques :
- Taux de complétion des tâches
- Fiabilité agentique à long horizon
- Taux de réussite en codage
- Coût par tâche réussie
La dernière métrique est particulièrement importante pour les développeurs. Un modèle qui coûte moins cher par correctif de dépôt réussi peut être plus précieux qu’un modèle avec un score de benchmark plus élevé mais des trajectoires échouées nettement plus nombreuses.
Spécifications attendues de Kimi K4
Le tableau ci-dessous distingue la base technique confirmée de K3 des informations et inférences concernant K4. Attendu ne signifie pas annoncé. Les champs inconnus doivent le rester jusqu’à ce que Moonshot AI publie une fiche modèle ou une documentation API.
| Specification basis | Kimi K3 confirmé | Kimi K4 rapports publics | Confiance |
|---|---|---|---|
| Statut du modèle | Publié | En développement | Rapporté |
| Architecture | MoE clairsemé | Non divulguée ; probablement une évolution MoE clairsemé | Inférence |
| Paramètres totaux | 2.8T | Annoncé comme significativement plus grand que K3 | Rapporté ; valeur exacte inconnue |
| Paramètres activés | 104B | Non divulgué | Inconnu |
| Configuration d’experts | 896 routés ; 16 sélectionnés ; 2 partagés | Non divulguée | Inconnu |
| Fenêtre de contexte | 1,048,576 tokens | Probablement au moins 1 M, mais non confirmé | Attendu |
| Attention | KDA plus Gated MLA | Possible KDA de nouvelle génération | Inférence |
| Vision native | MoonViT-V2 | Continuité multimodale probable | Attendu |
| Poids ouverts | Disponibles | Non confirmé | Inconnu |
| ID du modèle API | kimi-k3 | Non annoncé | Inconnu |
| Date de sortie | Disponible | Non annoncée | Inconnu |
La contrainte la plus importante est la ligne des paramètres. Significativement plus grand n’établit pas une taille exacte. De même, la fenêtre de contexte d’un million de tokens de K3, son design multimodal et sa sortie en poids ouverts ne peuvent pas être recopiés dans la fiche de K4 comme des faits confirmés. Ce sont des attentes plausibles directionnelles, non des engagements produits publiés.
Quelles fonctionnalités Kimi K4 pourrait-il introduire ?
-
Mise à l’échelle MoE clairsemée plus grande mais plus efficace
L’attente évidente est un modèle Mixture-of-Experts plus grand. La question plus importante est de savoir si K4 améliore la relation entre la capacité totale, la capacité activée et le coût de service. Augmenter le pool d’experts sans améliorer le routage pourrait créer des spécialistes sous-utilisés, des experts « chauds », des goulets de communication et un entraînement instable.
Une avancée crédible de K4 combinerait une capacité supplémentaire avec un meilleur équilibrage de charge, des experts plus spécialisés, des ratios d’activation plus faibles, ou une coordination inter-experts plus robuste. Aucun de ces détails n’a été divulgué ; un article devrait donc les décrire comme des cibles d’ingénierie plutôt que comme des fonctionnalités divulguées.
Un Kimi Delta Attention plus avancé
Kimi Delta Attention est central au design long-contexte de K3. Une version de nouvelle génération pourrait améliorer la récupération à travers des entrées à un million de tokens, réduire la mémoire d’état d’attention, et préserver l’information importante lors de longues exécutions d’agents. Le test pratique ne serait pas seulement la taille de la fenêtre de contexte, mais la capacité du modèle à trouver, combiner et agir sur des preuves lointaines sans fragmentation agressive ni récupération répétée.
Des agents plus fiables sur long horizon
Kimi K3 est déjà positionné pour des travaux techniques et de connaissance à long terme. Ses démonstrations officielles incluent le développement de compilateurs, l’optimisation de kernels GPU, le codage scientifique, la recherche interactive, le développement de jeux, et des workflows de conception de puces. K4 devrait transformer ces démonstrations impressionnantes en exécutions quotidiennes plus cohérentes.
Les métriques qui comptent sont moins d’appels d’outils inutiles, une meilleure rétention des objectifs, une meilleure récupération après des actions échouées, une vérification plus fiable, et une variance plus faible entre les runs. Un modèle qui réussit un benchmark difficile une fois mais se comporte de manière imprévisible en production est moins utile qu’un modèle légèrement plus faible à l’exécution fiable.
Un codage et une ingénierie logicielle renforcés
K4 devrait rester fortement orienté vers le codage, mais la frontière a dépassé la génération de fonctions isolées. Les modèles compétitifs d’ingénierie logicielle doivent cartographier des dépôts, comprendre des dépendances, opérer des terminaux, modifier plusieurs fichiers, exécuter des tests, diagnostiquer des échecs et réviser leur approche.
K3 est déjà performant sur ProgramBench, SWE-Marathon, FrontierSWE et les tâches terminal. La meilleure opportunité de K4 est de combler l’écart restant sur la réparation de dépôts profonds tout en préservant l’avantage de K3 dans le travail soutenu multi-étapes.
Une multimodalité native plus profonde
K3 combine texte et vision au niveau du modèle, et les exemples produits de Moonshot étendent cette capacité à l’édition vidéo et au développement avec vision dans la boucle. K4 pourrait améliorer les workflows capture d’écran-vers-code, le raisonnement sur graphiques et documents, la compréhension temporelle vidéo, les tests d’interface, et des agents qui inspectent les résultats visuels avant de continuer.
La distinction clé est entre accepter des images et utiliser la perception dans une boucle fermée. Un agent multimodal doit observer un rendu, identifier l’écart, éditer son travail, et vérifier la révision. C’est plus exigeant que de répondre à une seule question d’image.
Une meilleure efficacité d’inférence et de déploiement
Un modèle plus grand que K3 pourrait être difficile à auto-héberger même si ses poids sont publiés. K4 bénéficierait d’un entraînement conscient de la quantification, d’un parallélisme d’experts efficace, d’un décodage spéculatif, d’une gestion optimisée des états KV, et de variantes compagnons plus petites. Pour la plupart des équipes, un accès API hébergé pourrait rester plus pratique que d’opérer directement un modèle clairsemé de pointe.
Quelles performances de benchmark Kimi K4 devrait-il atteindre ?
K4 n’a publié aucun résultat de benchmark. L’approche responsable consiste à établir la barre de performance créée par K3 et les concurrents de pointe actuels, puis à identifier où un successeur devrait s’améliorer. La base élargie ci-dessous couvre le raisonnement, le codage, l’opération de terminal, la recherche profonde, le travail de connaissance agentique, et les tâches sur feuilles de calcul. Toutes les valeurs proviennent de la fiche modèle officielle Kimi K3 liée dans l’en-tête du tableau.
| Official benchmark suite | Kimi K3 | GPT-5.6 Sol | Claude Fable 5 | Claude Opus 4.8 |
|---|---|---|---|---|
| GPQA Diamond | 93.5 | 94.1 | 92.6 | 91.0 |
| DeepSWE | 67.5 | 73.0 | 70.0 | 59.0 |
| ProgramBench | 77.8 | 77.6 | 76.8 | 71.9 |
| Terminal-Bench 2.1 | 88.3 | 88.8 | 88.0 | 84.6 |
| FrontierSWE | 81.2 | 71.3 | 86.6 | 66.7 |
| SWE-Marathon | 42.0 | 39.0 | 35.0 | 40.0 |
| Kimi Code Bench 2.0 | 72.9 | 64.8 | 76.9 | 71.7 |
| BrowseComp | 91.2 | 90.4 | 88.0 | 84.3 |
| DeepSearchQA (F1) | 95.0 | Not reported | 94.2 | 93.1 |
| ResearchRubrics | 76.2 | 73.8 | Not reported | 73.5 |
| GDPval-AA v2 (Elo) | 1686 | 1736 | 1747 | 1593 |
| SpreadsheetBench 2 | 34.8 | 32.4 | 34.7 | 31.6 |
Ce sont des résultats de comparaison rapportés par Moonshot plutôt qu’un classement unique indépendant. Certains modèles ont été évalués via différents harnais d’agents, et les notes officielles décrivent des solutions de repli, des cyberguards, des substitutions matérielles, des réglages de raisonnement et des procédures spécifiques aux benchmarks. GDPval-AA v2 est une note Elo et ne doit pas être comparée numériquement aux lignes en pourcentage. De petites différences de score ne doivent pas être interprétées comme une supériorité universelle.
Instantané officiel des benchmarks de codage
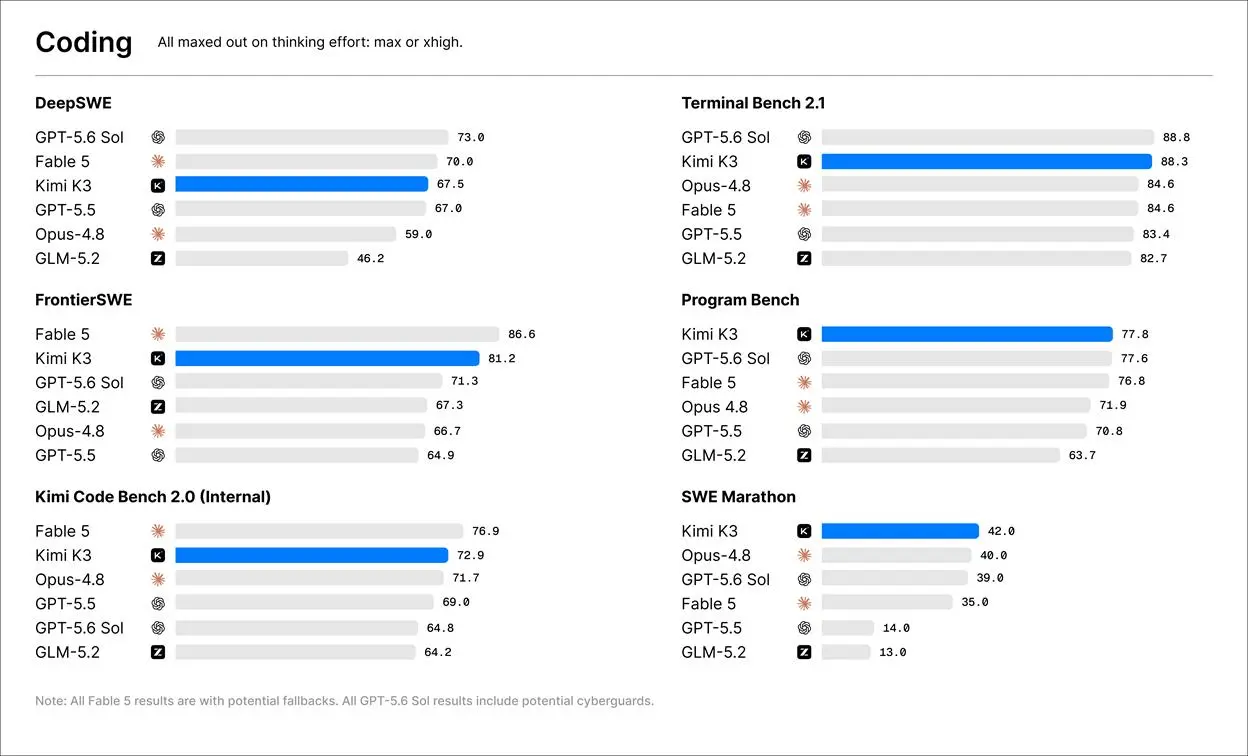
Comparaison officielle de codage Kimi K3. L’image est un graphisme publié par Moonshot ; consultez la fiche modèle et notes actuelles pour le dernier tableau numérique et la méthodologie d’évaluation.
Résultats et interprétation des benchmarks
GPT-5.6 Sol devance Kimi K3 sur DeepSWE, indiquant un avantage sur les réparations logicielles difficiles au niveau des dépôts. Claude Fable 5 mène sur FrontierSWE, tandis que K3 reste confortablement devant GPT-5.6 Sol et Claude Opus 4.8 sur ce benchmark.
Le profil de K3 devient plus distinctif sur le travail soutenu. Il devance légèrement ProgramBench et enregistre le meilleur résultat sur SWE-Marathon dans la comparaison sélectionnée. Il devance aussi BrowseComp et est essentiellement à égalité avec Claude Fable 5 sur SpreadsheetBench 2.
Pour K4, l’objectif ne devrait pas être une augmentation en pourcentage fixe sur chaque graphique. La cible la plus utile est d’améliorer la réparation profonde de bases de code et la fiabilité de l’usage de l’ordinateur sans perdre les forces de K3 dans le codage à long horizon, la navigation et le travail de connaissance agentique.
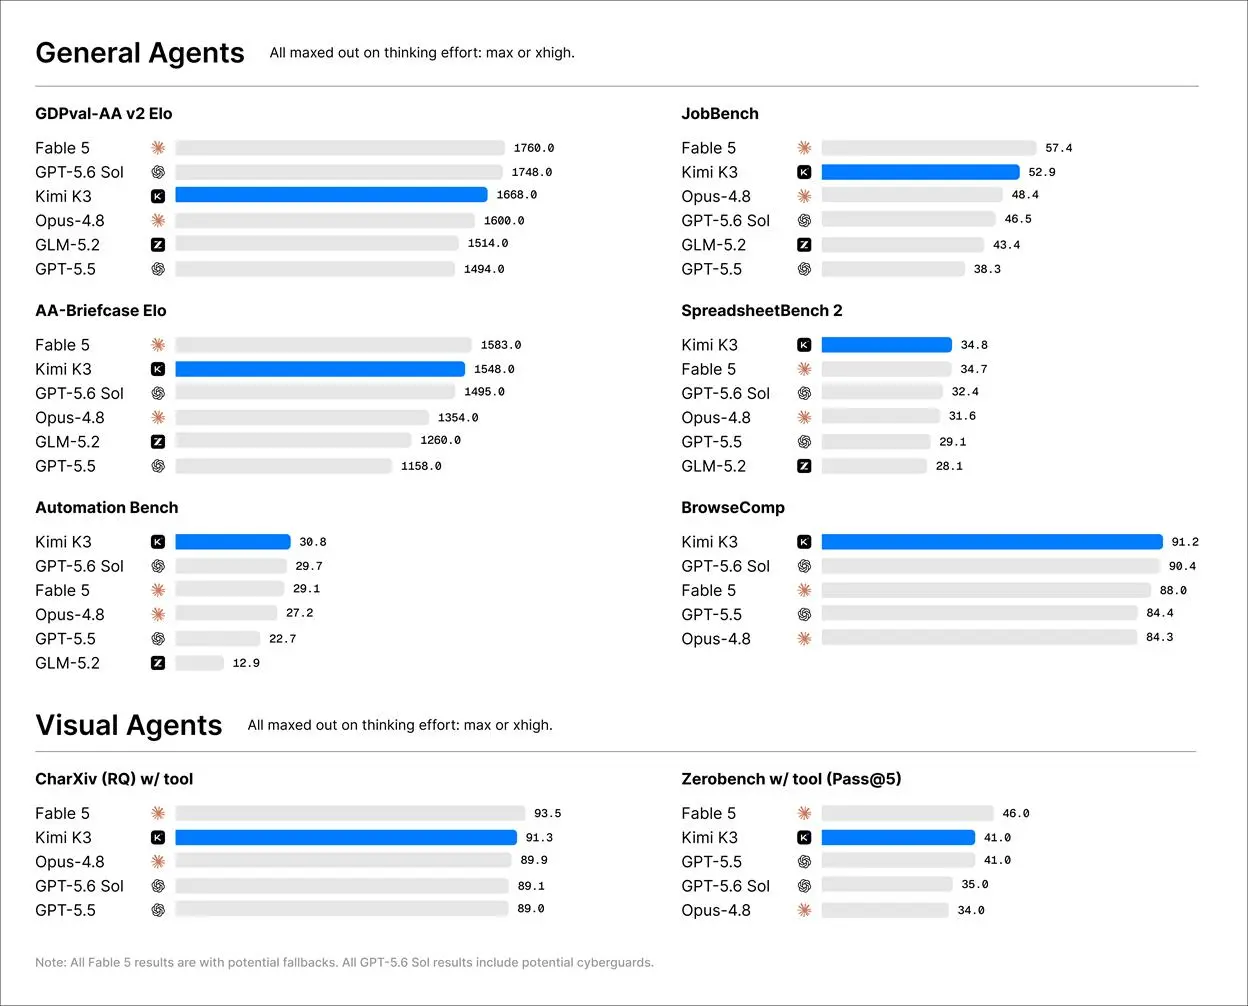
Comparaison officielle d’agents généraux et visuels Kimi K3. Source : page du modèle Kimi K3 de Moonshot AI.
Kimi K4 vs Kimi K3, GPT-5.6 Sol et Claude Fable 5
Une comparaison pré-sortie ne peut pas attribuer à K4 des scores qui n’existent pas. Elle peut, cependant, montrer la position concurrentielle que K4 serait censé occuper s’il prolonge la lignée K3.
| Dimension | Position attendue de Kimi K4 | Kimi K3 confirmé | Références fermées : GPT-5.6 Sol et Claude Fable 5 |
|---|---|---|---|
| Disponibilité | En développement | Disponible | Disponible |
| Ouverture du modèle | Inconnue | Poids ouverts | Propriétaire |
| Contexte confirmé | Inconnu | 1 M de tokens | Défini par le fournisseur ou classe 1 M |
| Force principale | Intelligence de frontière à plus grande échelle attendue | Codage et travail de connaissance à long horizon | Raisonnement, codage et usage de l’ordinateur de pointe |
| Multimodalité | Attendue ; non confirmée | Vision native | Multimodal |
| Auto-hébergement | Inconnu | Possible avec une infrastructure substantielle | Non disponible |
| Maturité agent | Attendue en amélioration | Forte | Forte |
| Coût de déploiement | Inconnu et potentiellement élevé | Élevé pour l’auto-hébergement ; API hébergée disponible | API hébergée uniquement |
| Raison principale d’intérêt | Échelle plus possible ouverture | Référence ouverte de frontière vérifiée | Capacité maximale des modèles fermés |
Résultat de la comparaison
Kimi K3 se distingue par des poids ouverts, une fenêtre de contexte d’un million de tokens et de fortes performances à long horizon. GPT-5.6 Sol reste plus fort sur certaines tâches de raisonnement difficiles et de réparation de dépôts, tandis que Claude Fable 5 est particulièrement compétitif en ingénierie logicielle et agents d’usage de l’ordinateur.
Si K4 reste ouvert ou largement accessible tout en comblant ces écarts de capacités, son importance irait au-delà d’un nombre de paramètres plus grand. Il montrerait que des systèmes ouverts ou semi-ouverts peuvent approcher la fiabilité des plateformes agentiques propriétaires les plus fortes. Si K4 devient fermé et extrêmement coûteux à servir, la distinction pratique serait bien moindre.
Que pourrait signifier Kimi K4 pour l’IA à poids ouverts ?
K3 démontre déjà que le développement à poids ouverts entre dans une échelle autrefois associée presque exclusivement aux laboratoires propriétaires. K4 pourrait repousser encore cette frontière, mais l’ouverture possède plusieurs couches : poids téléchargeables, code exploitable, licence utilisable, inférence reproductible, exigences matérielles abordables, et APIs hébergées accessibles.
Un modèle peut être techniquement ouvert mais économiquement inaccessible. L’échelle de 2,8 T de K3 signifie qu’un auto-hébergement sérieux nécessite une infrastructure substantielle même avec activation clairsemée et quantification. Un K4 encore plus grand pourrait élargir l’écart entre les chercheurs pouvant inspecter les poids et les organisations capables d’opérer le modèle efficacement.
Pour l’écosystème plus large, la sortie idéale de K4 combinerait des poids transparents, des recettes d’inférence efficaces, un comportement de tool-use robuste, et une API hébergée. Cette combinaison permettrait aux chercheurs d’étudier le modèle, aux entreprises de le déployer via une API, et à des équipes spécialisées de l’adapter à des charges privées ou réglementées.
Quand Kimi K4 sera-t-il publié ?
Moonshot AI n’a pas annoncé de date de sortie pour Kimi K4. Les rapports publics relient le modèle à l’approvisionnement en compute et à la planification de développement. Cela rend peu fiable toute prédiction précise de mois, trimestre ou compte à rebours.
Il est également inconnu si K4 apparaîtra simultanément dans le produit web Kimi, Kimi Code, Kimi Work, l’API Moonshot, et un dépôt de poids ouverts. K3 est disponible sur plusieurs de ces surfaces, mais K4 pourrait suivre un déploiement par étapes ou une stratégie de distribution différente.
Les signaux à surveiller sont un blog technique officiel de Moonshot, un dépôt de modèle vérifié, une documentation Kimi Platform, une licence publiée, et une fiche modèle avec des détails d’évaluation reproductibles. Les publications sociales et les rumeurs de paramètres doivent rester secondaires jusqu’à l’apparition de l’une de ces sources.
Comment accéder aux modèles Kimi en attendant K4
K4 n’est actuellement pas appelable. Les développeurs peuvent à la place évaluer l’architecture actuelle via Kimi K3 sur CometAPI. L’ID de modèle actuel est du texte de code simple : kimi-k3. La requête utilise POST /v1/chat/completions. N’envoyez pas de requêtes de production à un identifiant kimi-k4 spéculatif tant qu’une page d’intégration officielle ne l’a pas publié.
Créez un compte CometAPI et générez une clé API. Stockez la clé dans une variable d’environnement plutôt que de la coder en dur dans le code source de l’application.
from openai import OpenAI client = OpenAI( api_key="YOUR_COMETAPI_KEY", base_url="https://api.cometapi.com/v1", ) response = client.chat.completions.create( model="kimi-k3", messages=[ { "role": "user", "content": "Analyze the architecture of this software project." } ], ) print(response.choices[0].message.content)
Le bloc de code est en Python. L’endpoint, l’ID du modèle, les noms de paramètres et les mots-clés du code sont intentionnellement présentés comme du code plutôt que comme des hyperliens. Lorsque K4 sera disponible, les développeurs devront confirmer son véritable identifiant de modèle, la compatibilité de l’endpoint, les modalités prises en charge et la tarification avant de modifier le routage de production.
Ce que nous ne savons toujours pas sur Kimi K4
Un article responsable avant la sortie devrait conserver les inconnues suivantes plutôt que de les remplir avec des estimations communautaires :
- Comptes finaux de paramètres totaux et activés
- Nombre d’experts, experts partagés et stratégie de routage
- Fenêtre de contexte et longueur maximale de sortie
- Modalités d’entrée et de sortie prises en charge
- Statut de poids ouverts, dépôt et licence
- ID du modèle API, endpoints, modes de raisonnement et tarification
- Résultats officiels de benchmarks et harnais d’évaluation
- Formats de quantification et exigences matérielles d’auto-hébergement
- Disponibilité produit et date de sortie
Garder cette section explicite empêche que des spécifications prédites ne soient répétées plus tard comme des faits officiels. Cela rend également l’article plus facile à mettre à jour lorsque Moonshot AI publiera une documentation primaire.
FAQ
Kimi K4 a-t-il été publié ?
Non. Il n’existe pas de fiche modèle Kimi K4, de documentation API ou d’annonce publique de sortie officielle. La discussion actuelle repose principalement sur des informations selon lesquelles Moonshot AI prépare un successeur plus grand que K3.
Quelle sera la taille de Kimi K4 ?
La taille exacte est inconnue. Des rapports indiquent qu’il pourrait être significativement plus grand que K3, mais des revendications spécifiques multi-trillions de paramètres n’ont pas été confirmées par Moonshot AI.
Kimi K4 sera-t-il open source ?
Cela n’a pas été confirmé. K3 propose des poids ouverts sous la Kimi K3 License, mais une stratégie de sortie précédente ne garantit pas la même distribution pour K4.
Kimi K4 aura-t-il une fenêtre de contexte d’un million de tokens ?
Il est raisonnable d’attendre que K4 conserve ou améliore la capacité long-contexte de K3, mais Moonshot AI n’a pas publié de limite de contexte pour K4.
Les développeurs peuvent-ils utiliser Kimi K4 via CometAPI maintenant ?
Aucune route de modèle K4 confirmée n’est disponible. Les développeurs peuvent actuellement tester Kimi K3 et le comparer à d’autres modèles de frontière via la même couche d’intégration.
Conclusion
Kimi K4 ne doit pas être réduit à un nombre de paramètres supposé. K3 prouve déjà que Moonshot AI peut combiner une échelle extrême de modèle clairsemé, un contexte d’un million de tokens, une vision native, des poids ouverts, et un comportement d’agents à long horizon. La vraie question est de savoir si K4 peut transformer cette échelle en ingénierie logicielle plus fiable, usage de l’ordinateur plus robuste, meilleures boucles de retour multimodales et inférence plus efficace.
Les détails les plus importants restent inconnus : architecture exacte, date de sortie, scores de benchmarks, licence, accès API et coût de service. Tant que Moonshot ne publie pas de documentation primaire, toute spécification K4 au-delà du signal de développement rapporté doit être étiquetée comme attente ou inférence.
Les développeurs n’ont pas besoin d’attendre pour évaluer la direction actuelle de Moonshot AI. Kimi K3 est déjà disponible via CometAPI, offrant une base pratique pour le codage, le raisonnement long-contexte, l’analyse multimodale et les workflows d’agents avant l’arrivée de Kimi K4.