
GLM-5.3 Flash API를 가장 빠르게 사용하는 방법은 CometAPI의 OpenAI 호환 chat-completions 엔드포인트를 통해 모델을 호출하는 것입니다. 연결 세부 정보는 아래 API 사양 표에 정리되어 있으며, API 키는 서버에 보관하세요.
답부터: CometAPI 키를 생성하고, OpenAI 호환 SDK를 설치한 다음, /v1/chat/completions로 POST 요청을 보냅니다. 기본 요청이 성공한 뒤에 스트리밍, 비전, JSON 출력, 도구 사용을 단계적으로 추가하세요.
GLM-5.3 Flash API란?
GLM-5.3 Flash는 GLM-5 제품군의 효율 우선 네이티브 멀티모달 모델로, 추론, 긴 컨텍스트, 시각 이해, 에이전트 지향 기능을 채팅 API로 제공합니다. 이 모델은 총 320B 파라미터 중 토큰당 18B 활성화 구조를 사용합니다. 이는 비용 측면에서 중요하지만, 개발자는 긴 프롬프트와 반복적인 도구 호출에서도 활성 상태를 유지하는 모델이라는 경험으로 받아들입니다.
이 가이드는 의도적으로 아키텍처와 벤치마크 설명을 간략히 다룹니다. 하이브리드 어텐션 설계, 오픈 가중치, 완전한 출시 벤치마크 매트릭스, 가격 배경 및 제품군 비교는 동반 모델 개요에서 이미 설명합니다. 여기서는 통합 동작과 프로덕션 의사결정에 초점을 맞춥니다.
통합에 영향을 주는 API 사양
| API specification | Value | Practical meaning |
|---|---|---|
| Base URL | https://api.cometapi.com/v1 | 서버 측 클라이언트에서 한 번만 설정합니다. |
| Endpoint | POST /v1/chat/completions | OpenAI 호환 chat-completions 라우트를 사용합니다. |
| Compatible SDKs | OpenAI-compatible Python and JavaScript clients | CometAPI 기본 URL로 익숙한 클라이언트 패턴을 재사용합니다. |
| Authentication | Bearer API key | 서버 측 환경 변수나 시크릿 매니저에 키를 보관합니다. |
| Model code | glm-5.3-flash | 이 값을 요청 본문에 정확히 사용하세요. |
| Context window | 1,048,576 tokens | 대규모 리포지토리, 문서 묶음, 긴 에이전트 히스토리에 적합합니다. |
| Maximum output | Up to 131,072 tokens | 비용과 지연을 제어하려면 애플리케이션별 하한을 설정하세요. |
| Native inputs | Text, image, video, file | 호스팅된 라우트의 지원은 다를 수 있으므로 각 모달리티를 사용하기 전 라우트를 검증하세요. |
| Output | Text | 모델은 미디어를 해석하지만 이미지를 직접 생성해 반환하지는 않습니다. |
| Reasoning | low, high, max | 지연과 토큰 소비를 깊이와 교환하기 위해 노력 수준을 사용하세요. |
| Thinking | Always enabled | Thinking을 비활성화하려는 파라미터를 보내지 마세요. |
| Developer features | Streaming, function calling, caching, structured output | 대화형 앱, 에이전트, 머신 판독 가능한 파이프라인에 유용합니다. |
모델 능력과 게이트웨이 능력은 동일하지 않습니다. 특히 비디오, 파일, 엄격한 JSON Schema, 공급자 고유의 Thinking 필드는 실제 호출하는 라우트의 CometAPI 라이브 모델 페이지와 API 스키마를 계약으로 간주하세요.
간단한 성능 맥락
API 빌더에게 중요한 작업(터미널 작업, 소프트웨어 엔지니어링, 도구 사용, 자동화)에서 Z.ai가 강력한 출시 결과를 보고했습니다. 이는 특정 하니스와 도구 정책으로 얻은 공급자 보고 점수이므로, 보편적 순위를 확정하기보다 강점 가능성을 식별하는 데 유용합니다.
| Benchmark | GLM-5.3 Flash | What it suggests for API workloads |
|---|---|---|
| Terminal-Bench 2.1 | 84.3 | 터미널 기반 코딩 에이전트에 적합합니다. |
| DeepSWE v1.1 | 63.4 | 리포지토리 규모의 소프트웨어 엔지니어링에 유망합니다. |
| Toolathlon Verified | 78.4 | 강한 도구 선택 및 도구 사용 신호를 보입니다. |
| AutomationBench | 48.8 | 전작 대비 다단계 자동화가 개선되었습니다. |
실무적 시사점은 표보다 좁습니다. GLM-5.3 Flash는 긴 컨텍스트와 도구 또는 시각 피드백이 결합된 워크플로우에서 강력한 후보입니다. 전체 모델 비교는 기존의 모델 개요를 사용하세요.
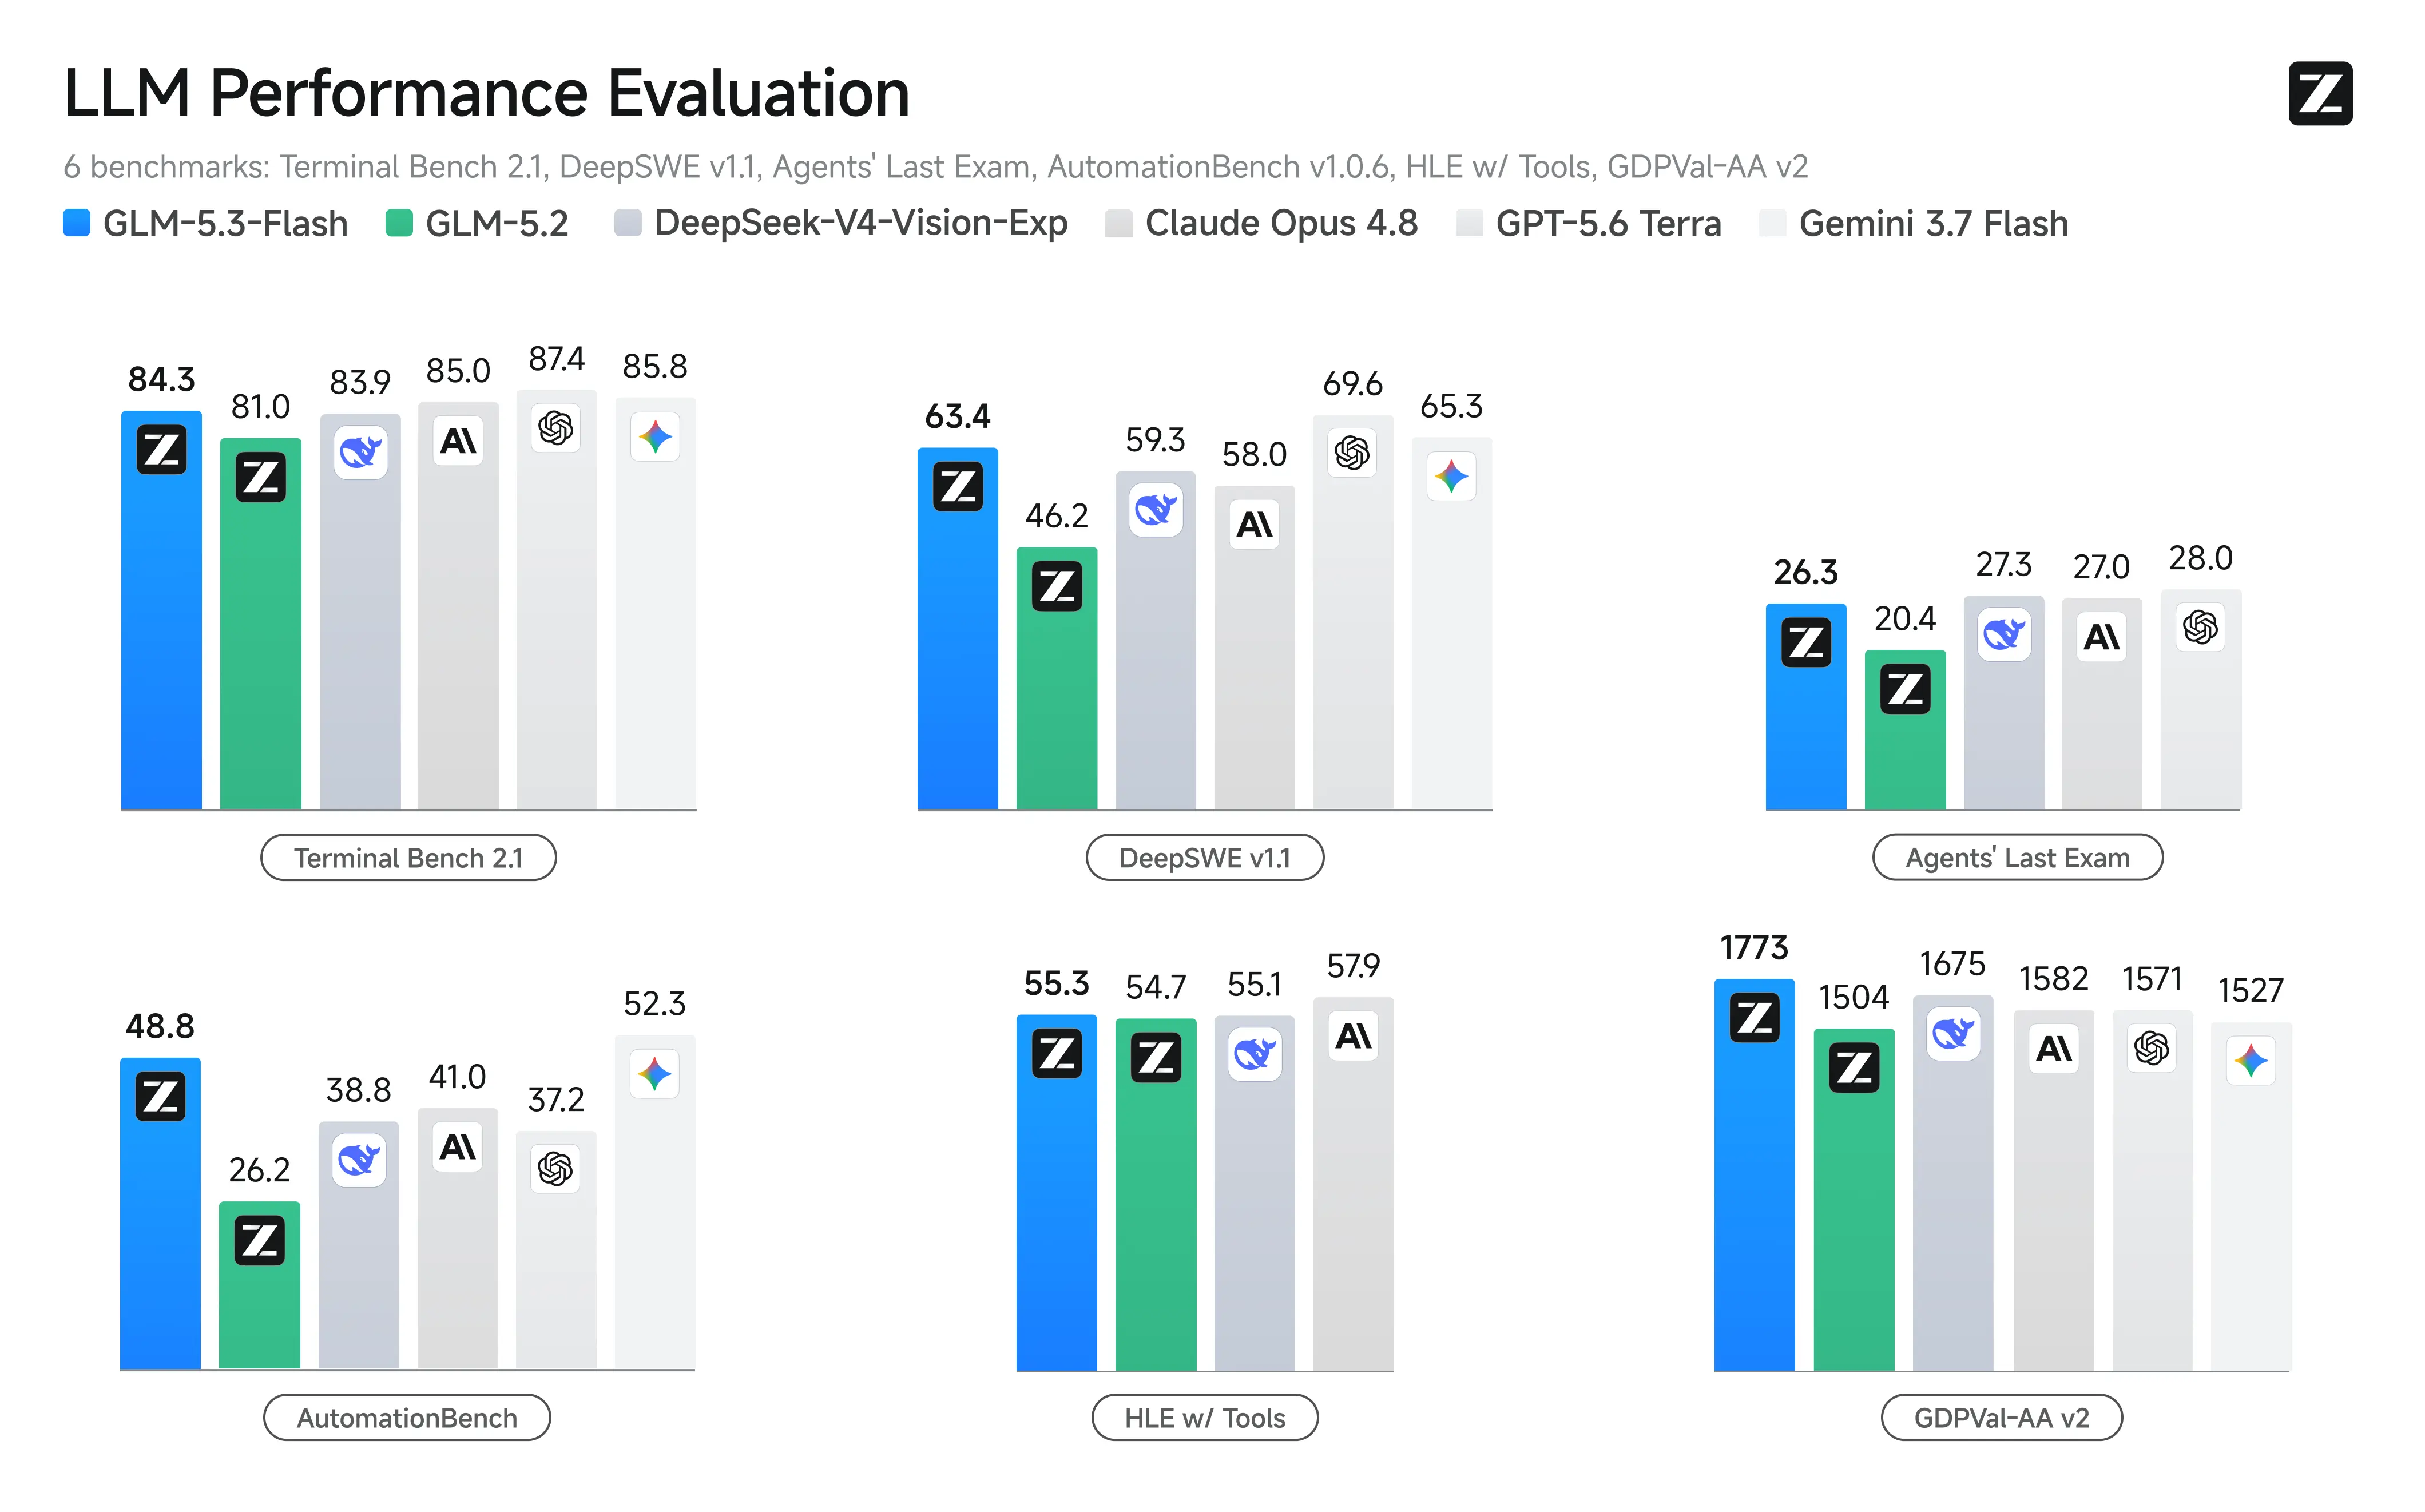
출처: Z.ai 공식 벤치마크 그래픽
이 공식 그래픽은 모델과 노력 설정에 따른 GLM-5.3 Flash 성능을 비교합니다. 본 API 가이드에서는 전체 출시 매트릭스를 반복하기보다 간결한 성능 맥락을 제공합니다. 애플리케이션은 자체 프롬프트에서 작업 성공률, 종단간 지연, 총 토큰 사용량을 측정해야 합니다.
왜 CometAPI를 통해 GLM-5.3 Flash를 사용할까요?
CometAPI는 OpenAI 호환 인터페이스로 GLM-5.3 Flash를 제공합니다. 이를 통해 팀은 익숙한 SDK 패턴을 재사용하고, 자격증명과 결제를 중앙집중화하며, 전체 요청 계층을 재구축하지 않고도 모델을 전환할 수 있습니다.
• 하나의 통합 패턴. 같은 기본 클라이언트로 모델 ID만 바꿔 다양한 지원 모델을 호출할 수 있습니다.
• 중앙화된 사용 가시성. 각 공급자 대시보드를 따로 유지하지 않고도 사용량과 비용을 검토할 수 있습니다.
• 더 빠른 평가. 단일 요청 하니스로 후보 모델 간 응답 품질, 지연, 오류를 비교할 수 있습니다.
• 간소한 폴백 설계. 재시도 및 라우팅 로직을 하나의 게이트웨이 계층에 유지할 수 있습니다.
• 더 낮은 게시 라우트 가격. 현재 모델 페이지에는 백만 입력 토큰당 $0.06, 백만 출력 토큰당 $0.20가 표시됩니다. 예산 책정 전 라이브 페이지를 확인하세요.
시작 전 준비 사항
CometAPI 계정, API 키, 그리고 다음 중 하나의 로컬 환경이 필요합니다.
• Python 3.9 이상과 pip
• Node.js 18 이상과 npm
• 최소한의 커맨드라인 테스트를 위한 cURL
프로덕션 CometAPI 키를 브라우저 JavaScript, 모바일 앱, 공개 리포지토리, 스크린샷, 클라이언트측 로그에 절대 배치하지 마세요. 신뢰할 수 있는 서버에서 CometAPI를 호출하고, 키는 환경 변수 또는 시크릿 매니저에 보관하세요.
CometAPI로 GLM-5.3 Flash API 사용 방법
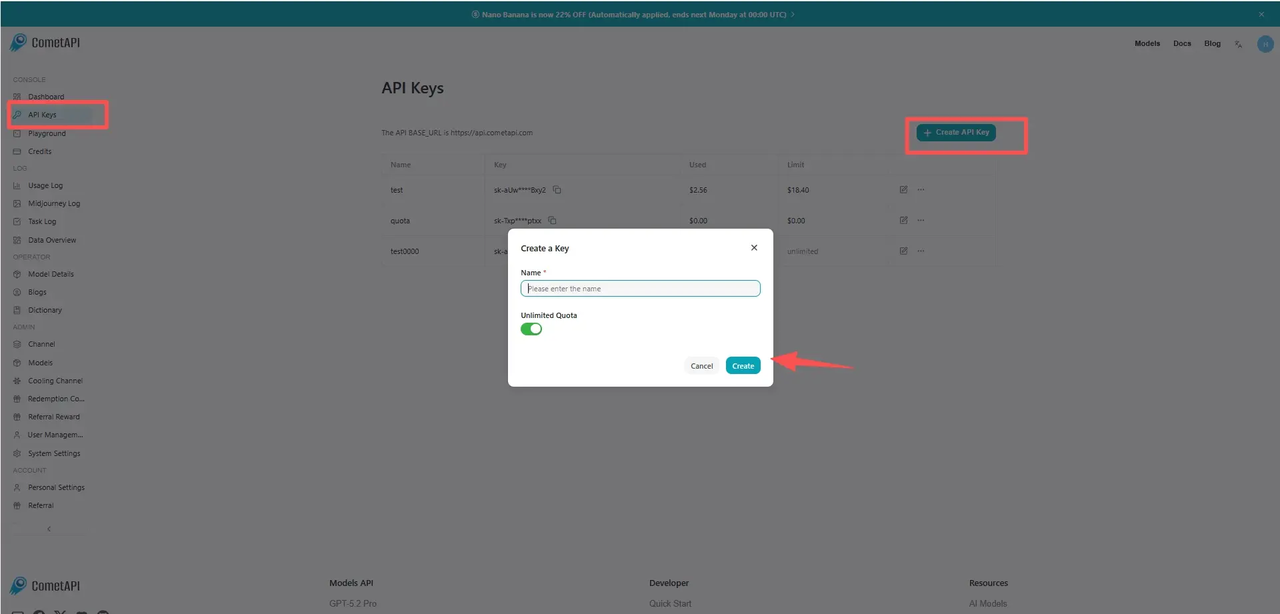
Step 1: CometAPI API 키 생성
CometAPI에 로그인하고 API 키 콘솔을 열어 키를 생성한 뒤, 시크릿 관리 워크플로우에 한 번만 복사하세요. 개발과 프로덕션에 별도의 키를 사용하여, 한 환경을 회전 또는 폐기해도 다른 환경이 중단되지 않도록 하세요.
Step 2: 키를 환경 변수로 저장
$env:COMETAPI_KEY = "your_cometapi_key_here"
export COMETAPI_KEY="your_cometapi_key_here"
프로덕션에서는 셸 히스토리 대신 배포 시크릿, 컨테이너 시크릿 또는 관리형 볼트를 사용하세요.

### Step 3: OpenAI 호환 SDK 설치
python -m pip install --upgrade openai
npm install openai
```

### Step 4: cURL로 첫 요청 보내기

```
curl https://api.cometapi.com/v1/chat/completions \
  -H "Authorization: Bearer $COMETAPI_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "glm-5.3-flash",
    "messages": [
      {
        "role": "system",
        "content": "You are a precise technical assistant."
      },
      {
        "role": "user",
        "content": "Explain three practical uses of a one-million-token context window."
      }
    ],
    "max_completion_tokens": 800
  }'
```

성공한 응답에는 choices[0].message.content 아래에 assistant 메시지와, 라우트가 반환하는 경우 사용량 메타데이터가 포함됩니다. 선택적 파라미터를 추가하기 전에 이 작은 요청으로 시작하세요.

### Step 5: Python에서 API 호출

```
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
    timeout=60.0,
    max_retries=2,
)

completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "system",
            "content": "You are a precise technical assistant.",
        },
        {
            "role": "user",
            "content": "Review this migration plan and list the top five risks.",
        },
    ],
    max_completion_tokens=1200,
)

print(completion.choices[0].message.content)
print(completion.usage)
```

### Step 6: JavaScript에서 API 호출

```
import OpenAI from "openai";

const client = new OpenAI({
  apiKey: process.env.COMETAPI_KEY,
  baseURL: "https://api.cometapi.com/v1",
  timeout: 60_000,
  maxRetries: 2,
});

const completion = await client.chat.completions.create({
  model: "glm-5.3-flash",
  messages: [
    { role: "system", content: "You are a precise technical assistant." },
    { role: "user", content: "Draft a safe rollout checklist for this API." },
  ],
  max_completion_tokens: 1200,
});

console.log(completion.choices[0].message.content);
console.log(completion.usage);
```

## 추론 노력 수준 제어 방법

[공식 모델 문서](https://docs.z.ai/guides/vlm/glm-5.3-flash)는 [low, high, max 추론 노력](https://docs.z.ai/guides/vlm/glm-5.3-flash)을 지원합니다. [Thinking은 항상 활성화](https://docs.z.ai/guides/vlm/glm-5.3-flash)되어 있으며, 노력 설정은 모델이 사용할 수 있는 추론 예산을 변경합니다.

| Effort | Good starting workloads                 | Trade-off                                       |
| ------ | --------------------------------------- | ----------------------------------------------- |
| low    | 분류, 리라이팅, 짧은 추출                | 더 낮은 지연과 출력 토큰 사용; 깊이는 낮음.      |
| high   | 코드 리뷰, 계획 수립, 문서 분석          | 다수 프로덕션 작업에 균형 잡힌 기본값.           |
| max    | 복잡한 디버깅, 도구 에이전트, 어려운 추론 | 가장 높은 깊이; 지연과 비용이 증가할 수 있음.    |

```
completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "user",
            "content": "Find hidden failure modes in this distributed rollout plan.",
        }
    ],
    max_completion_tokens=1800,
    extra_body={"reasoning_effort": "high"},
)

print(completion.choices[0].message.content)
```

설치된 SDK가 reasoning_effort를 1급 인자로 노출한다면 직접 전달할 수 있습니다. CometAPI 라우트가 공급자 고유 필드를 거부한다면 해당 필드를 제거하고 라우트 기본값을 사용하세요. Thinking을 비활성화하려고 시도하지 마세요.

## 응답 스트리밍 방법

스트리밍은 출력이 도착하는 대로 인터페이스에 표시할 수 있어 챗, 코딩 어시스턴트, 긴 분석에 유용합니다. 총 생성 토큰 수를 줄이지는 않으므로 동일한 출력 상한과 비용 제어를 유지하세요.

### Python 스트리밍

**Python**

```
stream = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {"role": "user", "content": "Create a staged database migration plan."}
    ],
    max_completion_tokens:1600,
    stream=True,
)

for chunk in stream:
    delta = chunk.choices[0].delta
    if delta.content:
        print(delta.content, end="", flush=True)
print()
```

### JavaScript 스트리밍

**JavaScript**

```
const stream = await client.chat.completions.create({
  model: "glm-5.3-flash",
  messages: [
    { role: "user", content: "Create a staged database migration plan." },
  ],
  max_completion_tokens: 1600,
  stream: true,
});

for await (const chunk of stream) {
  const text = chunk.choices[0]?.delta?.content ?? "";
  process.stdout.write(text);
}
```

• 취소 처리. 클라이언트 연결이 끊기면 스트림 읽기를 중지하고, 지원되는 경우 업스트림 작업을 취소하세요.

• 안전한 버퍼링. 각 청크에 전체 단어, JSON 토큰 또는 도구 호출 객체가 포함된다고 가정하지 마세요.

• 최종 사용량 기록. 사용량은 마지막 이벤트나 라우트별 메타데이터에만 나타날 수 있습니다.

## 이미지 전송 방법

[GLM-5.3 Flash](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/)는 messages[].content[]의 image_url 블록을 통해 시각 콘텐츠를 수신합니다. 공식 문서는 도달 가능한 이미지 URL 또는 Base64 Data URL을 권장합니다. CometAPI의 모델 페이지는 이미지-텍스트 기능을 식별하지만, 프로덕션 전 형식, 파일 크기, 라우트 동작을 테스트해야 합니다.

### 이미지 URL 분석

**Python**

```
completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "image_url",
                    "image_url": {
                        "url": "https://example.com/dashboard.png"
                    },
                },
                {
                    "type": "text",
                    "text": (
                        "Review this dashboard. Identify usability issues, "
                        "ambiguous metrics, and possible data-quality risks."
                    ),
                },
            ],
        }
    ],
    max_completion_tokens=1500,
)

print(completion.choices[0].message.content)
```

### 로컬 이미지를 Base64로 전송

**Python**

```
import base64
import mimetypes
from pathlib import Path

image_path = Path("dashboard.png")
mime_type = mimetypes.guess_type(image_path.name)[0] or "image/png"
encoded = base64.b64encode(image_path.read_bytes()).decode("utf-8")

completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "image_url",
                    "image_url": {
                        "url": f"data:{mime_type};base64,{encoded}"
                    },
                },
                {
                    "type": "text",
                    "text": "Extract the chart title, axes, and main trend.",
                },
            ],
        }
    ],
    max_completion_tokens=1000,
)

print(completion.choices[0].message.content)
```

• 인코딩 전, 관련 없는 여백을 자르세요.

• 확인하려는 정보보다 훨씬 큰 이미지는 다운스케일하세요.

• 일반적인 설명 대신 구체적인 시각 질문을 하세요.

• 공개 웹페이지 URL이 직접 이미지 URL이라고 가정하지 마세요.

• 다중 이미지 순서를 테스트하세요. 각 이미지는 프롬프트에서 명확히 참조되어야 합니다.

## 구조화된 JSON 요청 방법

다음 컴포넌트가 사람보다 코드인 경우 구조화된 출력이 유용합니다. 좁은 스키마를 사용하고 결과를 검증하며, 엄격한 JSON Schema가 동일한 형태로 노출되지 않는 라우트를 위한 폴백을 유지하세요.

**Python**

```
import json

completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "system",
            "content": "Return valid JSON only.",
        },
        {
            "role": "user",
            "content": (
                "Extract equipment, severity, observed symptom, and next action "
                "from this report: Feeder 12 showed repeated zero-sequence current "
                "spikes after rain; inspect insulation and compare adjacent sections."
            ),
        },
    ],
    response_format={"type": "json_object"},
    max_completion_tokens=800,
)

data = json.loads(completion.choices[0].message.content)
required = {"equipment", "severity", "symptom", "next_action"}
missing = required.difference(data)
if missing:
    raise ValueError(f"Missing fields: {sorted(missing)}")

print(data)
```

JSON 모드가 검증 필요성을 제거하지는 않습니다. 필수 필드, 타입, 허용 값, 최대 길이를 확인한 뒤에만 결과를 저장하거나 다른 시스템을 트리거하세요.

## 함수 호출(Function Calling) 사용 방법

함수 호출은 모델이 외부 데이터가 필요할 때를 결정하게 하되, 권한 부여와 실행 책임은 애플리케이션 코드에 남깁니다. 안전한 패턴은 다음과 같습니다: 모델이 도구 호출을 제안 → 서버가 이를 검증 → 서버가 도구를 실행 → 모델이 결과를 수신.

**Python**

```
import json

completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "system",
            "content": "Return valid JSON only.",
        },
        {
            "role": "user",
            "content": (
                "Extract equipment, severity, observed symptom, and next action "
                "from this report: Feeder 12 showed repeated zero-sequence current "
                "spikes after rain; inspect insulation and compare adjacent sections."
            ),
        },
    ],
    response_format={"type": "json_object"},
    max_completion_tokens=800,
)

data = json.loads(completion.choices[0].message.content)
required = {"equipment", "severity", "symptom", "next_action"}
missing = required.difference(data)
if missing:
    raise ValueError(f"Missing fields: {sorted(missing)}")

print(data)
```

• 인수 검증. 도구 호출 JSON을 신뢰할 수 없는 입력으로 취급하세요.

• 권한 부여 강제. 현재 사용자가 수행할 수 있는 작업은 모델이 결정하지 않습니다.

• 읽기와 쓰기 도구 분리. 파괴적이거나 외부에 영향을 미치는 작업에는 확인을 요구하세요.

• 도구 인벤토리 제한. 현재 워크플로우와 관련된 도구만 노출하세요.

• 루프 상한. 최대 도구 라운드, 총 토큰, 경과 시간, 비용을 제한하세요.

## [GLM-5.3 Flash](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/) API 파라미터

| Parameter               | Purpose                         | Practical guidance                                      |
| ----------------------- | ------------------------------ | ------------------------------------------------------- |
| model                   | 모델 라우트 선택                | glm-5.3-flash를 사용하세요.                             |
| messages                | 대화 및 멀티모달 입력           | role 순서를 유효하게 유지하고, 필요한 도구 메시지를 보존하세요. |
| max\_completion\_tokens | 생성 출력 상한                  | 모델 최대치에 의존하지 말고 워크플로우별로 설정하세요.  |
| temperature             | 샘플링 동작                     | 공식 권장값은 1입니다.                                  |
| top\_p                  | 누클리어스 샘플링               | 공식 권장값은 0.95입니다.                               |
| reasoning\_effort       | 추론 예산                       | low, high, max를 사용하세요. 라우트 지원 여부를 테스트하세요. |
| stream                  | 점진적 출력                     | 대화형 응답에 true를 사용하세요.                        |
| tools                   | 함수 정의                       | 스키마를 좁게 유지하고 모든 호출을 검증하세요.          |
| tool\_choice            | 도구 선택 제어                  | 워크플로우에 필수 도구가 없다면 auto로 시작하세요.       |
| response\_format        | 머신 판독 가능한 출력 요청      | 지원 여부와 반환된 JSON을 검증하세요.                   |

## Z.ai 직접 API vs CometAPI

두 라우트 모두 적합할 수 있습니다. 결정은 주로 통합 소유권, 모델 범위, 과금, 그리고 애플리케이션이 공급자 네이티브 기능을 얼마나 빨리 필요로 하는지에 달려 있습니다.

| Dimension       | Z.ai Direct API                               | CometAPI                                           | Practical result                                                |
| --------------- | --------------------------------------------- | -------------------------------------------------- | --------------------------------------------------------------- |
| Account and key | Z.ai 계정과 키                                | CometAPI 계정과 키                                 | 키는 상호 호환되지 않습니다.                                   |
| SDK pattern     | OpenAI 호환                                    | OpenAI 호환                                        | 많은 클라이언트 코드를 재사용할 수 있습니다.                    |
| Model coverage  | Z.ai 모델 제품군                               | 다수 공급자와 모델 제품군                          | CometAPI는 라우팅과 비교에 유용합니다.                          |
| Native features | 공급자 고유 동작을 가장 빠르게 이용           | 게이트웨이 노출 및 패스스루에 따라 달라짐          | 선택한 라우트에서 고급 필드를 테스트하세요.                     |
| Billing         | 공급자별                                      | 지원 모델 전반의 중앙화                            | 통합 과금은 다중 모델 운영을 단순화할 수 있습니다.              |
| Fallback design | 다른 공급자 통합이 필요                       | 하나의 게이트웨이 계층 내 유지 가능                | CometAPI는 전환 마찰을 줄일 수 있습니다.                        |
| Best fit        | Z.ai 네이티브 기능에 깊이 의존할 때            | 통합 접근, 평가, 프로덕션 라우팅이 필요할 때        | 일반적 우승자보다 시스템 아키텍처에 따라 선택하세요.            |

최신 공급자 네이티브 파라미터나 제품 기능이 필수라면 직접 API를 사용하세요. 하나의 클라이언트, 통합 과금, 모델 비교/교체가 더 중요하다면 CometAPI를 사용하세요. 프로덕션에서는 배포 예정 라우트에 대해 동일한 대표 테스트 스위트를 실행하세요.

## 비용 추정과 토큰 예산

현재 [CometAPI 모델 페이지](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/)에는 [백만 입력 토큰당 $0.06](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/), [백만 출력 토큰당 $0.20](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/)가 표시됩니다. 이 요율에서 요청 비용 추정은 다음과 같습니다:

cost = input_tokens / 1,000,000 x 0.06 + output_tokens / 1,000,000 x 0.20

| Workload                | Input tokens | Output tokens | Estimated cost |
| ----------------------- | ------------ | ------------- | -------------- |
| Short question          | 2,000        | 400           | $0.00020       |
| Code review             | 50,000       | 4,000         | $0.00380       |
| Large document analysis | 250,000      | 10,000        | $0.01700       |
| Long agent run          | 800,000      | 30,000        | $0.05400       |

가격은 시기별로 변합니다. 게시 또는 프로덕션 예산 책정 전에 라이브 입력, 캐시된 입력, 출력 요율을 확인하세요. 추론과 도구 루프는 청구되는 출력과 반복 입력을 증가시킬 수 있으므로, 하나의 보이는 답변이 아니라 전체 워크플로우를 기준으로 추정하세요.

## GLM-5.3 Flash API 프로덕션 모범 사례

### 비용과 지연 제어

#### 출력 상한

벤치마크 생성 설정과 프로덕션 API 제한은 다릅니다. 인용된 HLE 평가는 최대 163,840 토큰 생성 길이를 사용했고, 일부 평가는 64K 출력을 사용했습니다. 이들 설정이 모든 호스팅 API 라우트가 100,000+ 토큰을 반환할 수 있음을 증명하지는 않습니다. 라이브 라우트 스키마와 워크플로우 예산에서 상한을 설정하세요. 분류/추출에는 작은 상한, 분석에는 중간 상한, 장문 또는 에이전트 작업에만 큰 상한을 사용하세요.

**컨텍스트 제어**

100만 토큰 윈도는 용량이지 목표가 아닙니다. 관련 파일만 검색하고, 중복 로그를 제거하며, 안정적 지침을 앞부분에 배치하고, 추가 컨텍스트가 작업 성공에 기여하는지 측정하세요.

### 상태와 신뢰성

#### 상태 보존

다음 턴에 필요한 도구 호출과 라우트별 필드를 포함한 assistant 메시지를 완전하게 저장하세요. 구조화된 히스토리를 누락하면, 가시 텍스트가 완전해 보이더라도 다단계 도구 루프가 중단될 수 있습니다.

#### 선택적 재시도

• 429, 500, 502, 503, 네트워크 타임아웃 같은 일시적 오류는 지수 백오프와 지터로 재시도하세요.

• 인증 오류, 잘못된 파라미터, 과대 요청은 무분별하게 재시도하지 마세요.

• 애플리케이션 요청 ID를 부여해 중복 작업을 식별할 수 있게 하세요.

• 모델 요청 자체를 재시도하더라도 외부 쓰기 작업에는 멱등성 제어를 사용하세요.

### 안전성과 검증

#### 머신 판독 출력 검증

스키마 검증, 허용 값 검사, 길이 제한, 도메인 규칙을 모델과 모든 데이터베이스/큐/외부 API 사이에 배치하세요. 문법적으로 유효한 JSON 객체도 불완전하거나 안전하지 않을 수 있습니다.

#### 도구 호출 권한 부여

모델이 제안한 도구 호출을 신뢰할 수 없는 요청으로 취급하세요. 인수 검증, 사용자 권한 강제, 읽기/쓰기 도구 분리, 파괴적 행동에 대한 확인 요구를 적용하세요.

### 가시성과 폴백

#### 워크플로우 측정

• 작업 성공 또는 휴먼 수용률

• 최초 토큰까지 시간과 총 지연

• 입력, 캐시된 입력, 추론, 출력 토큰

• 도구 호출 수와 도구 실패율

• 재시도, 레이트 리밋, 공급자 오류

• 개별 호출당 비용이 아니라 완료된 작업당 비용

#### 폴백 설계

소문이 아니라 워크로드에 따라 폴백을 선택하세요. 문서 추출에는 텍스트 전용 폴백이 허용될 수 있지만, 스크린샷 기반 작업에서는 실패할 수 있습니다. 어떤 입력과 도구 스키마가 이식 가능한지, 제거해야 할 파라미터는 무엇인지, 자동 모델 전환 대신 사용자에게 복구 가능한 오류를 보여줘야 할 때를 정의하세요.

## 일반 오류와 트러블슈팅

| Symptom                 | Likely cause                                                       | What to check                                                                  |
| ----------------------- | ------------------------------------------------------------------ | ------------------------------------------------------------------------------ |
| 401 Unauthorized        | 키 누락, 형식 오류, 키 폐기                                       | Authorization 헤더와 서버 측 환경 변수를 확인하세요.                            |
| 404 or model not found  | 잘못된 모델 ID 또는 사용 불가 라우트                               | glm-5.3-flash를 사용하고 라이브 모델 페이지에서 가용성을 확인하세요.            |
| 429 Rate Limit          | 요청 또는 토큰 할당량 초과                                         | 백오프하고 동시성을 줄이며 계정 한도를 점검하고 지터와 함께 재시도하세요.       |
| Unsupported parameter   | 게이트웨이가 노출하지 않는 공급자 고유 필드                       | 선택적 필드를 제거한 뒤 하나씩 다시 추가하세요.                                 |
| Context length exceeded | 프롬프트와 요청된 출력이 라우트 한도를 초과                       | 트리밍, 검색, 요약하거나 max_completion_tokens를 낮추세요.                      |
| Invalid image           | URL 접근 불가, 형식 미지원, Base64 손상                            | 직접 HTTPS 이미지 URL을 테스트하고 MIME 접두사를 수정하세요.                    |
| Broken streamed JSON    | 청크를 완전한 객체로 파싱함                                        | 스트림을 버퍼링하고 전체 JSON 페이로드가 도착한 후에만 파싱하세요.              |
| Tool loop never ends    | 단계 예산 없음 또는 모호한 도구 결과                               | 라운드 상한을 설정하고 도구 설명을 개선하며 명시적 도구 오류를 반환하세요.      |

## 언제 GLM-5.3 Flash API를 써야 할까요?

### 적합한 경우

• 리포지토리 규모 코드 이해와 다파일 리뷰

• 비주얼 코딩, 스크린샷 분석, 인터페이스 QA

• 장문 문서 묶음과 증거 기반 종합

• 반복적 계획과 검증을 수행하는 도구 기반 에이전트

• 토큰 비용이 단위 경제성에 중요한 고볼륨 워크플로우

• 하나의 게이트웨이를 통한 모델 전환/비교가 유리한 애플리케이션

### 다른 라우트나 모델을 쓸 때

• 텍스트 출력이 아니라 이미지/비디오 출력을 제품이 필요로 할 때

• 작은 모델로 신뢰성 있게 처리할 수 있는 아주 작은, 저위험 분류 작업일 때

• 게이트웨이 라우트에서 노출되지 않는 공급자 네이티브 기능이 필수일 때

• 항상 켜진 추론이나 그에 따른 지연 프로파일을 워크플로우가 허용하지 못할 때

• 모델을 자체 도구, 데이터, 실패 사례로 아직 테스트하지 않았을 때

## FAQ

###

### 출시 전 정확히 어떤 CometAPI 라우트를 검증해야 하나요?

모델 가용성, 허용 멀티모달 형식, 최대 출력, 추론 필드, 구조화 출력 동작, 레이트 리밋, 현재 가격을 대표 요청으로 검증하세요.

### 프로덕션 평가는 어떤 지표를 추적해야 하나요?

작업 성공률, 최초 토큰까지 시간, 총 지연, 입력/출력 토큰, 도구 호출 실패, 재시도율, 워크플로우당 비용(단순 API 호출당 비용만이 아님)을 추적하세요.

### Z.ai 직접과 CometAPI 중 어떻게 선택해야 하나요?

공급자 네이티브 동작에 즉시 접근하는 것이 필수라면 Z.ai 직접을 사용하세요. 통합 인증, 과금, 모델 비교, 게이트웨이 수준 폴백이 더 중요하다면 CometAPI를 사용하세요.

### 안전한 폴백이란 무엇인가요?

동일 입력 모달리티를 수용하고, 필요한 도구 스키마를 보존하며, 미지원 파라미터를 제거하고, 작업의 권한 경계를 유지하며, 동작을 보존할 수 없을 때는 자동 전환 대신 명시적으로 실패를 보여주는 폴백입니다.

## 결론

[GLM-5.3 Flash](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/)는 긴 컨텍스트, 시각 입력, 추론, 도구 사용이 하나의 워크플로우에 결합될 때 API로 가장 유용합니다. 기본 CometAPI 통합은 작습니다: 하나의 서버 측 키, 하나의 OpenAI 호환 클라이언트, [glm-5.3-flash](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/) 모델 ID, chat-completions 엔드포인트. 프로덕션 품질은 그 요청 주변에서 결정됩니다: 범위가 명확한 프롬프트, 출력 상한, 스키마 검증, 도구 권한 부여, 재시도, 가시성, 워크로드별 평가.

짧은 텍스트 호출로 시작하고, 고급 기능을 한 번에 하나씩 추가하며, 확장 전에 전체 사용자 여정을 테스트하세요. 현재 가용성, 지원 라우트 동작, 가격은 라이브 [GLM-5.3 Flash 모델 페이지](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/)에서 확인하세요.

## SEO Metadata

**Meta title:** GLM-5.3 Flash API 사용 방법: 개발자 가이드

**Meta description:** CometAPI로 GLM-5.3 Flash API를 사용하는 방법을 알아보세요. Python/JavaScript 예제, 비전, 스트리밍, 도구, JSON 출력, 모범 사례를 포함합니다.

**Keywords:** GLM-5.3 Flash API, GLM-5.3 Flash 사용 방법, GLM-5.3 Flash Python, GLM-5.3 Flash JavaScript, GLM-5.3 Flash CometAPI, GLM API 튜토리얼, 멀티모달 API, 추론 API, 함수 호출

**URL slug:** how-to-use-glm-5-3-flash-api