

TL;DR
MiMo-V2.5는 멀티모달 작업, 일상형 에이전트, 비용 민감한 프로덕션에서 더 강력한 기본 선택입니다. MiMo-V2.5-Pro는 어려운 추론, 리포지토리 규모 코딩, 장시간 도구 사용에 특화된 옵션입니다. 두 모델 모두 1M 토큰 컨텍스트 윈도우와 최대 128K 출력 토큰을 제공하지만, Pro는 훨씬 더 큰 언어 백본을 사용하며 일반 입력/출력 토큰 비용이 약 3.1배입니다.
MiMo-V2.5 vs. Pro: Quick Decision
| Specification — official release | MiMo-V2.5 | MiMo-V2.5-Pro | Recommended model | Reason |
|---|---|---|---|---|
| Primary positioning | 옴니모달 모델 및 효율적인 에이전트 | 플래그십 에이전트 및 복잡한 코딩 | 워크로드에 따라 선택 | 옴니모달 입력은 V2.5에 유리하며, 지속적인 고난도 텍스트 작업은 Pro에 유리합니다. |
| Architecture | 스파스 MoE | 스파스 MoE | 워크로드에 따라 선택 | 모델 크기만으로 모든 작업에 더 나은 선택이 되는 것은 아닙니다. |
| Total parameters | 310B | 1.02T | 워크로드에 따라 선택 | 더 큰 모델은 어려운 추론을 겨냥하지만, 총 크기가 곧바로 성과를 보장하지는 않습니다. |
| Activated parameters | 15B | 42B | 워크로드에 따라 선택 | 작업 완성과 비용을 기준으로 결정하세요. |
| LLM layers | 48 | 70 | 워크로드에 따라 선택 | 레이어 수는 아키텍처 설명일 뿐, 보편적 우위를 의미하지 않습니다. |
| Routed experts | 256 | 384 | 워크로드에 따라 선택 | 차이는 목표 워크로드에서 실제 개선이 있을 때만 의미가 있습니다. |
| Experts activated per token | 8 | 8 | Either | 두 모델 모두 토큰당 8명의 전문가를 활성화합니다. |
| Context window | 1M tokens | 1M tokens | Either | 둘 다 1M 토큰 윈도우를 광고합니다; 실제 검색 성능을 테스트하세요. |
| Maximum output | 128K tokens | 128K tokens | Either | 둘 다 최대 128K 출력 토큰을 광고합니다. |
| Input modalities | 텍스트, 이미지, 비디오, 오디오 | 텍스트 | MiMo-V2.5 | 이미지, 비디오, 오디오 입력을 수용하며, Pro는 텍스트 입력에 초점을 맞춥니다. |
| Tool calling | Yes | Yes | 워크로드에 따라 선택 | 둘 다 도구를 호출합니다; 실제 경로에서의 성공률을 테스트하세요. |
| Open weights and license | Yes; MIT | Yes; MIT | Either | 둘 다 MIT 하에 오픈 웨이트를 제공합니다; 서빙 비용은 다릅니다. |
The Decisive Difference: Multimodal vs Agent-First
V2.5는 기본적으로 텍스트, 이미지, 비디오, 오디오를 입력으로 받습니다. Xiaomi는 언어 백본과 729M-파라미터 비전 인코더, 261M-파라미터 오디오 인코더를 결합하여 멀티모달 정보가 동일한 추론 워크플로에 직접 참여하도록 합니다.
- 툴을 호출하기 전에 스크린샷을 분석합니다.
- 비디오와 그 오디오 트랙을 함께 이해합니다.
- 다이어그램과 문서 이미지에서 정보를 추출합니다.
- 시각적 인터페이스와 멀티모달 지원 에이전트를 운용합니다.
- 긴 비디오 시퀀스를 대상으로 추론합니다.
V2.5-Pro는 다른 설계를 따릅니다. Xiaomi는 현재 입력 모달리티로 텍스트를 명시하고, 심층 추론, 코드 개발, 장시간 도구 오케스트레이션을 강조합니다.
워크플로 자체에 이미지, 비디오, 오디오 입력이 포함되면 V2.5부터 시작하세요. 어려운 부분이 텍스트, 소스 코드, 도구, 긴 에이전트 경로에서의 추론이라면 Pro를 테스트하세요.

Xiaomi 공식 멀티모달 벤치마크 비교.
Why V2.5-Pro Can Be Better on Hard Tasks
Model Scale: 310B/15B vs. 1.02T/42B
두 모델 모두 스파스 전문가 혼합(MoE) 백본, 하이브리드 슬라이딩-윈도우 및 글로벌 어텐션, 3개의 다중 토큰 예측(Multi-Token Prediction) 모듈을 사용합니다. Xiaomi의 V2.5 모델 카드는 총 310B, 활성 15B 백본을 문서화하며; Pro 모델 카드는 총 파라미터를 1.02T, 토큰당 활성 파라미터를 42B로 확장합니다.
| Architecture — official model card | V2.5 | Pro | Difference |
|---|---|---|---|
| Total parameters | 310B | 1.02T | 약 3.3× |
| Active parameters | 15B | 42B | 2.8× |
| Hidden size | 4,096 | 6,144 | 1.5× |
| LLM layers | 48 | 70 | 22 더 많음 |
| Attention heads | 64 | 128 | 2× |
| Routed experts | 256 | 384 | 1.5× |
| Experts per token | 8 | 8 | 동일 |
| MTP layers | 3 | 3 | 동일 |
V2.5는 5:1 어텐션 패턴을 사용하고, Pro는 로컬:글로벌 6:1 패턴으로 이동합니다. Xiaomi에 따르면 이러한 설계는 네트워크 전반의 풀 어텐션 대비 각각 약 6×, 7× 수준으로 KV 캐시 요구량을 줄입니다.
총 파라미터 수가 응답 품질로 선형적으로 이어지지는 않습니다. Pro의 더 큰 백본은 per-step 신뢰성의 작은 개선이 누적되는 어려운 추론이나 긴 경로에서 가장 큰 의미를 갖습니다.
Why Small Reliability Gains Compound
긴 에이전트 작업은 많은 종속 단계로 구성됩니다. 초기 도구 호출의 오류는 재시도를 유발하거나 이후 작업을 무효화할 수 있으므로, 단계별 신뢰성의 작은 향상이 전체 완수에 더 큰 영향을 미칠 수 있습니다. 모델 크기가 이를 보장한다고 가정하기보다는 대표 작업에서 그 효과를 평가하세요.
Where Does V2.5-Pro Actually Improve?
가장 깔끔한 수치 비교는 동일한 설정에서 두 모델을 비교한 Xiaomi의 베이스 모델 평가입니다. 이는 상이한 하네스나 사후 학습 설정에서 나온 결과를 섞는 일을 피하게 해줍니다.
General Knowledge: Small to Moderate Gains
베이스 모델 비교에서 Pro는 BBH에서 1.2점, MMLU에서 3.1점, MMLU-Pro에서 2.7점을 높였습니다. 이는 측정 가능한 차이지만, 더 어려운 추론 과제에서의 향상보다 작습니다.
Mathematics and Science: Larger Gains
동일한 베이스 모델 평가에서 Pro는 GPQA-Diamond에서 8.6점, GSM8K에서 16.3점, MATH에서 18.5점을 높였습니다. 어려운 추론이 성공을 좌우할 때 Pro를 선택해야 하는 가장 명확한 근거입니다.
Coding: Better, but Not Uniformly Better
보고된 향상은 HumanEval+에서 4.3점, MBPP+에서 3.2점, LiveCodeBench v6에서 4.1점, SWE-Bench AgentLess에서 4.9점입니다. 리포지토리 수준 작업과 도구 사용은 별도로 테스트하세요: 이러한 베이스 모델 점수는 모든 프로덕션 에이전트 워크플로를 측정하지 않습니다.
벤치마크 결과: Pro는 비용이 약 세 배이기 때문에 세 배 더 뛰어난 것이 아닙니다. 추론 난이도와 작업 지속 시간이 증가할수록 가치가 점진적으로 높아집니다.
위 표는 베이스 모델 평가이며, 프로덕션 API가 동일한 점수를 재현한다는 보장이 아닙니다. 에이전트 결과는 도구, 프롬프트, 재시도, 실행 환경, 토큰 예산에 좌우됩니다.
Post-Training and Long-Horizon Agents
프로덕션 모델에는 지도 미세조정, 에이전트 강화학습, 다중 교사 온-폴리시 증류가 추가됩니다. Xiaomi는 V2.5의 사후 학습 점수로 SWE-bench Pro 56.1, Terminal-Bench 2.0 65.8, Claw-Eval 일반 파트 Pass³ 62.1을 보고합니다.
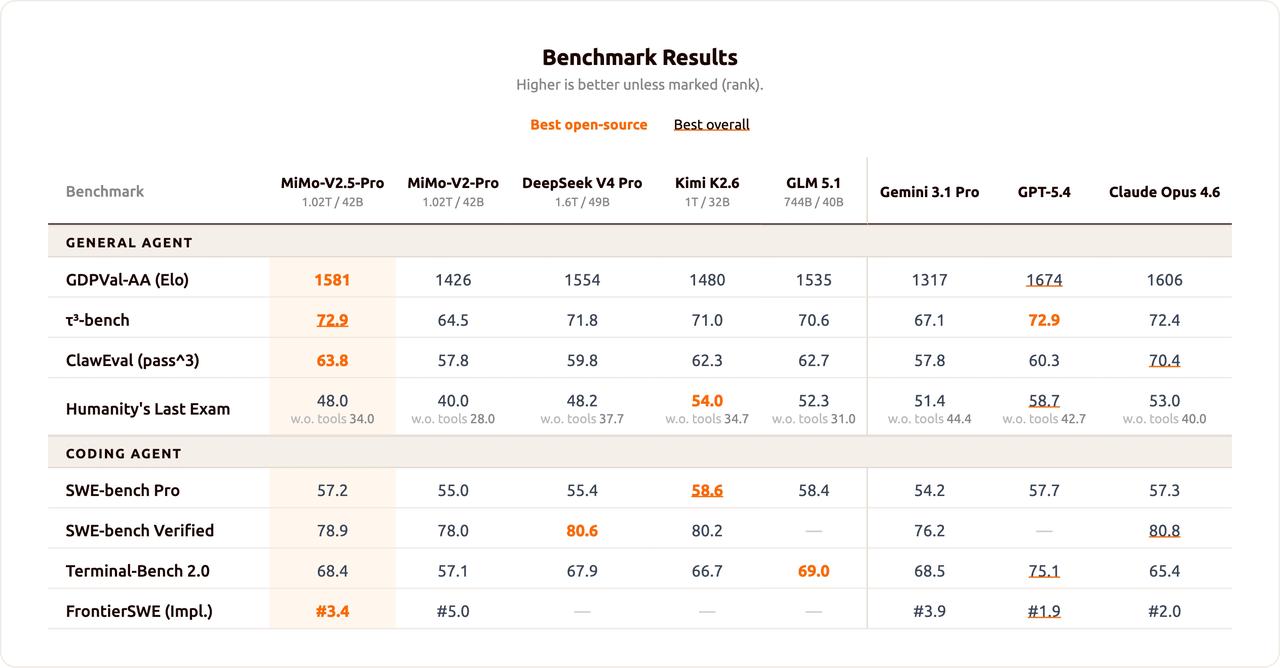
Pro는 장기 지평 소프트웨어 엔지니어링에 더 명시적으로 최적화되었습니다. Xiaomi는 수백 번의 도구 호출이 포함된 지속 경로를 강조하고, 78.9% SWE-bench Verified 결과를 공개합니다.
한 공식 사례 연구는 Pro가 4.3시간 동안 672회의 도구 호출로 SysY 컴파일러를 완성하고 233개 테스트를 모두 통과한 것을 보여줍니다. 교훈은 모든 코딩 요청에 Pro가 필요하다는 뜻이 아니라, 작은 신뢰성 차이가 수백 개의 종속 작업을 가진 워크플로의 완성 여부를 좌우할 수 있다는 점입니다.

Xiaomi 공식 코딩 및 에이전트 벤치마크 도표.
Long Context: Same Capacity, Different Workloads
두 모델 모두 Xiaomi의 현재 API를 통해 1M-토큰 컨텍스트 윈도우와 최대 128K 출력 토큰을 제공합니다. 따라서 원시 컨텍스트 크기만으로는 둘을 구분하기 어렵습니다.
긴 컨텍스트에 비디오, 문서 이미지, 시각적 에이전트 흔적 등 멀티모달 자료가 포함된다면 V2.5가 매력적입니다. 컨텍스트 자체가 문제인 경우—대형 리포지토리, 긴 계약서, 연구 코퍼스, 다수의 순차적 작업을 포함하는 에이전트 경로—에는 Pro를 테스트하는 것이 적합합니다.
큰 컨텍스트 윈도우는 용량을 의미할 뿐, 보장된 추론 충실도를 뜻하지 않습니다. 애플리케이션에 중요한 길이에서 검색, 지침 유지, 증거 활용을 평가하세요.
Price and Cost Efficiency
Xiaomi의 해외 사용량 기반 결제 가격이 트레이드오프를 분명히 보여줍니다.
| Pricing — official price sheet | V2.5 | Pro | Ratio |
|---|---|---|---|
| Uncached input per 1M tokens | $0.14 | $0.435 | 3.11× |
| Cached input per 1M tokens | $0.0028 | $0.0036 | 1.29× |
| Output per 1M tokens | $0.28 | $0.87 | 3.11× |
| Context window | 1M | 1M | Same |
| Maximum output | 128K | 128K | Same |
1M 비캐시 입력 토큰과 200K 출력 토큰을 가진 요청은 캐시 히트, 웹 검색 비용, 공급자별 과금 전 기준으로 V2.5에서 약 $0.196, Pro에서 약 $0.609로 추정됩니다.
캐시 가격 차이는 더 작습니다: 캐시 히트 입력의 경우 Pro가 약 29% 더 비쌉니다(표준 입력/출력 대비 211%가 아님). 시스템 프롬프트, 도구 정의, 리포지토리 프리픽스가 안정된 장시간 에이전트라면 실제 캐시 히트율을 측정하세요.
성공적인 작업당 비용을 추정하세요. 어려운 워크플로를 한 번에 완료하는 Pro 에이전트가, 더 저렴한 모델에서 반복 실패하는 것보다 비용이 적을 수 있습니다.
Which Model Should You Use?
| Workload — official guidance | Better choice | Why |
|---|---|---|
| Routine text chat | V2.5 | 낮은 비용; Pro가 불필요한 경우가 많음 |
| High-volume generation | V2.5 | 표준 토큰 가격이 약 3.1× 낮음 |
| Image, video, or audio understanding | V2.5 | 네이티브 멀티모달 입력 지원 |
| Routine tool calling | V2.5 | 낮은 비용으로 강력한 에이전트 능력 |
| Difficult mathematics and science | Pro | 더 큰 벤치마크 향상 |
| Repository-scale coding | Pro | 복잡한 소프트웨어 엔지니어링에 설계됨 |
| Hundreds of dependent tool calls | Pro | 지속 실행에 더 적합 |
| Cost-sensitive 1M context | V2.5 | 동일한 명목 컨텍스트를 훨씬 낮은 비용으로 |
선택 결과: V2.5는 멀티모달 애플리케이션, 일상형 에이전트, 비용 민감한 워크로드의 기본값입니다. Pro는 어려운 추론, 복잡한 소프트웨어 엔지니어링, 장시간 자율 경로에 대한 업그레이드입니다.
A Better Production Strategy: Route Between Both
글로벌 단일 모델 선택은 종종 불필요합니다. 멀티모달 및 일상형 요청은 V2.5로 라우팅하고, 어려운 텍스트 추론, 복잡한 코딩, 장기 실행만 Pro로 승격하세요.
| Evaluation dimension | Measure | Why it matters | Routing signal |
|---|---|---|---|
| Completion | Successful tasks / attempts | 엔드투엔드 신뢰성 포착 | 완수율이 낮은 클래스는 승격 |
| Quality | Human or rubric score | 토큰 비용이 지배하지 않도록 보장 | 고위험 작업은 승격 |
| Tool reliability | Errors and retries | 작은 오류가 에이전트에서 누적 | 긴 경로는 승격 |
| Latency | Time to accepted result | 재시도 오버헤드 포함 | 상호작용 작업은 경량 유지 |
| Cost | Spend per accepted task | 실패와 재실행을 반영 | 성공하는 가장 저렴한 모델 사용 |
Test Both APIs in CometAPI
MiMo-V2.5 API in CometAPI와 MiMo-V2.5-Pro API in CometAPI는 하나의 집계 레이어를 통해 나란히 평가를 지원합니다. 동일한 프롬프트, 시스템 지침, 도구, 출력 한도를 두 모델 모두에 전송한 뒤, 작업 성공과 비용을 비교하세요.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

models = ["mimo-v2.5", "mimo-v2.5-pro"]
prompt = """
이 구현 계획을 검토하세요.
숨은 기술적 위험을 식별하고 우선순위가 가장 높은 수정안 세 가지를 제안하세요.
"""

for model in models:
    response = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        max_tokens=2000,
    )
    print(f"\n--- {model} ---")
    print(response.choices[0].message.content)
간단한 요청, 어려운 추론, 코드 편집, 긴 컨텍스트 작업, 에이전트 도구 호출이 포함된 대표 배치를 실행하세요. 완수율, 토큰, 지연 시간, 도구 오류, 재시도, 답변 품질, 성공적인 작업당 비용을 기록하세요.
Limitations
V2.5 limitations
더 작은 언어 백본은 추론 난이도가 상승할수록 성능을 남겨둘 수 있습니다. BBH에서는 격차가 작지만, GPQA-Diamond와 MATH에서는 훨씬 커집니다. 1M-토큰 컨텍스트 윈도우도 1M-토큰 추론 충실도를 보장하는 것은 아닙니다.
Pro limitations
Pro의 일반 입력/출력 가격은 V2.5 대비 약 3.1배이며, 텍스트 전용 입력으로 멀티모달 애플리케이션의 드롭인 대체로는 부적합합니다. 또한 1.02T-파라미터 오픈 웨이트 모델은 토큰당 42B가 활성화된다고 해도 자체 호스팅에 높은 요구사항을 갖습니다.
Final Verdict
멀티모달 애플리케이션, 일상형 에이전트, 비용 민감한 프로덕션에는 V2.5를 선택하세요. 어려운 추론, 복잡한 소프트웨어 엔지니어링, 장시간 자율 에이전트에는 Pro를 선택하세요. 혼합 워크로드의 경우 대부분은 V2.5로 처리하고, 난이도나 경로 길이가 추가 비용을 정당화할 때만 Pro로 승격하세요.
FAQ
Pro가 항상 V2.5보다 좋은가요?
아니요. Pro는 어려운 텍스트 추론과 코딩에서 강하지만, V2.5는 이미지·비디오·오디오 입력을 지원하고 비용이 상당히 낮습니다.
두 모델 모두 1M-토큰 컨텍스트 윈도우를 지원하나요?
예. 둘 다 1M 토큰의 컨텍스트와 최대 128K 출력 토큰을 광고합니다. 애플리케이션은 실제 운영 길이에서 검색과 추론을 테스트해야 합니다.
멀티모달 에이전트는 어떤 모델을 사용해야 하나요?
V2.5부터 시작하세요. 이 모델은 시각 및 오디오 입력을 네이티브로 수용합니다. Pro는 현재 텍스트 입력 워크플로를 목표로 합니다.
Pro는 언제 더 높은 비용을 감수할 가치가 있나요?
더 나은 추론 신뢰성이 어려운 수학, 리포지토리 규모 코딩, 많은 종속 도구 호출이 포함된 긴 경로의 완수에 영향을 줄 때 가장 타당합니다.
프로덕션 시스템은 한 가지 모델만 사용해야 하나요?
반드시 그럴 필요는 없습니다. 라우팅 레이어를 통해 멀티모달 및 일상형 작업은 V2.5에 두고, 어려운 텍스트와 에이전트 작업만 Pro로 승격하세요.