GPT-5.4는 두 가지 주요 변형 — GPT-5.4 Thinking과 GPT-5.4 Pro — 을 갖춘 목표 지향의 “전문 업무” 모델 제품군으로 출시되며, 긴 문맥 문서 작업, 네이티브 컴퓨터 사용(에이전트) 기능, 그리고 사무, 법률 및 금융 워크플로 전반에서의 사실성과 작업 성능 향상에 큰 비중을 둔다. 이번 출시는 GPT-5 라인의 이전 업데이트(특히 GPT-5.3 Instant 및 GPT-5.3-Codex)에 이어 이루어졌으며, 사내 및 공개 벤치마크에서 측정 가능한 개선, 더 깊은 도구 통합(Excel용 ChatGPT 플러그인 포함), 그리고 더 큰 지원 컨텍스트 (최대 1 million 토큰까지 참조)를 제공한다.
OpenAI의 최신 릴리스인 GPT-5.4는 두 가지 주요 변형인 GPT-5.4 Thinking과 GPT-5.4 Pro로 구성된 “professional work” 타깃 모델 패밀리로 출시되었으며, 장문 컨텍스트 문서 작업, 네이티브 컴퓨터 사용(에이전트) 기능, 그리고 오피스·법무·금융 워크플로 전반에서 사실성 및 작업 성능 개선에 큰 비중을 둡니다. 이 릴리스는 GPT-5 라인의 이전 업데이트(특히 GPT-5.3 Instant 및 GPT-5.3-Codex)를 잇는 것으로, 내부 및 공개 벤치마크에서 측정 가능한 개선, 더 깊은 도구 통합(Excel용 ChatGPT 플러그인 포함), 그리고 더 큰 지원 컨텍스트(최대 1 million tokens까지 인용)를 제공합니다.
GPT-5.4 Thinking — 모델의 사고 과정을 더 많이 노출하며 다중 단계 추론과 에이전트 작업에 최적화된 변형(ChatGPT 내 “Thinking” 모드로 제공).
GPT-5.4 Pro — 고처리/우선순위 추론 티어로서, 고처리량 또는 지연 민감 엔터프라이즈 워크로드용(추가 연산을 반영한 더 높은 API 가격).
OpenAI는 GPT-5.4의 네이티브 컴퓨터 사용 기능을 강조합니다 — 프로그램적 마우스/키보드 동작을 통해 소프트웨어를 조작하고 다중 도구 시퀀스를 오케스트레이션할 수 있게 하여, 실제로 작업을 완료하는 에이전트를 구축하는 데 있어 단계적 도약으로 포지셔닝됩니다.
새로운 및 강조된 기능
장문 컨텍스트 지원: GPT-5.4는 매우 큰 컨텍스트를 지원하는 것으로 보고되었으며(ChatGPT 및 Codex 컨텍스트에서 최대 1,000,000 tokens 지원), 세션 동안 방대한 프로젝트, 서적, 코드베이스 또는 데이터셋을 모델의 “메모리”에 유지할 수 있게 합니다. 이는 문서 검토, 법률 계약, 다중 파일 엔지니어링 프로젝트에 혁신적입니다.
네이티브 컴퓨터 사용 / 에이전팅: GPT-5.4는 네이티브 컴퓨터 사용 기능을 갖춘 OpenAI의 첫 범용 모델로 — Playwright 등을 통해 또는 스크린샷 정보에 기반한 마우스/키보드 명령을 발행하여 소프트웨어를 조작할 수 있는 UI 동작 및 코드 시퀀스를 생성합니다. 이 기능은 개발자가 웹과 데스크톱 앱 전반에서 작업을 완료하는 에이전트를 구축하도록 설계되었습니다.
오피스 스킬 개선: 스프레드시트, 프레젠테이션 및 문서에 큰 비중 — 내부 벤치마크에서 스프레드시트 모델링, 프레젠테이션 심미성, 문서 작성 품질에서 큰 향상이 나타났습니다.
사실성 및 환각 감소: OpenAI는 내부적으로 큐레이션된 평가 세트에서 이전 모델 대비 사실 오류 감소를 보고합니다(아래 벤치마크 참조).
GPT-5.2 Thinking 및 GPT-5.3 Codex 같은 이전 모델과 비교할 때, GPT-5.4는 이러한 기능을 통합하여 사용자 개입을 최소화하면서 장시간 작업과 복잡한 워크플로를 처리하도록 설계된 단일 모델로 제공합니다.
GPT-5.4의 주요 기능 및 기술 하이라이트
1) 거대한 컨텍스트 윈도우(최대 1,000,000 tokens)
가장 즉각적으로 눈에 띄는 기능은 API를 통해 최대 1,000,000 tokens의 컨텍스트 윈도우 지원입니다. 이는 단일 모델 세션이 담을 수 있는 범위를 확장합니다: 전체 서적, 긴 코드베이스 또는 다문서 자료집을 여러 호출로 분할하지 않고 담을 수 있습니다. 지식 집약적 엔터프라이즈 워크플로(법률 디스커버리, 연구 종합, 대규모 코드 분석)에서는 백만 토큰 컨텍스트를 유지하는 능력이 엔지니어링 접착(glue)을 줄이고 일관성을 개선합니다.
시사점: 이전에는 오케스트레이션(검색, 분할, 외부 메모리)이 필요했던 워크플로가 이제 모델의 작업 메모리에 더 많은 원시 컨텍스트를 유지할 수 있어 — 파이프라인을 단순화하고 지연/일관성 간 트레이드오프를 낮춥니다.
2. 네이티브 컴퓨터 및 도구 사용
OpenAI는 스프레드시트, 문서 편집기, 코드 실행 환경 등 소프트웨어 도구와 커넥터를 이전 모델보다 더 강건하게 운영하는 능력을 강조합니다. GPT-5.4는 이전의 “도구 사용” 작업을 다음과 같이 확장합니다:
더 나은 도구 선택과 도구 파라미터화.
외부 API 호출 또는 UI 유사 동작을 단계적으로 수행할 때 더 신뢰할 수 있는 시퀀스 계획.
더 스마트한 도구 호출 아키텍처를 통한 에이전트형 워크플로의 토큰 오버헤드 감소.
에이전트 및 개발자 기능:
데스크톱 및 웹 자동화: 스크린샷 정보에 기반한 마우스/키보드 동작 발행을 명시적으로 지원함으로써, GPT-5.4는 실제 소프트웨어 워크플로를 운영하는 에이전트에 임베드될 수 있습니다(예: 양식 채우기, 대시보드 탐색, 다중 단계 절차 실행). OpenAI는 OS 스타일 벤치마크에서 최첨단 결과를 보고합니다.
도구 인터페이스와 가이드 가능성(steerability): GPT-5.4는 개발자 메시지를 통해 더 잘 제어할 수 있고, 외부 도구, 커넥터, API를 언제 어떻게 호출할지 더 잘 결정할 수 있습니다 — 이는 불필요하거나 위험한 행동을 최소화하는 신뢰할 수 있는 다중 도구 에이전트를 구축하는 데 핵심입니다.
실질적 영향: 자동화 작업(예: “이 스프레드시트를 열고, 피벗을 계산하고, 슬라이드 노트를 생성해라”)이 실패/재시도 사이클이 줄고, 인적 감독이 낮아집니다.
3) 다섯 가지 추론 노력 수준, 익스트림 모드
OpenAI는 여러 추론 노력 수준을 제시합니다 — 지연/비용을 더 깊은 내부 체인 오브 쏘트(chain-of-thought) 연산과 교환할 수 있게 해줍니다(비공식적으로 xhigh 또는 extreme reasoning으로 불리기도 하는 모드). 이는 더 많은 내부 숙고가 정답률에 실질적으로 기여하는 문제(복잡한 증명, 긴 코드 변환, 다단계 재무 분석)용으로 의도되었습니다. API 가격 및 과금 로직은 이러한 모드에서 수행되는 추가 모델 작업을 반영합니다.
실질적 영향: 단일 모델이 “모든 것”이 되도록 요구하는 대신, 고객이 자신들의 워크로드에 적합한 트레이드오프를 선택할 수 있습니다.
4) 생산성과 콘텐츠 저작
스프레드시트 모델링: GPT-5.4는 감사, 금융 및 분석 워크플로에서 사용될 가능성이 높은 스프레드시트 작업에서 강력한 개선을 보여줍니다. OpenAI는 GPT-5.4가 내부 “investment banking modeling” 스타일 작업에서 평균 **87.3%**를 기록한 반면 GPT-5.2는 **68.4%**였다고 보고합니다. 이는 수치 모델링과 수식 구성의 작업 수준 정확도에서 극적인 향상입니다.
프레젠테이션 및 시각 출력: 인간 평가자는 GPT-5.2 대비 미적 요소, 다양성, 이미지 생성 통합이 더 뛰어나서 GPT-5.4가 생성한 프레젠테이션을 68.0% 비율로 선호했습니다. 이는 슬라이드 제작에서 콘텐츠와 형식 모두의 개선을 반영합니다.
문서 초안 작성과 장문 작성: GPT-5.4는 확장된 컨텍스트 윈도우와 전용 추론 튜닝 덕분에 큰 컨텍스트를 처리할 때 긴 문서 전반의 일관성 유지, 더 나은 인용 동작, 내부 모순 감소에 최적화되었습니다.
5) 안전, 완화책 및 사이버 고려사항
환각 감소: OpenAI는 사용자들이 사실 오류를 표시한 비식별화된 프롬프트 세트에서, GPT-5.4의 개별 주장이 33% 더 낮은 확률로 거짓이며, 전체 응답이 18% 더 낮은 확률로 오류를 포함한다고 보고합니다(GPT-5.2 대비) — 이는 사실 정확성이 중요한 엔터프라이즈 도입에서 핵심 지표입니다.
사이버보안 완화(Thinking 변형): GPT-5.4 Thinking은 이전 Codex/5.3 모델에서 사용된 보호 장치를 기반으로 사이버 위험에 대한 확장된 완화책을 강조합니다. GPT-5.4 Thinking은 고능력 오용 시나리오에 대한 추가 가드레일을 갖추도록 설계되었습니다.
성능 벤치마크 — 숫자가 말하는 것
OpenAI와 여러 매체는 출시의 일환으로 초기 벤치마크 결과를 공개했습니다. 서로 다른 벤치마크는 서로 다른 능력(웹 내비게이션 vs. 도메인 지식 vs. 안전성)을 테스트하므로, 주요 수치와 그 의미를 집계하는 것이 유용합니다.
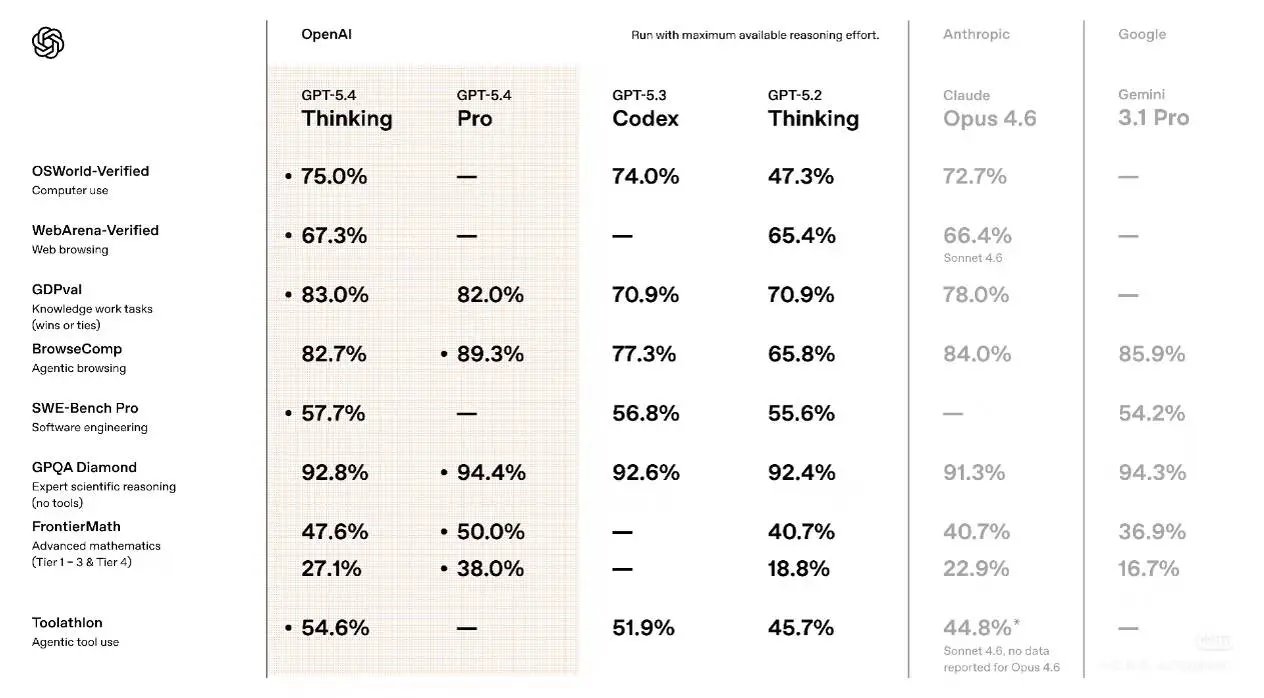
보고된 결과는 이전 GPT-5.x 계열 대비 눈에 띄는 개선을 보여주며, 다른 최상위 모델들과의 치열한 경쟁을 나타냅니다.
웹 및 데스크톱 상호작용 벤치마크
WebArena-Verified(브라우저 사용 테스트): GPT-5.4는 DOM과 스크린샷 신호를 모두 사용할 때 67.3% 성공률을 달성했으며, GPT-5.2의 65.4% 대비 눈에 띄지만 압도적이진 않은 향상입니다. 이는 모델이 라이브 페이지와 UI 요소와 상호작용해야 하는 작업을 측정합니다.
Online-Mind2Web(스크린샷 기반 브라우저 작업): GPT-5.4는 스크린샷 관찰만으로 92.8% 성공률을 기록 — 이전 에이전트 스타일 기준선 대비 특히 강한 개선입니다(OpenAI는 이를 ChatGPT Atlas의 Agent Mode 성능과 비교했습니다).
OSWorld-Verified(데스크톱 내비게이션): 독립 보도에 따르면 GPT-5.4는 데스크톱 환경 내비게이션 및 작업 완료를 평가하는 벤치마크에서 **75.0%**를 기록했습니다. 해당 결과는 엔드 투 엔드 자동화 작업에서 공개 기준선 다수를 앞서는 위치로 5.4를 자리매김했습니다.
핵심 요약: 5.4의 개선은 시각적 컨텍스트, UI 어포던스, 장시간의 행동 시퀀스 이해가 중요한 곳 — 즉 에이전트형 워크플로에서 가장 두드러집니다.
건강, 안전 및 지식 벤치마크
OpenAI의 배포 안전성 보고는 혼재된 신호를 보여줍니다:
HealthBench: GPT-5.4는 **62.6%**를 기록(스냅샷 테스트에서 GPT-5.2의 63.3% 대비 소폭 하락)하여, 특정 건강 관련 평가 지표에서 능력과 미묘한 트레이드오프가 있음을 시사합니다.
Hard: GPT-5.4는 “Hard” 평가 모음에서 40.1%(42.0% 대비 소폭 하락).
Consensus: GPT-5.4는 “Consensus”에서 **96.6%**를 기록 — 큐레이션된 합의 답변과의 일치도를 반영하는 지표로 약 2.1포인트 상승.
OpenAI는 건강 평가에서 평균 응답 길이 변화도 언급했습니다(GPT-5.4 평균 약 ~3,311자 vs. GPT-5.2의 2,676자). 이는 모델이 민감한 주제를 다루는 방식에 영향을 줄 수 있습니다.
해석: 안전 및 건강 지표는 5.4가 전반적으로 합의 정렬을 높이고, 응답 장황함을 변화시켰으며, 일부 협소한 건강 점수는 소폭 하락했음을 보여줍니다. 이러한 패턴은 모델 목표 재균형을 반영하는 경우가 많습니다 — 더 결단력 있고 장문의 답변은 유틸리티와 합의에 도움이 되는 한편, 민감한 도메인에서 주의 깊은 모니터링이 필요합니다.
도메인별 예시와 주장
초기 테스트는 구체적이고 도메인화된 주장을 제시했습니다(OpenAI 및 서드파티 출처):
법률 추론 벤치마크(BigLaw Bench) — 초기 테스트에서 GPT-5.4가 법률 추론 영역에서 **~91%**를 달성, 문서 분석 작업에 대한 강력한 신호입니다; 해당 수치는 초기의, 동료 검토되지 않은 수치입니다.
환각 감소: GPT-5.4 응답은 특정 이전 기준선 대비 ~33% 더 낮은 확률로 거짓 주장, ~18% 더 낮은 확률로 사실 오류를 포함합니다. 이러한 퍼센트는 2차 보도 및 회사 커뮤니케이션에서 강조되었으며, 다른 모든 주장과 마찬가지로 벤치마크 모음과 샘플링 방법론에 의존합니다.
GPT-5.4 얻는 방법과 비용 지불
ChatGPT 티어 및 엔터프라이즈 액세스
OpenAI 및 제품 보도에 따르면:
ChatGPT Plus / Team / Pro 사용자는 제품에서 GPT-5.4 Thinking을 즉시 받는 그룹이었습니다. Enterprise 및 Education 관리자는 관리자 설정을 통해 조기 액세스를 활성화할 수 있습니다. Free/Go 사용자는 즉각적인 액세스가 보장되지 않습니다. 개발자는 API를 통해 gpt-5.4 및 gpt-5.4-pro 엔드포인트를 호출할 수 있습니다.
API 가격 스냅샷(공개 개발자 가격)
OpenAI의 개발자 가격은 GPT-5.4를 토큰당 과금되는 프런티어 모델로 나열합니다. 발표 당시 공개 가격 페이지에 게시된 샘플 요율은 대략 다음과 같습니다:
Model
Input
Cached input
Output
gpt-5.4 (<272K context length)
$2.50
$0.25
$15.00
gpt-5.4 (>272K context length)
$5.00
$0.50
$22.50
gpt-5.4-pro (<272K context length)
$30.00
$180.00
gpt-5.4-pro (>272K context length)
$60.00
$270.00
CometAPI(a one-stop aggregation platform for large model APIs):
Model
Comet Price (USD / M Tokens)
Official Price (USD / M Tokens)
Discount
gpt-5.4
Input:$2/M; Output:$16/M
Input:$2.5/M; Output:$20/M
-20%
gpt-5.4-pro
Input:$24/MOutput:$192/M
Input:$30/MOutput:$240/M
-20%
따라서 API 비용을 크게 줄일 수 있으므로 CometAPI를 강력히 추천합니다.
비용 관리 고려사항
모델을 대규모로 사용할 계획이라면, 특히 장문 문서 또는 고처리량 환경에서 다음을 고려해야 합니다:
입력 캐싱과 중복 제거(가능한 경우 캐시된 입력 가격을 활용).
프롬프트 엔지니어링을 통해 컨텍스트를 압축하고 중복 토큰을 방지.
배칭 전략과 비싼 출력 생성을 최소화하는 후처리.
추론 모드 사용 모니터링, 더 깊은 추론 모드는 더 높은 연산 비용을 수반할 수 있음.
비교: GPT-5.4 vs GPT-5.3
GPT-5.4가 GPT-5.3 대비 개선된 점
추론 깊이와 도구 오케스트레이션: 5.4 Thinking은 다중 단계 추론과 에이전트형 사용 사례에서 5.3을 능가하도록 명시적으로 튜닝되었습니다. 이는 웹/데스크톱 상호작용 벤치마크와 에이전트 성공 지표에서 나타납니다.
컨텍스트 용량: 5.4의 1M 토큰 제공은 5.3의 주류 API 가용 범위를 넘어선 명확한 기술적 진전으로, 단일 세션 작업의 새로운 범주를 가능하게 합니다.
도메인 성능 향상: OpenAI의 초기 수치와 서드파티 보고서는 법률 및 문서 벤치마크에서 개선을 가리키며, 5.4의 더 긴 컨텍스트와 특화 튜닝이 도움이 됩니다.
트레이드오프 및 5.3이 여전히 더 나을 수 있는 영역
경량 대화형 사용:GPT-5.3 Instant는 빠르고 경제적인 대화 흐름에 최적화되어 있습니다; 짧은 채팅 상호작용에서 최소 지연/비용을 원하는 조직은 이를 선호할 수 있습니다.
안전성 지표의 안정성: 일부 건강 및 “hard” 평가 점수는 스냅샷에서 5.4가 5.2 대비 소폭 하락을 보였습니다; 규제가 민감한 도메인의 엔터프라이즈는 전면 롤아웃 전에 자체 평가 모음에서 모델을 검증해야 합니다.
사용 사례 및 산업적 함의
GPT-5.4의 깊은 추론, 장문 컨텍스트 메모리, 도구 사용의 조합은 여러 실질적·전략적 기회를 열어줍니다.
1. 전문 서비스 및 컨설팅
장문의 결과물을 생산하는 기업(예: 법률 서면, 다챕터 컨설팅 보고서, M&A 실사 자료집)은 전체 문서와 데이터셋을 컨텍스트에 유지할 수 있어, 문서 간 일관적 종합, 자동화된 QA, 수작업 분할 없이 경영 요약을 생성할 수 있습니다. APEX-Agents 벤치마크 승리도 이러한 포지셔닝과 일치합니다.
2. 소프트웨어 엔지니어링 및 코드베이스 추론
더 긴 컨텍스트는 단일 모델 호출에 전체 리포지토리 또는 긴 로그 트레이스를 포함할 수 있음을 의미합니다. GPT-5.4의 SWE 벤치마크 개선은 디버깅, 리팩터링, 코드 리뷰 워크플로에서 더 나은 성능을 나타내며 — 특히 지속적 부하에 Pro를 결합할 때 더욱 그렇습니다.
3. 자율 에이전트 및 엔터프라이즈 자동화
도구(스프레드시트, 티켓 시스템, 웹 인터페이스)를 통해 동작하는 에이전트형 시스템은 GPT-5.4의 개선된 도구 선택, 에이전트 워크플로의 토큰 오버헤드 감소, 장기 상태 보존 개선의 혜택을 받습니다. 이는 GPT-5.4를 엔터프라이즈 자동화 파이프라인과 여러 시스템을 가로질러 “행동하는 어시스턴트”에 매력적으로 만듭니다.
결론 — GPT-5.4가 바꾸는 것
GPT-5.4는 장문, 다문서 추론을 처리하고, 더 높은 신뢰도로 에이전트형 워크플로를 실행하며, Pro 계약을 통해 전문 파이프라인으로 확장할 수 있는 모델로 실용적이고 능력 중심의 진보를 나타냅니다. 워크플로가 장기적이고 도구 의존적인 조직에 있어, GPT-5.4는 잠재적 생산성에서 단계적 변화입니다.