
Anthropic heeft Fable 5.1 uitgebracht op 1 september 2026 als zijn krachtigste algemeen beschikbare model voor programmeren en kenniswerk. Het model richt zich op langetermijnwerk: meeruur durende coding, meerstaps research, documentintensief professioneel werk en agents die herhaaldelijk tools gebruiken terwijl ze grote hoeveelheden context behouden.
Claude Fable 5.1 combineert een contextvenster van 1M tokens, tot 128K outputtokens, input van tekst en afbeeldingen, en altijd-actieve adaptieve denkwijze. Basisprijzen blijven $10 voor input en $50 voor output per MTok; de belangrijke kostenwijziging is $0.25 per MTok voor cache-lezingen.
Specificaties van Claude Fable 5.1 in één oogopslag
De onderstaande specificaties komen uit Anthropic’s modeldocumentatie. Prijzen zijn de officiële Anthropic-lijstprijzen en moeten los worden gezien van eventuele CometAPI-prijzen.
| Officiële specificatie | Claude Fable 5.1 |
|---|---|
| Release en model-ID | 1 september 2026 — claude-fable-5-1 |
| Primaire rol | Veeleisende redenering en agentisch werk op lange termijn |
| Context en maximale output | 1M-token context — tot 128K output |
| Input → output | Tekst en afbeeldingen → tekst |
| Denken en standaard API-inspanning | Adaptief denken, altijd aan — hoge inspanning |
| Betrouwbare kennisafkapdatum | juni 2026 |
| Lijstprijzen | $10 input — $50 output — $0.25 cache-lezen per MTok |
Twee details zijn belangrijker dan de kale cijfers. Het 1M-contextvenster is standaard beschikbaar in plaats van als speciale long-context-laag. Adaptief denken staat altijd aan, terwijl de inspanningsinstelling bepaalt hoeveel werk het model verricht; Anthropic zegt dat de standaard High is in Claude Code en Medium in Claude Cowork en Claude.ai.
Wat is Claude Fable 5.1
Claude Fable 5.1 is Anthropic’s frontiermodel voor taken waarbij een systeem gedurende vele stappen moet blijven redeneren, tools gebruiken en context behouden. In plaats van korte vraag-en-antwoord-uitwisselingen is het ontworpen voor aanhoudende uitvoering: een codebase verkennen, terminalworkflows draaien, grote documentsets synthetiseren en professionele taken afronden die uren kunnen duren.
Het kenmerkende pakket is een contextvenster van 1M tokens met tot 128K output, input van tekst en afbeeldingen, en adaptief denken dat gedurende een verzoek ingeschakeld blijft. Dit stelt een agent in staat om lange instructies, bronmateriaal, toolresultaten en tussentijdse beslissingen in één werkcontext te houden, terwijl de redeneringsinspanning wordt aangepast aan de moeilijkheid van elke stap.
De beste fit is een high-value workflow waarin falen, herwerk of verlies van context meer kost dan premium tokenprijzen. Voorbeelden zijn engineering op repository-schaal, meerstaps research, agents voor computergebruik, documentanalyse met veel compliance en business-automatisering met herhaalde toolcalls. Voor routineclassificatie, grootschalige extractie of latentiegevoelige chat is een lagere Claude-laag vaak een beter startpunt.
Standaardgebruik van Fable vereist 30 dagen retentie voor veiligheidsmonitoring. In aanmerking komende enterpriseklanten kunnen zero data retention gebruiken terwijl Enterprise Frontier Safeguards wordt uitgerold; Anthropic zegt dat de geplande architectuur gemonitorde data opslaat in door de klant beheerde cloudinfrastructuur. Gereguleerde teams moeten accountspecifieke voorwaarden verifiëren vóór uitrol.
Claude Fable 5.1 vs. Fable 5: wat is er veranderd?
De 5.1-release is geen uniforme capaciteitsstap. De duidelijkste veranderingen zijn lagere kosten voor herhaald contextgebruik en veel sterkere uitvoering op agentische research, terminal-codering en businessworkflows, terwijl algemene tool-ondersteunde redenering slechts licht stijgt.
| Dimensie | Claude Fable 5 | Claude Fable 5.1 | Verandering |
|---|---|---|---|
| Basis input / output | $10 / $50 per MTok | $10 / $50 per MTok | Geen wijziging |
| Cache-lezen | $1.00 per MTok | $0.25 per MTok | 75% lager |
| Terminal-Bench-Science 0.1 | 24.7% | 52.6% | +27.9 punten |
| Terminal-Bench 4.0 | 42.0% | 55.8% | +13.8 punten |
| AutomationBench | 17.1% | 31.4% | +14.3 punten |
| HLE with tools | 63.8% | 65.0% | +1.2 punten |
Cache-leesacties zijn 75% goedkoper terwijl basisprijzen gelijk blijven
Input blijft $10 per MTok en output blijft $50 per MTok, dus het headline-tarief is niet gedaald. De materiële verandering is de cache-read-prijs die daalt van $1.00 naar $0.25 per MTok. Dit is vooral relevant voor agents die herhaaldelijk een lange prefix opnieuw laden met repositories, policies, documenten, tooldefinities en eerdere staat. Hun kosten per afgeronde workflow kunnen dalen ook wanneer tarieven voor nieuwe input en output niet veranderen.
Agentische wetenschappelijke research laat de grootste winst zien
Terminal-Bench-Science 0.1 stijgt van 24.7% naar 52.6%, een winst van 27.9 procentpunt en meer dan een verdubbeling van de vorige score. Dit is het sterkste bewijs dat Fable 5.1 de uitvoering op lange horizon verbetert: een onderzoek plannen, tools bedienen, resultaten interpreteren en herstellen van tussentijdse fouten.
Terminal-codering en zakelijke automatisering verbeteren substantieel
Terminal-Bench 4.0 stijgt van 42.0% naar 55.8%, terwijl AutomationBench stijgt van 17.1% naar 31.4%. Deze resultaten wijzen op betere end-to-end taakvoltooiing, niet louter betere codegeneratie. Teams mogen de grootste winst verwachten in workflows die vereisen dat het model een omgeving inspecteert, acties kiest, tools gebruikt en uitkomsten verifieert over meerdere stappen.
Algemene redenering verbetert minder dan uitvoering
Humanity's Last Exam met tools gaat van 63.8% naar 65.0%, slechts 1.2 punt, en CursorBench neemt toe met 2.9 punten. De vergelijking ondersteunt daarom niet de algemene claim dat elke capaciteit evenveel is verbeterd. Fable 5.1 moet beter worden begrepen als een upgrade gericht op uitvoering, waarvan de sterkste winst optreedt wanneer redenering via tools en lange taakketens moet worden volgehouden.
Vergelijkingsresultaat: Bestaande Fable 5-gebruikers die lange, tool-intensieve agents draaien hebben de duidelijkste reden om te upgraden: aanzienlijk goedkopere cache-lezingen en minder falen op uitvoeringsgerichte benchmarks. Teams die korte prompts of algemene kenniswerkzaamheden doen moeten de kleinere winsten valideren tegen latentie en totale kosten vóór migratie.
Benchmarkprestaties van Claude Fable 5.1
Anthropic’s officiële benchmarktabel vergelijkt het nieuwe model met zijn voorganger, Claude Opus 5, en GPT-5.6 Sol. De geselecteerde rijen hieronder bestrijken research, codering, kenniswerk, computergebruik en automatisering.
| Officiële benchmark | Claude Fable 5.1 | Claude Fable 5 | Claude Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| Terminal-Bench-Science 0.1 | 52.6% | 24.7% | 29.0% | 22.4% |
| Terminal-Bench 4.0 | 55.8% | 42.0% | 52.3% | 37.3% |
| GDPval-AA v2 | 1853 | 1723 | 1824 | 1711 |
| OSWorld 2.0 partial | 77.9% | 72.9% | 75.4% | — |
| OSWorld 2.0 strict | 41.7% | 36.1% | 39.6% | — |
| AutomationBench | 31.4% | 17.1% | 26.9% | 19.6% |
| CursorBench 3.2.0 | 73.4% | 70.5% | 70.0% | 67.2% |
De bovenstaande afbeelding is de officiële Anthropic-benchmarkafbeelding, gekopieerd uit het brondocument, geen lokaal opnieuw getekende grafiek. Anthropic wijst op een standaardfout van ±3.5–4.5 punten voor Terminal-Bench-Science en zegt dat productieveiligheidsmaatregelen waren ingeschakeld tijdens de evaluatie. Kleine verschillen moeten daarom met voorzichtigheid worden geïnterpreteerd.
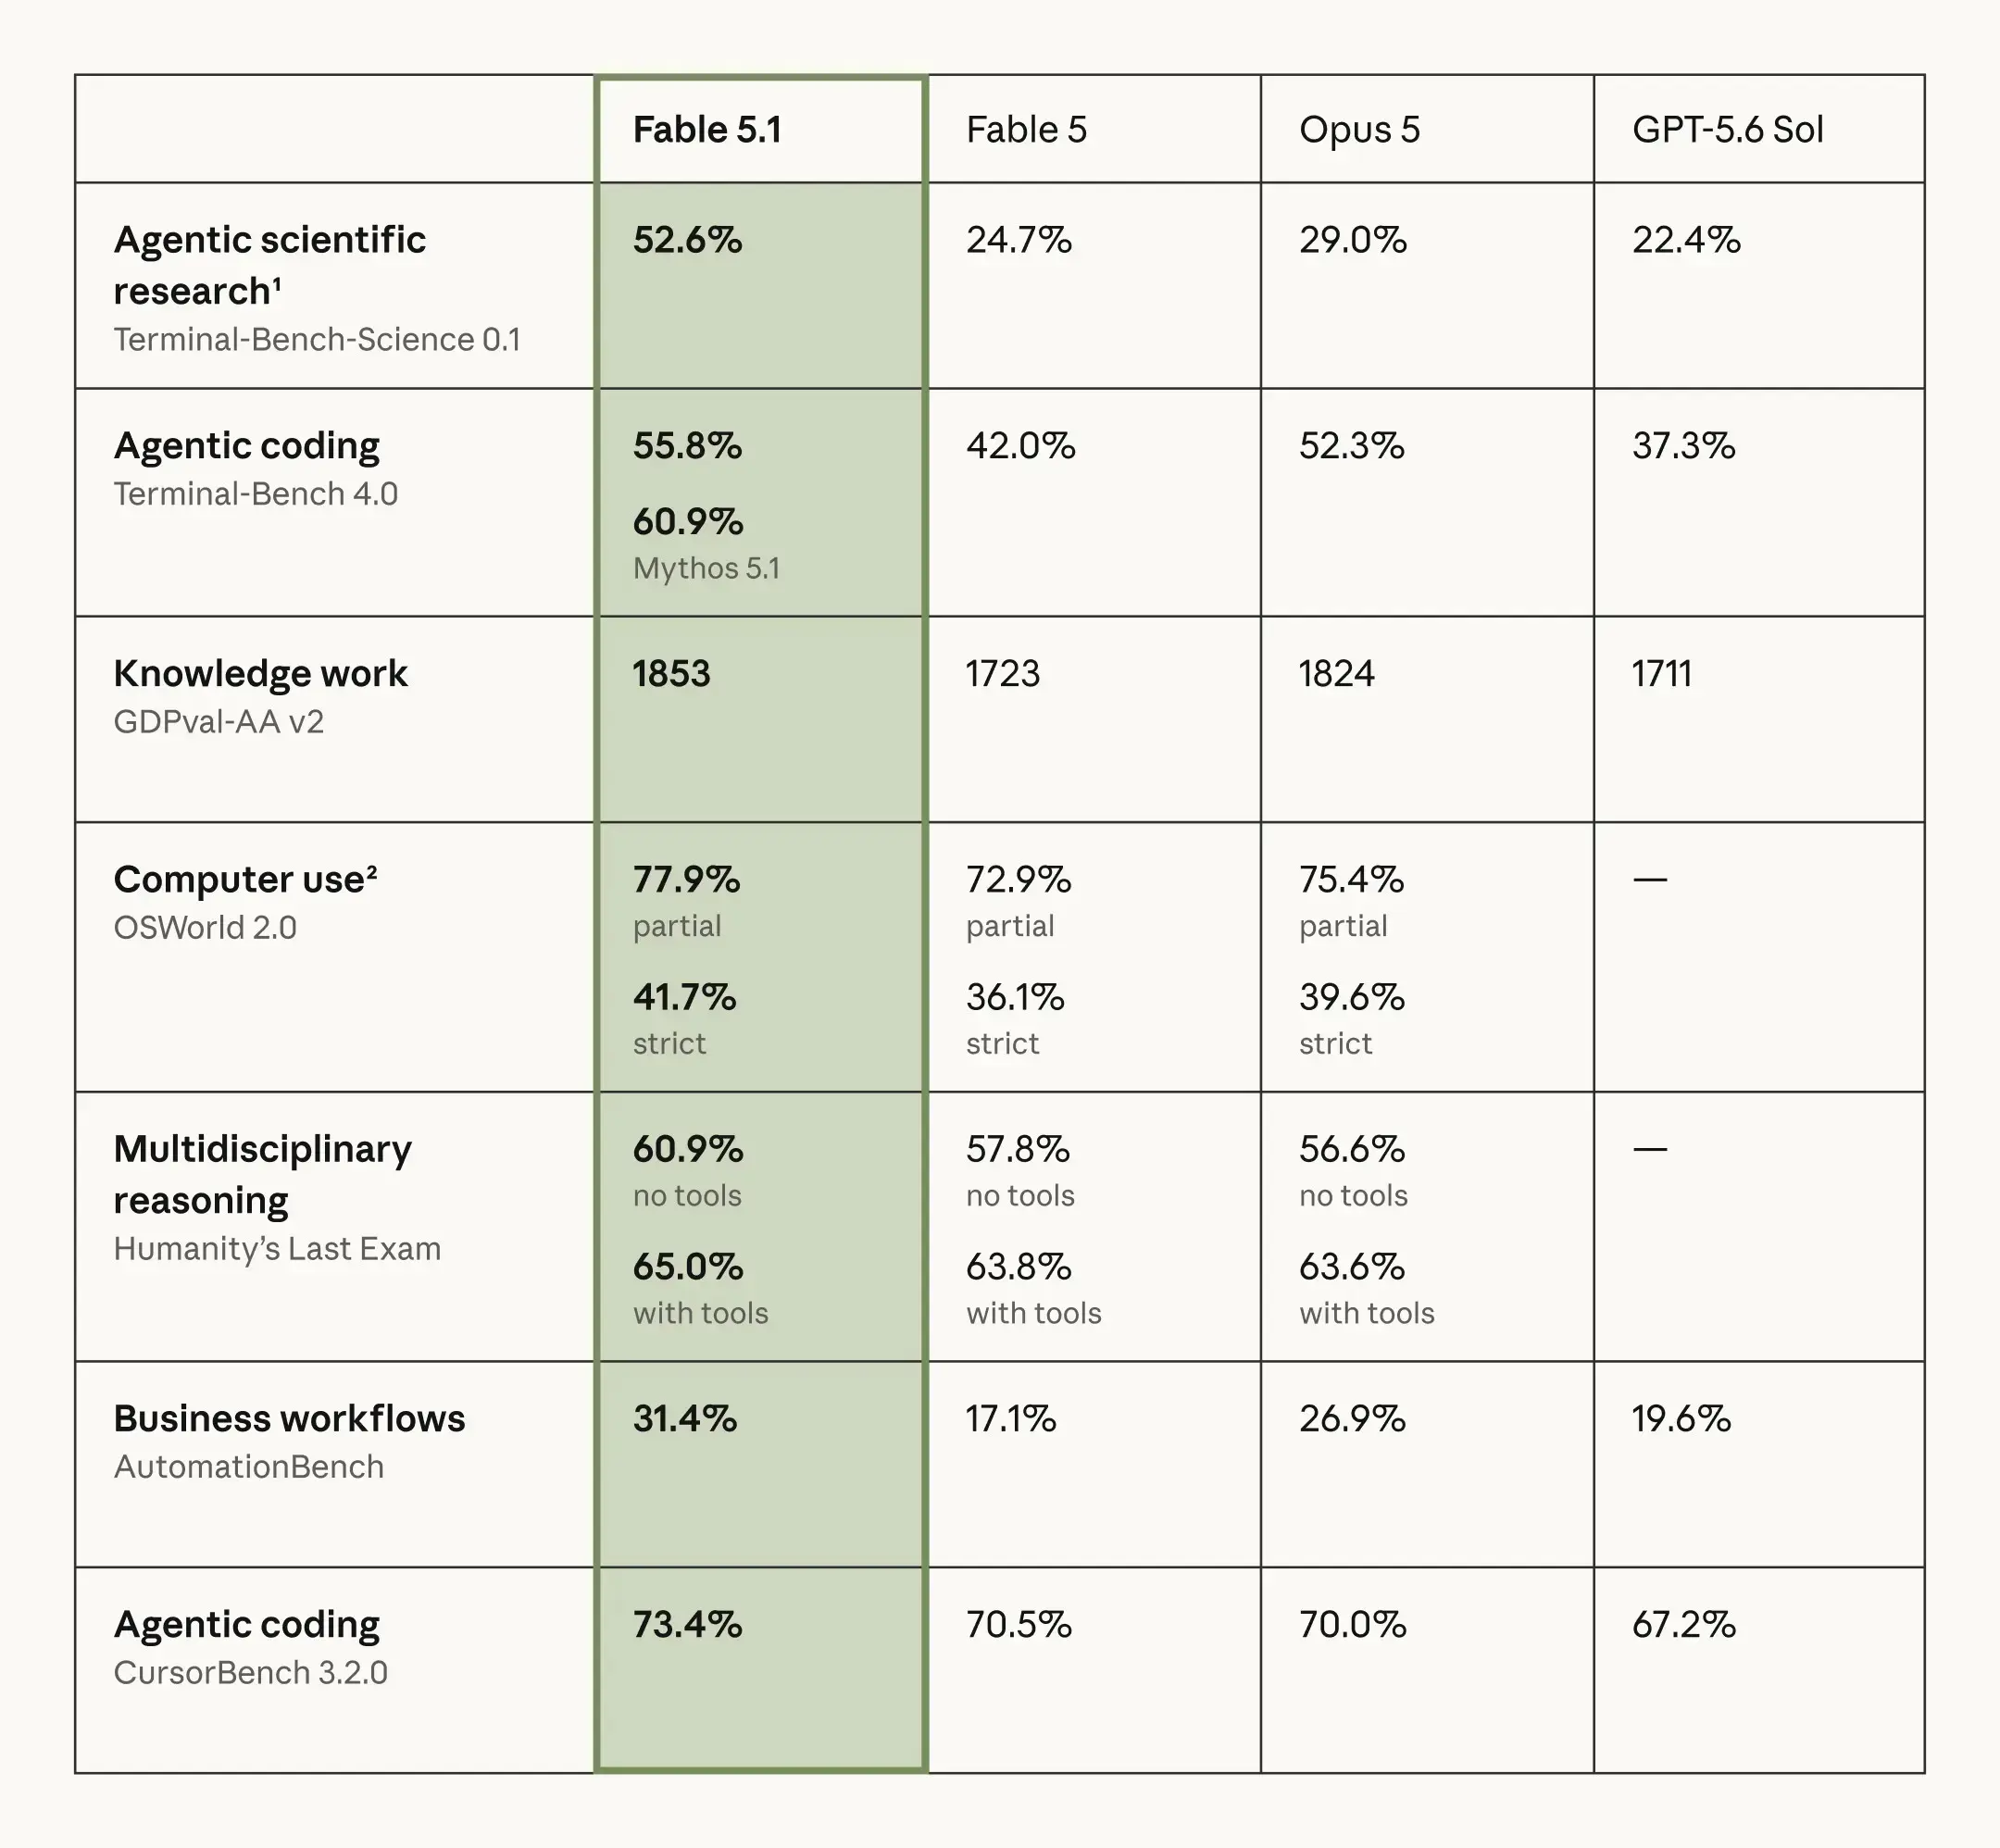
Bron:Officiële Anthropic Fable 5.1 benchmarkgrafiek
Hoe de benchmarkresultaten te interpreteren
Deze scores mogen niet worden gezien als universele maatstaven voor modelkwaliteit. Anthropic evalueerde Claude Fable 5.1 met productieveiligheidsmaatregelen ingeschakeld, en sommige benchmarktaken kunnen worden beïnvloed door interventies van deze safeguards. Terminal-Bench-Science rapporteert ook een standaardfout van ongeveer ±3.5–4.5 procentpunt per model.
OSWorld 2.0-resultaten gebruiken de taakrelease van augustus 2026 van de benchmarkauteurs, dus ze moeten niet rechtstreeks worden vergeleken met scores uit eerdere taakreleases.
Prijzen van Claude Fable 5.1
Prijzen voor input en output
Anthropic vermeldt Claude Fable 5.1 op $10 per MTok input en $50 per MTok output. In de CometAPI staat Claude Fable 5.1 op $8 per MTok input en $40 per MTok output, een verlaging van 20% ten opzichte van de officiële lijstprijzen. Dit zijn gebruiksgebonden tarieven; controleer vóór productie de live modelpagina omdat platformprijzen en factureringsregels kunnen veranderen.
Prijzen voor promptcache
Anthropic rekent $12.50 per MTok voor een cache-schrijfactie van 5 minuten, $20 per MTok voor een cache-schrijfactie van 1 uur en $0.25 per MTok voor een cache-leesactie. Het leestarief ligt 75% onder Fable 5’s $1 per MTok, dus langlopende agents die repositories, policies, tooldefinities of eerdere staat hergebruiken profiteren meer dan korte one-off prompts.
Voorbeeldkosten van een agent-workflow
Een agent die bij elke van 1.000 stappen 150K gecachete tokens leest, verbruikt 150 MTok aan cache-lezingen. Tegen het $0.25-tarief van Fable 5.1 kost die component $37.50; tegen Fable 5’s $1-tarief zou het $150 kosten—een besparing van $112.50. Nieuwe input, output, cache-schrijfacties en platformkosten komen daar nog bij, dus teams moeten de totale kosten per succesvolle workflow vergelijken in plaats van alleen de cachekosten.
Waarom cache-prijzen de economics van agents veranderen
Een conventioneel verzoek besteedt het grootste deel van de rekening aan nieuwe input en output. Een agent is anders: elke toolstap kan een grote gecachete prefix opnieuw lezen met policy, code, documenten, tooldefinities en eerdere staat. Anthropic’s reductie van 75% voor cache-lezingen komt onevenredig ten goede aan lange lussen.
Bijvoorbeeld, een agent die 150K gecachete tokens herleest over 1.000 stappen verbruikt 150 miljoen cache-read-tokens. Bij $1 per MTok kost die component $150; bij $0.25 per MTok kost het $37.50. Dit voorbeeld sluit nieuwe input, output, cache-schrijfacties en platformkosten uit, maar laat zien waarom ongewijzigde basisprijzen toch kunnen leiden tot lagere kosten per afgeronde taak.
Anthropic schat ongeveer 25% lagere kosten voor typische token-gefactureerde workloads en tot circa 45% voor sterk agentische workloads. Dit zijn schattingen op basis van workloadmix, geen universele korting op elke token.
Claude Fable 5.1 vs Opus 5 vs Sonnet 5
Het frontiermodel is het capaciteitsplafond, maar Anthropic raadt de Opus-laag aan als startpunt voor de meeste workloads. De Sonnet-laag blijft de snellere, goedkopere keuze wanneer throughput en latentie zwaarder wegen dan maximale betrouwbaarheid op lange termijn. Voor een diepere tweemodelanalyse, zie CometAPI’s Fable vs Sonnet-vergelijking.
| Dimensie | Claude Fable 5.1 | Claude Opus 5 | Claude Sonnet 5 |
|---|---|---|---|
| Contextvenster | 1M | 1M | 1M |
| Maximale output | 128K | 128K | 128K |
| Lijstprijs input / output | $10 / $50 | $5 / $25 | $2 / $10 |
| Vergelijkende latentie | Langzamer | Gemiddeld | Snel |
| Beste fit | Moeilijkste langetermijnagents en redenering | Standaard premium startpunt | Hoog volume met prioriteit voor snelheid en kosten |
Selectieresultaat: Begin met de lagere prijstier die aan de taak voldoet. Schaal pas op wanneer productievevaluaties laten zien dat het frontiermodel het acceptatiepercentage verhoogt, retries vermindert of de totale kosten per succesvolle workflow verlaagt.
Migratiewijzigingen die ontwikkelaars moeten testen
Het nieuwe model is grotendeels een drop-in-opvolger, maar Anthropic documenteert drie breaking changes die agentframeworks en lange gesprekken beïnvloeden.
| Migratiewijziging | Wat gebeurt er | Vereiste actie voor ontwikkelaars |
|---|---|---|
| Geforceerde toolkeuze | tool_choice = any of een benoemde tool retourneert HTTP 400 | Gebruik auto, instrueer het model en handhaaf strikte schema’s waar nodig |
| Thinking-blokken bij modelwissels | Oudere modellen kunnen de nieuwe thinking-blokken niet lezen | Test routers en verwacht dat thinking-blokken worden gedropt bij terugroutering |
| Eerdere beurten bewerken | Gewijzigde geschiedenis kan thinking-blokken ongeldig maken | Houd geschiedenissen append-only of gebruik ondersteunde compactiepatronen |
Test ook per-bericht-inspanning, op beurtniveau gescope systeemberichten, voortgangsupdates tussen toolcalls, cachegedrag en contentherkomst voordat je productieverkeer migreert. De bestaande Fable API-tutorial blijft de betere plek voor generieke SDK-setup en voorbeeldaanvragen.
Wie zou Claude Fable 5.1 moeten gebruiken?
Claude Fable 5.1 is het best voor workloads waarbij volgehouden redenering en succesvolle voltooiing zwaarder wegen dan minimale latentie of tokenprijs. Kies het wanneer de taak vele stappen omvat, herhaaldelijk tools gebruikt of voldoende zakelijke waarde heeft zodat minder mislukte runs en minder herwerk de premium modelkosten kunnen compenseren.
- Engineering op repository-schaal: debuggen, migraties, refactoring over meerdere files, testuitvoering en onbemande codingagents.
- Meerstaps research: zoeken, bewijs evalueren, analyses uitvoeren en een goed onderbouwd eindrapport produceren.
- Grote documenten en professioneel werk: contracten, technische documentatie, financieel materiaal, spreadsheets en presentatie-workflows.
- Computergebruik en automatisering: taken die herhaalde toolcalls, interfacenavigatie, verificatie en herstel van tussentijdse fouten vereisen.
Voor routineclassificatie, grootschalige extractie of latentiegevoelige chat, begin met Claude Opus 5 of Claude Sonnet 5
Beschikbaarheid via CometAPI
Per 4 september 2026 vermeldt de CometAPI-modelpagina Claude Fable 5.1 als live en operationeel. De model-ID is claude-fable-5-1.
- Maak een CometAPI-account aan of meld je aan en genereer een API-sleutel in het dashboard.
- Selecteer Claude Fable 5.1 en geef
claude-fable-5-1door als model-ID. - Verstuur verzoeken via het Anthropic-compatibele
/v1/messages-endpoint of het OpenAI-compatibele/v1/chat/completions-endpoint. - Voer een evaluatie in productie-stijl uit om latentie, contexthandling, toolgedrag en billing te bevestigen vóór migratie van verkeer.
Ontwikkelaars hebben ook rechtstreeks toegang tot het model via de Claude API, Amazon Bedrock, Google Cloud, Microsoft Foundry en Claude Platform on AWS.
Conclusie
Claude Fable 5.1 moet worden begrepen als een upgrade in uitvoering. Het meest overtuigende bewijs is niet het ongewijzigde 1M-contextvenster of de premium basisprijs van $10/$50; het is de grote verbetering in agentische research, terminal-codering en automatisering, gecombineerd met aanzienlijk goedkopere cache-lezingen.
Gebruik het wanneer een taak moeilijk, langdurig en waardevol genoeg is dat minder mislukte runs de premium prijs kunnen rechtvaardigen. Voor routine-, high-volume- of latentiegevoelig werk, begin met een goedkopere laag en schaal pas op wanneer je eigen evaluatie een meetbare verbetering in afgeronde uitkomsten laat zien.
Veelgestelde vragen
Is Claude Fable 5.1 beschikbaar via een API?
Ja. Anthropic vermeldt dat Claude Fable 5.1 actief is sinds 1 september 2026. Het is beschikbaar via de Claude API, Amazon Bedrock, Google Cloud, Microsoft Foundry en Claude Platform on AWS.
Wat kost de Claude Fable 5.1 API?
De officiële lijstprijs van Anthropic is $10 per MTok input en $50 per MTok output. CometAPI vermeldt momenteel $8 input en $40 output per MTok. Controleer vóór uitrol de live routeprijs.
Hoe groot is het contextvenster van Claude Fable 5.1?
Het model ondersteunt een contextvenster van 1M tokens en tot 128K outputtokens. Grote capaciteit neemt niet de noodzaak weg om retrievalkwaliteit, latentie en kosten met productiedocumenten te testen.
Wat is er veranderd van Claude Fable 5 naar 5.1?
De grootste praktische veranderingen zijn sterkere agentische research en terminaluitvoering, een verlaging van de cache-read-prijs van $1 naar $0.25 per MTok, per-bericht-inspanningsinstellingen, voortgangsupdates en contentherkomst. Migratie vereist ook testen van geforceerde toolkeuze, thinking-blokken over modelwissels en bewerkte gespreksgeschiedenissen.
Is Claude Fable 5.1 beter dan Claude Opus 5?
Niet voor elke workload. Fable 5.1 is de capabelere optie voor veeleisend langetermijnwerk, maar het is trager en duurder. Anthropic raadt aan de meeste workloads te starten met Claude Opus 5 en pas op te schalen wanneer evaluaties met hogere inspanning nog tekortschieten.
Kan ik Claude Fable 5.1 gebruiken via CometAPI?
Ja. CometAPI vermeldt momenteel Claude Fable 5.1 als live onder model-ID claude-fable-5-1, met Anthropic-compatibele en OpenAI-compatibele endpoints.
Ondersteunt Claude Fable 5.1 geforceerd toolgebruik?
Nee. Anthropic documenteert dat tool_choice ingesteld op any of een benoemde tool HTTP 400 retourneert. Gebruik auto of none, en stuur de toolselectie met instructies en strikte inputschema’s wanneer vereist.