
ตอบก่อน
GPT-6 Astra คือโมเดลรุ่นธงใหม่ของ OpenAI สำหรับงานแบบ end-to-end ที่ยาก OpenAI released GPT-6 Astra เมื่อวันที่ 3 กันยายน 2026 โดยวางตำแหน่งไว้กับการให้เหตุผลเชิงลึก การใช้คอมพิวเตอร์ การเขียนโค้ด งานวิจัย งานวิทยาศาสตร์ และการสร้างสิ่งส่งมอบระดับมืออาชีพ โมเดล API มีหน้าต่างบริบทขนาด 1.05M โทเค็น และเอาต์พุตสูงสุด 128K รองรับอินพุตทั้งข้อความและภาพ และรองรับความพยายามในการให้เหตุผลตั้งแต่ระดับต่ำไปจนถึงสูงสุด การตั้งราคามาตรฐานของ API เริ่มที่ $10 input / $50 output ต่อหนึ่งล้านโทเค็น การเปลี่ยนแปลงเชิงปฏิบัติที่สำคัญที่สุดไม่ใช่การกระโดดแบบสม่ำเสมอบนทุกเบนช์มาร์กด้านปัญญาทั่วไป: ผลกำไรที่ใหญ่ที่สุดของ Astra ปรากฏในงานเชิงเอเจนต์ การใช้คอมพิวเตอร์ การดึงข้อมูลจากบริบทยาว เวิร์กโฟลว์การเขียนโค้ด วิทยาศาสตร์ และความปลอดภัยไซเบอร์
ประเด็นนี้สำคัญเพราะบทความเก่าของ CometAPI GPT-6 Is Coming Soon — What Will It Look Like? จำเป็นต้องเป็นการคาดการณ์ ตอนนี้ Astra เปิดตัวสาธารณะแล้ว คู่มือนี้จึงเน้นพฤติกรรมของโมเดลที่ได้รับการยืนยัน การแลกเปลี่ยนบนเบนช์มาร์ก เศรษฐศาสตร์ของ API และจุดที่โมเดลนี้เป็นตัวเลือกที่ดีกว่าโมเดลแนวหน้าที่ถูกกว่า
GPT-6 Astra คืออะไร?
GPT-6 Astra เป็นทายาทของรุ่นธง GPT-5.6 Sol ของ OpenAI OpenAI อธิบาย Astra ว่าเป็นโมเดลที่ทรงความสามารถที่สุดสำหรับงานแบบ end-to-end ที่ยากที่สุด โดยเน้นเวิร์กโฟลว์ที่ต้องให้เหตุผล ใช้เครื่องมือ โต้ตอบกับซอฟต์แวร์ แก้งานระหว่างทาง และพางานตั้งแต่คำขอเริ่มต้นไปจนเสร็จสมบูรณ์ การวางตำแหน่งนี้สำคัญ: Astra ไม่ใช่แค่โมเดลแชตที่ใหญ่ขึ้น แต่ถูกออกแบบให้เป็นเครื่องยนต์ให้เหตุผลภายในเอเจนต์ที่ทำงานข้ามเบราว์เซอร์ เทอร์มินัล เอกสาร สเปรดชีต สภาพแวดล้อมพัฒนา และซอฟต์แวร์ระดับองค์กร
โพสต์เปิดตัวเน้นผลลัพธ์ระดับ state-of-the-art ข้ามการใช้คอมพิวเตอร์ การท่องเว็บ วิศวกรรมซอฟต์แวร์ ความปลอดภัยไซเบอร์ วิทยาศาสตร์ และงานมืออาชีพ โดยรายงานคะแนน 97.6% / 99.9% / 100% บน FrontierMath Tier 4, ARC-AGI-3 และ ExploitBench ตามลำดับ ตัวเลขพาดหัวเหล่านี้โดดเด่น แต่ไม่ควรตีความว่า “Astra ชนะทุกเบนช์มาร์ก” บน Artificial Analysis Intelligence Index ที่ใช้ในตารางเปรียบเทียบของ OpenAI เอง Astra ได้ 61.2 ขณะที่ Claude Fable 5.1 ได้ 65.7 ดังนั้นการเปิดตัวนี้จึงควรถูกเข้าใจว่าเป็นการเปลี่ยนระดับในด้านการลงมือทำและงานเชิงเอเจนต์ มากกว่าการกวาดชนะทุกมาตรวัดปัญญา
มีอะไรเปลี่ยนไปจาก GPT-5.6 Sol?
การใช้คอมพิวเตอร์กลายเป็นความสามารถระดับหนึ่ง
ความก้าวหน้าที่ชัดเจนที่สุดของ Astra คือการใช้คอมพิวเตอร์ บน OSWorld 2.0 OpenAI รายงานว่า Astra ได้ 72.6% เทียบกับ 65.7% ของ GPT-5.6 Sol ในการจำลองเวลาแฝงเดียวกัน Astra ทำงานเสร็จในราว 40 นาที เทียบกับประมาณ 75 นาทีของ Sol ลดลงราว 47% เมื่อรวมกับ Codex harness ที่อัปเดต OpenAI รายงานความเร็วการทำงานเสร็จบน Mind2Web เพิ่ม 1.9× ประเด็นเชิงปฏิบัติไม่ใช่แค่ว่า Astra มองเห็นหน้าจอได้ แต่คือมันรักษาความสอดคล้องของงานซอฟต์แวร์หลายขั้นตอนให้อยู่ได้ยาวนานขึ้นพร้อมลดทางอ้อมที่มีค่าใช้จ่าย
การสร้างสิ่งส่งมอบระดับมืออาชีพมีความจงใจมากขึ้น
OpenAI ฝึก Astra โดยเฉพาะสำหรับเวิร์กโฟลว์มืออาชีพที่ลงท้ายด้วยสิ่งส่งมอบที่ใช้งานได้จริง ไม่ใช่เพียงร่างข้อความ วัสดุเปิดตัวอธิบายถึงประสิทธิภาพที่แข็งแรงขึ้นบนเอกสาร สเปรดชีต งานพรีเซนเทชัน การวิเคราะห์ข้อมูล งานออกแบบ และการยึดตามเทมเพลต Astra ยังเก่งขึ้นในการรักษาทิศทางเมื่อข้อกำหนดเปลี่ยนกลางงาน ทำให้ข้อความกำกับใหม่มีแนวโน้มจะไม่ทับเป้าหมายเดิม ประโยชน์นี้ชัดเจนในเอเจนต์องค์กรที่ทำงานยาว ซึ่งคำสั่งใหม่มักมาหลังเวิร์กโฟลว์เริ่มไปแล้ว
เซสชันยาวเก็บบริบทการทำงานที่มีประโยชน์ได้มากขึ้น
สำหรับเซสชันเขียนโค้ดยาว Astra นำเสนอวิธีใหม่ให้ Codex เก็บและเรียกโน้ตหลังบริบทที่ใช้งานอยู่เต็ม เดิมอาศัยการบีบอัดอย่างหนักซึ่งอาจละข้อมูลว่าเหตุใดการแก้ไขก่อนหน้าจึงล้มเหลวหรือข้อจำกัดใดถูกทดสอบไปแล้ว OpenAI ระบุว่า Astra สามารถเก็บโน้ตข้ามหน้าต่างบริบท ช่วยความต่อเนื่องระหว่างการรีแฟกเตอร์และแก้บั๊กขนาดใหญ่
ความพยายามในการให้เหตุผลขยายได้ถึงระดับสูงสุด
นักพัฒนาสามารถเลือกความพยายามในการให้เหตุผลแบบ low, medium, high, xhigh หรือ max ทำให้เกิดเส้นโค้งคุณภาพ-ต้นทุนที่กว้างกว่าแทนที่จะมอง Astra เป็นจุดทำงานคงที่ แนวทางใช้งานโมเดลอย่างเป็นทางการ แนะนำให้เลือกความพยายามที่ต่ำที่สุดซึ่งบรรลุเป้าหมายการประเมิน เพราะเศรษฐศาสตร์ที่ดีที่สุดของโมเดลมักมาจากประสิทธิภาพโทเค็นมากกว่าการรันที่เหตุผลสูงสุดเสมอ
ประสิทธิภาพเบนช์มาร์กของ GPT-6 Astra
OpenAI เผยการเปรียบเทียบกว้างครอบคลุมการใช้คอมพิวเตอร์ งานมืออาชีพ การเขียนโค้ด การให้เหตุผลเชิงวิชาการ สุขภาพ ความปลอดภัยไซเบอร์ บริบทยาว และการจัดแนว วิธีอ่านที่มีประโยชน์ที่สุดคือแยกระหว่าง “ปัญญาทั่วไป” กับ “ความสามารถในการทำงานที่ต้องใช้เครื่องมือให้เสร็จ” Astra สูงกว่า Sol เพียงเล็กน้อยบน Artificial Analysis Intelligence Index ในตารางของ OpenAI เอง แต่ทิ้งห่างอย่างชัดเจนในหลายเบนช์มาร์กเชิงเอเจนต์และเชิงปฏิบัติการ
| Benchmark | GPT-6 Astra | GPT-5.6 Sol | นัยจากความต่าง |
|---|---|---|---|
| AutomationBench | 41.4% | 18.1% | เพิ่มขึ้นมากในเวิร์กโฟลว์ธุรกิจแบบ end-to-end |
| OSWorld 2.0 | 72.6% | 65.7% | การโต้ตอบกับคอมพิวเตอร์และการทำงานให้เสร็จดีขึ้น |
| Terminal-Bench 4.0 | 57.9% | 37.3% | เพิ่มขึ้นมากในงานโค้ดดิ้งเชิงเอเจนต์ผ่านเทอร์มินัล |
| Terminal-Bench Science 0.1 | 64.6% | 22.4% | ก้าวกระโดดในเวิร์กโฟลว์วิทยาศาสตร์ที่ใช้โค้ด/เครื่องมือ |
| FrontierMath Tier 4 v2 | 97.6% | 83.0% | การให้เหตุผลคณิตศาสตร์ระดับแนวหน้าแข็งแรงขึ้น |
| ExploitBench | 100.0% | 78.5% | ความสามารถด้านความปลอดภัยไซเบอร์ระดับวิกฤต |
| SRE-Bench, one attempt | 88.0% | 55.9% | เก่งขึ้นมากใน reverse engineering / SRE |
| MRCR v2, 512K-1M | 96.3% | 73.8% | การดึงข้อมูลจากบริบทยาวมากดีขึ้น |
| AA Intelligence Index v4.1.1 | 61.2 | 60.9 | ปัญญาทั่วไปแทบทรงตัวเมื่อเทียบกับ Sol |
รูปแบบชัดเจนผิดปกติ ข้อได้เปรียบของ Astra ใหญ่ที่สุดเมื่อเบนช์มาร์กต้องการปฏิสัมพันธ์ต่อเนื่องกับเครื่องมือหรือสภาพแวดล้อม AutomationBench เพิ่มจาก 18.1% เป็น 41.4%; Terminal-Bench Science เพิ่มจาก 22.4% เป็น 64.6%; และ MRCR บริบทยาวปรับปรุงจาก 73.8% เป็น 96.3% ในช่วง 512K–1M ตรงกันข้าม Artificial Analysis Intelligence Index ขยับจาก 60.9 เป็น 61.2 นี่คือเหตุผลที่การบรรยายว่า Astra “แพงขึ้น 2.5× แต่ฉลาดขึ้นเล็กน้อย” พลาดคุณค่าที่แท้จริงของผลิตภัณฑ์
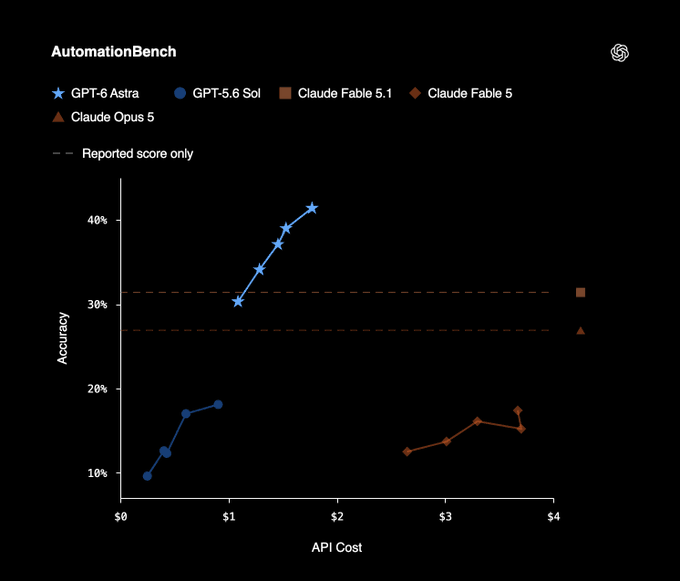
ที่มา: OpenAI AutomationBench chart (ภาพต้นฉบับ ไม่ได้วาดใหม่)
เบนช์มาร์กอิสระ: GPT-6 Astra เป็นก้าวกระโดดเชิงรุ่นหรือไม่?
การทดสอบอิสระช่วยเพิ่มความเป็นจริง Artificial Analysis รายงานคะแนน Intelligence Index ที่ 61 เท่ากับ GPT-5.6 Sol ที่ max effort ขณะเดียวกัน Astra ดีขึ้นมากบน Coding Agent Index และใช้โทเค็นน้อยลงอย่างมีนัยสำคัญในงานโค้ดดิ้งเชิงเอเจนต์ Artificial Analysis วัดการใช้โทเค็นลดลงประมาณสามเท่าเมื่อเทียบกับ GPT-5.6 Sol ที่ max effort ใน Codex harness ของตน ทำให้ Astra ทำคะแนนสูงกว่าในต้นทุนต่อภารกิจเอเจนต์โค้ดดิ้งใกล้เคียงกัน
ด้านเศรษฐศาสตร์ดูน่าดึงดูดน้อยลงบนปัญญาทั่วไป Astra ใช้เอาต์พุตโทเค็นน้อยกว่า Sol ประมาณ 10% บน Intelligence Index ที่ max effort แต่ราคาโทเค็นต่อหน่วยเพิ่ม 2.5× กลบประสิทธิภาพนั้นไป; Artificial Analysis ประเมินว่า Astra แพงกว่าประมาณ 75% ต่อภารกิจ ที่ max effort นอกจากนี้ยังรายงานการลดอัตรา hallucination จาก 92% เหลือ 51% บน AA-Omniscience ขณะที่ความแม่นยำเพิ่มขึ้นสี่จุด
ข้อสรุปที่มีประโยชน์ขึ้นกับงาน: GPT-6 Astra ดูเป็นก้าวกระโดดที่สุดเมื่อเอเจนต์ต้องลงมือ ทำซ้ำ ใช้เครื่องมือ และปิดงานที่ซับซ้อนให้เสร็จ สำหรับการให้เหตุผลทั่วไปหรือการสร้างข้อความปริมาณมาก ส่วนต่างราคาจะยากกว่าที่จะคุ้มค่า
GPT-6 Astra เทียบกับ GPT-5.6 Sol, Claude Fable 5.1, และ Gemini 3.8 Flash
การเลือกโมเดลเชิงปฏิบัติควรรวมความสามารถ มัลติโหมด หน้าต่างบริบท การดำเนินงานเชิงเอเจนต์ และราคา โมเดลด้านล่างไม่ได้ทดแทนกันได้: Astra เพิ่มประสิทธิภาพเพื่อการดำเนินงานแบบ end-to-end ที่ยาก Claude Fable 5.1 นำในมาตรวัดปัญญาทั่วไปบางรายการ และ Gemini 3.8 Flash เสนอราคาโทเค็นที่ต่ำกว่ามากพร้อมโหมดอินพุตที่กว้างกว่า
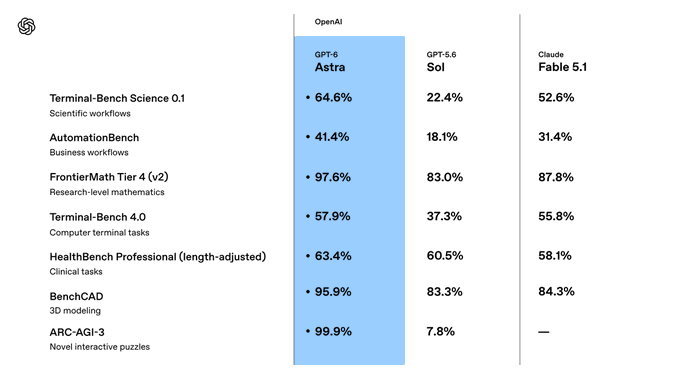
| Metric | GPT-6 Astra | GPT-5.6 Sol | Claude Fable 5.1 | Gemini 3.8 Flash |
|---|---|---|---|---|
| Context window | 1.05M | 1.05M | 1M | 1.048M |
| Max output | 128K | 128K | 128K | 65.5K |
| Input modalities | Text, image | Text, image | Text, image/PDF | Text, image, audio, video, PDF |
| AA Intelligence Index | 61.2 | 60.9 | 65.7 | 58.7 |
| AutomationBench | 41.4% | 18.1% | 31.4% | — |
| Terminal-Bench 4.0 | 57.9% | 37.3% | 55.8% | 19.1% |
| DeepSWE 1.1 | 74.1% | 72.7% | 67.4% | 73.8% |
| FrontierMath Tier 4 v2 | 97.6% | 83.0% | 87.8% | — |
| HLE with tools | 57.2% | — | 65.0% | — |
| HealthBench Professional | 63.4% | 60.5% | 58.1% | 52.1% |
| Official standard input price | $10/M | $4/M | $10/M | $0.75/M |
| Official standard output price | $50/M | $20/M | $50/M | $3.75/M |
เมื่อใดที่ GPT-6 Astra เป็นตัวเลือกที่ดีกว่า
เลือก Astra เมื่อภารกิจมีต้นทุนสูงเพราะคนต้องเข้าไปกู้การรันเอเจนต์ที่ล้มเหลว: การเปลี่ยนโค้ดขนาดใหญ่ อัตโนมัติเบราว์เซอร์/เดสก์ท็อป งานวิจัยเชิงลึกที่คร่อมหลายเครื่องมือ การสร้างสิ่งส่งมอบทางเทคนิค หรือเวิร์กโฟลว์วิทยาศาสตร์และปฏิบัติการที่ซับซ้อน ราคาพรีเมียมจะทำให้คุ้มได้ง่ายเมื่อจำนวนการรันซ้ำลดลง การแก้ไขด้วยมือลดลง และการใช้เอาต์พุตโทเค็นน้อยลงสำคัญกว่าราคาโทเค็นต่อหน่วย
เมื่อใดที่ Claude Fable 5.1 เป็นตัวเลือกที่ดีกว่า
Claude Fable 5.1 ยังคงเป็นคู่แข่งแนวหน้าที่จริงจัง ในตารางเปิดตัวของ OpenAI เอง โมเดลนี้ได้ 65.7 บน Artificial Analysis Intelligence Index เทียบกับ 61.2 ของ Astra และ 65.0 บน Humanity’s Last Exam พร้อมเครื่องมือ เทียบกับ 57.2 ของ Astra นั่นหมายความว่า Astra ไม่ควรถูกทำการตลาดว่าเป็นผู้ชนะด้านปัญญาสากล หากชุดประเมินของคุณคล้ายการให้เหตุผลแบบยาวมากกว่าการใช้คอมพิวเตอร์ทำงาน Claude Fable 5.1 อาจยังเหมาะกว่า
เมื่อใดที่ Gemini 3.8 Flash เป็นตัวเลือกที่ดีกว่า
Gemini 3.8 Flash เล็งไปยังจุดคนละด้านของแนวหน้า รองรับอินพุตข้อความ ภาพ เสียง วิดีโอ และ PDF พร้อมหน้าต่างบริบทประมาณ 1M โทเค็น โดยราคาทางการต่ำกว่า Astra มาก สำหรับการดึงข้อมูลมัลติโหมดปริมาณมาก ความเข้าใจวิดีโอ/เสียง เอเจนต์ทั่วไป หรือเวิร์กโหลดที่เศรษฐศาสตร์โทเค็น $10/$50 ทำได้ยาก Gemini 3.8 Flash มักเป็นตัวเลือกที่คุ้มค่ากว่าในการผลิต
ทำไมคะแนนความปลอดภัยไซเบอร์ของ GPT-6 Astra จึงสำคัญ
Astra เป็นโมเดล OpenAI ที่เปิดใช้งานกว้างตัวแรกที่ไปถึงเกณฑ์ขีดความสามารถด้านความปลอดภัยไซเบอร์ระดับวิกฤต ภายใต้ Preparedness Framework ของบริษัท OpenAI ระบุว่าโมเดลสามารถระบุช่องโหว่ที่ไม่เคยรู้มาก่อนและพัฒนากลยุทธ์การเจาะระบบบนระบบที่แข็งตัวแล้ว เมื่อได้รับเครื่องมือและการเข้าถึงที่เหมาะสม ในการประเมินเปิดตัว Astra ได้ 100% บน ExploitBench, 42.4% บน ExploitGym และ 88.0% บน SRE-Bench ในความพยายามครั้งเดียว
ความสามารถนี้มาพร้อมการควบคุมการใช้งานที่เข้มงวดขึ้น OpenAI ระบุว่ามาตรการป้องกันในการผลิตอาจทำให้ช้าลง หยุดชั่วคราว หรือหยุดงานที่ถูกต้อง โดยเฉพาะบริบทไซเบอร์ที่เสี่ยงสูง ChatGPT หรือ Codex อาจขอให้ผู้ใช้ตรวจทานการกระทำก่อนทำต่อ ขณะที่งาน API อาจหยุดได้ การปรับใช้ Astra แบบดีฟอลต์ยังปฏิเสธคำขอสร้างเอ็กซ์พลอยต์ขั้นสูงมากขึ้น โปรแกรม Daybreak ของ OpenAI ให้การเข้าถึงที่แยกต่างหากและผ่านการคัดกรองสำหรับเวิร์กโฟลว์ด้านป้องกันบางส่วน
ระบบการ์ดบันทึกการแลกเปลี่ยนด้านความสามารถในการตรวจติดตาม: โดยรวม Astra จัดแนวได้ดีกว่า Sol แต่การให้เหตุผลแบบเขียนอาจตรวจติดตามได้ยากกว่าภายใต้เงื่อนไขการประเมินแบบเป็นปฏิปักษ์ ดังนั้น OpenAI จึงปรับใช้การติดตามความคลาดเคลื่อนที่กว้างขึ้นรอบการอนุมานของ Astra ที่ใช้เครื่องมือ ทีมองค์กรควรปฏิบัติต่อสิทธิ์ของเอเจนต์ ขอบเขตการอนุมัติ บันทึกการตรวจสอบ และการให้สิทธิ์แบบน้อยที่สุดสำหรับการเข้าถึงเครื่องมือ เป็นส่วนหนึ่งของสถาปัตยกรรมโมเดล ไม่ใช่ตัวเลือกเสริม
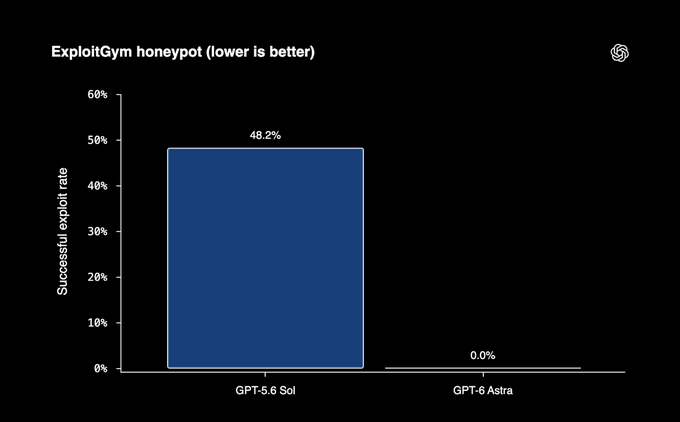
ที่มา: OpenAI official ExploitGym honeypot safety chart (ภาพต้นฉบับ ไม่ได้วาดใหม่)
ราคา GPT-6 Astra
หน้าราคาปัจจุบันของ API ของ OpenAI แยกระหว่างคำขอแบบบริบทสั้นและบริบทยาว สำหรับ Standard อัตราบริบทสั้นคือ $10 อินพุต, $1 อินพุตที่แคช, $12.50 เขียนแคช และ $50 เอาต์พุต ต่อหนึ่งล้านโทเค็น คำขอที่มีอินพุตเกิน 272K โทเค็นจะใช้อัตราบริบทยาว: $20 อินพุต, $2 อินพุตที่แคช, $25 เขียนแคช และ $75 เอาต์พุต ต่อหนึ่งล้านโทเค็น
| Processing / context | Input | Cached input / cache write | Output |
|---|---|---|---|
| Standard, short context | $10/M | $1/M / $12.50/M | $50/M |
| Standard, long context (>272K input) | $20/M | $2/M / $25/M | $75/M |
| Batch / Flex, short context | $5/M | $0.50/M / $6.25/M | $25/M |
| Batch / Flex, long context | $10/M | $1/M / $12.50/M | $37.50/M |
| Fast mode, short context | $20/M | $2/M / $25/M | $100/M |
| Fast mode, long context | $40/M | $4/M / $50/M | $150/M |
เมื่อเทียบกับ GPT-5.6 Sol ราคามาตรฐานโทเค็นของ Astra สำหรับบริบทสั้นสูงกว่า 2.5× ($10/$50 เทียบกับ $4/$20) ส่วนต่างนี้ไม่ได้แปลว่า ต้นทุนต่อภารกิจเสร็จสมบูรณ์สูงขึ้น 2.5× โดยอัตโนมัติ บนงานโค้ดดิ้งเชิงเอเจนต์ ทั้ง OpenAI และ Artificial Analysis รายงานการใช้เอาต์พุตโทเค็นที่น้อยกว่าสำหรับ Astra ในบางการตั้งค่า หน่วยที่ถูกต้องสำหรับการประเมินจึงเป็นต้นทุนต่อภารกิจที่สำเร็จ ไม่ใช่เพียงต้นทุนต่อโทเค็น
วิธีเข้าถึง GPT-6 Astra
OpenAI เริ่มเปิดตัวแบบทยอยเมื่อวันที่ 3 กันยายน 2026 Astra มีกำหนดให้ผู้ใช้ ChatGPT Plus, Pro, Business และ Enterprise, OpenAI API และ AWS ในวันถัดๆ ไป ผู้ดูแลระบบองค์กรสามารถเปิดใช้งาน Astra ต่อพื้นที่ทำงาน โดยดีฟอลต์จะปิดไว้เมื่อเปิดตัว
เรียกใช้ GPT-6 Astra ด้วย OpenAI Responses API
from openai import OpenAI
client = OpenAI()

response = client.responses.create(
    model="gpt-6-astra",
    reasoning={"effort": "high"},
    input=(
        "ทบทวนสถาปัตยกรรมของรีโพซิทอรีนี้ ระบุประเด็นการออกแบบ "
        "ที่มีความเสี่ยงสูงสุด อธิบายหลักฐาน และเสนอแผนการย้ายระบบ "
    ),
)

print(response.output_text)
รหัสโมเดลคือ gpt-6-astra สำหรับเวิร์กโฟลว์ที่ใช้เครื่องมือหนัก Responses API เป็นจุดเริ่มต้นที่เป็นธรรมชาติ เพราะ Astra รองรับการเรียกใช้ฟังก์ชัน เอาต์พุตแบบมีโครงสร้าง การค้นหาเว็บ การค้นหาไฟล์ ตัวแปลโค้ด เชลล์แบบโฮสต์ ใช้แพตช์ การใช้คอมพิวเตอร์ MCP และการค้นหาเครื่องมือ ขณะนี้ยังไม่รองรับการจูนแบบละเอียด
กรณีใช้งาน GPT-6 Astra ในโลกจริง
การพัฒนาเกมและเวิร์กโฟลว์ซอฟต์แวร์เชิงภาพ
Playco ทดสอบ Astra ภายใน Playbot ซึ่งเป็น IDE ขับเคลื่อนด้วย AI ที่ทำงานกับ Unity และ Godot โดยตรง OpenAI รายงานการแก้ด้วยมือที่น้อยลง 50% เมื่อเทียบกับโมเดลก่อนหน้า และต้นแบบสามธีมที่สร้างจากรากฐานแบบ grey-box เดียว ตัวอย่างนี้สำคัญเพราะงานต้องมากกว่าการสร้างซอร์สโค้ด: โมเดลต้องให้เหตุผลเกี่ยวกับเลย์เอาต์เชิงพื้นที่ เล่นเกม ทดสอบการเปลี่ยนแปลง ระบุบั๊ก และวนซ้ำภายในสภาพแวดล้อมเชิงภาพ
การทบทวนเอกสารทางกฎหมายและการเงิน
OpenAI วางตำแหน่ง Astra สำหรับเวิร์กโฟลว์มืออาชีพหลายขั้นตอนที่สร้างเอกสาร สเปรดชีต และการวิเคราะห์ที่ขัดเกลาแล้ว ในการทบทวนด้านกฎหมายและการเงิน คุณค่าจริงคือการรักษาสถานะงานข้ามไฟล์จำนวนมาก การตรวจสอบไขว้หลักฐาน และส่งคืนสิ่งส่งมอบที่เสร็จสมบูรณ์แทนที่จะตอบคำถามโดดๆ การตรวจสอบโดยผู้เชี่ยวชาญ การควบคุมการอนุมัติ และการเข้าถึงข้อมูลแบบสิทธิน้อยที่สุดยังคงจำเป็น
เอเจนต์วิศวกรรมแนวระยะยาว
การผสมผสานผลลัพธ์จาก Terminal-Bench, DeepSWE, การย้ายฐานข้อมูล การใช้คอมพิวเตอร์ และบริบทยาว ทำให้ Astra เกี่ยวข้องอย่างยิ่งกับวิศวกรรมระดับคลังรีโพซิทอรี รูปแบบการปรับใช้ที่มีประโยชน์คือให้ Astra ใช้สภาพแวดล้อมพัฒนาที่มีข้อจำกัด เป้าหมาย issue หรือการย้าย ชุดทดสอบ และการเข้าถึงเครื่องมือ แล้วประเมินความสำเร็จตามคุณภาพงานที่รวม การวนล้มเหลวกี่ครั้ง เวลารีวิวโดยมนุษย์ และต้นทุนรวม นี่เป็นเมตริกในการผลิตที่ดีกว่าคะแนนเบนช์มาร์กโค้ดดิ้งตัวเดียว
ข้อจำกัดของ GPT-6 Astra
- ราคาโทเค็นพรีเมียม Astra แพงกว่า GPT-5.6 Sol 2.5× ต่อโทเค็นที่ราคามาตรฐานบริบทสั้น ดังนั้นงานแชตทั่วไป การจัดหมวด การดึงข้อมูล และการร่างง่ายๆ มักไม่คุ้ม
- บริบทยาวมีค่าบริการเพิ่ม คำขอที่มีอินพุตเกิน 272K โทเค็นจะย้ายไปใช้อัตราบริบทยาวสำหรับทั้งคำขอ ดังนั้น “บริบท 1.05M” ไม่ได้หมายถึงความจำราคาคงที่
- ไม่มีอินพุตเสียงหรือวิดีโอแบบเนทีฟ โมเดลรับข้อความและภาพ และให้เอาต์พุตเป็นข้อความ; Gemini 3.8 Flash ยืดหยุ่นกว่าสำหรับงานที่การเข้าใจเสียง/วิดีโอแบบเนทีฟเป็นศูนย์กลาง
- ไม่มีการจูนแบบละเอียด หน้าโมเดลอย่างเป็นทางการระบุว่ายังไม่รองรับ จึงต้องปรับแต่งด้วยพรอมต์ เครื่องมือ การค้นคืน และการออกแบบเวิร์กโฟลว์
- มาตรการไซเบอร์สามารถขัดจังหวะเวิร์กโฟลว์ OpenAI เตือนชัดเจนว่าการตรวจความปลอดภัยเพิ่มเติมอาจหยุดชั่วคราวหรือหยุดงานที่ถูกต้องในบริบทเสี่ยงสูง
- ไม่ชนะทุกเบนช์มาร์ก Claude Fable 5.1 นำหน้า Astra บน Artificial Analysis Intelligence Index และ HLE-with-tools ตามตัวเลขที่ OpenAI เผยเอง
คำถามที่พบบ่อย
GPT-6 Astra เปิดตัวอย่างเป็นทางการหรือยัง?
เปิดแล้ว OpenAI เริ่มทยอยเปิดให้ใช้ เมื่อวันที่ 3 กันยายน 2026 ความพร้อมใช้งานถูกทยอยตามองค์กร แผน ChatGPT แบบชำระเงิน การเข้าถึง API และ AWS ไม่ได้ปรากฏพร้อมกันทุกบัญชี
หน้าต่างบริบทของ GPT-6 Astra คือเท่าไร?
หน้ารายการโมเดลอย่างเป็นทางการระบุหน้าต่างบริบท 1.05M โทเค็น และเอาต์พุตสูงสุด 128K คำขอที่เกิน 272K อินพุตโทเค็นจะใช้อัตราราคาแบบบริบทยาว
GPT-6 Astra มีค่าใช้จ่ายเท่าใด?
ราคามาตรฐานบริบทสั้นคือ $10 input / $50 output ต่อหนึ่งล้านโทเค็น โดยอินพุตที่แคช $1 และการเขียนแคช $12.50 บริบทยาว Batch/Flex และ Fast mode มีอัตราต่างกัน ดังนั้นการประเมินเพื่อการผลิตควรใช้ระดับที่สอดคล้องกับคำขอจริง
GPT-6 Astra ดีกว่า Claude Fable 5.1 หรือไม่?
ขึ้นอยู่กับงาน Astra นำบนการใช้คอมพิวเตอร์ เอเจนต์โค้ดดิ้ง วิทยาศาสตร์ ไซเบอร์ และงานมืออาชีพบางส่วน ขณะที่ Claude Fable 5.1 นำ Astra บน Artificial Analysis Intelligence Index และ HLE with tools ตามการเปรียบเทียบที่ OpenAI เผย ควรใช้ชุดประเมินเอเจนต์/งานของคุณเอง แทนที่จะสมมติว่าโมเดลเดียวชนะทุกประเภท
GPT-6 Astra คือ AGI หรือไม่?
หน้าผลิตภัณฑ์ทางการของ OpenAI อธิบาย Astra ว่าเป็นเจเนอเรชันใหม่ของปัญญาและเป็นโมเดลที่ทรงความสามารถที่สุดที่เปิดใช้งานอย่างกว้าง แต่ไม่ได้ระบุผลิตภัณฑ์นี้ว่าเป็น “AGI” การอิ่มตัวบนเบนช์มาร์กบางงานไม่เท่ากับนิยาม AGI ที่เป็นเอกฉันท์และสากล
สรุป
การเข้าใจ GPT-6 Astra ที่ดีที่สุดคือมองว่าเป็นโมเดลแนวหน้าที่เน้นการลงมือทำ หลักฐานความก้าวหน้าที่แข็งแรงที่สุดไม่ใช่การขยับเล็กน้อยจาก 60.9 เป็น 61.2 เทียบกับ GPT-5.6 Sol บน Artificial Analysis Intelligence Index; แต่คือการปรับปรุงที่ใหญ่กว่าอย่างมากในด้านการใช้คอมพิวเตอร์ เอเจนต์โค้ดดิ้ง เวิร์กโฟลว์วิทยาศาสตร์ การดึงข้อมูลจากบริบทยาว การทำงานระดับมืออาชีพให้เสร็จ และความปลอดภัยไซเบอร์ หน้าต่างบริบท 1.05M และสแต็กเครื่องมือเชิงลึกเปิดพื้นที่ให้ผู้พัฒนาสร้างเอเจนต์ที่ยังคงมีประโยชน์เกินกว่าคำตอบเดียว
ข้อแลกเปลี่ยนคือราคา ราคามาตรฐาน $10/$50 เป็นพรีเมียม คำขอบริบทยาวแพงกว่า และการทดสอบอิสระชี้ว่า Astra อาจแพงกว่า Sol อย่างมีนัยสำคัญบนเวิร์กโหลดปัญญาทั่วไป โมเดลคุ้มราคาพรีเมียมเมื่ออัตราการทำงานสำเร็จดีขึ้นและการแก้โดยมนุษย์ลดลงจนคุ้มกว่าต้นทุนโทเค็น สำหรับเวิร์กโฟลว์ที่ง่ายกว่าหรือปริมาณสูง GPT-5.6, Claude Fable 5.1 และโดยเฉพาะ Gemini 3.8 Flash ยังคงเป็นตัวเลือกที่เกี่ยวข้อง ไม่ใช่ของเดิมที่ล้าสมัย