
TL;DR
Z.AI đã công khai đặt tên GLM-6.0 và đặt Full Self-Training ở vị trí trung tâm trong lộ trình thế hệ tiếp theo của mình. Hướng đi được tiết lộ kết nối trải nghiệm tự sinh ra xuyên suốt tiền huấn luyện, giữa huấn luyện và hậu huấn luyện với tự đánh giá và hiệu chỉnh, biến quá trình huấn luyện thành một vòng phản hồi được kiểm soát thay vì một lượt tạo dữ liệu đơn lẻ.
Phần khó là kiểm soát: GLM-6.0 sẽ cần tinh lọc dữ liệu tổng hợp, phát hiện và sửa lỗi, dừng các vòng lặp kém hiệu quả và ngăn bộ đánh giá thưởng cho đường tắt. Những cơ chế đó đặt ra các câu hỏi thực tiễn về thẩm định độc lập, an toàn, chi phí và quản trị. Vì chưa có thẻ mô hình, bộ benchmark, đặc tả API, giá hay ngày phát hành đầy đủ được công bố, bài viết này đánh giá kiến trúc huấn luyện và bằng chứng kèm theo—không phải các thông số suy đoán.
Những điểm chính cho GLM 6.0?
- Bằng chứng mạnh nhất công khai hiện nay liên quan đến hệ thống Full Self-Training, không phải rò rỉ số tham số hay kết quả benchmark.
- Hướng đi được tiết lộ bao trùm dữ liệu tự sinh, môi trường huấn luyện tự xây dựng và tối ưu hóa hạ tầng với sự hỗ trợ của mô hình.
- Vòng phản hồi dự kiến trải dài từ tiền huấn luyện, giữa huấn luyện đến hậu huấn luyện thay vì coi tự huấn luyện là kỹ thuật chỉ áp dụng sau huấn luyện.
- Mô hình hóa đa phương thức nguyên sinh, học tăng cường tầm nhìn dài hạn, lập kế hoạch, sử dụng công cụ, phục hồi và xác minh là các hướng nghiên cứu có liên quan, nhưng chưa phải thông số GLM 6.0 đã công bố.
- Ox Alpha không phải bằng chứng về hiệu năng GLM 6.0 bị rò rỉ; Z.AI xác định đó là danh tính tiền phát hành của GLM-5.3-Flash.
Z.AI thực sự đã xác nhận gì về GLM 6.0?
Tài liệu công khai của Z.AI thiết lập bốn tín hiệu cụ thể: tên GLM-6.0, Full Self-Training là hướng huấn luyện trung tâm, một vòng lặp trải dài tiền huấn luyện, giữa huấn luyện và hậu huấn luyện, cùng cơ chế tự đánh giá và hiệu chỉnh. Công ty cũng cho biết khoảng 60% doanh thu ròng dự kiến dùng để hỗ trợ các mô hình thế hệ tiếp theo, Full Self-Training, huấn luyện quy mô lớn, suy luận, tính toán và hạ tầng liên quan.
Khung Full Self-Training của Z.AI
Full Self-Training được giới thiệu như ý tưởng tổ chức cho GLM-6.0, không phải một tính năng hậu huấn luyện nhỏ. Hệ thống dự kiến sẽ tạo ra trải nghiệm huấn luyện, học từ kết quả, lọc mẫu yếu và lặp lại chu kỳ dưới các kiểm soát chất lượng rõ ràng.
Tự huấn luyện GLM-6.0 xuyên suốt tiền-, giữa- và hậu huấn luyện
Trình tự được tiết lộ—tiền huấn luyện, giữa huấn luyện và hậu huấn luyện—ngụ ý rằng trải nghiệm tự sinh có thể ảnh hưởng đến nền tảng tri thức, định hình năng lực và căn chỉnh tác vụ thay vì chỉ xuất hiện trong giai đoạn tinh chỉnh cuối cùng. Z.AI chưa công bố bộ dữ liệu, ranh giới giai đoạn hay tỷ lệ pha trộn, vì vậy đây nên được coi là hướng đi đã xác nhận chứ không phải công thức hoàn chỉnh.
Cơ chế tự đánh giá và hiệu chỉnh của GLM-6.0
Lộ trình liên kết Full Self-Training với tự đánh giá, phát hiện lỗi, hiệu chỉnh và tự tinh lọc dữ liệu. Về thực tiễn, mô hình sẽ cần đánh giá các quỹ đạo, sửa các bước thất bại, loại bỏ dữ liệu không đáng tin và quyết định khi nào việc lặp thêm không còn cải thiện kết quả theo đo lường độc lập. Thiết kế bộ đánh giá và quy tắc dừng vẫn chưa được công bố.
Bài công bố GLM-6.0 và Full Self-Training nên được đọc cùng với phân bổ nguồn thu công khai của Z.AI.
Những gì đã biết vs những gì chưa biết
Hồ sơ công khai ủng hộ một lộ trình, không phải đặc tả hoàn chỉnh. Bảng dưới đây tách biệt hướng đã xác nhận khỏi các câu hỏi mở để bài viết không biến ý định được công bố thành tuyên bố sản phẩm thiếu cơ sở.
| Tuyên bố | Tình trạng bằng chứng | Những gì được hỗ trợ | Những gì còn chưa biết |
|---|---|---|---|
| Tên GLM-6.0 | Đã công khai | Z.AI đã đặt tên mô hình thế hệ tiếp theo là GLM-6.0. | Ngày phát hành và định vị cuối cùng. |
| Full Self-Training | Lộ trình đã xác nhận | Đây là ưu tiên chiến lược đã nêu. | Chi tiết triển khai và hành vi theo quy mô. |
| Tiền huấn luyện → Giữa huấn luyện → Hậu huấn luyện | Hướng đi đã xác nhận | Tự huấn luyện dự kiến bao trùm vòng đời huấn luyện. | Bộ dữ liệu, bộ thẩm định, ranh giới giai đoạn và tỷ lệ dữ liệu. |
| Tự đánh giá và hiệu chỉnh | Mục tiêu đã xác nhận | Lộ trình bao gồm tự tinh lọc, phát hiện lỗi và hiệu chỉnh. | Độ tin cậy, thẩm định độc lập và tiêu chí dừng. |
| Đặc tả | Chưa công bố | Chưa có đặc tả công khai đầy đủ. | Tham số, cửa sổ ngữ cảnh, đa phương thức, giá và mã nhận diện API. |
| Benchmark | Chưa công bố | Chưa có bảng kết quả GLM-6.0 chính thức. | Điểm số, phương pháp và kết quả có thể tái hiện độc lập. |
Full Self-Training là gì và hoạt động như thế nào
Full Self-Training là một vòng lặp học khép kín trong đó mô hình hỗ trợ tạo bài toán hoặc môi trường, thử nghiệm chúng, đánh giá các quỹ đạo kết quả, sửa các bước yếu và đưa trải nghiệm được chấp nhận quay lại huấn luyện. Sự chuyển dịch quan trọng là từ một pipeline dữ liệu tổng hợp một lần sang một quy trình được quản trị liên tục.
- Tạo sinh: xây dựng bài toán, môi trường công cụ và các đường lời giải ứng viên.
- Thực hiện: hoàn thành tác vụ và lưu lại hành động, quan sát và suy luận trung gian thành các quỹ đạo.
- Đánh giá và sửa: chấm điểm kết quả bằng bộ thẩm định, phát hiện lỗi, sửa các bước thất bại và loại bỏ mẫu có độ tin cậy thấp.
- Huấn luyện và dừng: học từ trải nghiệm đã chấp nhận, rồi chỉ tiếp tục khi đánh giá độc lập cho thấy cải thiện hữu ích.
Mở rộng vòng lặp này xuyên suốt tiền huấn luyện, giữa huấn luyện và hậu huấn luyện sẽ cho phép GLM-6.0 cải thiện chất lượng dữ liệu, định hình năng lực và căn chỉnh tác vụ ở các giai đoạn khác nhau. Kiến trúc này vẫn phụ thuộc vào bộ thẩm định đáng tin cậy: nếu không có kiểm tra độc lập, tự huấn luyện có thể thưởng cho chính điểm mù của nó.
Full Self-Training có thể thay đổi GLM 6.0 như thế nào?
Thiết kế được tiết lộ nên được hiểu như một kiến trúc hệ thống hơn là một khối Transformer mới đơn lẻ. Nó cố gắng khép vòng quanh mô hình để mô hình ngày càng hỗ trợ tạo ra các nguồn lực cần cho chu kỳ huấn luyện tiếp theo.
GLM 6.0 có thể tạo dữ liệu huấn luyện như thế nào?
Vòng lặp đầu tiên là tự sản xuất dữ liệu. Thay vì chỉ phụ thuộc vào tập dữ liệu do con người viết hoặc sưu tầm bên ngoài, các mô hình có thể dùng tự chơi, kiểm tra dựa trên quy tắc, kết quả thực thi, chấm điểm bằng mô hình và kiểm tra ngẫu nhiên bởi con người để tạo và lọc ví dụ mới. Các ví dụ được chấp nhận sau đó quay lại tiền huấn luyện, giữa huấn luyện và hậu huấn luyện.
Ràng buộc quan trọng là thẩm định: tạo sinh tổng hợp chi phí thấp chỉ hữu ích khi hệ thống có thể nhận diện ví dụ đúng, đa dạng và không suy thoái. Một vòng lặp thực tiễn là mô hình tạo sinh → thực thi tác vụ → kiểm tra bằng quy tắc hoặc công cụ → lọc → tái huấn luyện.
GLM 6.0 có thể xây dựng môi trường huấn luyện như thế nào?
Vòng lặp thứ hai là tự xây dựng môi trường. Các tác tử có thể thu thập hoặc biến đổi tác vụ thế giới thực, thử nghiệm các tác vụ đó, tạo bộ thẩm định và kiểm tra liệu tác vụ có thực sự giải được trước khi trở thành dữ liệu huấn luyện. Điều này đặc biệt quan trọng với lập trình và công việc tác tử, nơi trạng thái terminal, đầu ra công cụ, trạng thái trình duyệt, kết quả kiểm thử và phục hồi sau lỗi cung cấp giám sát mạnh hơn so với câu trả lời chỉ văn bản.
Mục tiêu đánh giá chuyển từ việc câu trả lời nghe có vẻ hợp lý sang việc hành động có thành công, kết quả có thể thẩm định độc lập hay không và tác tử có thể phục hồi sau thất bại hay không.
GLM 6.0 có thể tối ưu hạ tầng huấn luyện như thế nào?
Vòng lặp thứ ba là tự tối ưu hạ tầng. Trên thực tế, nên hiểu đây là kỹ nghệ hệ thống do AI hỗ trợ: một mô hình lập trình mạnh đề xuất thay đổi lên operators, kernels, lập lịch, caching hoặc mã phục vụ, trong khi benchmark tự động và thẩm định do con người kiểm soát quyết định thay đổi nào được chấp nhận.
Chu kỳ kết quả là mô hình tốt hơn → đề xuất hệ thống tốt hơn → lợi ích hiệu năng được thẩm định → thêm thí nghiệm huấn luyện → mô hình tốt hơn. Rà soát của con người và benchmark có thể tái hiện vẫn là các điểm kiểm soát thay vì tùy chọn.
Nền tảng GLM 5.3 Flash hiện tại cho ta biết gì về GLM 6.0?
Vì GLM 6.0 chưa có thẻ mô hình công khai, so sánh hợp lý nhất là tách năng lực GLM hiện tại đã đo lường khỏi hướng đi thế hệ tiếp theo. Z.AI mô tả GLM-5.3-Flash là mô hình MoE tổng 320B, 18B hoạt động, được huấn luyện trên kho dữ liệu đa phương thức 30T tokens. Đây là thông số GLM-5.3-Flash, không phải thông số GLM 6.0.
| Chiều so sánh | GLM-5.3-Flash API trong CometAPI | Hướng đi đã công bố của GLM 6.0 |
|---|---|---|
| Trạng thái phát hành | Đang khả dụng | Đang phát triển; tên sản phẩm cuối cùng chưa được tài liệu dẫn chiếu xác lập độc lập |
| Tham số | Tổng 320B / hoạt động 18B | Chưa công bố |
| Kiến trúc lõi | MoE; attention thưa lai + tuyến tính; mHC | Chưa công bố ở mức khối |
| Dữ liệu huấn luyện | Kho đa phương thức 30T tokens | Dữ liệu tự sinh dự kiến đi vào vòng lặp đệ quy |
| Đa phương thức | Nhập đa phương thức nguyên sinh | Mô hình hóa đa phương thức thống nhất là hướng nghiên cứu, chưa phải đặc tả công bố |
| Giai đoạn huấn luyện | Công thức huấn luyện theo giai đoạn đã công bố | Tự huấn luyện xuyên suốt tiền-, giữa- và hậu huấn luyện |
| Môi trường huấn luyện | Môi trường do nhà nghiên cứu thiết kế và benchmark | Tác tử hỗ trợ xây dựng và thẩm định môi trường |
| Thẩm định | Pipeline đánh giá và huấn luyện hiện có | Tự đánh giá mạnh hơn, phản hồi từ thực thi và tự xác minh |
| Hạ tầng | Ngăn xếp suy luận được tối ưu | Mô hình hỗ trợ tối ưu hạ tầng |
| Chi tiết API | Đã công bố ID mô hình và API đang chạy | Chưa công bố |
Văn bản phát hành của Z.AI báo cáo khoảng 3,0× compute attention thấp hơn và kích thước KV-cache nhỏ hơn 4,4× đối với GLM-5.3-Flash so với GLM-5.3 API. Hình đồ họa chính thức đi kèm gắn nhãn so sánh trên một triệu token là 3,40× cho compute attention và 3,80× cho KV cache mỗi lớp. Do hai tư liệu chính thức sử dụng các con số khác nhau, chúng nên được báo cáo theo bối cảnh tương ứng thay vì gộp thành một phép đo.
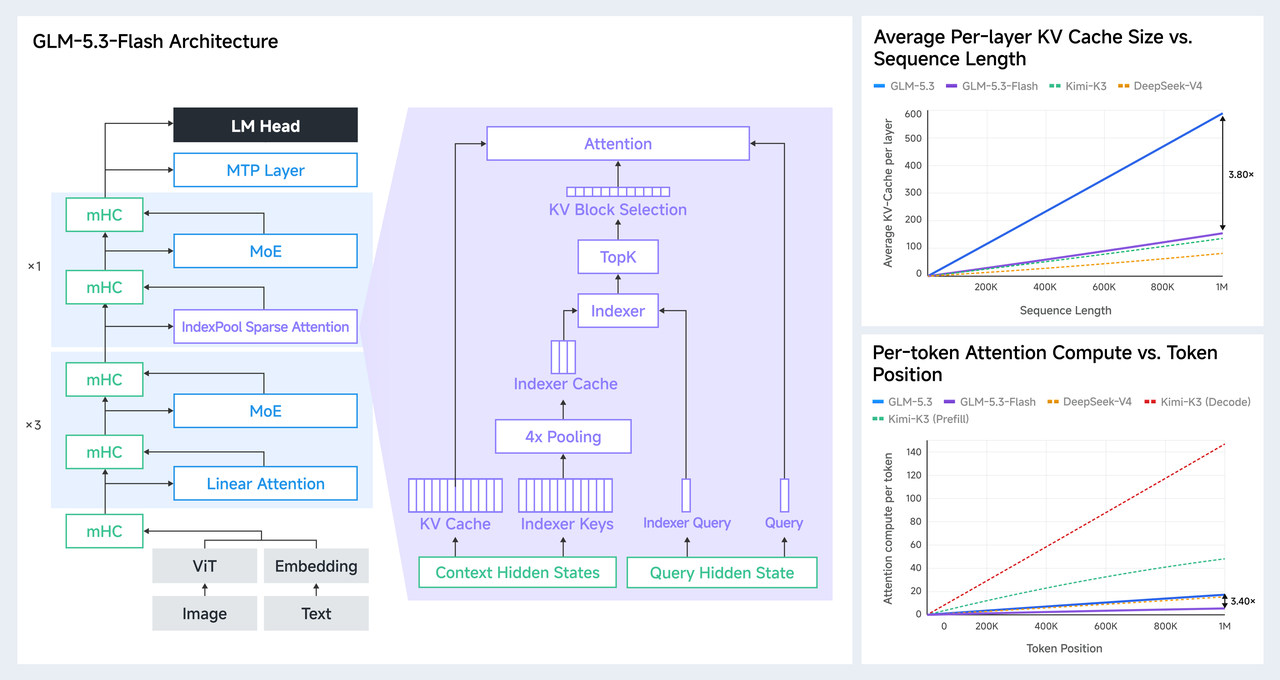
So sánh kiến trúc và hiệu năng GLM-5.3-Flash do Z.AI công bố
Bộ kết quả benchmark nào tạo nền cho GLM 6.0?
Chưa có bảng benchmark GLM 6.0 đã thẩm định nào được công bố. Thế hệ GLM hiện tại chỉ hữu ích như một nền tảng vì các đánh giá dưới đây đo lường lập kế hoạch, lập trình, sử dụng công cụ, tự động hóa và thực thi tầm nhìn dài—những năng lực liên quan nhất tới hướng Full Self-Training đã tiết lộ.
| Đánh giá chính thức của Z.AI | GLM-5.3-Flash | GLM-5.2 | Chênh lệch báo cáo |
|---|---|---|---|
| Terminal Bench 2.1 | 84.3 | 81.0 | +3.3 |
| DeepSWE v1.1 | 63.4 | 46.2 | +17.2 |
| NL2Repo | 56.3 | 48.9 | +7.4 |
| Toolathlon Verified | 78.4 | 59.9 | +18.5 |
| AutomationBench v1.0.6 | 48.8 | 26.2 | +22.6 |
| Agents’ Last Exam | 26.3 | 20.4 | +5.9 |
| HLE with Tools | 55.3 | 54.7 | +0.6 |
| GDPval-AA v2 | 1773 Elo | 1504 Elo | +269 Elo |
So sánh là đa chiều thay vì một hạng mục điểm duy nhất. GLM-5.3-Flash cho thấy mức tăng lớn nhất được báo cáo trên AutomationBench (+22,6), Toolathlon Verified (+18,5) và DeepSWE (+17,2), trong khi khác biệt HLE-with-Tools chỉ +0,6. Mẫu hình này gợi ý mức tăng mạnh hơn ở các tác vụ tác tử nặng thực thi so với mọi dạng suy luận hỗ trợ công cụ. Nó không dự đoán điểm số GLM 6.0.
Vì sao những benchmark này quan trọng
Benchmark chỉ quan trọng ở đây nếu chúng phơi bày những năng lực mà Full Self-Training hướng tới cải thiện. Sáu hạng mục trong bảng cho thấy một tiến trình từ tạo ra công việc đúng cho đến duy trì hành vi hiệu quả trong môi trường thực. Lập trình kiểm tra xem mô hình có thể thực thi một tác vụ phức tạp hay không; sử dụng công cụ kiểm tra liệu nó có thể chuyển một hành động thành phản hồi và chọn bước tiếp theo; và tự động hóa kiểm tra liệu nó có thể duy trì vòng lặp đó xuyên suốt một quy trình dài hay không.
| Hạng mục benchmark | Vì sao quan trọng với GLM-6.0 |
|---|---|
| Lập trình | Kiểm tra thực thi tác vụ phức tạp |
| Sử dụng công cụ | Kiểm tra vòng lặp hành động–phản hồi |
| Tự động hóa | Kiểm tra thực thi quy trình tầm nhìn dài |
| HLE | Kiểm tra giải bài toán phức tạp cấp chuyên gia |
| GDPval | Kiểm tra chất lượng công việc chuyên nghiệp |
| Đa phương thức | Kiểm tra việc dùng phản hồi thị giác |
Sau đó HLE nâng độ khó của các bài toán, GDPval hỏi liệu đầu ra có hữu ích trong công việc chuyên nghiệp hay không, và đánh giá đa phương thức kiểm tra liệu quan sát hình ảnh có thể dẫn dắt các hành động tiếp theo hay không. Đọc cùng nhau, sáu hạng mục chuyển từ năng lực cô lập sang hoàn thành tác vụ đầu-cuối: lập kế hoạch, hành động, quan sát phản hồi, sửa lỗi và tiếp tục cho đến khi đạt mục tiêu.
Vì vậy, một kết quả GLM-6.0 trong tương lai sẽ có ý nghĩa không phải vì nó tạo ra điểm tổng cao hơn, mà vì mức tăng trên nhiều chiều này cho thấy trải nghiệm huấn luyện tự sinh chuyển hóa thành khả năng thực thi đáng tin cậy trong thế giới thực. Mục tiêu cuối cùng của Full Self-Training không phải để cải thiện điểm kiểm tra, mà là để cải thiện khả năng của mô hình trong việc hoàn thành các tác vụ thế giới thực.
Vì sao Full Self-Training có thể quan trọng với GLM 6.0?
Điều hứa hẹn thực sự không phải là GLM 6.0 sẽ đơn giản “tự huấn luyện”. Thay đổi ý nghĩa hơn là các phần lớn hơn trong pipeline phát triển có thể trở nên do máy tạo ra và máy thẩm định. Ngày nay, các nhà nghiên cứu vẫn làm nhiều việc xung quanh mô hình: thu thập dữ liệu, thiết kế tác vụ, xây dựng bộ thẩm định, cấu trúc môi trường, chẩn đoán lỗi và tinh chỉnh phần mềm hệ thống. Full Self-Training đẩy mô hình tham gia vào nhiều giai đoạn hơn.
Nếu cách tiếp cận này hiệu quả, biến số mở rộng quan trọng sẽ ít nằm ở việc thêm bao nhiêu tham số và nhiều hơn ở việc có thể thực thi bao nhiêu vòng học hữu ích, đã thẩm định cho mỗi đơn vị tính toán. Đó là cách hiểu thực tiễn của cải thiện tự hồi quy, không phải phiên bản khoa học viễn tưởng về tự sửa đổi tự động không giới hạn.
Chiến lược được công bố nên được đánh giá như một hệ thống phản hồi được kỹ sư hóa với bộ thẩm định, môi trường có thể tái hiện, benchmark hạ tầng và kiểm soát của con người—không phải bằng chứng của tự cải thiện tự trị không giới hạn.
Điều gì có thể trục trặc với Full Self-Training?
Một vòng lặp tự huấn luyện có thể khuếch đại sai lầm nhanh chẳng kém khuếch đại trải nghiệm hữu ích. Bốn chế độ lỗi đặc biệt đáng chú ý:
- Khuếch đại lỗi: các quỹ đạo tổng hợp yếu có thể trở thành dữ liệu huấn luyện tương lai, cho phép các mẫu có vẻ hợp lý nhưng sai tăng cường lẫn nhau.
- Lách thưởng và đánh lừa bộ thẩm định: nếu cùng một hệ thống vừa tạo công việc vừa chấm điểm nó, hệ thống có thể tối ưu vào kẽ hở của bộ thẩm định thay vì thành công thực sự của tác vụ.
- Thu hẹp phân phối: học lặp đi lặp lại từ dữ liệu do mô hình tạo có thể giảm đa dạng và khiến các trường hợp hiếm trong thực tế khó xử lý hơn.
- Áp lực về chi phí, an ninh và quản trị: xây dựng môi trường, truy cập công cụ và lặp bền bỉ làm tăng nhu cầu tính toán và mở rộng bề mặt tấn công.
Vì vậy, một triển khai GLM-6.0 đáng tin cần có bộ thẩm định độc lập, nguồn gốc dữ liệu, ngưỡng chấp nhận, kiểm thử red-team, kiểm toán của con người và quy tắc dừng rõ ràng. Tự hiệu chỉnh chỉ hữu ích khi tín hiệu hiệu chỉnh đáng tin hơn hành vi đang được hiệu chỉnh.
Khi nào API GLM 6.0 có thể khả dụng?
Z.AI chưa công bố ngày phát hành API GLM 6.0, mã nhận diện mô hình, cửa sổ ngữ cảnh, đầu ra tối đa, giá token, cam kết mở trọng số hay yêu cầu triển khai. Bất kỳ giá trị cụ thể nào hiện tại đều là suy đoán.
Nhà phát triển có thể đánh giá hướng đi hiện tại thông qua GLM-5.3-Flash API trên CometAPI cho khối lượng công việc đa phương thức nguyên sinh và định hướng hiệu năng, GLM-5.3 API trên CometAPI cho nhánh flagship hiện tại, hoặc GLM-5.2 API trên CometAPI như nền so sánh thế hệ trước.
Kết luận
GLM-6.0 quan trọng không phải như một sản phẩm hứa hẹn mà như một phép thử xem Z.AI có thể biến Full Self-Training thành một hệ thống kỹ thuật có thể lặp lại hay không. Lộ trình kết nối trải nghiệm tự sinh, huấn luyện theo giai đoạn, tự đánh giá, hiệu chỉnh và lặp có kiểm soát; bằng chứng quyết định sẽ là liệu các cơ chế đó có cải thiện độ tin cậy trên các quy trình làm việc dài, sử dụng công cụ, thế giới thực hay không.
Bằng chứng đó vẫn chưa đầy đủ. Z.AI chưa công bố thẻ mô hình GLM-6.0, ngày phát hành, mã nhận diện API, giá hay bộ benchmark. Cho đến khi các tài liệu đó tồn tại, kết luận có cơ sở phải hẹp: công ty đã công bố một hướng huấn luyện, không phải một hồ sơ năng lực hoàn chỉnh.
Mục tiêu cuối cùng của Full Self-Training không phải để cải thiện điểm kiểm tra, mà là để cải thiện khả năng của mô hình trong việc hoàn thành các tác vụ thế giới thực.