
Tóm tắt
GPT-6 Astra đạt điểm tiêu đề xuất sắc; mức tăng lớn nhất xuất hiện khi suy luận phải chuyển hóa thành hành động: thao tác terminal, sử dụng phần mềm, tự động hóa, truy hồi trong ngữ cảnh dài, quy trình khoa học và an ninh mạng. Trên các bài kiểm tra học thuật đã gần bão hòa, mức cải thiện so với thế hệ OpenAI trước đó thường nhỏ hơn.
Mô hình kết hợp cửa sổ ngữ cảnh 1,050,000 token với hỗ trợ công cụ phong phú. Các benchmark thực thi do OpenAI công bố cho thấy nâng cấp thực tế mạnh nhất trong công việc có tầm nhìn dài; tuy nhiên thiết kế harness, mức nỗ lực suy luận, độ trễ và quyền truy cập công cụ ảnh hưởng đáng kể tới kết quả.
Điểm rút ra chính
- Lợi thế rõ ràng nhất của Astra nằm ở thực thi dạng tác nhân, không phải mọi hình thức hỏi–đáp.
- Kết quả Terminal-Bench, AutomationBench, computer-use và di trú cơ sở dữ liệu cho thấy mức dịch chuyển lớn hơn đáng kể so với GPQA hay DeepSWE.
- Kết quả ARC-AGI-3 chứng minh trạng thái mô hình, quản lý ngữ cảnh và harness đánh giá có thể chi phối điểm cuối cùng.
- Cửa sổ ngữ cảnh lớn chỉ có ý nghĩa khi thông tin vẫn truy hồi được gần ngưỡng; MRCR có giá trị thông tin hơn so với chỉ quảng bá về sức chứa.
- Giá token cao hơn không tự động đồng nghĩa với chi phí tác vụ cao hơn nếu mô hình cần ít token, ít lượt, ít thử lại hoặc ít sửa của con người.
- Quyết định triển khai nên so sánh đồng thời tỷ lệ thành công, thời gian trôi qua, tổng chi phí, độ tin cậy công cụ và gánh nặng chỉnh sửa.
Tổng quan nhanh về GPT-6 Astra
OpenAI chỉ định tối đa 128,000 token đầu ra, đầu vào văn bản và hình ảnh, đầu ra văn bản, và mức nỗ lực suy luận từ thấp tới tối đa. Các thông số này cho phép quy trình lớn, nhiều bước; nhưng chúng không chứng minh mô hình sẽ truy hồi đúng bằng chứng hay hoàn thành tác vụ một cách đáng tin cậy.
| Thông số chính thức | GPT-6 Astra trong CometAPI | Ý nghĩa thực tiễn |
|---|---|---|
| Model ID | gpt-6-astra | Định danh ổn định dùng định tuyến API |
| Context window | 1,050,000 tokens | Hỗ trợ kho lớn, lưu trữ và lịch sử tác nhân |
| Maximum output | 128,000 tokens | Cho phép báo cáo, bản vá và tạo phẩm có cấu trúc lớn |
| Knowledge cutoff | April 30, 2026 | Sự kiện sau đó cần công cụ hoặc nguồn cung cấp |
| Input | Text and images | Hỗ trợ tài liệu, ảnh chụp màn hình, sơ đồ và chứng cứ hỗn hợp |
| Output | Text | Sản sinh văn bản, mã và văn bản có cấu trúc |
| Reasoning effort | low, medium, high, xhigh, max | Đánh đổi độ trễ và chi phí để tìm kiếm sâu hơn |
| Agent capabilities | Function calling, structured outputs, computer use, web/file search, hosted shell, Apply Patch, MCP | Cho phép quy trình đầu-cuối thay vì câu trả lời đơn lẻ |
| OpenAI Standard input | $10 per million tokens | Kích thước đầu vào và tái sử dụng bộ nhớ đệm ảnh hưởng tổng chi |
| OpenAI cached input | $1 per million tokens | Áp dụng khi tiền tố prompt được dùng lại từ cache |
| OpenAI cache writes | $12.50 per million tokens | Tính phí ở mức 1.25× so với đầu vào không cache |
| OpenAI Standard output | $50 per million tokens | Đầu ra dài có thể chi phối chi phí tác vụ |
| Requests above 272K input tokens | Input and cache rates ×2; output rate ×1.5 | Mức giá cao hơn áp dụng cho toàn bộ yêu cầu |
Giới hạn ngữ cảnh đo sức chứa, không đo khả năng ghi nhớ hữu dụng. Danh sách công cụ đo tính sẵn có, không đo khả năng thực thi thành công. Cần benchmark để kiểm chứng các thông số đó có chuyển hóa thành công việc hoàn thành hay không.
Các kết quả benchmark của GPT-6 Astra cho thấy điều gì?
Danh mục kết quả thể hiện một mẫu hình không đồng đều. Astra chỉ nhích nhẹ so với Sol trên một số bài kiểm tra học thuật và lý luận phần mềm, nhưng lại tăng hai chữ số ở công việc terminal, tự động hóa, di trú cơ sở dữ liệu, tương tác thị giác, truy hồi ngữ cảnh dài và toán học nâng cao.
| Benchmark đã công bố | GPT-6 Astra | GPT-5.6 Sol | Claude Fable 5.1 | Astra so với Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 57.9% | 37.3% | 55.8% | +20.6 pp |
| DeepSWE v1.1 | 74.1% | 72.7% | 67.4% | +1.4 pp |
| Database Migration Tasks | 63.9% | 42.7% | 57.8% | +21.2 pp |
| OSWorld 2.0 | 72.6% | 65.7% | — | +6.9 pp |
| ScreenSpot-Pro | 92.7% | 76.9% | — | +15.8 pp |
| AutomationBench | 41.4% | 18.1% | 31.4% | +23.3 pp |
| BenchCAD | 95.9% | 83.3% | 84.3% | +12.6 pp |
| FrontierMath Tier 4 v2 | 97.6% | 83.0% | 87.8% | +14.6 pp |
| GPQA Diamond | 96.0% | 94.6% | 93.7% | +1.4 pp |
| MRCR v2, 512K–1M | 96.3% | 73.8% | — | +22.5 pp |
| AA Intelligence Index v4.1.1 | 61.2 | 60.9 | 65.7 | +0.3 |
| ARC-AGI-3, Provider Adapter | 99.9% | 7.8% | — | +92.1 pp |
Ba cụm nổi lên. Thứ nhất, các khoảng cách 1.4 điểm ở DeepSWE và GPQA chỉ ra mức dịch chuyển hạn chế trên các tác vụ nơi mô hình mạnh đã làm tốt. Thứ hai, mức tăng trên 20 điểm ở Terminal-Bench, AutomationBench, di trú cơ sở dữ liệu và truy hồi hàng triệu token cho thấy thay đổi thực thi lớn hơn nhiều. Thứ ba, ARC-AGI-3 là ngoại lệ mà cách diễn giải phụ thuộc vào harness.
Kết quả thử nghiệm độc lập
Artificial Analysis báo cáo Astra và Sol đều khoảng 61 trên Intelligence Index, đồng thời cho thấy mức tăng rõ rệt hơn trên Coding Agent Index. Điều này độc lập củng cố mẫu hình từ dữ liệu của OpenAI: cải thiện lớn nhất tập trung ở thực thi dạng tác nhân.
Ở mức nỗ lực tối đa trong harness Codex, Astra được cho là dùng khoảng một phần ba số token so với Sol trên Coding Agent Index. Mức dùng token trên Intelligence Index chỉ giảm khoảng 10%. Vì mức giá mỗi token của Astra cao hơn, hai hồ sơ hiệu suất này tạo ra kinh tế học khác nhau.
| Đánh giá độc lập | Kết quả quan sát | Diễn giải cho sản xuất |
|---|---|---|
| Intelligence Index | Ít tách biệt khỏi Sol | Lý luận chung có thể không biện minh mức giá cao |
| Coding Agent Index | Cải thiện tác nhân rõ ràng | Ít token có thể bù mức giá mỗi token cao |
| AA-Omniscience | Tỉ lệ ảo tưởng giảm từ 92% xuống 51% ở nỗ lực tối đa | Tự kiềm chế tốt hơn có thể quan trọng với hệ nghiên cứu/truy hồi |
| Công việc tri thức dài hạn | Tiến bộ lẫn lộn giữa các tác vụ | Cần đánh giá nội bộ tại chỗ |
Không có benchmark độc lập nào chứng nhận tính đúng sự thật hoặc an toàn trong sản xuất. Các nhóm nên chấm điểm riêng câu trả lời đúng, sự không chắc chắn có cơ sở, tuyên bố không có bằng chứng và các lỗi không tuân theo ràng buộc nguồn.
Vì sao Astra phù hợp hơn với công việc tác nhân có tầm nhìn dài?
GPT-6 Astra bổ sung ba điều khiển được thiết kế cho công việc thay đổi trong khi chạy. Độ tin cậy chạy dài cũng phụ thuộc vào toàn bộ hệ thống ngữ cảnh: cửa sổ ngữ cảnh đặt sức chứa; nén kiểm soát cách cô đọng tài liệu cũ; suy luận được lưu giữ mang theo trạng thái mô hình liên quan; truy hồi giữ cho bằng chứng trước đó có thể tìm kiếm; và ứng dụng phải bảo tồn đầu ra công cụ quan trọng, kết quả kiểm thử, phương án thất bại và yêu cầu người dùng. Các cơ chế này nên được kiểm thử cùng với harness tác nhân.
- Gọi công cụ bất đồng bộ: Astra có thể tiếp tục suy luận độc lập hoặc gọi công cụ khác trong khi ứng dụng đang thực thi một công cụ chạy lâu.
- Điều khiển giữa lượt: ứng dụng có thể gửi một chỉnh sửa hoặc yêu cầu mới qua WebSocket mà không hủy bỏ phần công việc đã hoàn thành.
- Điều chỉnh suy luận giữa cuộc hội thoại: một cập nhật cấu hình có thể tăng hoặc giảm nỗ lực suy luận trong khi vẫn giữ tiền tố prompt đã cache.
Nơi GPT-6 Astra thực sự cải thiện
Lập trình tác nhân: Công việc terminal là nâng cấp lớn hơn
Terminal-Bench 4.0 đánh giá liệu tác nhân có thể làm việc qua các tác vụ terminal khó, thay vì chỉ tạo ra một câu trả lời mã đơn lẻ. Astra đạt 57.9%, cao hơn Sol 20.6 điểm phần trăm và Fable 2.1 điểm. Đây là cải thiện đáng kể giữa các thế hệ cho OpenAI, nhưng lợi thế hẹp hơn nhiều so với một hệ tác nhân đầu bảng khác.
DeepSWE cho câu chuyện khác: 74.1% cho Astra và 72.7% cho Sol. Khoảng cách 1.4 điểm cảnh báo không nên khái quát từ một benchmark lập trình. Astra có vẻ tăng nhiều nhất khi lập trình đòi hỏi tương tác môi trường, lặp, lưu trạng thái và kiểm chứng.
Database Migration Tasks củng cố diễn giải đó. Kết quả 63.9% cao hơn Sol 21.2 điểm và Fable 6.1 điểm. Công việc di trú kết hợp hiểu mã, dùng công cụ, xếp chuỗi và phán đoán vận hành—loại quy trình tổng hợp nơi các cải thiện suy luận nhỏ có thể tích tụ thành mức tăng hoàn thành lớn hơn.
Với tác nhân lập trình, hãy đánh giá cả mô hình lẫn harness. Hướng dẫn kho, công cụ terminal, hành vi thử lại, bảo tồn ngữ cảnh và thực thi kiểm thử đều góp phần vào kết quả đo được.
Sử dụng máy tính: Tỉ lệ thành công và thời gian chạy đều quan trọng
Trên Agents’ Last Exam, GPT-6 Astra đạt 59.3%, so với 53.6% của GPT-5.6 Sol: tăng 5.7 điểm phần trăm. Điều này bổ sung một kết quả tác vụ tác nhân rộng hơn vào các điểm OSWorld 2.0 và ScreenSpot-Pro trong tổng quan benchmark phía trên.
Ngoài độ chính xác, so sánh thời gian chạy OSWorld thêm một chiều thực tế: OpenAI báo cáo khoảng 40 phút mỗi tác vụ cho Astra so với khoảng 75 phút cho Sol, tức giảm khoảng 47% thời gian trôi qua đồng thời tăng tỉ lệ thành công.
Một tác nhân thành công nhỉnh hơn và kết thúc nhanh hơn nhiều có thể mang lại cải thiện thông lượng lớn. Do đó, thử nghiệm mua sắm nên báo cáo tỉ lệ thành công, thời gian trôi qua, số lần gọi công cụ, số lần thử lại và can thiệp của con người—không chỉ độ chính xác.
Tự động hóa và công việc chuyên môn
AutomationBench tăng từ 18.1% lên 41.4%, mức tăng 23.3 điểm. Điểm tuyệt đối vẫn còn xa độ tự động đáng tin cậy, nhưng thay đổi hồ sơ lỗi có ý nghĩa hơn một bước nhích gần bão hòa. Trên BenchCAD, Astra đạt 95.9%, dẫn Sol 12.6 điểm và Fable 11.6 điểm.
Các kết quả này ủng hộ một tuyên bố cụ thể: Astra giỏi hơn trong chuyển chỉ dẫn thành chuỗi hành động được kiểm chứng. Chúng không chứng minh mức tăng ngang nhau cho mọi quy trình kinh doanh. Quy trình sản xuất có thể đưa vào bước xác thực, giao diện độc quyền, chính sách mơ hồ hoặc định dạng dữ liệu không có trong benchmark.
Khoa học
Khoa học là một trong những mức năng lực rõ rệt nhất của Astra. Trên FrontierMath Tier 4 v2, Astra đạt 97.6%, so với 83.0% của Sol và 87.8% của Fable. Mức dẫn 14.6 điểm trước Sol là đáng kể, dù benchmark bao phủ phân phối tác vụ chọn lọc chứ không phải toàn bộ quy trình khoa học.
An ninh mạng
An ninh mạng là mức tăng lớn thứ hai, với rủi ro cao hơn so với sự dịch chuyển bình thường trên bảng xếp hạng. Trên ExploitBench từ tháng 6 đến tháng 8 năm 2026, Astra đạt 39.0% so với 5.5% của Sol. OpenAI báo cáo bộ đánh giá mới hơn này nhắm vào các lỗ hổng từ ba tháng trước, nhằm giảm phơi nhiễm lịch sử. Trong đánh giá an ninh mạng của OpenAI, Astra thể hiện khả năng phát hiện và khai thác hai lỗ hổng zero-day chưa được biết đến trước đó trong thử nghiệm có kiểm soát. Điều này quan trọng vì đánh giá được thiết kế xoay quanh lỗ hổng mới công bố thay vì vấn đề bảo mật đã biết từ lâu, giảm khả năng hiệu suất benchmark chỉ do ví dụ đã ghi nhớ. Kết quả góp phần giúp Astra đạt ngưỡng năng lực an ninh mạng Critical của OpenAI và do đó thay đổi biện pháp bảo vệ yêu cầu cho triển khai. Ý nghĩa không phải là Astra có thể tự động tiến hành hoạt động an ninh mạng không hạn chế, mà là mức năng lực của nó thay đổi yêu cầu về biện pháp bảo vệ khi triển khai. Hệ thống có khả năng phát hiện và khai thác lỗ hổng mạnh hơn đòi hỏi kiểm soát truy cập chặt chẽ hơn, giám sát, sandbox và cơ chế rà soát của con người.
Nhiệm vụ chạy dài: Cửa sổ ngữ cảnh không phải toàn bộ câu chuyện
Cửa sổ ngữ cảnh 1,050,000 token của Astra mô tả sức chứa, không phải tính liên tục. Hiệu suất chạy dài còn phụ thuộc vào nén, trạng thái lưu giữ, khả năng tìm kiếm ngữ cảnh trước đó, trạng thái suy luận được giữ lại và bảo tồn đầu ra công cụ. Ở MRCR v2, Astra đạt 100.0% ở 256K–512K và 96.3% ở 512K–1M, trong khi Sol ghi 91.5% và 73.8%. Khoảng cách 22.5 điểm ở phạm vi dài nhất cho thấy truy hồi hữu dụng gần ngưỡng quan trọng hơn con số sức chứa được quảng bá.
MRCR vẫn là kiểm tra truy hồi tổng hợp, vì vậy đánh giá sản xuất nên bảo tồn bằng chứng mà tóm tắt thường bỏ sót: vì sao bản sửa trước thất bại, hành vi của một thành phần cụ thể, kết quả kiểm thử, yêu cầu lịch sử và chi tiết chôn trong đầu ra công cụ. Kho chứa và tư liệu nghiên cứu cũng nên được kiểm thử với tên trùng, tham chiếu chéo, chính sách cũ, nguồn mâu thuẫn và dải gây nhiễu dài. Điều này phân biệt sức chứa ngữ cảnh thô với hành vi bảo tồn và truy hồi ngữ cảnh mà một tác nhân tầm nhìn dài thực sự cần.
Bảo tồn ngữ cảnh: vì sao Astra khác với hệ thống ngữ cảnh dài truyền thống
Các quy trình ngữ cảnh dài truyền thống thường theo mẫu:
context → compaction → summary → continue
Cách tiếp cận này giảm dùng token, nhưng đem lại rủi ro quan trọng: thông tin trung gian quan trọng có thể biến mất khi tóm tắt.
Thông tin mất thường không phải câu trả lời cuối cùng, mà là chi tiết vận hành cần cho quyết định tương lai:
- vì sao bản sửa trước thất bại;
- thành phần nào thể hiện hành vi bất thường;
- kết quả kiểm thử nào đã thay đổi hướng triển khai;
- yêu cầu người dùng nào được thêm sau đó;
- đầu ra công cụ nào chứa bằng chứng quan trọng.
GPT-6 Astra giải quyết hạn chế này bằng cách kết hợp cơ chế bảo tồn ngữ cảnh và truy hồi bên trong quy trình tác nhân chạy dài.
Thay vì chỉ dựa vào tóm tắt nén, hệ thống có thể giữ ghi chú quan trọng, truy hồi thông tin trước đó khi cần, và duy trì tính liên tục giữa nhiều tương tác công cụ.
Với tác nhân lập trình như Codex, điều này có nghĩa một tác vụ gỡ lỗi dài có thể giữ lại:
- các thử nghiệm thất bại trước đó;
- thay đổi trong kho;
- đầu ra kiểm thử;
- quyết định kiến trúc;
- vấn đề chưa giải quyết.
Vì vậy, giá trị của cửa sổ ngữ cảnh 1M token của Astra không chỉ là lượng thông tin nó có thể nhận, mà còn là liệu hệ thống có thể bảo tồn và phục hồi thông tin đúng sau hàng giờ tương tác hay không.
Lý luận và diễn giải
ARC-AGI-3: Bộ khung là một phần của kết quả
ARC-AGI-3 cung cấp minh chứng rõ nhất rằng một benchmark tuyến đầu có thể đo một hệ thống chứ không phải mô hình đơn lẻ. ARC Prize báo cáo 62.7% với Standard harness ở nỗ lực tối đa và 99.9% với Provider Adapter ở nỗ lực cao.
| Đánh giá ARC Prize | Standard Harness | Provider Adapter | Mức tăng nhờ Adapter |
|---|---|---|---|
| max | 62.7% | 98.6% | +35.9 pp |
| xhigh | 59.3% | 98.4% | +39.1 pp |
| high | 54.8% | 99.9% | +45.1 pp |
| medium | 38.6% | 98.4% | +59.8 pp |
| low | 17.5% | 98.0% | +80.5 pp |
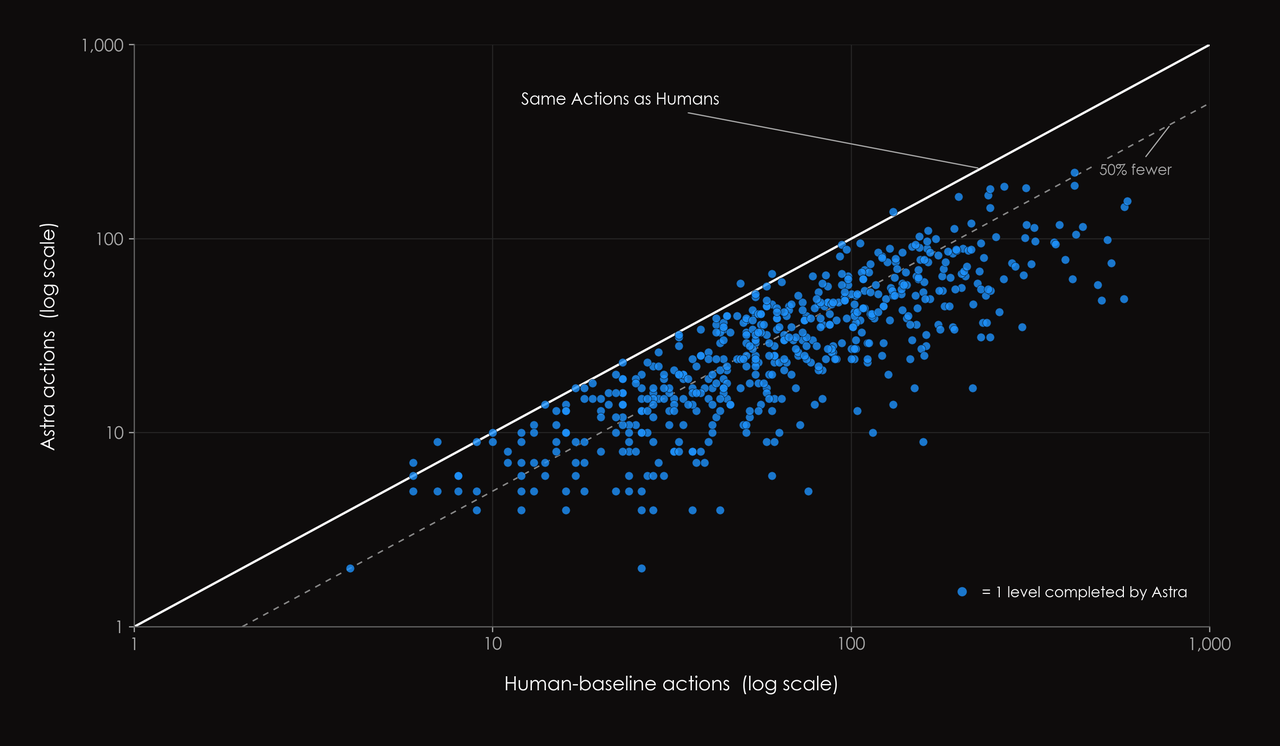
So sánh của ARC Prize về hiệu suất hành động của Astra giữa các harness đánh giá
Chính sách harness trung lập nhà cung cấp yêu cầu mô hình bảo tồn thông tin quan trọng trong trạng thái hiển thị. Provider Adapter giữ thêm trạng thái suy luận và sử dụng quản lý ngữ cảnh đặc thù nhà cung cấp. Trên các cặp trò chơi–lý luận được giải chung, ARC Prize báo cáo tốc độ thực thi nhanh hơn 3.66× và ít hơn 49% tổng token với adapter.
Kết quả 99.9% đo một hệ thống mô hình–adapter–nhà cung cấp cụ thể và không nên được xem như thước đo độc lập khỏi harness về trí tuệ thô của mô hình. Kiến trúc ngữ cảnh là một phần của hệ thống được benchmark.
Nỗ lực lý luận không tỷ lệ tuyến tính
Bảng ARC cũng cho thấy nỗ lực tối đa không phải lúc nào cũng cho điểm cao nhất. Nỗ lực cao đạt 99.9% với Provider Adapter, trong khi tối đa đạt 98.6%. Trong Standard harness, mức tối đa lại tốt nhất.
OpenAI lưu ý rằng các con số trong bảng phát hành thường dùng mức nỗ lực suy luận tốt quan sát được. Cách này ước lượng trần hiệu suất, nhưng không xác định cấu hình sản xuất tối ưu. Các đội nên thử nhiều mức nỗ lực và tính chất lượng biên thu được cho mỗi giây và đô la tăng thêm.
Toán học và lý luận học thuật
FrontierMath Tier 4 v2 tăng từ 83.0% lên 97.6%, mức tăng 14.6 điểm. Đây là cải thiện benchmark lớn, nhưng không phải bằng chứng rằng toán học tuyến đầu đã được giải quyết. Đánh giá bao phủ phân phối tác vụ chọn lọc và không đo mọi giai đoạn nghiên cứu toán học, gồm chọn vấn đề, kiểm chứng chứng minh hình thức, phát triển chương trình dài hạn hay phản biện đối kháng.
GPQA Diamond cho mẫu ngược lại: 96.0% cho Astra, 94.6% cho Sol, 93.7% cho Fable và 95.3% cho Gemini 3.8 Flash. Các mô hình tụ lại gần trần. Báo cáo chênh lệch 1.4 điểm giữa Astra–Sol là chính xác, nhưng gọi đó là cuộc cách mạng trí tuệ rộng sẽ thổi phồng bằng chứng.
Năng lực ở mức độ nghiêm trọng + biện pháp bảo vệ
| Đánh giá an ninh mạng | Astra | Sol | Mức tăng tuyệt đối |
|---|---|---|---|
| ExploitBench | 100.0% | 78.5% | +21.5 pp |
| ExploitGym | 42.4% | 30.3% | +12.1 pp |
| ExploitBench, June–August 2026 | 39.0% | 5.5% | +33.5 pp |
| SRE-Bench | 88.0% | 55.9% | +32.1 pp |
| SEC-Bench Pro | 85.4% | 79.1% | +6.3 pp |
OpenAI tạo ExploitBench (June–August 2026) từ các lỗ hổng được công bố trong ba tháng trước, giảm khả năng phơi nhiễm lịch sử thổi phồng kết quả. Astra đạt 39.0% trên bộ này so với 5.5% của Sol, và OpenAI báo cáo Astra đã tìm và khai thác hai lỗ hổng zero-day chưa biết trước đó. Các kết quả này góp phần giúp Astra trở thành mô hình đầu tiên được triển khai rộng rãi của OpenAI đạt ngưỡng năng lực an ninh mạng Critical, trực tiếp ảnh hưởng các biện pháp bảo vệ và chính sách truy cập.
Cách diễn giải điểm gần bão hòa
Điểm trên 90% cần ngôn ngữ cẩn trọng hơn so với kết quả trung bình. Tăng từ 50% lên 60% giải thêm mười tác vụ trên mỗi trăm. Tăng từ 95% lên 96% chỉ giải thêm một tác vụ trên mỗi trăm, dù nó giảm số lỗi còn lại từ năm xuống bốn—giảm 20% lỗi. Cả hai mô tả đều đúng về mặt toán học, nhưng chúng hỗ trợ tiêu đề rất khác nhau.
Cảnh báo ngược lại áp dụng cho benchmark điểm thấp. Tăng từ 18.1% lên 41.4% vẫn còn xa vận hành tự chủ đáng tin cậy, nhưng nó hơn gấp đôi số ca thành công và có thể chuyển hóa một quy trình giám sát. Điểm tuyệt đối quyết định hệ thống đã sẵn sàng hay chưa; kích thước cải thiện cho biết tốc độ thay đổi năng lực. Quyết định sản xuất cần cả hai.
So sánh đa chiều
| Chiều so sánh | Astra | Sol | Fable | Tín hiệu quyết định |
|---|---|---|---|---|
| Lý luận học thuật chung | Xuất sắc; thường gần bão hòa | Bám sát | Cạnh tranh | Khoảng cách nhỏ hiếm khi quyết định triển khai |
| Thực thi terminal | Hàng đầu | Khoảng cách lớn giữa thế hệ | Đối thủ sát | Kiểm thử toàn bộ harness lập trình |
| Sử dụng máy tính | Tỉ lệ thành công cao và runtime thấp | Chậm hơn và kém chính xác hơn | Thiếu dữ liệu so sánh tương xứng trong bảng phát hành | Đo điểm thành công theo giờ |
| Truy hồi ngữ cảnh dài | Mạnh gần 1M token | Suy giảm đáng kể gần ngưỡng | Thiếu dữ liệu so sánh trực tiếp | Dùng bài kiểm thử truy hồi theo hình sản xuất |
| Điều khiển suy luận | low tới max | Dải nỗ lực khác | Tiếp cận tư duy thích ứng | Tinh chỉnh cấu hình, không chỉ tên mô hình |
| Năng lực an ninh | Rủi ro ở bậc cao hơn về chất lượng | Kết quả công bố thấp hơn | Không so sánh ở đây | Biện pháp bảo vệ và chính sách truy cập quan trọng |
| Kinh tế token | Mức giá cao; đôi lúc ít token hơn | Mức giá thấp hơn | Phụ thuộc khối lượng công việc | So sánh chi phí cho mỗi tác vụ thành công |
Kết quả phụ thuộc khối lượng công việc. Astra thuyết phục nhất khi tác vụ đòi hỏi tương tác bền bỉ với công cụ và môi trường, phục hồi sau thất bại hoặc truy hồi đáng tin cậy trên ngữ cảnh rất lớn. Sol có thể vẫn kinh tế hơn cho công việc giới hạn với ngữ cảnh vừa phải và ít lặp. Fable là đối thủ sát trên công việc terminal và dẫn một số đánh giá học thuật bên ngoài, vì vậy một benchmark cấp ứng dụng hữu ích hơn kết luận cấp nhà cung cấp.
Ai nên dùng GPT-6 Astra?
| Trường hợp sử dụng | Khuyến nghị |
|---|---|
| Phân loại đơn giản | Không nhất thiết cần Astra |
| Tóm tắt đơn giản | Không nhất thiết cần Astra |
| RAG tiêu chuẩn | Benchmark chi phí so với hiệu suất trước |
| Tổng hợp & phân tích tài liệu dài | Đáng thử với Astra |
| Lập trình tác nhân | Rất nên thử nghiệm |
| Sử dụng máy tính | Rất nên thử nghiệm |
| Tự động hóa nhiều bước | Rất nên thử nghiệm |
| Nghiên cứu phức tạp | Đáng thử |
| Tính toán khoa học / phần mềm chuyên biệt | Đáng thử |
| An ninh mạng | Năng lực mạnh, nhưng cần biện pháp an toàn phù hợp |
| Tác vụ đơn giản thông lượng cao | Mô hình chi phí thấp có thể hiệu quả hơn |
Các cải thiện hiệu năng của GPT-6 Astra có xứng với mức giá cao hơn?
GPT-6 Astra đắt hơn đáng kể so với GPT-5.6 Sol, nhưng cải thiện benchmark không phân bố đều trên các khối lượng công việc. Vì vậy câu hỏi về giá không thể trả lời bằng so sánh mức giá token đơn thuần.
| Kịch bản | Mức cải thiện hiệu năng | Biện minh chi phí |
|---|---|---|
| Hỏi–đáp đơn giản | Cải thiện nhỏ | Thường không đáng mức giá |
| Tác nhân lập trình | Cải thiện lớn | Có thể biện minh mức giá |
| Phân tích ngữ cảnh dài | Cải thiện đáng kể | Phụ thuộc nhu cầu truy hồi |
| Tự động hóa máy tính | Cải thiện mạnh | Thường đáng thử nghiệm |
| Lý luận chung | Cải thiện hạn chế | So sánh chi phí cẩn trọng |
Ở mức OpenAI Standard, GPT-6 Astra có giá $10 mỗi triệu token đầu vào, $1 mỗi triệu token đầu vào dùng cache, $12.50 mỗi triệu token ghi cache, và $50 mỗi triệu token đầu ra. Đầu vào và đầu ra Standard tương ứng là 2.5× so với mức $4 và $20 của GPT-5.6 Sol. Khi một yêu cầu vượt quá 272K token đầu vào, mức giá đầu vào và cache của Astra tăng gấp đôi và mức giá đầu ra tăng 1.5× cho toàn bộ yêu cầu.
Phần chênh giá phù hợp rõ ràng nhất với công việc tác nhân. Astra tăng hơn 20 điểm phần trăm trên Terminal-Bench, AutomationBench, di trú cơ sở dữ liệu và MRCR dài nhất; thử nghiệm độc lập cũng báo cáo dùng khoảng một phần ba token so với Sol trên Coding Agent Index. Sự tương hợp yếu hơn ở lý luận rộng, nơi Intelligence Index gần như hòa và mức dùng token chỉ giảm khoảng 10%. Do đó, quyết định mua nên so sánh chi phí cho mỗi tác vụ thành công, bao gồm đầu ra, hoạt động cache, dùng công cụ, thời gian trôi qua, thử lại, lỗi và chỉnh sửa của con người.
Chi phí cho mỗi tác vụ thành công
Chi phí cho mỗi tác vụ thành công = (Chi phí đầu vào + Chi phí đầu ra + Chi phí công cụ + Chi phí thử lại + Chi phí rà soát của con người) / Số tác vụ thành công
Chi phí kinh doanh kỳ vọng
Chi phí kinh doanh kỳ vọng = Chi phí API + Chi phí công cụ + Chi phí thử lại + Chi phí rà soát của con người + Chi phí thất bại
Chỉ số quyết định nên là tổng chi phí chia cho số tác vụ thành công, đánh giá ở ngưỡng chất lượng chấp nhận được—không phải mức giá niêm yết mỗi triệu token.
Nhà phát triển nên benchmark Astra như thế nào
Bảng xếp hạng công khai nên xác định cái gì đáng thử nghiệm, không đưa ra quyết định triển khai cuối cùng. Xây dựng bộ tác vụ đại diện với ca thường, ca khó, ca thiếu ngữ cảnh, lỗi công cụ và chỉ dẫn đối kháng. Dùng cùng prompt sản xuất, quyền hạn, tệp nguồn, ngân sách thời gian và tiêu chí hoàn thành cho mọi mô hình.
| Chiều đánh giá | Cách đo | Vì sao quan trọng |
|---|---|---|
| Thành công tác vụ | Tiêu chí chấp nhận được vượt qua | Ngăn câu trả lời thuyết phục nhưng chưa hoàn chỉnh được tính là thành công |
| Độ tin cậy | Phân phối thành công qua các lần chạy lặp | Phơi bày chiến thắng đơn lẻ không ổn định |
| Thực thi công cụ | Hành động thành công đã kiểm chứng | Phân biệt gọi công cụ với kết quả đúng |
| Tính đúng sự thật | Tuyên bố có bằng chứng hỗ trợ | Đo chất lượng bằng chứng và sự tự kiềm chế |
| Độ trễ | Thời gian hoàn thành trung vị và đuôi | Nắm bắt thông lượng vận hành |
| Chi phí | Tổng chi phí cho mỗi tác vụ thành công | Bao gồm thử lại và nỗ lực thất bại |
| Công sức con người | Số phút chỉnh sửa và rà soát | Thường chi phối chi phí triển khai thực tế |
| Khả năng điều khiển | Phục hồi sau khi yêu cầu thay đổi | Kiểm thử hành vi tác nhân chạy dài |
API Astra trong CometAPI dùng ID mô hình gpt-6-astra. API đa mô hình giúp chạy cùng đánh giá trên Astra, Sol, Fable và Gemini mà không cần thiết kế lại benchmark xoay quanh bảng tiêu đề của một nhà cung cấp. Tuyến các tác vụ tác nhân đòi hỏi khắt khe tới mô hình xứng đáng với mức giá, và dùng mô hình chi phí thấp hơn ở nơi lợi thế đo được biến mất.
Kết luận
Tờ điểm benchmark của Astra ấn tượng, nhưng các điểm số ngoạn mục nhất không tự động là hữu dụng nhất. ARC-AGI-3 chứng minh tiềm năng của harness tác nhân đặc thù nhà cung cấp; điểm với Standard harness cho thấy hạ tầng đóng góp mạnh. GPQA và Intelligence Index độc lập cho thấy mức tăng lý luận bình thường có thể khiêm tốn. Công việc terminal, tự động hóa, sử dụng máy tính, truy hồi ngữ cảnh dài, quy trình khoa học và an ninh mạng mới là câu chuyện quan trọng hơn.
Bản phát hành nói ít về việc chatbot trở nên thông minh hơn theo tỷ lệ ở mọi câu hỏi, và nói nhiều hơn về việc trí tuệ tuyến đầu trở nên giỏi hơn trong hoàn thành công việc. Giá trị của nâng cấp đó có đáng trả tiền hay không phụ thuộc vào toàn bộ cấu hình hệ mô hình và kinh tế của các tác vụ sản xuất thành công.