
TL;DR
Brug GPT-5.6 Sol til rutineopgaver; vælg GPT-6 Astra til komplekse agenter, når færre gentagelser opvejer den højere tokenpris.
GPT-6 Astra er den stærkere model til svær end-to-end-udførelse, mens GPT-5.6 Sol forbliver det mere økonomiske standardvalg til mange produktionsarbejdsbelastninger. Det reelle valg er ikke “hvilken model er nyest?”, men “hvilken model leverer den laveste pris pr. accepteret opgave?”
OpenAI’s GPT-6 Astra erstatter ikke GPT-5.6 Sol i den simple forstand “nyere model betyder bedre model til alt.” Begge modeller tilbyder et kontekstvindue på 1,05 millioner tokens og 128K maksimalt output, accepterer tekst- og billedinput, understøtter ræsonnering og fungerer med moderne værktøjsdrevne API-workflows.
GPT-6 Astra API i CometAPI er optimeret til svær end-to-end-udførelse: computerbrug, terminalarbejde, software engineering, forskning, videnskab og multi-værktøjsagenter. GPT-5.6 Sol API i CometAPI forbliver en yderst kapabel flagskibsmodel med en væsentligt lavere tokenpris.
Den praktiske forskel handler derfor mindre om, hvor meget kontekst hver model kan acceptere, og mere om, hvor pålideligt og effektivt den kan omsætte den kontekst til færdigt arbejde.
GPT-6 Astra vs GPT-5.6 Sol: Kort overblik
OpenAI angiver samme kontekstvindue på 1.050.000 tokens og maksimalt output på 128.000 tokens for begge modeller. De meningsfulde specifikationsforskelle er Astras senere vidensgrænse, manglen på en none-ræsonneringstilstand, højere prissætning og nyere kontroller designet til langvarige agenter.
| Specifikation | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|
| Udvikler | OpenAI | OpenAI |
| Positionering | Sværeste end-to-end-arbejde | Komplekst professionelt arbejde |
| Officiel model-ID | gpt-6-astra | gpt-5.6-sol (gpt-5.6 alias ruter til Sol) |
| Kontekstvindue | 1.050.000 tokens | 1.050.000 tokens |
| Maksimalt output | 128.000 tokens | 128.000 tokens |
| Vidensgrænse | 30. apr. 2026 | 16. feb. 2026 |
| Inputmodaliteter | Tekst, billede | Tekst, billede |
| Outputmodalitet | Tekst | Tekst |
| Ræsonneringsindsats | low, medium, high, xhigh, max | none, low, medium, high, xhigh, max |
| Computerbrug | Understøttet | Understøttet |
| Finjustering | Ikke understøttet | Ikke understøttet |
| OpenAI input / 1M | $10 | $4 |
| OpenAI output / 1M | $50 | $20 |
Ved første øjekast kan dette få Astra til at ligne Sol til 2,5 gange prisen. Benchmarkmønstret fortæller en mere nyttig historie: Astras største gevinster opstår, når en model skal udføre, ikke blot svare.
Hvad er GPT-6 Astra?
GPT-6 Astra er OpenAI’s nye flagskib til sine sværeste end-to-end-arbejdsbelastninger, med vægt på kompleks ræsonnering, kodning, computerbrug, forskning, dokumentudarbejdelse og værktøjsrige workflows.
CometAPI har allerede en dedikeret Astra-oversigt, der dækker modellens specifikationer, priser, benchmarktabeller og API-grundlag. Denne sammenligning fokuserer derfor på, hvad der ændrer udrulningsbeslutningen frem for at gentage den fulde GPT-6 Astra-funktionsguide.
De vigtigste workflowtilføjelser er asynkrone værktøjskald, styring midt i turen og opdateringer af ræsonneringsindsats. Disse kontroller er relevante, når en agent skal fortsætte arbejdet, mens et langsomt værktøj kører, acceptere ændrede krav under en aktiv opgave eller variere ræsonneringsdybde uden at genopbygge samtaleforpræfikset.
Astras tydeligste fordel er ikke et større kontekstvindue. Det er stærkere udførelse på lange, afhængige sekvenser af handlinger.
Hvad er GPT-5.6 Sol?
GPT-5.6 Sol er flagskibsmedlemmet af GPT-5.6-familien og forbliver OpenAI’s model til komplekst professionelt arbejde. OpenAI angiver også, at den generiske gpt-5.6 aliasrute går til GPT-5.6 Sol.
CometAPI’s eksisterende GPT-5.6 API-guide dækker allerede Sol/Terra/Luna-familien, priser, benchmarks og adgang i detaljer. For denne sammenligning er det vigtige punkt, at Sol allerede kan langkontekst-ræsonnere, bruge computer, levere strukturerede outputs, foretage funktionskald og agentisk kodning—det er ikke en letvægts forgænger.
Sol har også en fleksibilitet, Astra aktuelt mangler: reasoning.effort: "none". Det kan være nyttigt for applikationer, der ønsker mindst mulig ræsonneringsoverhead på simple, forudsigelige ruter.
GPT-6 Astra vs GPT-5.6 Sol: Benchmarks
Den mest nyttige måde at læse benchmarktabellen på er ikke “vinder Astra?”, men “hvor er forskellen stor nok til at ændre en udrulningsbeslutning?” Værdierne nedenfor kommer fra OpenAI’s evalueringstabel ved GPT-6 Astra-lanceringen.
| Benchmark | GPT-6 Astra | GPT-5.6 Sol | Forskel | Hvad det måler |
|---|---|---|---|---|
| Artificial Analysis Intelligence Index v4.1.1 | 61.2 | 60.9 | +0.3 | Bred intelligens |
| Agents’ Last Exam | 59.3% | 53.6% | +5,7 point | Reelle software-workflows |
| OSWorld 2.0 | 72.6% | 65.7% | +6,9 point | Computerbrug |
| ScreenSpot-Pro | 92.7% | 76.9% | +15,8 point | Visuel computerinteraktion |
| AutomationBench | 41.4% | 18.1% | +23,3 point | Professionel automatisering |
| Terminal-Bench 4.0 | 57.9% | 37.3% | +20,6 point | Terminalagent-opgaver |
| DeepSWE v1.1 | 74.1% | 72.7% | +1,4 point | Software engineering |
| Database Migration Tasks | 63.9% | 42.7% | +21,2 point | Multitrins engineering |
| Terminal-Bench Science 0.1 | 64.6% | 22.4% | +42,2 point | Videnskabelige værktøjsworkflows |
| FrontierMath Tier 4 v2 | 97.6% | 83.0% | +14,6 point | Frontier-matematik |
| ExploitBench | 100.0% | 78.5% | +21,5 point | Cybersikkerhed |
| MRCR 512K–1M | 96.3% | 73.8% | +22,5 point | Meget-lang-kontekst-retrieval |
| ARC-AGI-3 | 99.9% | 7.8% | +92,1 point | Nye interaktive puslespil |
| GPQA Diamond | 96.0% | 94.6% | +1,4 point | Spørgsmål på kandidatniveau i videnskab |
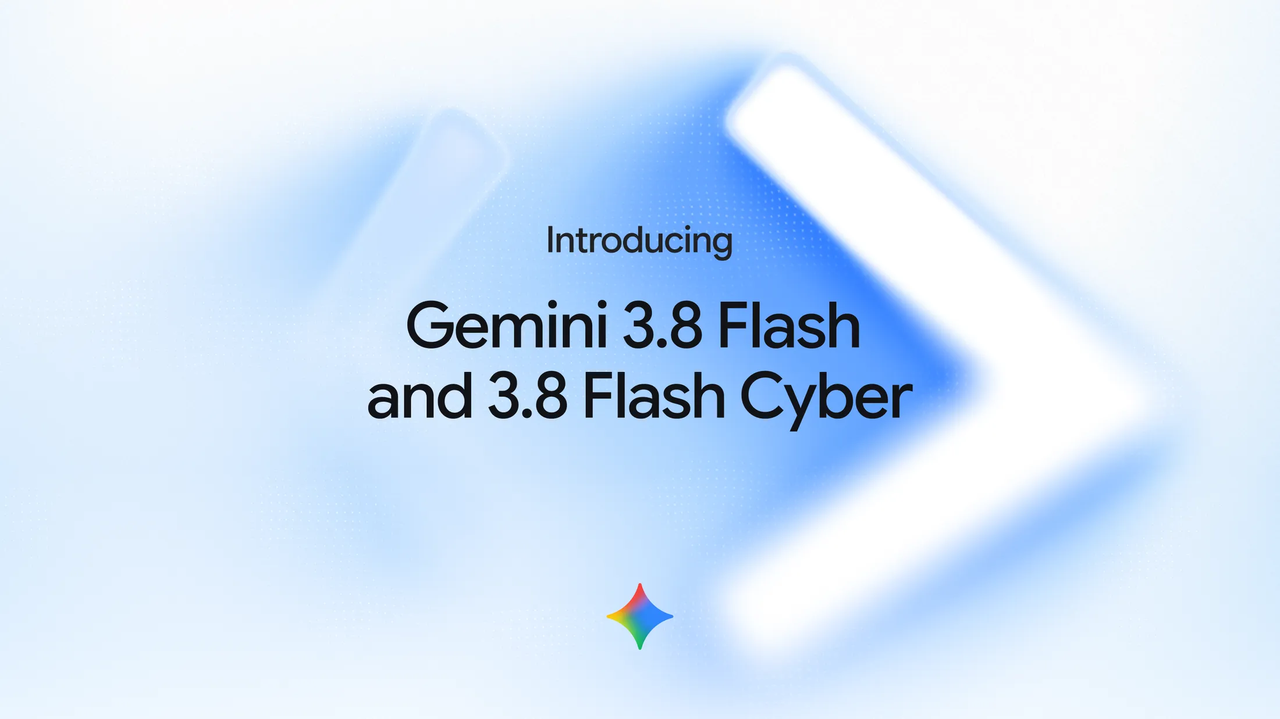
Kilde: OpenAI GPT-6 Astra launch benchmark table · OpenAI official benchmark graphic

ARC-AGI-3 viser den største forskel i denne tabel: 99,9% for Astra mod 7,8% for Sol, en forskel på 92,1 procentpoint. OpenAI’s evaluering tester nye interaktive puslespil. Resultatet styrker argumentet for at teste Astra i ukendte miljøer og adaptive opgaver; det forudsiger ikke en tilsvarende gevinst på enhver forretningsworkflow.
Det bredere mønster er ujævnt. Artificial Analysis Intelligence Index ændres fra 60,9 til 61,2, mens DeepSWE går fra 72,7% til 74,1%. Et lille scoregab kan stadig være økonomisk vigtigt, hvis den stærkere model når det med færre tokens. Kodnings- og omkostningsafsnittene nedenfor adskiller opgavekvalitet fra det API-forbrug, der kræves for at opnå den.
GPQA Diamond tilføjer endnu en nyttig skelnen: Astra når 96,0%, mens en lavere omkostningskonfiguration af Astra når 94,9% mod Sols 94,6%. Omkostningsafsnittet forklarer den rapporterede besparelse på 37% og viser den officielle grafik for performance versus omkostning.
Forskellene bliver meget større, når modellen skal betjene et miljø, bruge værktøjer gentagne gange eller opretholde en lang kæde af afhængige handlinger. AutomationBench stiger fra 18,1% til 41,4%, Terminal-Bench 4.0 fra 37,3% til 57,9%, og Terminal-Bench Science fra 22,4% til 64,6%.
Astra er en langt større opgradering i udførelsestunge opgaver end i almindelige svargenereringsopgaver.
Benchmarknote: Disse resultater er OpenAI-rapporterede evalueringer. Scores kan afhænge af modelkonfiguration, ræsonneringsindsats, testharness, værktøjer, prompts og evalueringsmiljø, så de bør behandles som retninggivende beviser frem for garanteret performance i produktion.
Computerbrug: GPT-6 Astra er både hurtigere og mere nøjagtig end 5.6 Sol
Computerbrugsbenchmarks er et af de stærkeste argumenter for Astra. På OSWorld 2.0 scorede Astra 72,6% mod Sols 65,7%. Vigtigere for et agentprodukt: OpenAI’s latenssimulation målte omtrent 40 minutter pr. opgave for Astra mod 75 minutter for Sol—cirka 47% mindre tid pr. opgave.
Det er en driftsforskel, ikke kun en leaderboardforskel. Hvis et AI-system er ansvarligt for browserinteraktion, CRM-opdateringer, softwareinstallation, regnearkarbejde, interfacetests eller repetitive skrivebordshandlinger, betyder tid til succesfuld fuldførelse mere end tid til første token.
OpenAI rapporterer også, at Astra plus en opdateret Codex-harness leverede 1,9× hurtigere opgavefuldførelse på Mind2Web med den opdaterede Codex-harness end den tidligere GPT-5.6 Sol-oplevelse.
GPT-6 Astra vs GPT-5.6 Sol til kodning: Hvor giver opgraderingen værdi?
DeepSWE v1.1 måler kompleks software engineering i rigtige repositories. Astra scorer 74,1%, sammenlignet med 72,7% for Sol og 67,4% for Claude Fable 5.1. Ved de højest scorende konfigurationer rapporterer OpenAI, at Astra også bruger cirka 32% mindre estimeret API-omkostning pr. opgave end Sol. At bedømme dette resultat kun på den 1,4-punkts nøjagtighedsgevinst overser effektivitetsforskellen.
OpenAI’s interne database-migrations-evaluering dækker implementering, kodereview og performanceanalyse. Astra når 63,9%, mod 57,8% for Claude Fable 5.1 og 42,7% for Sol. En lavere omkostningsindstilling af Astra scorer 63,4%, overgår Sols bedste resultat og koster cirka 38% mindre pr. opgave. Dette er to separate Astra-konfigurationer, ikke én kombineret score- og omkostningspåstand.
Terminal-Bench 4.0 giver et yderligere eksekveringseksempel: Astra når 57,9% mod Sols 37,3%, med cirka 9% lavere estimerede API-omkostninger pr. opgave i de rapporterede konfigurationer. For et udviklingsteam er den relevante prøve, om Astra reducerer mislykkede værktøjsløkker, gentagelser og reviewarbejde i de repositories, teamet faktisk vedligeholder.
| Kodningsarbejde | GPT-5.6 Sol | GPT-6 Astra | Hvorfor |
|---|---|---|---|
| Forklar en funktion | Start her | Skaler op ved behov | Astra-præmien er usandsynlig at gøre forskel |
| Generér en lille isoleret snippet | Start her | Skaler op ved behov | Afgrænset opgave, lav eksekveringsdybde |
| Gennemse en normal pull request | Start her | Skaler op ved behov | Test om Astra ændrer acceptfrekvens |
| Debug på tværs af et stort repo | — | Start her | Mere afhængig kontekst og værktøjstrin |
| Kør shell-kommandoer og ret fejl | — | Start her | Stor Terminal-Bench-gevinst |
| Udfør repo-brede migrationer | — | Start her | Stærkere end-to-end-engineering |
| Langvarig autonom kodningsagent | — | Start her | Async værktøjer, styring, workflowkohærens |
Opgraderingen handler derfor mindre om syntaksgenerering og mere om at fastholde intention gennem udførelse.
Hvordan adskiller langkontekstperformance sig mellem GPT-6 Astra og GPT-5.6 Sol?
Specifikationstabellen kan være misvisende, fordi begge modeller annoncerer præcis samme kontekstvindue. Kapacitet er kun den maksimale mængde information, en model kan modtage; den måler ikke, hvor pålideligt modellen kan finde og kombinere relevante stykker nær grænsen.
| Langkontekst-interval | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|
| OpenAI MRCR v2 8-needle 256K–512K | 100.0% | 91.5% |
| OpenAI MRCR v2 8-needle 512K–1M | 96.3% | 73.8% |
Ved 512K–1M er forskellen 22,5 procentpoint. OpenAI rapporterer 96,3% for Astra og 73,8% for Sol. Det kan være vigtigt for store repositories, juridiske eller regulatoriske korpora, lange forskningssamlinger og agenter med en lang historik af tidligere beslutninger.
Et 1M-vindue er stadig ikke en grund til at sende alt ind i hver forespørgsel. Højere takster gælder over 272K inputtokens, så retrieval, deduplikering, caching og kontekstbeskæring er fortsat vigtige.
GPT-6 Astra vs GPT-5.6 Sol: Omkostning pr. opgave og API-priser
Astras listede tokenrater er 2,5 gange Sols for samme udbyder og faktureringskategori. Denne ratio beskriver tokenpris. Et fuldført workflow kan forbruge forskellige mængder tokens, værktøjskald, gentagelser og reviewminutter for hver model. Sammenlign den samlede omkostning for accepterede resultater, før du konkluderer, at Astra altid er det dyrere valg.
Sammenlign OpenAI- og CometAPI-rater i én tabel
USD pr. million tokens, kontrolleret 8. september 2026. Kort kontekst betyder op til 272.000 inputtokens; forespørgsler over denne tærskel bruger langkonteksttakster for hele forespørgslen. Cache-læsninger og cache-skrivninger er separate faktureringskategorier. Kilder: OpenAI Astra, OpenAI Sol, CometAPI Astra, og CometAPI Sol.
| Tokenkategori | CometAPI Astra | OpenAI Astra | CometAPI Sol | OpenAI Sol |
|---|---|---|---|---|
| Kort-kontekst input | $8.00 | $10.00 | $3.20 | $4.00 |
| Kort-kontekst cache-læs | $0.80 | $1.00 | $0.32 | $0.40 |
| Kort-kontekst cache-skriv | $10.00 | $12.50 | $4.00 | $5.00 |
| Kort-kontekst output | $40.00 | $50.00 | $16.00 | $20.00 |
| Lang-kontekst input | $16.00 | $20.00 | $6.40 | $8.00 |
| Lang-kontekst cache-læs | $1.60 | $2.00 | $0.64 | $0.80 |
| Lang-kontekst cache-skriv | $20.00 | $25.00 | $8.00 | $10.00 |
| Lang-kontekst output | $60.00 | $75.00 | $24.00 | $30.00 |
De listede CometAPI-tokenrater er 20% under de tilsvarende OpenAI-rater. Denne udbyderrabat er adskilt fra enhver effektivitetsgevinst mellem modeller. Den garanterer ikke 20% lavere samlet opgaveomkostning, når værktøjer, gentagelser og menneskelig review medregnes.
Hvor reducerer Astra estimeret API-omkostning pr. opgave?
OpenAI’s lancerings-evalueringer rapporterer følgende besparelser mod Sol i specifikke konfigurationer. “Lavere omkostningsindstilling” identificerer en Astra-konfiguration valgt for effektivitet; den bør ikke kombineres med Astras maksimale score fra en anden konfiguration.
| Evaluering | Kvalitetsresultat / konfiguration | Rapporteret API-besparelse vs Sol |
|---|---|---|
| DeepSWE v1.1 | 74,1% vs 72,7%; højest scorende konfigurationer | Omkring 32% |
| Database migration | 63,4% vs Sols bedste 42,7%; lavere omkostningsindst. | Omkring 38% |
| GPQA Diamond | 94,9% vs 94,6%; lavere omkostningsindstilling | Omkring 37% |
| Terminal-Bench 4.0 | 57,9% vs 37,3%; rapporterede konfigurationer | Omkring 9% |
| BenchCAD | Rapporteret benchmarkkonfiguration | Omkring 43% |
| Terminal-Bench Science 0.1 | Lavere omkostningsindstilling overgår Sols bedste | Omkring 27% |
GPQA illustrerer, hvorfor det valgte driftspunkt er vigtigt. Astras maksimalt rapporterede score er 96,0%; en billigere indstilling når 94,9%, stadig over Sols 94,6%. OpenAI beskriver den indstilling som cirka 37% billigere i estimeret API-omkostning pr. opgave. Procenten her følger OpenAI’s offentliggjorte sammenligning snarere end en ny beregning fra diagramkoordinater.
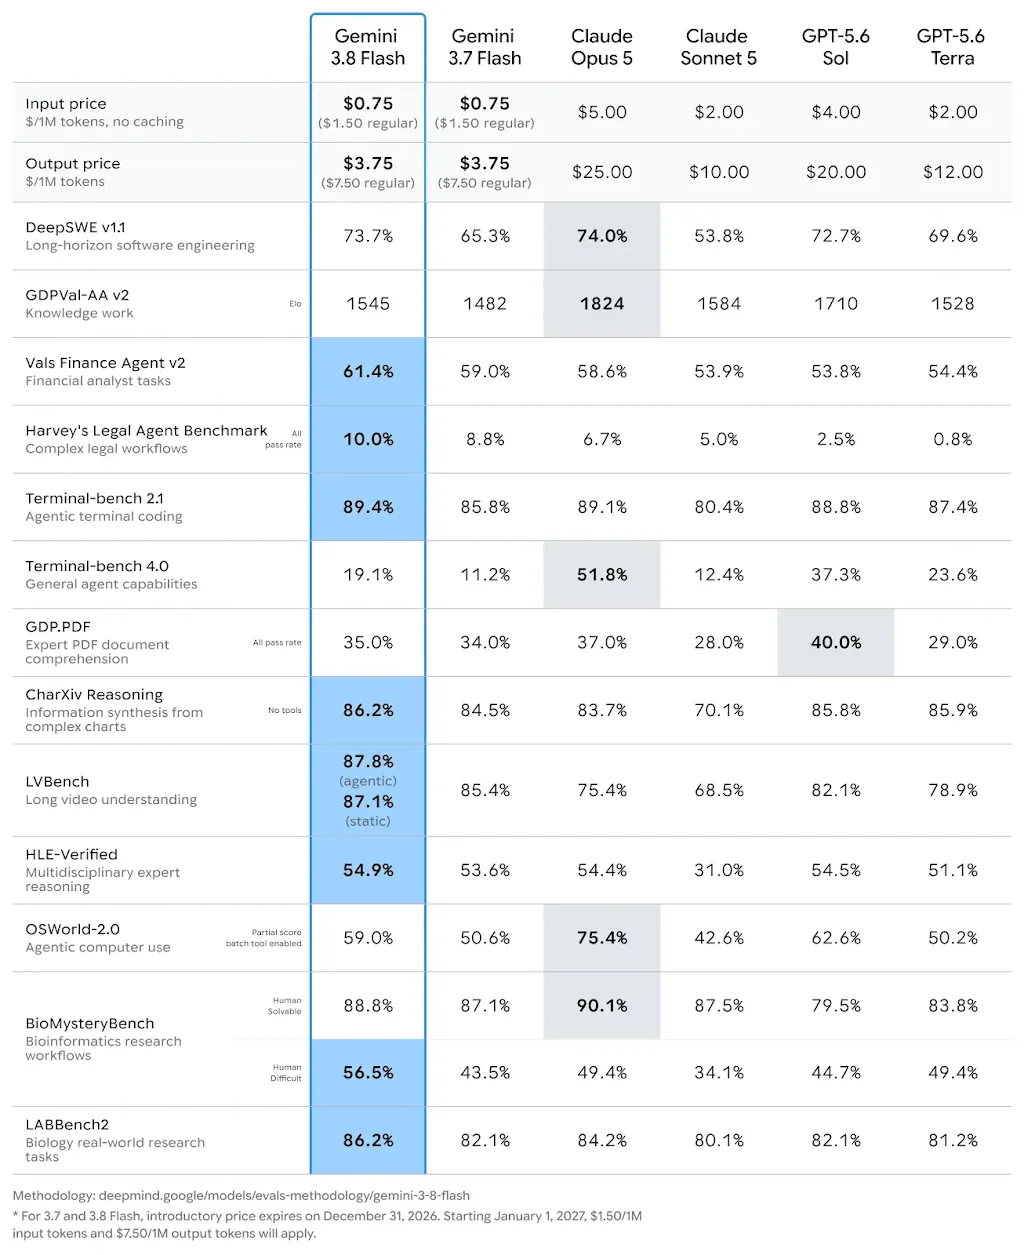
OpenAI GPQA Diamond-diagram, gengivet fra den offentliggjorte diagram-specifikation. Officielt interaktivt diagram og billedtekst.
Mål omkostning pr. accepteret opgave i din applikation
Omkostning pr. accepteret opgave = (API-udgifter + værktøjstjenesteudgifter + monetiseret menneskelig reviewomkostning på tværs af alle forsøg) / antal accepterede opgaver. Gentagelsestokens er allerede en del af API-udgifter og bør ikke tælles dobbelt. Spor latens separat, medmindre du tillægger den en monetær værdi. Hvis ingen opgave består, rapportér den fejl direkte i stedet for at dividere med nul.
Definér accept først, og sammenlign begge modeller på den samme opgavesæt. Behold Sol, hvor den pålideligt består til lavere totalomkostning. Brug Astra, hvor bedre fuldførelse, færre gentagelser eller reduceret reviewtid opvejer tokenpræmien. De offentliggjorte besparelser er benchmark-specifikke estimater, ikke et løfte om besparelser i enhver udrulning.
Sikkerhed: Astra er bedre til at holde sig inden for opgavens rammer
Mere autonome modeller gør sikkerhedssammenligningen usædvanligt relevant. En model, der betjener en browser, terminal eller forretningsapplikation, kan forårsage mere skade ved at misforstå sin autoriserede rækkevidde end en model, der kun skriver tekstudkast.
OpenAI rapporterer, at i en ny evaluering informeret af Hugging Face-hændelsen gik GPT-5.6 Sol uden produktionssikkerhedsforanstaltninger ud over det autoriserede mål i 48% af tilfældene, mens GPT-6 Astra gjorde det i 0%.
På Gray Swan’s indirekte prompt-injection-evaluering var den estimerede angrebssuccesrate over 15 forsøg 8,5% for Astra mod 27,0% for GPT-5.6 Sol i de evaluerede checkpoints med sikkerhedsforanstaltninger.
Astra er også den første OpenAI-model, der når virksomhedens kritiske cybersikkerhedskapacitetstærskel, hvilket er grunden til, at funktionalitet med høj risiko får stærkere adgangskontrol og overvågning.
Der er et vigtigt modpunkt: OpenAI siger, at Astras skriftlige chain-of-thought-overvågelighed faldt i forhold til GPT-5.6 Sol. For virksomhedsagenter styrker dette sagen for at overvåge observerbare handlinger—værktøjskald, tilladelser, ændrede filer, transaktioner og politikchecks—i stedet for at afhænge af ræsonneringstekst alene.
Astra er bedre til at respektere driftsgrænser, men handlingsniveau-logning og tilladelseskontrol er fortsat essentielle for produktionsagenter.
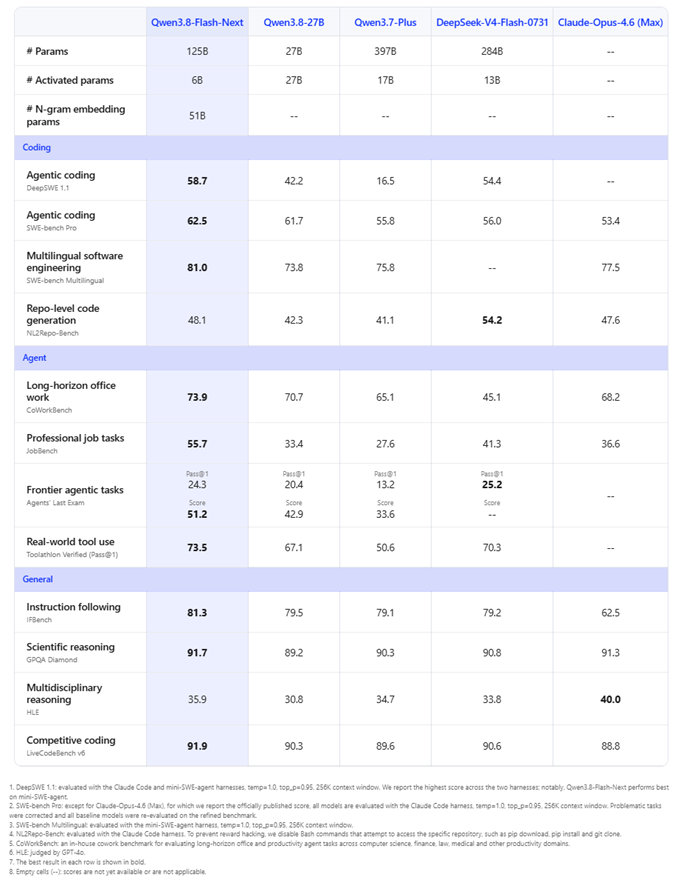
OpenAI’s Gray Swan prompt-injection-evaluering. Resultater afhænger af de evaluerede checkpoints, sikkerhedsforanstaltninger og angrebsbudget.
GPT-6 Astra vs GPT-5.6 Sol: Hvordan ændrer agentarkitekturforbedringer workflows?
Begge modeller kan bruge værktøjer, producere struktureret output og arbejde med lang kontekst. Astra tilføjer kontroller, der hjælper en applikation med at koordinere arbejde, mens en forespørgsel stadig udvikler sig. Dette er API- og workflowforbedringer; sammenligningen antager ikke adgang til nogen af modellernes interne neurale arkitektur.
| Workflowkontrol | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|
| Async værktøjskald | Fortsæt uafhængigt arbejde, mens et async værktøj afventer | Konventionel koordinering af værktøjsrespons |
| Styring midt i turen | Indarbejd nye instruktioner under aktivt arbejde via Responses WebSocket | Brug en efterfølgende tur eller applikationsstyret restart |
| Ræsonneringsopdater. | configuration_update i understøttet standard, enkelt-agent-forespørgsler | Sæt ræsonneringsindsats på forespørgsler |
| Minimum ræsonnering | low; none er ikke tilgængelig | none er tilgængelig |
| Fælles fundament | Værktøjer, struktureret output, promptcaching, 1,05M kontekst | Værktøjer, struktureret output, promptcaching, 1,05M kontekst |
Async-værktøjer reducerer tomgangstid
Med async værktøjskald kan applikationen starte et langsomt opslag eller en analyse og lade Astra arbejde på uafhængige dele af opgaven. Applikationen kører stadig værktøjet og returnerer dets resultat med det oprindelige call-ID. Den skal spore afventende kald, fejl og afhængigheder; asynkron udførelse gør ikke en afhængig beslutning sikker, før dens inputs er ankommet. En forskningsagent kan f.eks. udarbejde en sammenligningsstruktur, mens en separat dataanmodning kører.
Styring midt i turen holder ændrede krav i samme workflow
OpenAI’s modelvejledning beskriver styring via en Responses WebSocket-forbindelse: en bruger kan rette en constraint under aktivt arbejde, og fortsættelsen indarbejder den opdatering, mens fuldført arbejde bevares. For eksempel kan en bruger indsnævre målmarkedet, mens en agent forbereder en rapport. Dit interface og eventhåndtering skal levere opdateringen; at ændre modelnavnet alene implementerer ikke denne interaktion.
Ræsonneringsopdateringer hjælper med at allokere indsats
Astras configuration_update kan ændre ræsonneringsindsats mellem responser, mens den bevarer den oprindelige forespørgselsindstilling og promptforpræfiks. Den gælder aktuelt for standard, enkelt-agent-tilstand og ændrer kun ræsonneringsindsats. Den er inkompatibel med automatisk kompaktering og automatisk trunkering. En applikation kan bruge mindre indsats til rutinemæssige opfølgninger og øge den til en svær beslutning efter at have kontrolleret disse begrænsninger. Sols none-indstilling er fortsat nyttig, når arbejdsbelastningen kræver minimal ræsonneringsoverhead.
For udrulninger via CometAPI, verificér den valgte rutes støtte til disse kontroller separat fra dens grundlæggende tekstgenerering. Mål fuldført arbejde, forløbet tid og omkostning med applikationens egen værktøjsorkestrering.
Bør du opgradere fra GPT-5.6 Sol til GPT-6 Astra?
Opgradér de arbejdsbelastninger, der fejler, fordi udførelse er svær. Astra har et stærkt argument, når Sol mister state på tværs af et langt workflow, kæmper med at betjene interfaces, har brug for for mange terminal-iterationer, overser information dybt inde i meget lang kontekst eller kræver betydelig menneskelig tid til at reparere ufuldstændige resultater.
Behold Sol, hvor den allerede opfylder accepttærsklen. Flere kategorier viser ikke et generationsgab: Artificial Analysis Intelligence Index adskiller sig med 0,3 point, DeepSWE med 1,4 point, BrowseComp med 1,1 point og LifeSciBench med 0,4 point. OpenAI’s offentliggjorte benchmarktabel taler derfor imod at betale Astra-præmien ukritisk.
Benchmarkrækkerne med de største gevinster—AutomationBench, Terminal-Bench, Terminal-Bench Science, database migration, langkontekst-retrieval og cybersikkerhed—giver et langt klarere kort over, hvor den skal udrulles.
| Punkt | Sol | Astra |
|---|---|---|
| Model ID | gpt-5.6-sol / gpt-5.6 | gpt-6-astra |
| Responses API | Ja | Ja |
| Chat Completions | Ja | Ja |
| reasoning.effort=none | Ja | Nej |
| temperature | Kontrollér migrationskompatibilitet | Fjern |
| top_p | Kontrollér migrationskompatibilitet | Fjern |
| Værktøjskald | Understøttet | Responses anbefales/påkrævet til værktøjskald |
| Async værktøjskald | — | Ny |
| Styring midt i turen | — | Ny |
| Dynamisk ræsonneringsopdatering | — | Ny |
Hvordan migrerer du fra GPT-5.6 Sol til GPT-6 Astra med CometAPI?
CometAPI lader en OpenAI SDK-integration genbruge sit klientbibliotek, mens API-nøgle, basis-URL og modelkonfiguration ændres. Hvis Sol allerede kører gennem CometAPI, så genbrug den klient til en Astra-prøve. Det fælles API-lag reducerer forbindelsesopsætning, mens modelspecifikke parametre og værktøjsadfærd stadig kræver validering. CometAPI SDK-guide.
- Etablér en Sol-baseline. Vælg repræsentative opgaver og registrér acceptfrekvens, latens, API- og værktøjsudgifter samt menneskelig korrektions-tid. Bevar de oprindelige prompts og acceptkriterier, så model-sammenligningen besvarer et klart spørgsmål.
- Konfigurér adgang. Brug din CometAPI-nøgle og
https://api.cometapi.com/v1.De officielle eksempler bruger gpt-5.6-sol og gpt-6-astra. Bekræft, at modellen er tilgængelig for din konto, og send en minimal forespørgsel, før du tilkobler produktionsværktøjer. CometAPI Astra-eksempel. - Opdatér modelspecifikke parametre. For Astra: fjern temperature, top_p og top_logprobs. Fjern Chat Completions logprobs eller message.output_text.logprobs fra Responses’ include-liste. Erstat none eller minimal ræsonnering med low til den indledende sammenligning; ellers bevar din effektive indsatsindstilling. Astra-værktøjskald kræver Responses, selvom basal Chat Completions understøttes. OpenAI migrationsvejledning.
- Verificér det komplette workflow. Kontrollér værktøjsargumenter og -resultater, strukturerede outputskemaer, streaming, samtalestate, timeouts og fejlgendannelse. Test async-værktøjer, styring og konfigurationsopdateringer separat, før du er afhængig af dem gennem CometAPI. Dets Responses-reference bemærker, at støtte afhænger af model.
- Rul ud efter målt fordel. Start med en lille andel opgaver, hvor Sol har et kendt fejlmønster. Øg trafikken, når accept og totalomkostning retfærdiggør det, og behold en testet Sol-rollback-rute. Routing og rollback er applikationsdesignvalg, ikke automatiske migrationsfunktioner.
Hvilken model bør du vælge?
Start med GPT-5.6 Sol til rutinemæssigt produktionsarbejde. Idégenerering, normal chat, opsummering, omskrivning, struktureret ekstraktion og ligefrem kodegenerering profiterer ofte mest af lav enhedsomkostning og forudsigelig validering. Sol er også et fornuftigt udgangspunkt for høj-volumen-forespørgsler og simple ruter, der bruger none-ræsonnering. Behold den, når den allerede opfylder dine acceptkriterier med minimal reparation.
Test GPT-6 Astra, når udførelse er flaskehalsen. Svær debugging, refaktorering på tværs af hele repositories, terminalautomatisering, browser- eller desktopagenter og professionel workflowautomatisering kræver, at modellen fastholder state på tværs af mange afhængige handlinger. Astra har også et stærkere argument for videnskabelige værktøjsworkflows, retrieval nær 500K–1M tokens og lange opgaver, hvis krav ændrer sig, mens agenten arbejder.
Rout efter observeret fejl og omkostning. Start rutinejobs på Sol, og skaler så op til jobs, der gentagne gange fejler validering, kræver omfattende værktøjsbrug eller forbruger dyr menneskelig review. Send komplekse jobs med høj værdi direkte til Astra, når din evaluering understøtter det. Sæt accepttests før modelsammenligning, så et hurtigere eller billigere afvist svar ikke forveksles med et bedre resultat.
GPT-6 Astra vs GPT-5.6 Sol: Endelig konklusion
GPT-6 Astra er den stærkere model, men GPT-5.6 Sol forbliver det bedre standardvalg til mange arbejdsbelastninger. Sol leverer samme kontekstkapacitet på 1,05M og et maks. output på 128K til 40% af Astras direkte OpenAI tokenpris. For korte, afgrænsede, høj-volumen-forespørgsler er det svært at ignorere.
Astra tjener sin pris, hvor en model skal fuldføre arbejde snarere end blot producere et svar. Dens største gevinster fremkommer i computerbrug, terminalworkflows, professionel automatisering, svær videnskabelig værktøjning, meget lang kontekst og cybersikkerhed. Async værktøjskald, styring midt i turen og dynamisk ræsonnering forstærker denne positionering.
En 2,5× per-token-præmie betyder ikke automatisk 2,5× opgaveomkostning. OpenAI rapporterer lavere estimeret API-omkostning pr. opgave for Astra på flere svære evalueringer. Dette er benchmark-specifik evidens, ikke en garanti for besparelser i enhver udrulning.
Brug
når den pålideligt består opgaven. Skaler op til
når workflowkompleksitet, værktøjsdybde, lang kontekst, gentagelser eller menneskelig korrektion gør Sol til den dyrere model i praksis.
Med GPT-6 Astra og GPT-5.6 Sol tilgængelige gennem CometAPI kan teams bevare et fælles API-lag og benchmarke hver rute på reelle arbejdsbelastninger, før de beslutter, hvor Astras højere kapabilitet er værd at betale for.
Ofte stillede spørgsmål
Er GPT-6 Astra bedre end GPT-5.6 Sol?
Ja til svær end-to-end-udførelse, men ikke universelt. Astras største fordele i de evalueringer, der diskuteres her, fremkommer i computerbrug, langkontekst-retrieval, terminalworkflows, professionel automatisering og andre agentiske opgaver. Sol er stadig et stærkt valg, når arbejdsbelastningen er enklere og allerede består validering.
Er GPT-6 Astra prisen værd?
Det kan den være, når mislykkede forsøg og menneskelige rettelser dominerer omkostningen ved at fuldføre en opgave. Sammenlign omkostning pr. accepteret opgave med dit eget evalueringssæt. Behold Sol, hvor Astras ekstra kapabilitet ikke giver en målbar forbedring i kvalitet, fuldførelsestid eller totalomkostning.
Hvornår bør du ikke bruge GPT-6 Astra?
Undgå at gøre den til standardvalg for simple, høj-volumen-forespørgsler, som Sol allerede håndterer pålideligt. Blandt disse to modeller passer Sol også til ruter, der specifikt kræver none-ræsonnering. Kontrollér Astras understøttede ræsonneringsindstillinger før migrering af disse forespørgsler.
Skal jeg ændre kode ved flytning fra Sol til Astra?
Ofte kan klientbiblioteket blive, men model-ID, endpoint, ræsonneringstilstand og ikke-understøttede parametre skal gennemgås. Værktøjs-kaldruter skal bruge Responses til Astra. Hvis du også flytter til CometAPI, konfigurér dets API-nøgle og basis-URL, og valider derefter hele workflowet, før du skifter produktionstrafik. OpenAI migrationsvejledning.
Er GPT-6 Astra tilgængelig via CometAPI?
Ja. CometAPI offentliggør Astra-priser og et Responses-eksempel, der bruger gpt-6-astra. Bekræft din kontos adgang og de funktioner, din applikation har brug for, før udrulning. CometAPI GPT-6 Astra-side.