
TL;DR
DeepSeek V4.1 Flash es el modelo multimodal de DeepSeek orientado a la eficiencia para programación, razonamiento, agentes y cargas de trabajo de contexto largo. La documentación técnica oficial especifica un diseño Mixture-of-Experts de 552B con 8B parámetros activos para entrada y 16B para salida, además de comprensión visual nativa y una huella de caché KV mucho menor.
Para desarrolladores que usen la API de DeepSeek V4.1 Flash en CometAPI, la integración práctica es compatible con OpenAI: usa https://api.cometapi.com/v1 como URL base, establece el modelo en deepseek-v4.1-flash y llama a la interfaz estándar de Chat Completions.
Hay una diferencia importante en los nombres: la API de primer nivel de DeepSeek usa deepseek-flash, mientras que CometAPI usa deepseek-v4.1-flash. Trata los identificadores de modelo como configuración específica del proveedor.
Puntos clave
- DeepSeek V4.1 Flash combina un backbone MoE de 552B, comprensión de imágenes nativa y un perfil de cómputo asimétrico entre entrada y salida.
- En CometAPI, usa deepseek-v4.1-flash; en la API de primer nivel de DeepSeek, usa deepseek-flash.
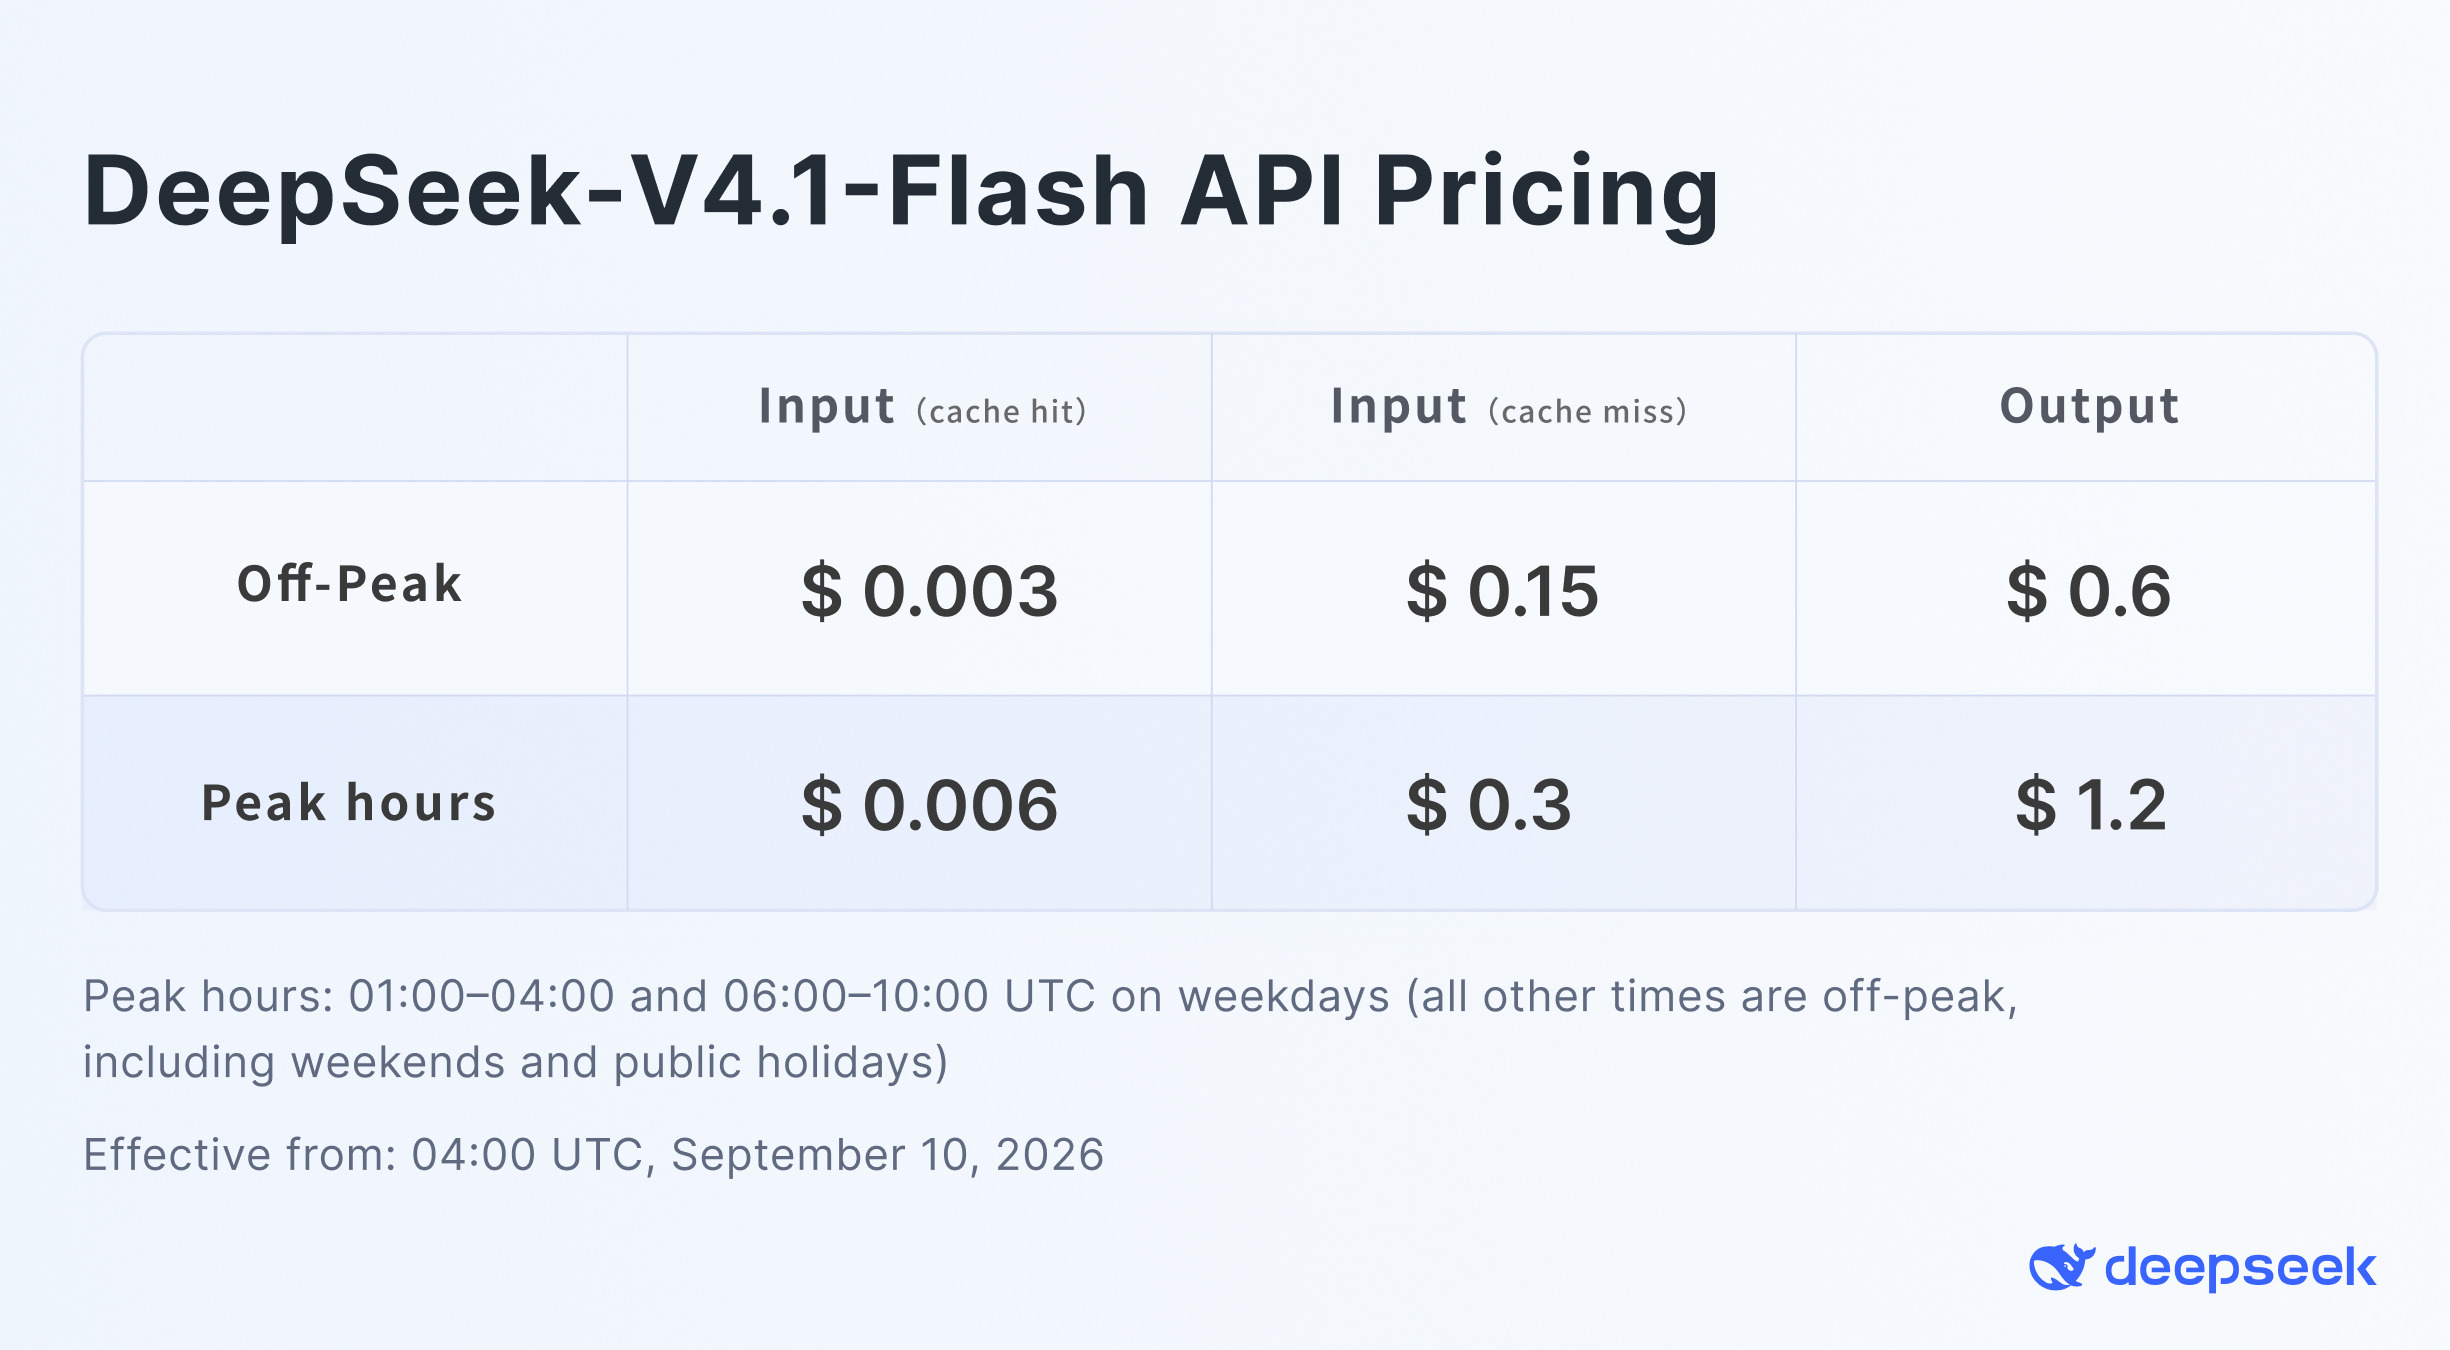
- CometAPI publica precios base desde $0.12/M tokens de entrada, mientras que DeepSeek marca $0.15/M de entrada por fallo de caché en horas valle.
- Las mayores diferencias medidas se concentran en programación, terminal, repositorios, automatización y benchmarks de agentes asistidos por herramientas.
¿Qué es la API DeepSeek V4.1 Flash?
DeepSeek V4.1 Flash es el último modelo Flash construido sobre una arquitectura Mixture-of-Experts de 552B parámetros. Su diseño de codificador-decodificador causal activa 8B parámetros para el procesamiento de entrada y 16B para la generación de salida.
Para la planificación de integración, la API oficial de DeepSeek expone una ventana de contexto de 1M de tokens y una salida máxima de 384K tokens. El servicio upstream soporta Chat Completions y Responses API compatibles con OpenAI, una API compatible con Anthropic, streaming, salida JSON, llamadas a herramientas y entrada de imagen nativa. Esta guía usa la ruta de Chat Completions de CometAPI, así que verifica el passthrough de funciones en esa ruta antes de producción.
Nota del proveedor: los IDs de modelo y los campos de solicitud avanzados son específicos de la ruta. Usa deepseek-v4.1-flash para los ejemplos de CometAPI en esta guía y prueba visión, llamadas a herramientas, salida estructurada y controles de pensamiento en el endpoint desplegado.
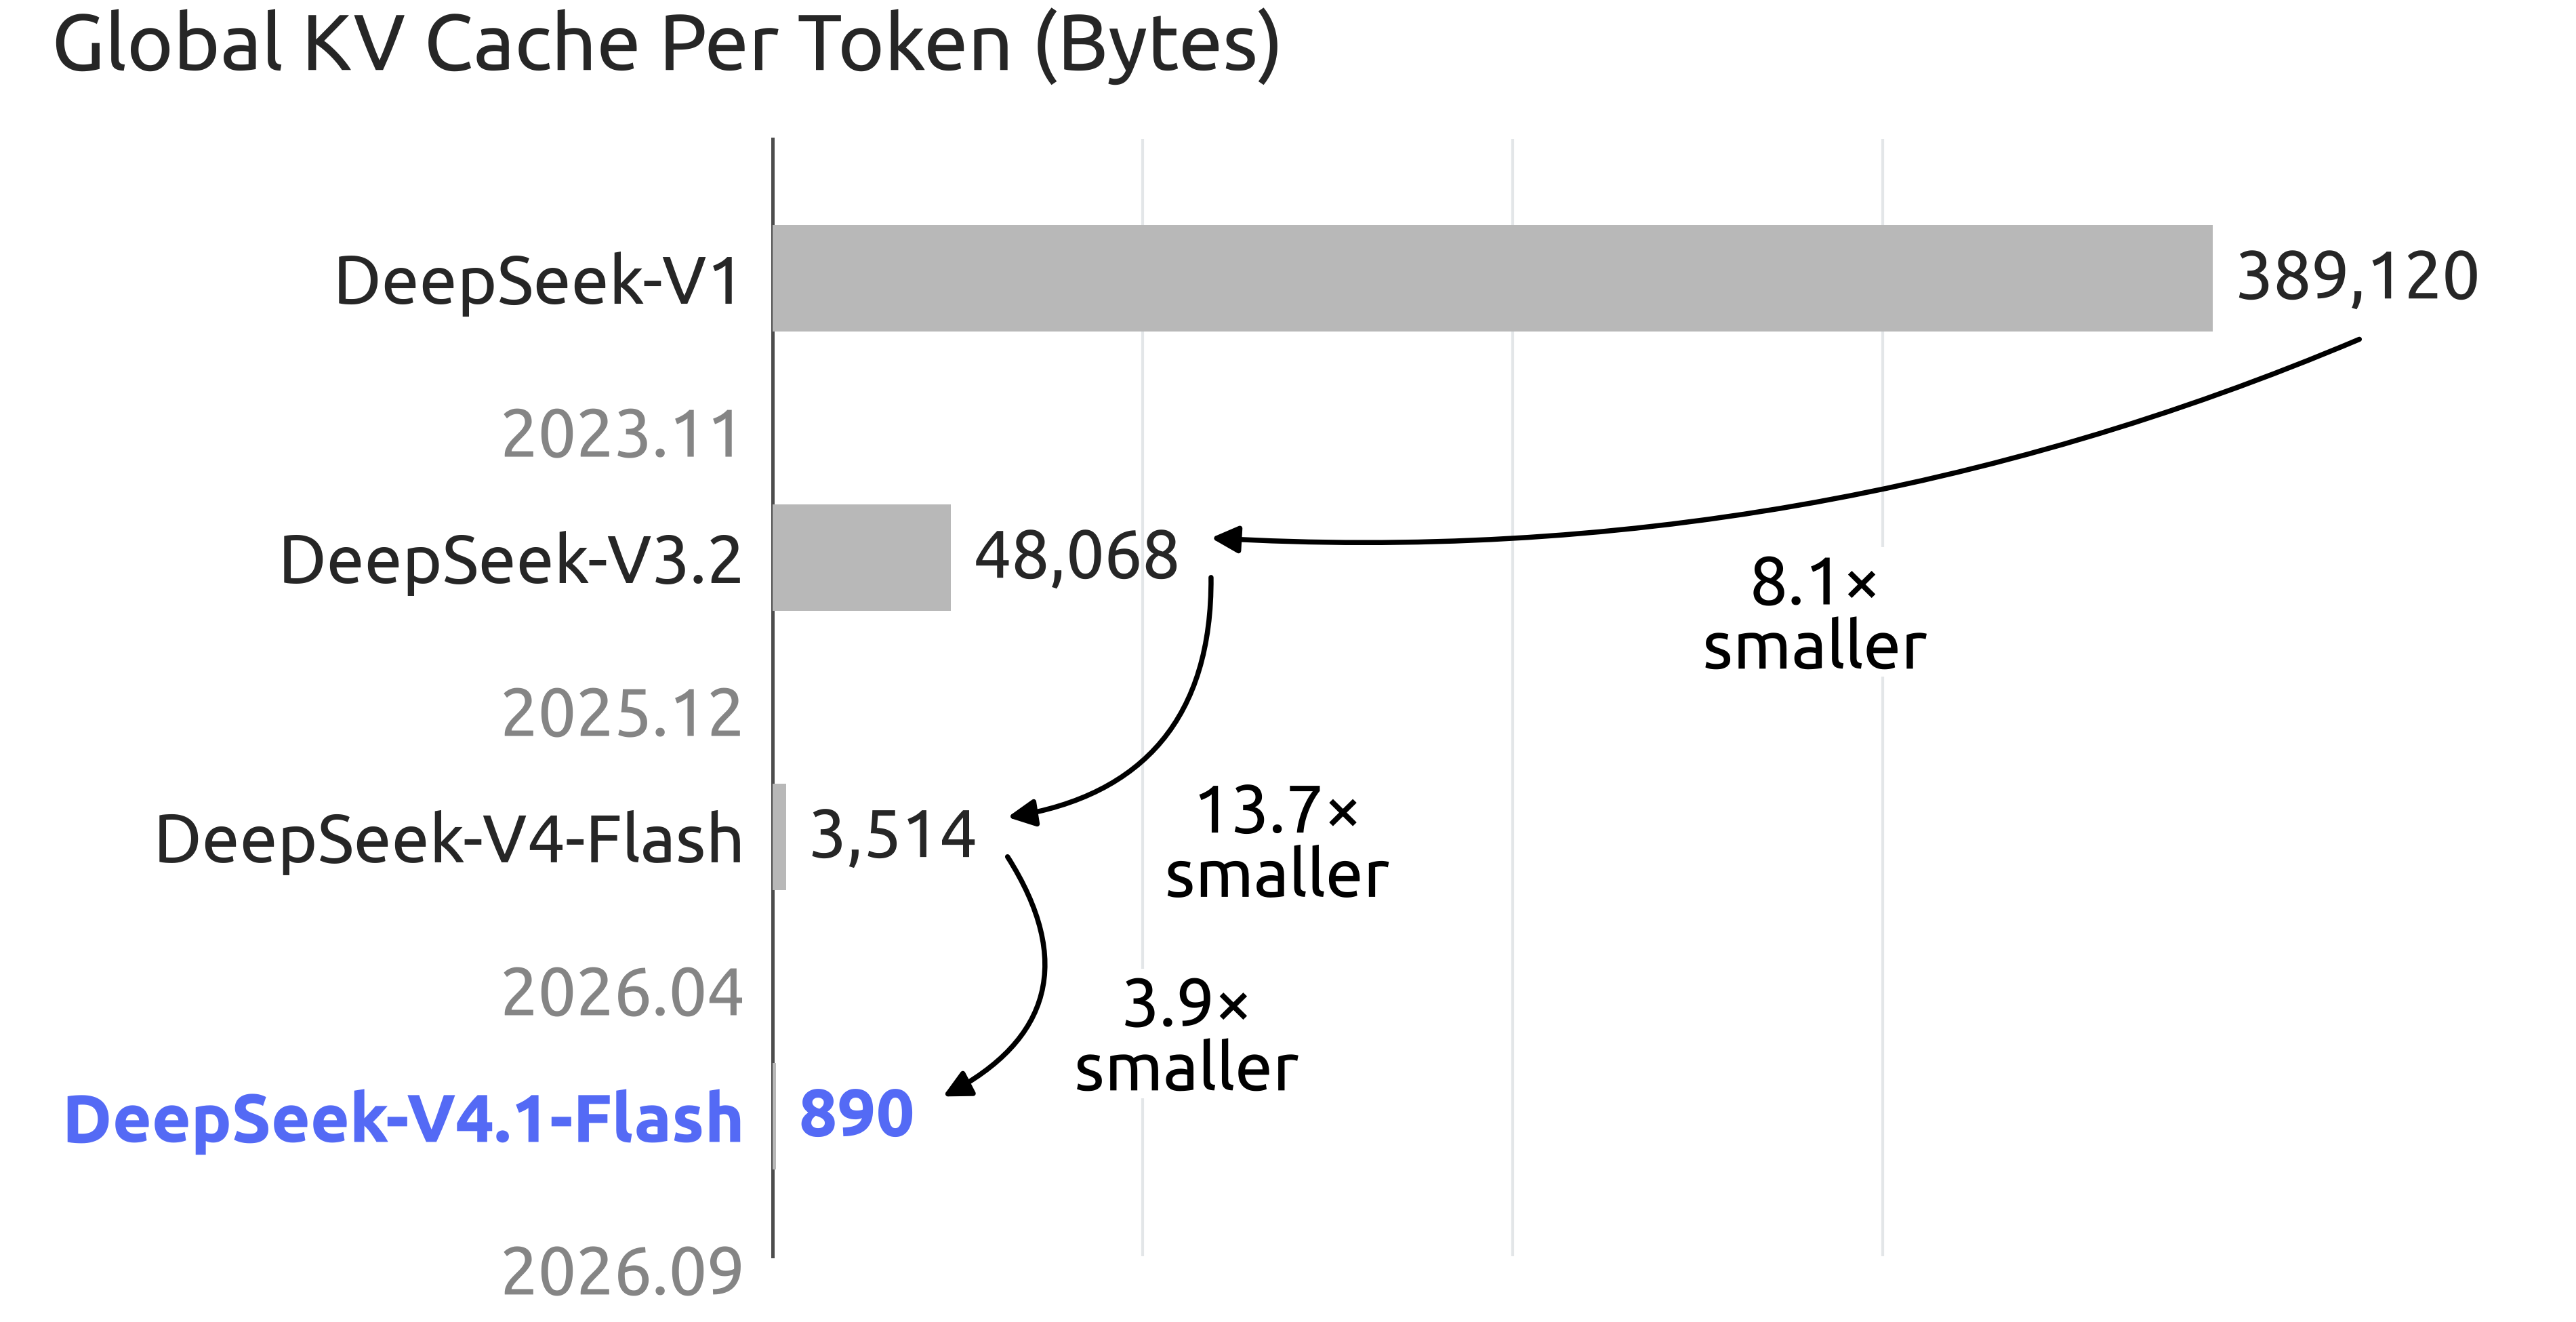
DeepSeek también informa que el caché KV global es de ~890 bytes por token, frente a 3,514 bytes por token en la generación V4 Flash anterior. Esa reducción importa especialmente para agentes de larga ejecución que reutilizan repetidamente prompts grandes, esquemas de herramientas e historial de conversación.
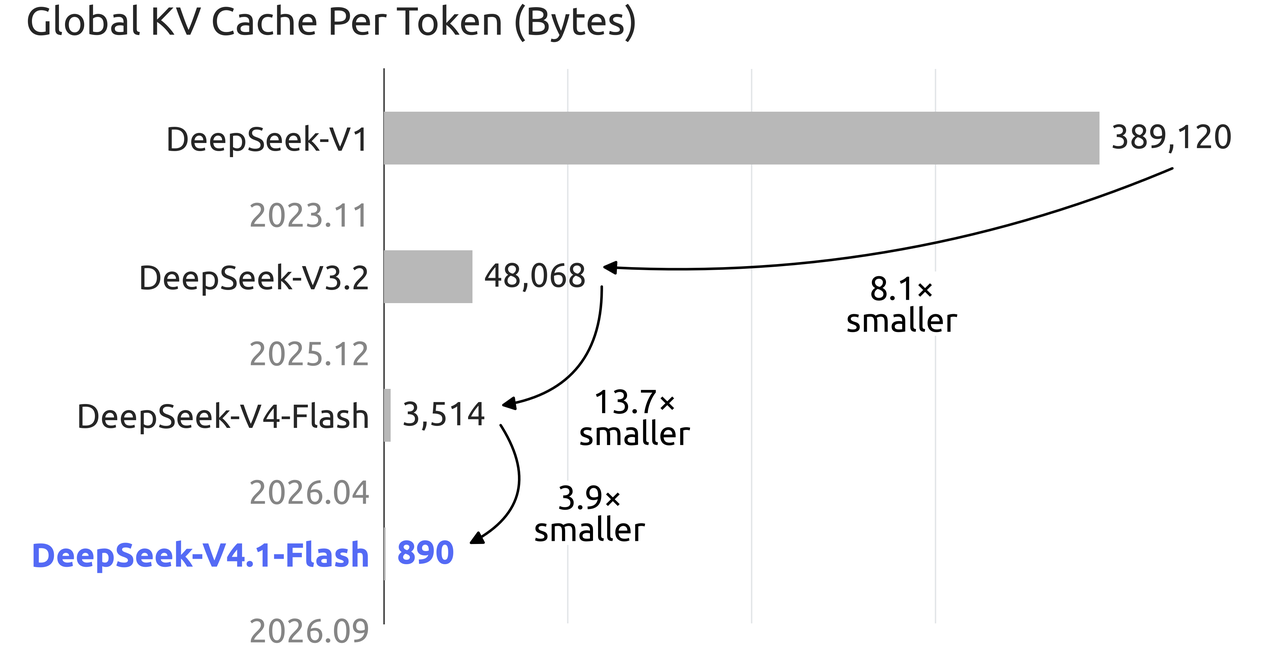
¿Comparación oficial del caché KV de DeepSeek? fuente oficial de la imagen
¿Qué tan sólido es DeepSeek V4.1 Flash para programación y agentes de IA?
Esta guía se centra en evidencia de benchmarks que informa directamente la selección de API. DeepSeek caracteriza V4.1 Flash como superior a modelos flagship, incluido V4 Pro, en su paquete de evaluación publicado. Las mejoras más aplicables aparecen en trabajo de terminal, ingeniería de software, tareas de repositorios, automatización y agentes asistidos por herramientas; los equipos de producción deberían seguir validando el modelo con sus propios prompts y criterios de finalización.
La conclusión práctica es más estrecha que “V4.1 es más inteligente”. DeepSeek V4.1 Flash es especialmente atractivo para uso repetido de herramientas, acciones de terminal, programación a escala de repositorios, automatización y trayectorias largas de agentes. Las cargas de trabajo de puro conocimiento o razonamiento pueden producir una clasificación distinta.
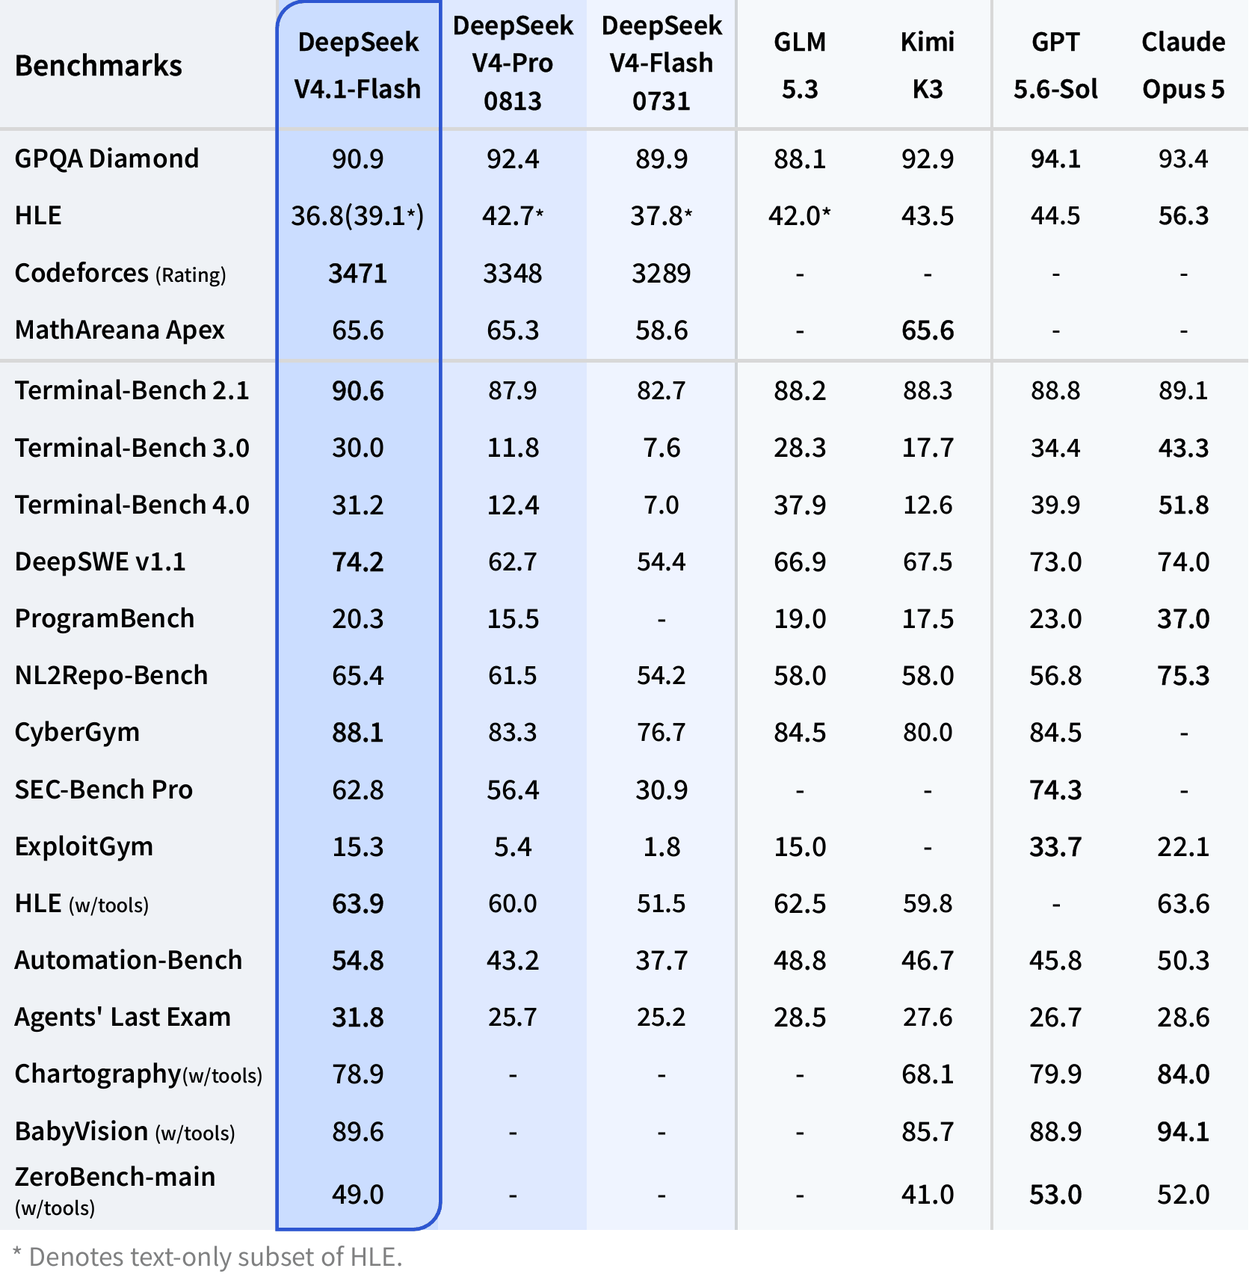
¿Resultados oficiales de benchmarks de DeepSeek? fuente oficial de la imagen
¿Por qué usar la API DeepSeek V4.1 Flash a través de CometAPI?
La principal ventaja de integración es que la API de DeepSeek V4.1 Flash en CometAPI puede invocarse con el mismo patrón de cliente compatible con OpenAI usado para otros modelos, reduciendo cambios de SDK en aplicaciones multi-modelo.
Esto también evita un error de integración común: copiar el identificador de primer nivel de DeepSeek en una solicitud de CometAPI. Las rutas de proveedor se refieren a la misma familia de modelos, pero los IDs de modelo documentados son distintos.
Conéctate a DeepSeek V4.1 Flash con CometAPI
Configura tu clave de API y URL base
Crea una clave de API de CometAPI, guárdala en una variable de entorno y configura la URL base compatible con OpenAI como https://api.cometapi.com/v1. No incrustes credenciales de producción en el código fuente.
export COMETAPI_KEY="YOUR_COMETAPI_KEY"
``````sh
$env:COMETAPI_KEY="YOUR_COMETAPI_KEY"
Realiza tu primera solicitud a la API
Usa el identificador de modelo de CometAPI deepseek-v4.1-flash con el endpoint estándar de Chat Completions.
curl "https://api.cometapi.com/v1/chat/completions"
  -H "Content-Type: application/json"
  -H "Authorization: Bearer ${COMETAPI_KEY}"
  -d '{
    "model": "deepseek-v4.1-flash",
    "messages": [
      {
        "role": "user",
        "content": "Explain three ways to reduce latency in a high-throughput API service."
      }
    ]
  }'
Una respuesta exitosa usa la estructura de completion al estilo OpenAI ya conocida, por lo que las aplicaciones que ya leen choices[0].message.content requieren una migración mínima.
Ejemplo con SDK de Python
pip install openai
``````python
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[
        {
            "role": "user",
            "content": "Write a Python retry helper with exponential backoff."
        }
    ],
)

print(response.choices[0].message.content)
Para producción, añade timeouts explícitos, reintentos acotados, registro de solicitudes y monitoreo de uso.
Ejemplo con SDK de JavaScript
npm install openai
``````js
import OpenAI from "openai";

const client = new OpenAI({
  apiKey: process.env.COMETAPI_KEY,
  baseURL: "https://api.cometapi.com/v1",
});

const response = await client.chat.completions.create({
  model: "deepseek-v4.1-flash",
  messages: [
    {
      role: "user",
      content: "Create a typed rate limiter interface for an Express API."
    }
  ],
});

console.log(response.choices[0].message.content);
La abstracción del cliente permanece igual mientras que la URL base y el ID del modelo pasan a ser configuración del proveedor.
Funciones de la API DeepSeek V4.1 Flash
Configura el razonamiento y el modo de pensamiento
DeepSeek documenta tanto la operación con “thinking” como sin ella. Al enrutar a través de CometAPI, verifica que los campos específicos del proveedor se transmitan exactamente como esperas antes de depender de ellos como contrato de producción.
response = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[
        {
            "role": "user",
            "content": "Design a fault-tolerant distributed job scheduler."
        }
    ],
    reasoning_effort="high",
    extra_body={
        "thinking": {"type": "enabled"}
    },
)
Prueba cada nivel de esfuerzo soportado frente a tus propias metas de latencia, uso de tokens y finalización de tareas, porque los mapeos del proveedor pueden diferir.
Analiza imágenes con entrada de visión
DeepSeek V4.1 Flash acepta imágenes JPEG, PNG, GIF y WebP. Los límites oficiales incluyen 32 MiB por imagen inline, 64 MiB por imagen basada en archivo, hasta 600 imágenes por solicitud y un límite de 8,192 caracteres para URLs de imágenes externas. Las imágenes pertenecen a mensajes de user o developer, no de system o assistant.
response = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[
        {
            "role": "user",
            "content": [
                {"type": "text", "text": "Identify the three most important anomalies."},
                {
                    "type": "image_url",
                    "image_url": {"url": "https://example.com/dashboard.png"}
                }
            ]
        }
    ],
)
Valida tamaño de imagen, accesibilidad de la URL, preprocesamiento, uso de tokens y latencia en la ruta exacta de CometAPI usada en producción.
Transmite respuestas con SSE
El streaming reduce la latencia percibida al entregar salida incremental a interfaces interactivas de programación, chat y agentes.
stream = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[
        {
            "role": "user",
            "content": "Explain distributed-cache invalidation."
        }
    ],
    stream=True,
)

for chunk in stream:
    if chunk.choices and chunk.choices[0].delta.content:
        print(chunk.choices[0].delta.content, end="", flush=True)
Los clientes de producción deben manejar streams interrumpidos, deltas vacíos, recuperación por timeout, límites de reintentos y contabilidad final de uso.
¿Cuánto cuesta la API DeepSeek V4.1 Flash?
La tarificación documentada de la API de DeepSeek usa ventanas de horas pico y valle. La imagen oficial de precios muestra tarifas en horas valle de $0.003/M por lectura de caché (acierto), $0.15/M por entrada con fallo de caché y $0.60/M por salida; las tarifas en horas pico son el doble.
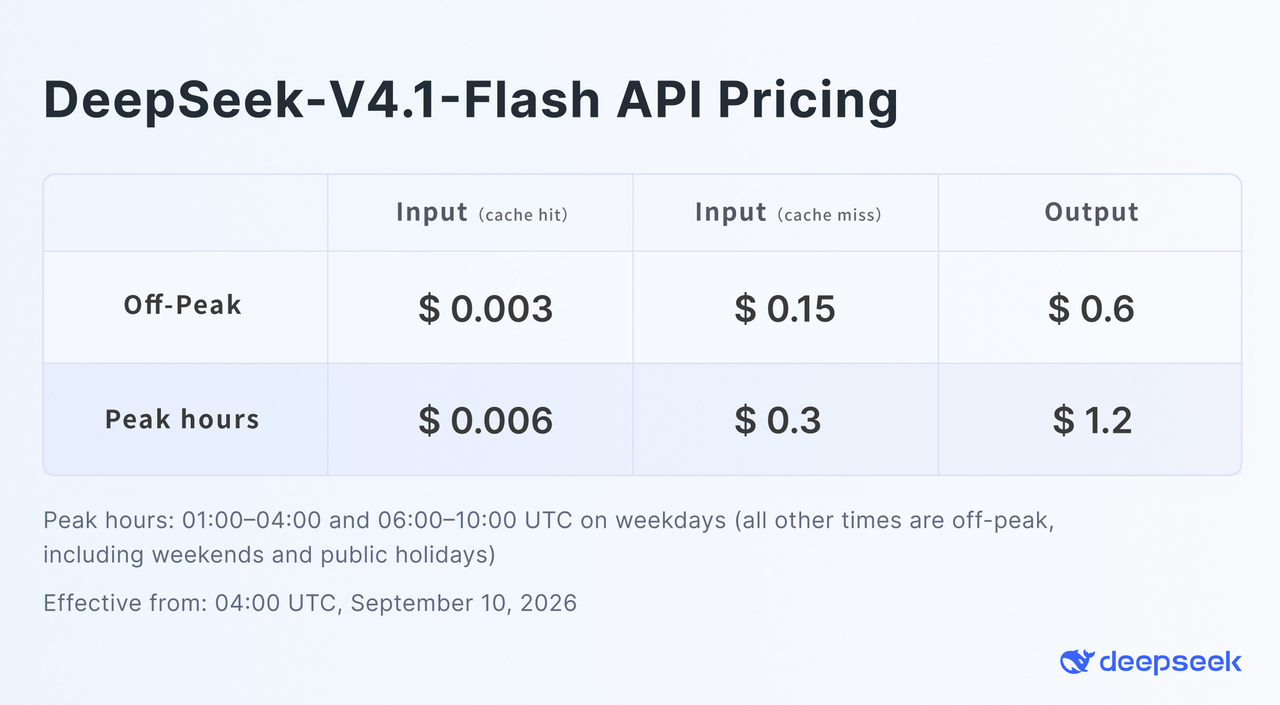
¿Precios oficiales de la API DeepSeek V4.1 Flash? fuente oficial de la imagen
Un ejemplo simple a tarifa base para 100M tokens de entrada por fallo de caché y 20M tokens de salida es:
Input:
100 x $0.12 = $12.00

Output:
20 x $0.48 = $9.60

Total base cost:
$21.60
El costo real en producción depende de la mezcla de tokens en caché, multiplicadores de pico, condiciones de solicitud y la tarifa vigente del proveedor. La gran diferencia entre precios por acierto y por fallo de caché hace que los prefijos reutilizables estables —instrucciones de sistema, esquemas de herramientas y contexto común— sean una palanca de costo importante.
API DeepSeek V4.1 Flash vs V4 Pro vs V4 Flash
Estado actual: la documentación en vivo de DeepSeek
Models & Pricing documentation
indica que DeepSeek V4 Pro sigue disponible después del 14 de septiembre de 2026, con facturación sin cambios. Verifica la documentación en vivo antes de depender del enrutamiento o el comportamiento de migración.
¿Qué debes probar antes de llevar la API DeepSeek V4.1 Flash a producción?
- Enrutamiento de modelo: confirma deepseek-v4.1-flash en CometAPI y mantén IDs específicos de proveedor en la configuración, no en la lógica de la aplicación.
- Regresión de prompts: ejecuta prompts representativos de producción y compara finalización de tareas, no solo puntuaciones de benchmark.
- Salida estructurada: valida cada respuesta JSON contra el esquema de la aplicación y define una ruta de reparación o reintento.
- Llamadas a herramientas: prueba tipos de argumentos, llamadas malformadas, llamadas en paralelo y condiciones de terminación de bucles.
- Controles de pensamiento: verifica qué campos CometAPI transmite y mide el impacto en latencia y tokens de cada ajuste.
- Visión: prueba capturas reales y documentos, incluidos límites de tamaño, URLs inaccesibles y roles de mensaje no soportados.
- Streaming: maneja deltas vacíos, conexiones interrumpidas, límites de reintento y contabilidad final de uso.
Para cargas de agentes, compara el costo por tarea completada, no solo dólares por millón de tokens. Un modelo puede ser más caro por token de salida y aun así resultar más barato extremo a extremo si reduce reintentos y llamadas a herramientas; lo contrario también ocurre cuando un mayor esfuerzo de razonamiento añade tokens sin mejorar la finalización.
¿Vale la pena usar la API DeepSeek V4.1 Flash?
Para nuevas integraciones con DeepSeek, DeepSeek V4.1 Flash es un fuerte candidato predeterminado dentro de la familia Flash porque combina mejor rendimiento publicado en agentes con visión nativa y precios agresivos.
Sus casos de uso más sólidos no son solo chat genérico. El mejor encaje es para agentes de programación, ingeniería de software automatizada, análisis de contexto largo, asistentes multimodales, automatización de flujos de alto volumen y agentes que usan herramientas donde el contexto reutilizado puede dominar el costo total.
Para desarrolladores que desean mantener una arquitectura de SDK al estilo OpenAI, la API DeepSeek V4.1 Flash en CometAPI ofrece el patrón de integración usado en toda esta guía: mantén la interfaz estándar del cliente, apúntala a https://api.cometapi.com/v1 y usa deepseek-v4.1-flash.
Preguntas frecuentes sobre la API DeepSeek V4.1 Flash
¿Cómo debo organizar los IDs de modelo específicos de proveedor?
Almacena el proveedor, la URL base y el ID del modelo juntos en la configuración específica del entorno. Esto evita que un ID de primer nivel como deepseek-flash se envíe por error a una ruta de CometAPI que espera deepseek-v4.1-flash.
¿Cómo puedo mejorar la reutilización de caché en agentes de larga ejecución?
Mantén instrucciones de sistema estables, esquemas de herramientas y contexto de referencia compartido al inicio del prompt. Agrega después la entrada volátil del usuario y los resultados de herramientas para que el prefijo reutilizable cambie menos.
¿Cuál es la forma más segura de comparar V4.1 Flash con V4 Pro?
Repite el mismo conjunto de tareas de producción, limita presupuestos de reintentos y compara tasa de finalización, latencia, conteo de llamadas a herramientas y tokens totales. Un precio por token más bajo no garantiza un costo menor por tarea exitosa.
¿Qué política de fallback debería usar un agente?
Define qué fallos son reintentables, establece un techo estricto de reintentos y selecciona un modelo de fallback solo después de preservar el estado de las herramientas necesario para reanudar con seguridad. Registra cada fallback para que cualquier deriva silenciosa de calidad sea visible.
¿Cómo deben validarse las entradas de imagen antes de enviarlas?
Comprueba la firma real del archivo, formato soportado, tamaño en bytes, accesibilidad de la URL y el rol del mensaje. Elimina metadatos innecesarios y evita enviar imágenes sensibles salvo que tus políticas de retención y acceso lo permitan explícitamente.
¿Cuándo debería considerar Responses API en lugar de Chat Completions?
Usa Chat Completions cuando mantengas un flujo de mensajes compatible con OpenAI existente. Considera Responses API cuando la aplicación se beneficie de ítems de entrada tipados, imágenes de salida de herramientas o salida con JSON Schema; después confirma que la ruta del proveedor seleccionada soporte los campos requeridos.
¿Cómo debo manejar fallos de validación de esquema?
Rechaza la salida inválida antes de que llegue a sistemas downstream, registra el error de validación y reintenta con un prompt de reparación acotado. Si la reparación falla repetidamente, enruta la tarea a un fallback seguro en lugar de aceptar JSON plausible pero inválido.