
TL;DR
DeepSeek V4.1 Flash는 552B-파라미터 인과적 인코더–디코더 MoE 모델, 네이티브 이미지 이해, 1M 토큰 컨텍스트 윈도우, 그리고 크게 낮아진 서빙 비용으로 이전 V4 Flash 세대를 대체한다. DeepSeek의 공식 비교에 따르면, 코딩, 터미널, 보안, 에이전트 벤치마크 대부분에서 V4 Pro 0813 대비 개선되었으며, GPQA Diamond와 도구 없는 HLE에서는 여전히 V4 Pro가 앞선다.
DeepSeek의 현재 API 가격 페이지는 다시 한 번 V4.1 Flash와 V4-Pro-0813을 각각 제공하는 deepseek-flash와 deepseek-v4-pro를 별도 라우트로 명시한다. 이들은 가격, 동시성 한도, 비전 지원이 다르다. 따라서 신규 통합은 과거 별칭 동작에 의존하지 말고 의도한 워크로드에 맞는 모델 ID를 선택해야 한다.
Key Takeaways
- V4.1 Flash와 V4 Pro는 현재 공식 API에서 별개의 선택지다: V4.1 Flash에는 deepseek-flash, V4-Pro-0813에는 deepseek-v4-pro를 사용하라.
- 가장 큰 비교상 이득은 터미널 작업, 코딩 에이전트, 자동화, 보안 지향 실행에서 나타나며, 모든 폐쇄형 추론 벤치마크에서 그런 것은 아니다.
- V4.1 Flash는 캐시-히트 입력, 캐시-미스 입력, 출력 토큰 전 영역에서 현재 명시된 V4 Pro 라우트 대비 실질적으로 저렴하다.
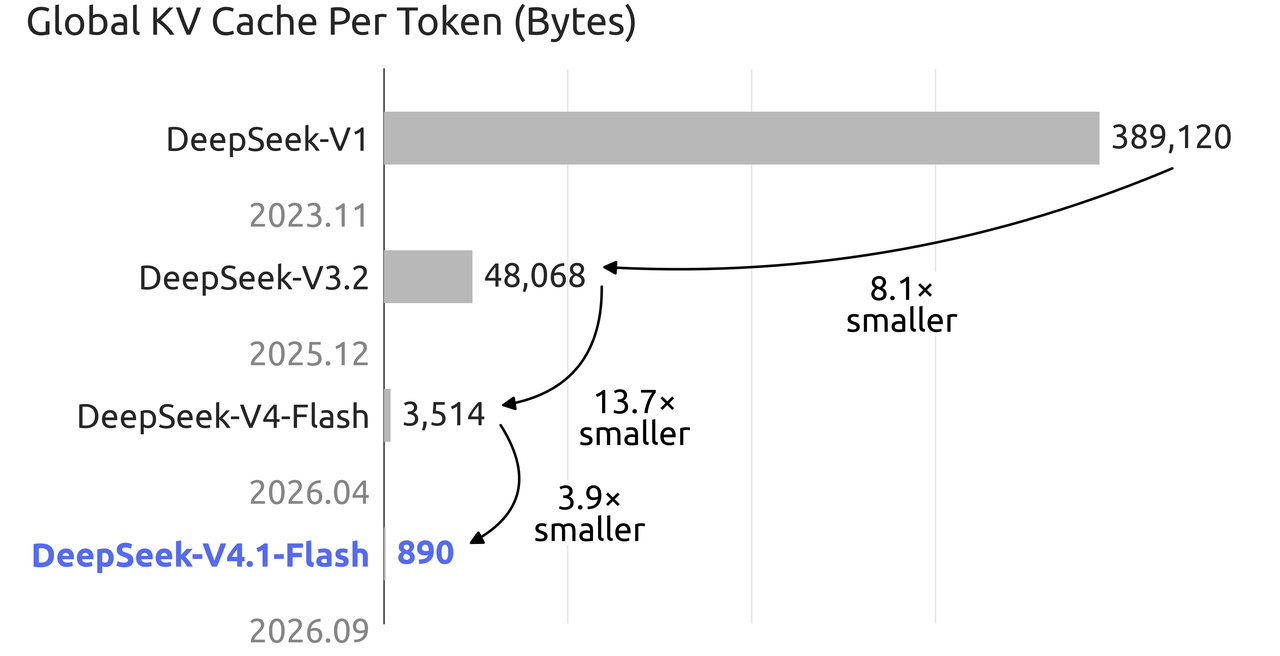
- V4.1 Flash는 네이티브 비전을 추가하고, 문서화된 동시성을 500에서 2,500으로 높였으며, 글로벌 KV-캐시 저장 용량을 토큰당 890바이트로 줄였다.
- 별칭이 동작하더라도 마이그레이션은 명시적으로 하라: 모델 ID를 업데이트하고, 생각/비생각 모드를 검증하며, 도구 호출과 이미지 입력을 재테스트하고, 토큰 사용량과 지연 시간을 모니터링하라.
Current routing note: 공식 가격 페이지는 deepseek-v4-pro를 V4-Pro-0813으로 표시하며, V4.1 Flash와 별개다.
How Do DeepSeek V4.1 Flash and V4 Pro Specifications Compare?
아키텍처는 V4 Pro의 매우 큰 스파스 MoE 설계에서 V4.1 Flash의 비대칭 인과적 인코더–디코더 설계로 변경되었다. 최신 모델은 입력 처리 시 활성화 파라미터를 출력 생성 시보다 적게 사용하여 프리필 비용을 줄이면서도 강한 생성 능력을 유지한다.
| Specification | DeepSeek V4.1 Flash | DeepSeek V4 Pro 0813 |
|---|---|---|
| Architecture | Causal encoder–decoder MoE | Sparse MoE |
| Total parameters Backbone parameters / repository weight count | 백본 파라미터 552B; Hugging Face에 763B 모델 크기 표기 | 백본 파라미터 1.6T; Hugging Face에 약 1.7T 모델 크기 표기 |
| Active parameters | 입력 8B; 출력 16B | 토큰당 49B |
| Context window | 1M tokens | 1M tokens |
| Maximum output | 384K tokens | 384K tokens |
| Thinking and non-thinking modes | Supported | Supported |
| Native image understanding | Supported | Not supported |
| Documented concurrency | 2,500 | 현재 구성에서 500 |
| Current official API status | deepseek-flash로 활성 | deepseek-v4-pro(V4-Pro-0813)로 활성 |
Parameter-count clarification: DeepSeek의 V4.1 Flash 모델 카드에는 552B의 백본 파라미터가 기재되어 있으며, Hugging Face 리포지토리에는 763B 모델 크기가 보고되어 있다. 이 수치는 서로 다른 범위를 설명하므로 상호 교환 가능한 총합으로 제시해서는 안 된다.
Output-length clarification: V4.1 Flash 모델 카드는 로컬 추론에서 max_tokens ≥ 256K를 권장하지만, DeepSeek의 현재 API 가격 페이지는 두 API 모델 모두에 대해 명시적으로 최대 출력 384K를 표기한다. 권장 추론 설정은 API가 강제하는 최대치와 동일하지 않다.
Where Does DeepSeek V4.1 Flash Improve on V4 Pro?
DeepSeek의 공식 벤치마크 표는 실행 중심 워크로드에서 가장 명확한 개선을 보여준다. 아래 퍼센트 열은 공개 점수를 기반으로 계산되었으며, 지표가 평점이거나 단순 퍼센트가 오해를 불러올 수 있는 경우에는 퍼센트 비교를 생략했다.
| Benchmark | V4.1 Flash | V4 Pro 0813 | Difference | Interpretation |
|---|---|---|---|---|
| Terminal-Bench 2.1 | 90.6 | 87.9 | +2.7 points; +3.1% | 보다 신뢰할 수 있는 터미널 실행 |
| Terminal-Bench 3.0 | 30.0 | 11.8 | +18.2 points; +154.2% | 더 어려운 터미널 작업에서 큰 향상 |
| Terminal-Bench 4.0 | 31.2 | 12.4 | +18.8 points; +151.6% | 최신 터미널 작업에서 큰 향상 |
| DeepSWE v1.1 | 74.2 | 62.7 | +11.5 points; +18.3% | 저장소 수준 소프트웨어 작업 강화 |
| ProgramBench | 20.3 | 15.5 | +4.8 points; +31.0% | 프로그램 합성 향상 |
| NL2Repo-Bench | 64.0 | 61.5 | +2.5 points; +4.1% | 자연어→리포지토리 작업 개선 |
| CyberGym | 88.1 | 83.3 | +4.8 points; +5.8% | 사이버 작업 실행 강화 |
| HLE with tools | 63.9 | 60.0 | +3.9 points; +6.5% | 도구 보강 추론 강화 |
| Automation-Bench | 54.8 | 43.2 | +11.6 points; +26.9% | 실질적 자동화 성능 향상 |
| Agents’ Last Exam | 31.8 | 25.7 | +6.1 points; +23.7% | 일반 에이전트 행동 강화 |
| Codeforces rating | 3,471 | 3,348 | +123 rating points | 경쟁 프로그래밍 향상 |
| GPQA Diamond | 90.9 | 92.4 | −1.5 points | V4 Pro가 우위 유지 |
| HLE without tools | 36.8; 39.1 on text subset | 42.7 on text subset | −3.6 points on comparable text subset | V4 Pro가 우위 유지 |

결과는 다차원적이다: V4.1 Flash는 코딩 에이전트, 터미널 운영, 자동화, 보안 작업, 도구 사용, 비전, 동시성, 비용 측면에서 결정적으로 더 낫다. V4 Pro의 잔존 우위는 선택된 순수 추론 테스트에 집중되어 있다. 따라서 워크로드는 단일 총합 주장보다 작업 믹스 기준으로 평가해야 한다.
Why Is DeepSeek V4.1 Flash More Efficient Than V4 Pro?
Asymmetric input and output compute
V4.1 Flash는 입력 처리 중 8B, 출력 생성 중 16B 파라미터를 활성화한다. 이러한 비대칭 설계는 프리필과 디코딩의 상이한 연산 요구를 겨냥하여, 두 단계 모두를 동일한 활성 파라미터 예산에 통과시키지 않고 비용을 줄인다.
Smaller KV-cache footprint
DeepSeek는 V4.1 Flash가 이전 세대의 KV 캐시에 비해 HBM은 1/4, SSD 용량은 1/8만 필요하다고 보고한다. 공개된 차트는 글로벌 KV 캐시가 토큰당 890바이트이며, V4 Flash의 3,514바이트와 비교된다고 제시한다.
Native multimodal input and higher concurrency
V4.1 Flash는 이미지를 네이티브로 해석할 수 있으며, 문서화된 동시성 한도가 2,500으로 노출되어 현재 V4 Pro 수치 500의 5배다. 이 변화는 스크린샷 기반 에이전트, 문서 추출, 비주얼 트러블슈팅, 고볼륨 프로덕션 큐에서 중요하다.
What Does DeepSeek V4.1 Flash Cost Compared with V4 Pro?
현재 공식 API 요금표는 두 라우트를 별도로 가격 책정한다. 100만 토큰당, V4.1 Flash는 캐시-히트 입력 $0.003/$0.006, 캐시-미스 입력 $0.15/$0.30, 출력 $0.60/$1.20(오프피크/피크)이다. V4 Pro는 각각 $0.022/$0.044, $0.66/$1.32, $1.98/$3.96이다. 가격은 변동될 수 있으므로, 프로덕션 예산은 실시간 가격 페이지를 참고해야 한다.
How Should You Migrate from DeepSeek V4 Pro or V4 Flash to V4.1 Flash?
Use the explicit production model ID
V4.1 Flash를 원할 때는 deepseek-flash를 사용하라. 이전의 deepseek-v4-flash와 deepseek-v4-flash-vision-exp 이름은 여전히 V4.1 Flash로 라우팅되지만, 명시적 네이밍은 모니터링과 향후 롤백을 감사하기 쉽게 한다. 현재 기재된 V4-Pro-0813 백엔드를 의도적으로 원할 때는 deepseek-v4-pro를 사용하라.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_DEEPSEEK_API_KEY",
    base_url="https://api.deepseek.com",
)

response = client.chat.completions.create(
    model="deepseek-flash",  # 또는 "deepseek-v4-pro"
    messages=[{"role": "user", "content": "이 마이그레이션 계획을 검토해 주세요."}],
)

print(response.choices[0].message.content)
Retest behavior, not only endpoint compatibility
- 대표 프롬프트를 생각 모드와 비생각 모드 모두에서 실행하고, 작업 성공률, 토큰 수, 지연 시간을 비교하라.
- 도구 스키마, JSON 출력, Responses API 동작, prefix completion, FIM 사용 시 재검증하라.
- 제품이 새로운 네이티브 비주얼 기능을 사용할 예정이라면 이미지 입력 테스트를 추가하라.
- V4 Pro 가정을 이어받지 말고 피크/오프피크 요율로 예산을 재기준화하라.
- 프롬프트 캐시 적중률을 추적하라. 대규모에서는 입력 비용을 지배할 수 있다.
Choose the intended backend explicitly
현재 deepseek-v4-pro 라우트는 V4-Pro-0813을 선택한다. 팀은 라우팅이 다시 변경되더라도 비교 가능성을 유지하기 위해, 해석된 모델 버전, 평가 날짜, 프롬프트 세트, 가격 책정 구간을 기록해야 한다.
Which Workloads Fit DeepSeek V4.1 Flash Best?
| Workload | Recommended choice | Reason |
|---|---|---|
| Coding agents and repository maintenance | V4.1 Flash | DeepSWE, ProgramBench, NL2Repo, 터미널 점수가 더 높음 |
| Tool-driven automation | V4.1 Flash | Automation-Bench, 도구-보강 HLE, 에이전트 점수가 더 높음 |
| Image-aware assistants | V4.1 Flash | 네이티브 이미지 이해 |
| High-throughput or cost-sensitive serving | V4.1 Flash | 더 높은 동시성과 훨씬 낮은 토큰 가격 |
| Historical V4 Pro reproductionCurrent V4 Pro access and evaluation | V4 Pro | 공식 라우트가 현재 V4-Pro-0813으로 표시됨 |
| Pure closed-book reasoning | Validate on domain data | GPQA Diamond와 도구 없는 HLE에서 V4 Pro가 더 높으므로 검증 필요 |
DeepSeek V4.1 Flash vs V4 Pro FAQ
Is DeepSeek V4.1 Flash better than V4 Pro?
대부분의 프로덕션 차원—코딩 에이전트, 터미널 작업, 자동화, 도구 사용, 비전, 처리량, 가격—에서는 그렇다. GPQA Diamond와 도구 없는 HLE의 공개 점수에서는 여전히 V4 Pro가 강하므로, 순수 추론 워크로드는 도메인별 프롬프트로 테스트해야 한다.
Can I still call deepseek-v4-pro?
가능하다. 현재 공식 API 페이지는 deepseek-v4-pro를 V4-Pro-0813으로 표기하며, 자체 가격과 동시성 한도를 가진다.
What model ID should a new integration use?
V4.1 Flash에는 deepseek-flash, V4-Pro-0813에는 deepseek-v4-pro를 사용하라. 두 ID를 별칭으로 취급하지 말라.
Do old V4 Flash model IDs still work?
DeepSeek는 deepseek-v4-flash와 deepseek-v4-flash-vision-exp 요청이 자동으로 V4.1 Flash로 라우팅되며 새로운 Flash 가격이 적용된다고 명시한다. 그럼에도 명확성을 위해 구성된 모델 ID를 업데이트하는 것이 권장된다.
Does DeepSeek V4.1 Flash support images?
예. 네이티브 이미지 이해는 V4.1 Flash의 일부이며, 과거 V4 Pro API는 이 기능을 제공하지 않았다.
Is DeepSeek V4.1 Flash cheaper than the current V4 Pro?
예. 현재 공식 요금표는 V4.1 Flash가 V4 Pro보다 캐시-히트 입력, 캐시-미스 입력, 출력 가격이 모두 낮다고 명시한다.
Should I expect identical outputs after migration?
아니오. 엔드포인트 호환성은 동일한 추론 경로, 도구 선택, 토큰 사용, 서식을 보장하지 않는다. 이전 임계값에 의존하기 전에 프로덕션 평가를 재실행하라.