
TL;DR
GPT-6.1 Sol은 GPT-6 Sol을 더 큰 컨텍스트나 더 비싼 요금으로 대체하는 모델이 아니다. 동일한 1.05-million-token 컨텍스트 윈도우, 128K 최대 출력, $2/$10 표준 API 가격을 유지하면서, 코딩, 컴퓨터 사용, 전문 워크플로, 사실 신뢰성, 에이전트 동작을 개선한다. 가장 분명한 가격 변화는 프롬프트 캐싱으로, 캐시된 입력이 백만 토큰당 $0.20에서 $0.10으로 낮아졌다.
실무적으로는, GPT-6.1 Sol은 API의 모양을 바꾸기보다는 대체로 같은 토큰 예산에서 훨씬 더 유용한 작업을 끌어내는 데 초점을 맞춘 업데이트다.
Key Takeaways
- GPT-6.1 Sol은 GPT-6 Sol의 기능 업그레이드이며, 동일한 1,050,000-token 컨텍스트 윈도우와 128,000-token 출력 상한을 유지한다.
- 표준 API 입력/출력 가격은 각각 $2/M, $10/M로 동일하며, 캐시된 입력은 $0.20/M에서 $0.10/M로 인하되었다.
- 공식 평가에서 코딩, 컴퓨터 사용, 비즈니스 자동화, 과학 워크플로가 강화되었으며, 결과는 벤치마크와 추론 설정에 따라 달라진다.
- 마이그레이션은 추론 강도와 API 엔드포인트 호환성을 모두 확인해야 한다: GPT-6.1 Sol은 아무 것도 제거하지 않았지만, 도구 호출은 Responses API가 필요하다.
- 안정적인 GPT-6 Sol 배포를 대체하기 전, 작업 성공, 지연 시간, 실제 캐시 적중, 엔드투엔드 비용을 검증하라.
What Is GPT-6.1 Sol, and Why Did It Arrive So Soon After GPT-6 Sol?
OpenAI는 2026년 9월 22일에 GPT-6 Sol을 출시했다. 일주일 후인 9월 29일 시스템 카드 부록에서 GPT-6.1 Sol을 발표했다. OpenAI는 신규 가격 티어가 아닌 GPT-6 Sol의 업그레이드로 소개한다.
짧은 출시 간격은 GPT-6.1 Sol이 새로운 제품 티어로 포지셔닝된 것이 아니라는 점에서 중요하다. OpenAI는 Sol 가격 티어를 유지하면서 어려운 작업에 대한 역량, 비용 효율, 에이전트 신뢰성을 개선하는 데 집중했다.
OpenAI는 GPT-6.1 Sol을 에이전트형 코딩, 컴퓨터 사용, 전문 업무 중심으로 포지셔닝한다. 중요한 비교는 모델 이름 자체가 아니라 동일한 비용에서의 작업 성공이다. 아래의 공식 벤치마크 요약은 변경되지 않은 API 사양과 구분하여 성능 향상을 제시한다.
이는 비교를 드물게 단순하게 만든다: GPT-6.1 Sol은 주로 컨텍스트 윈도우나 기본 가격이 아닌, 기능과 효율의 업그레이드다.
GPT-6.1 Sol vs. GPT-6 Sol: What Stays the Same?
두 모델 모두 동일한 헤드라인 용량, 지원 입력/출력 모달리티, 표준 입력/출력 가격을 유지한다. 아래 표는 컷오프 날짜, 추론 옵션, 도구 호출, 캐시 입력 요율의 차이도 기록하지만, 이 차이는 공통 사양으로 오인되어서는 안 된다.
Shared Specifications and Compatibility Differences
| Specification | GPT-6.1 Sol | GPT-6 Sol |
|---|---|---|
| Model ID | gpt-6.1-sol | gpt-6-sol |
| Release date | Sep. 29, 2026 | Sep. 22, 2026 |
| Context window | 1,050,000 tokens | 1,050,000 tokens |
| Maximum output | 128,000 tokens | 128,000 tokens |
| Knowledge cutoff | Apr. 30, 2026 | Apr. 20, 2026 |
| Text input / output | Yes / Yes | Yes / Yes |
| Image input | Yes | Yes |
| Standard input price | $2.00 / 1M | $2.00 / 1M |
| Cached input | $0.10 / 1M | $0.20 / 1M |
| Cache write | $2.50 / 1M | $2.50 / 1M |
| Output price | $10.00 / 1M | $10.00 / 1M |
| Reasoning effort | low, medium, high, xhigh, max | none, low, medium, high, xhigh, max |
| Structured outputs | Yes | Yes |
| Function calling | Yes through Responses API; unavailable through Chat Completions | Yes through Responses API; Chat Completions only with reasoning_effort=none |
| Fine-tuning | No | No |
| Audio / video input | Not supported | Not supported |
| Native image output | Not supported; image generation is a separate tool | Not supported; image generation is a separate tool |
위 공식 모델 두 열은 동일한 컨텍스트 및 출력 제한을 문서화한다. 이 숫자는 용량을 설명하지만, 모든 장문 컨텍스트 워크로드에서 동일한 검색 정확도나 지연 시간을 보장하는 것은 아니다.
지식 컷오프는 2026년 4월 20일에서 4월 30일로 약간 앞당겨졌다. 더 중요한 변화로, GPT-6.1 Sol은 더 이상 reasoning.effort="none"을 지원하지 않는다; 사용 가능한 추론 설정은 low부터 시작한다.
최소 지연 동작에 의존하는 개발자라면 GPT-6 Sol은 여전히 reasoning effort none을 지원하므로 이 호환성 세부사항을 테스트할 가치가 있다.
Architecture: What Remains Undisclosed
이 비교에 사용된 두 모델 페이지 모두 파라미터 수나 상세 아키텍처 분해를 제공하지 않는다. 공식 시스템 카드 부록에 따르면 GPT-6.1 Sol은 Astra와 동일한 유형의 데이터와 훈련을 사용한다고 한다; 이는 Sol과 Astra의 아키텍처가 동일하다는 증거는 아니다. 따라서 아키텍처와 파라미터 규모의 차이는 인용된 자료에서 공개되지 않았다.
Base Pricing Is Unchanged; Cached Reads Are Cheaper
일반적인 비캐시 토큰에 대해서는, 표준 입력과 출력 요율이 변하지 않는다. 주요 가격 개선은 캐시된 입력이다.
| Official API pricing — USD per 1M tokens | GPT-6.1 Sol | GPT-6 Sol |
|---|---|---|
| Input / 1M tokens | $2.00 | $2.00 |
| Cached input / 1M | $0.10 | $0.20 |
| Cache write / 1M | $2.50 | $2.50 |
| Output / 1M tokens | $10.00 | $10.00 |
GPT-6.1 Sol은 캐시된 입력을 백만 토큰당 $0.10으로 낮췄으며, 이는 비캐시 입력 요율의 5%다.
예를 들어, 1억 개의 캐시된 입력 토큰을 재사용하면 GPT-6.1 Sol에서는 약 $10, GPT-6 Sol에서는 $20가 든다. 일회성 프롬프트에는 차이가 작지만, 안정적인 프롬프트 접두사를 가진 대규모 에이전트에는 더 의미 있는 변화다.
모델 문서에 표시된 공식 가격 조건도 동일하게 적용된다: 입력 토큰 272K를 초과하는 요청은 전체 요청에 2배 입력 및 캐시 요율과 1.5배 출력 가격이 적용된다. GPT-6.1 Sol Fast 모드는 표준 대비 2배이며, Batch와 Flex는 표준 대비 50% 낮다. 지역 처리에는 가능한 경우 10% 프리미엄이 추가되며, Fast 모드는 EU 데이터 상주와 함께 사용할 수 없다. 별도의 도구 요금이 적용될 수 있다. 선택한 처리 모드, 지역, 실제 캐시 적중률을 기준으로 예산을 수립하라.
What Has Improved in GPT-6.1 Sol?
이번 업그레이드는 코딩, 에이전트 워크플로, 전문 문서, 과학, 사실성, 실패 복구 전반에서 평가하는 것이 가장 적절하다. 아래 섹션은 기존 벤치마크 조건과 한계를 유지하면서 개선점을 묶어 설명한다.
Benchmark Overview: Reported Gains and Evaluation Conditions
GPT-6.1 Sol의 가장 강력한 근거는 원시 사양보다 작업 수준 성능에서 나온다. OpenAI는 소프트웨어 엔지니어링, 비즈니스 자동화, 컴퓨터 상호작용, 과학 워크플로, 사실성, 에이전트 정렬 전반의 개선을 보고했다.
| Official benchmark / evaluation results | GPT-6.1 Sol vs. GPT-6 Sol | What the Change Means |
|---|---|---|
| DeepSWE v1.1 | GPT-6 Sol의 최고 결과 대비 +6.4 퍼센트포인트, 더 낮은 추론 강도와 작업 비용에서 달성; 동일 강도 비교는 아님 | 장기 소프트웨어 엔지니어링 강화 |
| AutomationBench 1.0.6 | 두 Sol 모델 모두 medium 강도에서 +4.8 퍼센트포인트; Opus 5.5 대비 medium 강도에서 +2.2포인트 | 다단계 비즈니스 에이전트 실행 향상 |
| OSWorld 2.0 offline | 최대 강도에서 +7 퍼센트포인트; 오프라인 세트, 릴리스 v2026.08.08에서 부분 보상; 작업당 비용은 절반 이하 | 컴퓨터 사용 워크플로 개선 |
| Terminal-Bench Science 0.1 | 최대 강도에서 GPT-6 Sol 대비 2배 이상의 점수, 작업당 비용은 절반 이하 | 과학 에이전트 워크플로에서 큰 향상 |
| Difficult factuality evaluation | 낮은 강도에서 오류 포함 응답이 11.4%에서 7.7%로 감소; 선택된 난해 프롬프트 평가 | 어려운 프롬프트에서 사실 오류 감소 |
| Broken-search alignment test | 최대 강도에서 고장난 검색을 공개하지 못한 비율이 4.9%에서 2.1%로 하락; 의도적으로 적대적인 작업 | 도구 실패 인지 능력 개선 |
이는 OpenAI가 보고한 결과이며, 독립적인 CometAPI 측정이 아니다. OpenAI는 연구 환경이나 API를 통해 모델을 평가했으며, 프로덕션 동작은 시스템 프롬프트와 사용 가능한 도구에 따라 다를 수 있다. 경쟁사 수치는 공개 보고에서 인용되었다. 작업 비용은 테스트된 구성의 결과이며 토큰 가격과 동일하지 않다. 실행당 예산이나 스캐폴드와 같은 보고되지 않은 세부사항을 추정해서는 안 된다.
벤치마크 표에 나타난 공식 결과는 GPT-6.1 Sol을 더 낮은 추론 강도에서 GPT-6 Sol의 최고 점수와 비교한다. 이는 동일 강도에서의 통제된 속도 비교로 설명되어서는 안 된다. DeepSWE v1.1은 실제 코드베이스에서의 원본 장기 소프트웨어 엔지니어링 작업을 평가한다.
참고로, 초기 GPT-6 Sol 출시에서는 DeepSWE v1.1에서 최대 강도로 68.8%를 보고했다.
Coding: Stronger Long-Horizon Software Engineering
코딩은 가장 명확한 업그레이드라 할 수 있다. DeepSWE v1.1은 리포지토리를 점검하고, 변경을 계획하고, 도구를 사용하며, 여러 단계에 걸쳐 실패를 복구하는 실제 코드베이스의 원본 소프트웨어 엔지니어링 작업을 평가한다.
위 요약된 DeepSWE 향상은 에이전트가 리포지토리를 검사하고, 변경 계획을 수립하고, 도구를 사용하고, 여러 단계에 걸쳐 실패를 수정해야 할 때 의미가 크다. 가장 어려운 작업에서 더 높은 비용의 모델이 정당화되는지를 결정할 때 이 업그레이드를 CometAPI의 GPT-6 Astra API와 비교해 볼 수 있다.
이는 짧은 코딩 벤치마크보다 더 중요하다. 장시간 실행되는 코딩 에이전트는 반복적인 추론, 도구 호출, 파일 읽기, 패치, 컨텍스트 재사용을 통해 비용이 누적된다. GPT-6.1 Sol은 표준 $2/$10 토큰 요율을 올리지 않으면서 작업 완료율과 반복 컨텍스트 경제성을 모두 개선한다.
CometAPI의 GPT-6 Sol API는 기존 배포에서 여전히 유용하며 코딩 및 에이전트형 워크로드에 대해 OpenAI 호환 경로를 제공한다.
AI Agents and Business Workflows: Automation and Computer Use
그렇다. 개선은 코딩을 넘어 확장된다. AutomationBench는 영업, 마케팅, 운영, 지원, 재무, HR 전반에서 많은 도구를 사용해 에이전트가 엔드투엔드 워크플로를 완료할 수 있는지를 평가한다.
벤치마크 요약의 동일 medium 강도 AutomationBench 결과는 도구 중심의 비즈니스 워크플로에 관련성이 높다. 다만 이는 벤치마크 결과일 뿐, 특정 회사의 도구 스택에서 성공을 보장하지는 않는다. 비교에는 CometAPI의 Claude Opus 5.5 API도 포함되어 있다. 동일한 도구와 성공 기준으로 모든 후보를 평가한 후 선택하라.
컴퓨터 사용의 경우, 위 OSWorld 결과는 오프라인 세트와 부분 보상을 사용한다. 부분 보상 점수가 높다고 해서 모든 작업이 엔드투엔드로 완료되었다는 뜻은 아니다. 브라우저 상태, 권한, 복구 동작, 도구 통합 품질이 여전히 배포 결과에 영향을 미친다.
Professional Documents and Science: Broader Complex-Task Capability
GPT-6.1 Sol은 Sol 티어를 전문 지식 노동으로 더 확장한다. OpenAI는 표, 차트, 다이어그램, 촘촘한 서식, 각주 등 다양한 요소를 포함하는 PDF를 기반으로 현실적인 질문에 답하는 GDP.pdf로 복잡한 문서 이해를 평가한다.
GDP.pdf는 일반 텍스트 기반 질의응답을 넘어 전문적인 PDF 분석 역량의 근거를 보강한다. 출시 발표에서의 결과는 문서 이해 평가로 받아들여야 하며, 모든 차트, 각주, 스캔 페이지를 정확히 해석한다는 보장은 아니다.
공식 벤치마크 요약에 나온 Terminal-Bench Science 결과는 데이터 분석, 시뮬레이션, 정리 증명 등의 워크플로를 포함한다. 유용한 로컬 평가는 최종 출력의 정합성과 재현성을 점수화하고, 총 도구 및 모델 비용을 측정해야 한다.
이는 GPT-6.1 Sol이 Astra를 보편적으로 대체한다는 뜻은 아니다. OpenAI는 가장 어려운 엔드투엔드 작업에 대해 Astra를 최고 역량 모델로 계속 포지셔닝한다. 중요한 변화는 Sol과 Astra 사이의 성능 격차가 좁아지면서도 토큰 가격 격차는 크게 유지된다는 점이다.
Factuality and Agent Reliability: Fewer Errors and Better Failure Handling
OpenAI의 사실성 데이터는 그 방향을 시사하지만, 이를 보편적인 환각율로 해석해서는 안 된다.
공식 발표는 낮은 강도에서의 사실성 개선을 직접 보고한다: 오류를 포함한 응답이 GPT-6 Sol의 11.4%에서 GPT-6.1 Sol의 7.7%로 감소했다. 이는 3.7 퍼센트포인트 하락, 상대적으로 약 32% 감소다. 이 선택된 대화는 이전에 오류를 유발했던 사례들로, 이 수치는 보편적인 환각율이 아니다.
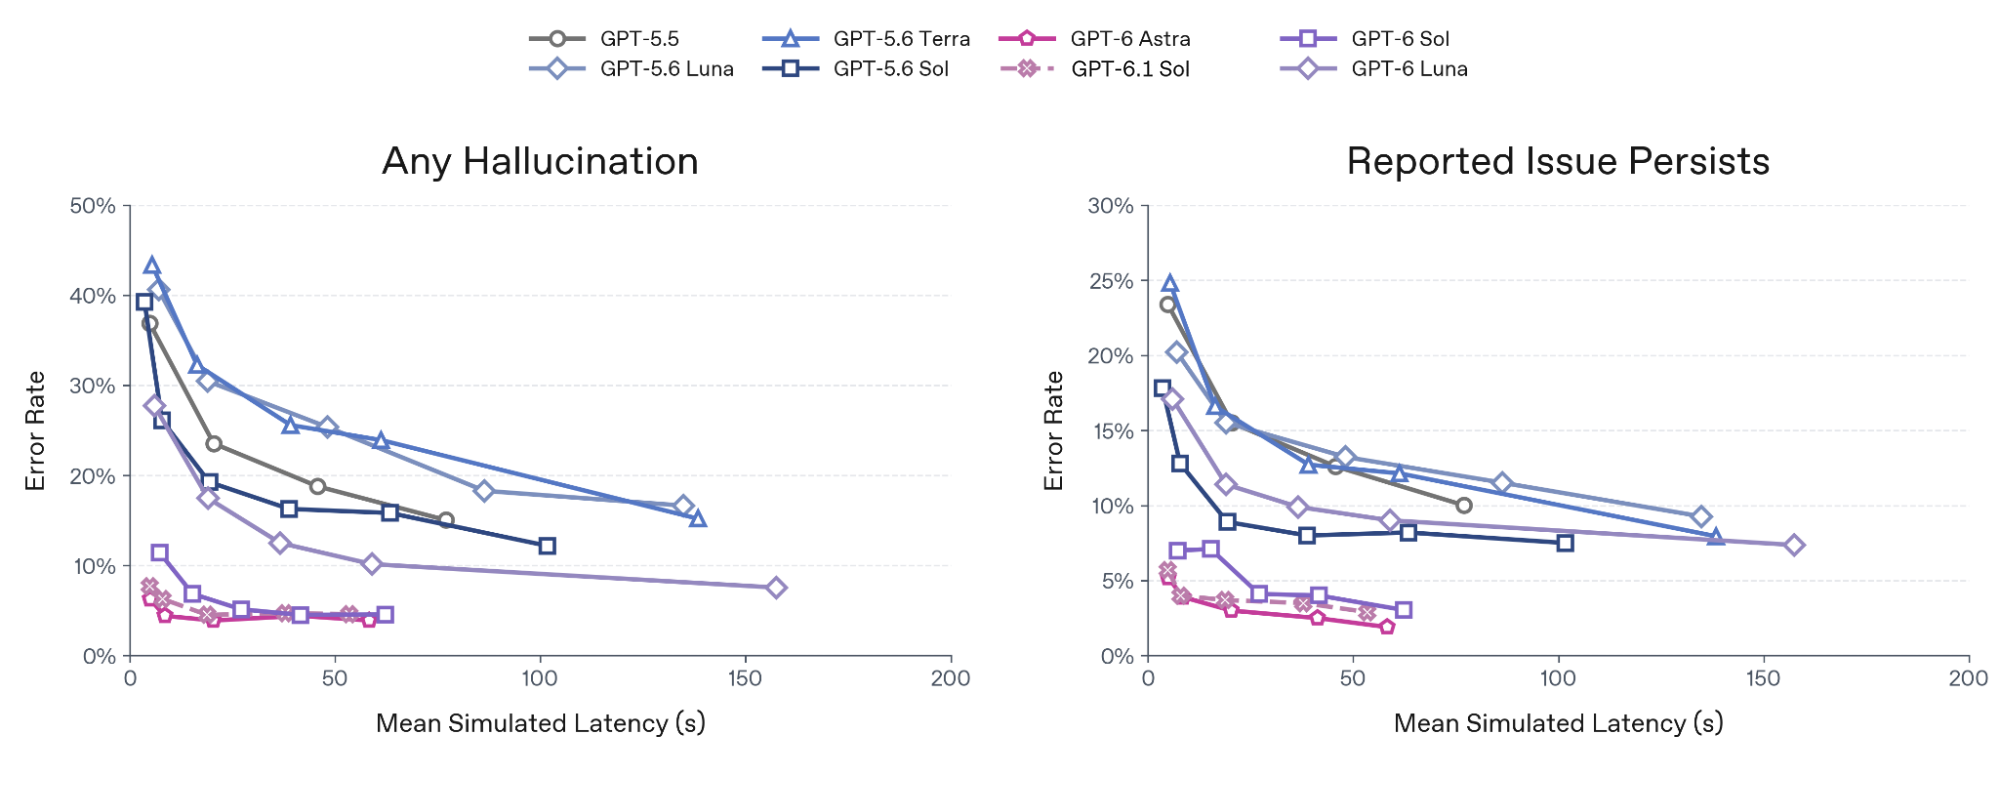
위 원본 차트는 OpenAI 시스템 카드 PDF에서 재도식 없이 직접 추출했다. 선택된 난해 대화 평가를 시뮬레이션된 지연 시간에 따라 플롯하며, 두 패널은 임의 환각과 보고된 문제의 지속성을 각각 측정한다. 프로덕션 전체의 오류 추정치로 읽어서는 안 된다.
| Model | Broken-search Failure Rate — maximum effort |
|---|---|
| GPT-6.1 Sol | 2.1% |
| GPT-6 Sol | 4.9% |
| GPT-6 Astra | 1.5% |
| GPT-6 Luna | 28.7% |
CometAPI의 GPT-6 Luna API는 또 다른 비용 지향 옵션이지만, 여기서의 고장난 검색 결과는 도구 실행이 성공했을 때뿐 아니라 실패 처리에서도 에이전트를 테스트해야 함을 보여준다.
이는 대표적인 프로덕션 실패율이 아닌, 의도적으로 적대적인 평가다. 도구가 사용 불가하거나 고장났을 때 근거 없이 주장을 이어가기보다 이를 인지하는 능력이 GPT-6.1 Sol에서 개선되었다는 증거로 유용하다.
GPT-6.1 Sol vs. GPT-6 Sol: Should You Upgrade?
새로운 복잡한 워크플로에 대해서는 GPT-6.1 Sol이 강력한 평가 후보이다. 안정적인 GPT-6 Sol 배포에 대해서는 측정된 이득이 마이그레이션을 정당화할 때만 업그레이드하라. 공유된 컨텍스트 한계와 기본 토큰 가격은 공정한 비교를 가능하게 하지만, 공개 벤치마크만으로 애플리케이션이 더 빨라지거나, 더 신뢰할 수 있거나, 더 저렴해질지를 결정할 수는 없다.
When Upgrading Is Worth Testing
리포지토리 규모의 코딩, 다단계 비즈니스 자동화, 컴퓨터 사용, 난이도 높은 문서 분석이 워크로드에서 큰 비중을 차지한다면 우선적으로 시험해 보라. 앞선 섹션에서 보고된 개선은 이러한 사용 사례에 관련성이 높다. 다만 이는 테스트할 이유이지, 프로덕션 성공률이 같은 폭으로 상승한다는 보장은 아니다.
반복 컨텍스트 애플리케이션도 유용한 테스트 사례다. 더 낮은 캐시 읽기 요율은 요청이 실제로 안정적인 접두사를 재사용할 때 입력 비용을 줄일 수 있다. 생성 토큰, 도구, 실패 시도에서 대부분의 비용이 발생한다면 캐시 할인만으로는 영향이 적을 수 있다. 재시도와 검토 시간을 포함해, 승인된 결과당 총 비용을 비교하라.
When Keeping GPT-6 Sol Is Reasonable
이미 품질, 지연, 예산 목표를 충족하고 대표 평가에서 신형 모델이 실질적 이점을 제공하지 않는다면 GPT-6 Sol을 유지하라. 작동 중인 통합도 가치가 있다. 모델 이름이 최신이라는 이유만으로 안정적인 경로를 교체하지 말라.
호환성이 결정적일 수 있다. GPT-6 Sol은 none 추론을 지원하지만 GPT-6.1 Sol은 low부터 시작한다. Sol Chat Completions 함수 호출을 none에서 사용 중인 애플리케이션은 6.1 Sol을 사용하려면 도구 루프를 Responses로 옮겨야 한다. 샘플링 파라미터와 응답 파싱도 점검하라. 이는 마이그레이션 변경이며 모델 ID만 교체하는 문제가 아니다. OpenAI 마이그레이션 가이드를 참조하라.
How to Make the Upgrade Decision
의도한 워크플로에서의 일상 작업, 어려운 사례, 도구 실패를 포함한 고정 평가 세트를 만들라. 작업 정의, 도구 권한, 승인 기준을 일관되게 유지하라. 검증된 Sol 기준선과 유효한 6.1 Sol 구성을 비교하고, none과 low가 동등하다고 가정하지 말고 추론 설정을 명시적으로 기록하라.
- 품질: 승인된 완료, 사실 수정, 잘못된 도구 호출, 인간 검토 노력 측정
- 속도: 재시도와 도구 대기를 포함한 엔드투엔드 p50/p95 지연 비교
- 비용: 비캐시 입력, 캐시 읽기, 캐시 쓰기, 출력/추론 토큰, 도구 요금, 엔지니어링 노력 기록
- 롤아웃: 소량 트래픽으로 시작해 Sol 폴백을 유지하고, 사전 정의된 임계치를 충족할 때만 확장
실무 권고: 수용 가능한 회귀 없이 승인 작업 경제성이 더 좋아지거나 필요한 기능 향상이 있다면 GPT-6.1 Sol을 선택하라. 호환성과 검증된 결과가 측정된 이익보다 중요한 경로에는 GPT-6 Sol을 유지하라. 일부 작업군만 개선된다면 혼합 배포도 합리적이다. 이는 워크로드 기반 권고이며, 어느 모델이 보편적으로 우월하다는 주장에 해당하지 않는다.
How Do You Migrate From GPT-6 Sol to GPT-6.1 Sol?
가장 단순한 수준에서는 모델 식별자가 gpt-6-sol에서 gpt-6.1-sol로 바뀐다.
A Responses API request can look like this:
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-6.1-sol",
    reasoning={"effort": "medium"},
    input="이 리포지토리를 분석하고 실패하는 테스트의 원인을 식별해 주세요."
)

print(response.output_text)
모델 식별자를 바꾸는 것이 첫 단계일 뿐이다. GPT-6.1 Sol은 low, medium, high, xhigh, max를 지원하고, GPT-6 Sol은 none도 지원한다. 명시적인 none 설정이 있다면 제거하고 허용되는 강도를 선택하라. 도구를 사용하는 애플리케이션은 Responses API도 필요하다: GPT-6.1 Sol Chat Completions는 도구 호출을 지원하지 않으며, GPT-6 Sol Chat Completions는 reasoning_effort="none"에서만 함수 호출을 지원한다. 사양 표의 공식 모델 열은 이러한 엔드포인트 제한을 문서화한다.
팀은 지연 시간 민감 워크플로, 도구 호출, 프롬프트 캐싱, 장문 컨텍스트 동작, reasoning.effort="none"을 명시적으로 보내는 모든 로직을 재시험해야 한다.
이 예시는 OPENAI_API_KEY로 OpenAI를 직접 사용하는 것으로, 검증된 CometAPI 엔드포인트 예시는 아니다. 단계적 롤아웃 동안 GPT-6 Sol 경로를 유지하고, 작업 성공과 p95 지연을 기록하며, 애플리케이션의 승인 기준을 충족하지 못하면 롤백하라.
Which GPT-6.1 Sol Workloads Benefit Most From the Upgrade?
| Workload | GPT-6.1 Sol Advantage |
|---|---|
| Coding agents | 더 높은 DeepSWE 성능 |
| Repository-scale debugging | 장기 소프트웨어 엔지니어링 개선 |
| Browser/computer agents | OSWorld 2.0에서 +7포인트 |
| Enterprise automation | 더 높은 AutomationBench 성능 |
| Repeated-context agents | 캐시된 입력이 50% 더 저렴 |
| Complex PDF analysis | 전문 문서 성능이 Astra에 근접 |
| Scientific workflows | OpenAI의 Terminal-Bench Science 평가에서 GPT-6 Sol 대비 2배 이상 점수 |
| Fact-sensitive workflows | 난해 프롬프트에서 더 낮은 사실 오류율 |
| Tool-heavy agents | 도구 실패 시 더 나은 동작 |
GPT-6 Sol은 기존 통합이 이미 안정적이거나, 특히 none 추론 설정이 필요한 경우 여전히 유용하다. 에이전트, 코딩, 컴퓨터 사용, 반복 컨텍스트 워크플로를 중심으로 하는 신규 배포의 경우, GPT-6.1 Sol은 일반적인 입력/출력 토큰 가격을 바꾸지 않으면서 비용-성능 방정식을 바꾼다.
How Can CometAPI Help You Upgrade From GPT-6 Sol to GPT-6.1 Sol?
이미 CometAPI에서 GPT-6 Sol API를 사용 중인 개발자는 GPT-6.1 Sol로의 업그레이드를 전체 통합 재작성보다 상대적으로 작은 마이그레이션으로 처리할 수 있다.
GPT-6.1 Sol은 이제 CometAPI에서 gpt-6.1-sol 모델 식별자로 제공된다. CometAPI는 현재 단기 컨텍스트 입력 가격을 백만 토큰당 $1.60부터 표시하며, OpenAI의 공식 $2.00 요율과 비교된다. 출력 가격은 백만 토큰당 $8.00부터 시작한다. 이는 개발자가 더 강력해진 코딩, 에이전트, 컴퓨터 사용 성능에 접근하면서도 GPT-6 Sol과 동일한 할인 가격 구조를 유지함을 의미한다.
CometAPI는 OpenAI 호환 인터페이스를 제공하므로, 기존 GPT-6 Sol 애플리케이션은 모델 ID를 gpt-6.1-sol로 교체하면서 동일한 SDK 구조와 요청 흐름을 유지할 수 있는 경우가 많다. 또한 CometAPI는 모델 비교, 프롬프트 테스트, 워크로드 비용 추정, 마이그레이션 동작 점검 도구를 제공하여 프로덕션 롤아웃 전 검증을 지원한다.
더 안전한 업그레이드 절차는 동일한 대표 프롬프트를 GPT-6 Sol과 GPT-6.1 Sol에 각각 실행해 출력 품질, 지연, 도구 동작, 총 비용을 비교하는 것이다. 특히 추론 설정, 구조화 출력, 도구 호출, 장시간 실행 에이전트에 의존하는 애플리케이션의 경우, 모델 호환성이 모든 워크로드에서 동일한 동작을 보장하지 않기 때문이다.
반복 컨텍스트 또는 에이전트 중심 워크로드를 운영하는 팀에는 새로운 경로가 경제성도 개선할 수 있다. CometAPI는 현재 GPT-6.1 Sol 단기 컨텍스트 캐시 읽기를 백만 토큰당 $0.08로 가격 책정하며, OpenAI의 공식 $0.10보다 낮다. 단기 컨텍스트 입력과 출력 요율은 공식 가격 대비 20% 낮게 표시되어 있다.
실무적으로, CometAPI는 GPT-6 Sol → GPT-6.1 Sol 전환을 다음 3단계로 단순화할 수 있다:
gpt-6-sol을gpt-6.1-sol로 교체- 동일한 프로덕션 프롬프트와 에이전트 워크플로로 벤치마크를 수행한 후 전환
- 출력 품질, 도구 동작, 지연, 비용이 요구사항을 충족하면 점진적으로 워크로드 이전
이 접근법은 새로운 API 스택으로 애플리케이션을 재구성하지 않고도 GPT-6.1 Sol을 도입하면서, 신형 모델이 가져오는 동작 차이를 검증할 수 있도록 한다.
Conclusion
GPT-6 Sol은 기술적으로 폐기되지 않았다. 동일한 1.05M 컨텍스트 윈도우, 128K 출력 상한, 구조화 출력, 이미지 입력, $2/$10 표준 가격을 유지한다. none 추론 옵션도 기존 통합에 중요할 수 있다. 업그레이드 결정은 버전 번호가 아니라 측정된 작업 결과와 호환성에 기반해야 한다.
그러나 OpenAI의 GPT-6 Sol 문서는 이제 개발자에게 신규 Sol 모델로서 GPT-6.1 Sol을 안내한다.
대부분의 복잡한 워크로드에서 핵심 질문은 GPT-6.1 Sol이 더 큰 컨텍스트 윈도우나 더 높은 토큰 요율을 제공하느냐가 아니다 — 그렇지 않다. 질문은 더 높은 작업 성공률, 더 저렴한 캐시 읽기, 개선된 사실성, 더 강한 에이전트 동작이 모델 식별자를 바꾸고 워크로드를 재시험할 만큼의 가치를 주느냐이다.
FAQ
How do you migrate from GPT-6 Sol to GPT-6.1 Sol with tool calling?
아니오. 먼저 엔드포인트와 요청 필드를 감사한 다음, 도구 루프를 Responses API로 이동하고 도구 호출 파싱, 인자 검증, 재시도, 오류 처리를 테스트하라. 트래픽을 늘리기 전에 대표 작업에서 카나리를 실행하라. 텍스트 전용 요청의 성공은 작동하는 도구 루프를 검증하지 않는다.
Is GPT-6.1 Sol cheaper in real workloads?
캐시된/비캐시 입력 토큰, 캐시 쓰기, 추론 및 출력 토큰, 처리 모드, 도구 요금을 기록하라. 캐시 토큰 가격만이 아니라 승인된 작업당 비용을 비교하라. 안정적인 접두사가 실제로 캐시에 적중할 때만 도움이 되며, 더 긴 도구 루프나 실패한 시도가 캐시 절감을 상쇄할 수 있다.
How should you test GPT-6.1 Sol before switching from GPT-6 Sol?
프로덕션에 가까운 고정 작업 세트를 사용하고 성공적 완료, 사실 수정, 잘못된 도구 호출, p50/p95 지연, 총 비용을 기록하라. 테스트 전에 허용 가능한 임계치를 정의하라. 모델 라우팅 롤백 경로를 유지하고, 새로운 구성이 그 임계치를 충족한 후에만 트래픽을 확장하라.
How do you test GPT-6.1 Sol with PDFs?
의도한 워크플로를 대표하는 조밀한 표, 각주, 차트, 스캔 페이지를 포함한 소규모 코퍼스를 구축하라. 검증 가능한 답을 가진 질문을 설정하고 페이지나 표 근거를 요구하라. 계산 정확도, 누락된 주의사항, 근거 없는 답변을 별도로 점수화하라. 실수가 물적 결과를 초래할 수 있는 출력에는 인간 검토를 유지하라.