
TL;DR
DeepSeek V4.1 Flash is het op efficiëntie gerichte multimodale model van DeepSeek voor codering, redeneren, agents en workloads met lange context. De officiële technische documentatie specificeert een 552B Mixture-of-Experts-ontwerp met 8B actieve parameters voor input en 16B voor output, plus native visueel begrip en een veel kleinere KV-cache-footprint.
Voor ontwikkelaars die de DeepSeek V4.1 Flash API in CometAPI gebruiken, is de praktische integratie OpenAI-compatibel: gebruik https://api.cometapi.com/v1 als de basis-URL, stel het model in op deepseek-v4.1-flash en roep de standaard Chat Completions-interface aan.
Eén naamgevingsverschil is belangrijk: de first-party API van DeepSeek gebruikt deepseek-flash, terwijl CometAPI deepseek-v4.1-flash gebruikt. Behandel modelidentifiers als providerspecifieke configuratie.
Key Takeaways
- DeepSeek V4.1 Flash combineert een 552B MoE-backbone, native beeldbegrip en een asymmetrisch input/output-rekenprofiel.
- In CometAPI gebruik je deepseek-v4.1-flash; op de first-party API van DeepSeek gebruik je deepseek-flash.
- CometAPI publiceert basistarieven vanaf $0.12/M inputtokens, terwijl DeepSeek’s off-peak cache-miss inputprijs $0.15/M is.
- De grootste gemeten verschillen concentreren zich in coding, terminal, repository, automatisering en tool-ondersteunde agentbenchmarks.
- Valideer vóór productie uitrol geavanceerde velden zoals thinking-instellingen, vision-payloads, streaming, tool-aanroepen en gestructureerde output op exact de providerroute die je gaat inzetten.
What Is the DeepSeek V4.1 Flash API?
DeepSeek V4.1 Flash is het nieuwste Flash-model, gebouwd op een Mixture-of-Experts-architectuur met 552B parameters. Het Causal Encoder-Decoder-ontwerp activeert 8B parameters voor inputverwerking en 16B voor outputgeneratie.
Voor integratieplanning biedt de officiële DeepSeek API een contextvenster van 1M tokens en een maximale output van 384K tokens. De upstream-service ondersteunt OpenAI-compatibele Chat Completions- en Responses-API’s, een Anthropic-compatibele API, streaming, JSON-output, tool-aanroepen en native afbeeldingsinput. Deze gids gebruikt de CometAPI Chat Completions-route; verifieer dus de feature-doorgifte op die route vóór productie.
| Specification | DeepSeek V4.1 Flash official API details |
|---|---|
| Architecture | 552B MoE, Causal Encoder-Decoder |
| Active parameters | 8B for input; 16B for output |
| Context length | 1M tokens |
| Maximum output | 384K tokens |
| Interfaces | Chat Completions, Responses API, Anthropic-compatible API |
| Streaming | Supported |
| Structured output | JSON output and JSON Schema through supported endpoints |
| Tool calls | Supported, including thinking-mode tool use |
| Vision input | JPEG, PNG, GIF, and WebP |
| Image limits | 32 MiB inline; 64 MiB per file; up to 600 images per request |
| First-party model ID | deepseek-flash |
| CometAPI model ID | deepseek-v4.1-flash |
Provider-opmerking: model-ID’s en geavanceerde requestvelden zijn route-specifiek. Gebruik deepseek-v4.1-flash voor CometAPI-voorbeelden in deze gids en test vision, tool-aanroepen, gestructureerde output en thinking-instellingen op het ingezette endpoint.
DeepSeek meldt ook dat de globale KV-cache ongeveer 890 bytes per token is, tegenover 3,514 bytes per token bij de vorige V4 Flash-generatie. Die reductie is vooral belangrijk voor langlopende agents die herhaaldelijk grote prompts, toolschema’s en conversatiegeschiedenis hergebruiken.
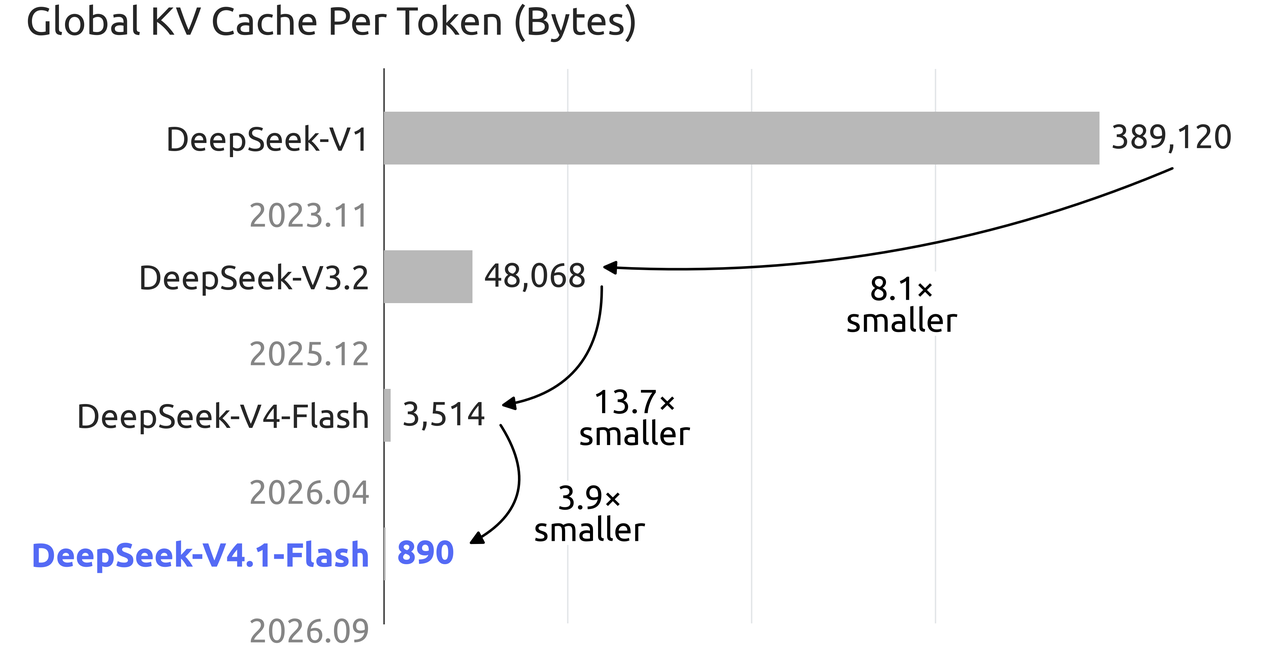
Officiële DeepSeek KV-cache-vergelijking? officiële afbeeldingsbron
How Strong Is DeepSeek V4.1 Flash for Coding and AI Agents?
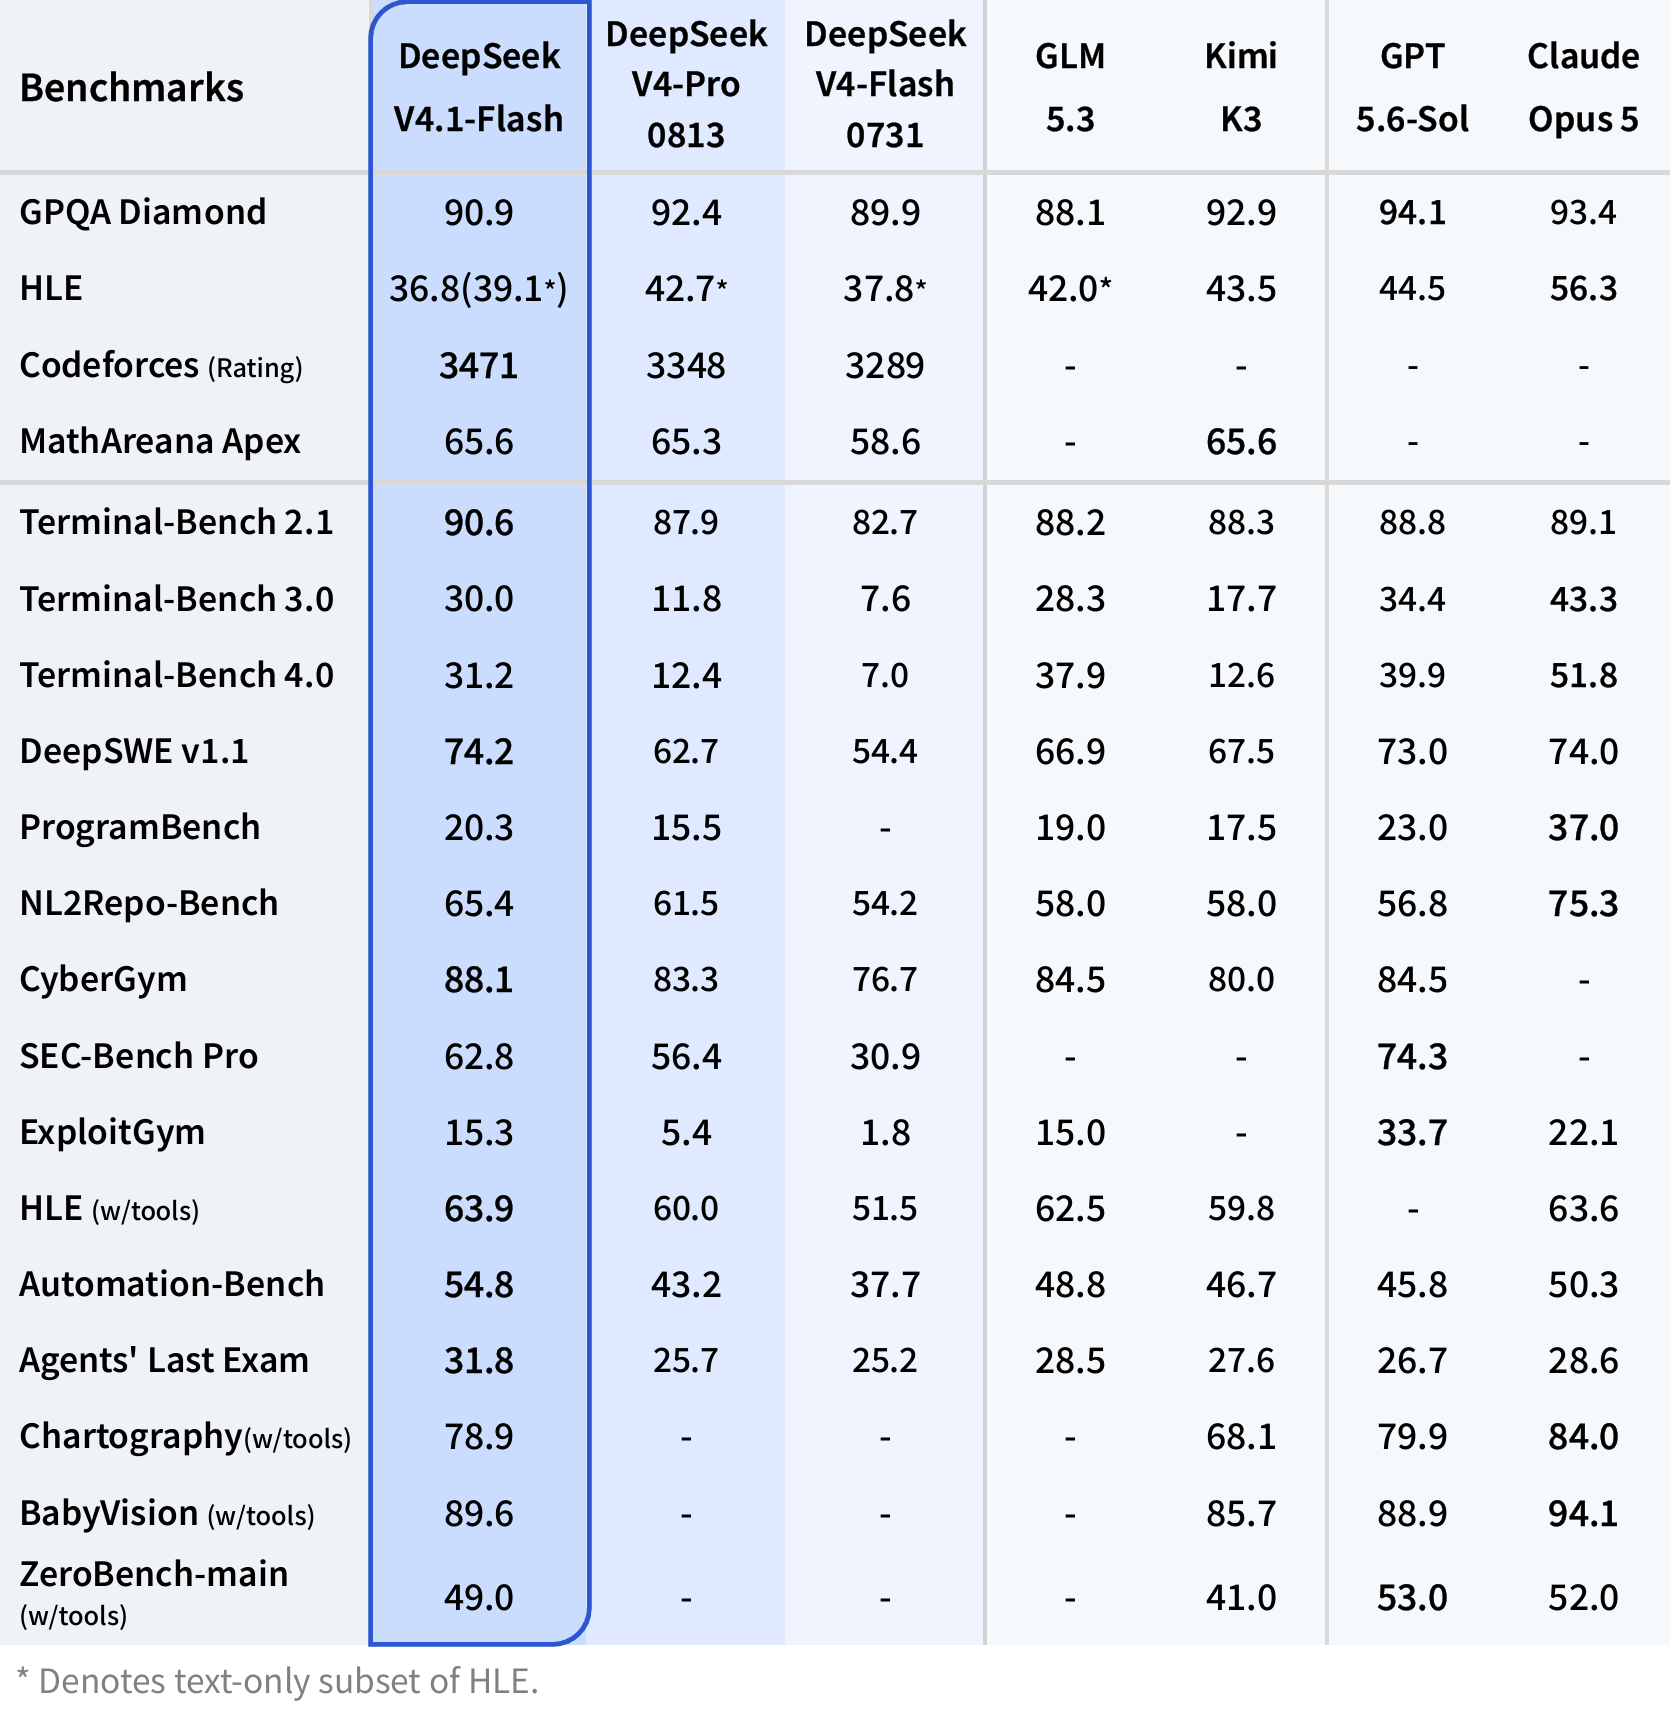
Deze gids focust op benchmarkbewijzen die direct de API-keuze informeren. DeepSeek karakteriseert V4.1 Flash als beter dan vlaggenschipmodellen, inclusief V4 Pro, binnen het gepubliceerde evaluatiepakket. De meest bruikbare winst zit in terminalwerk, software-engineering, repository-taken, automatisering en tool-ondersteunde agents; productieteams moeten het model nog steeds valideren op hun eigen prompts en voltooiingscriteria.
| Benchmark | DeepSeek V4.1 Flash | DeepSeek V4 Pro | DeepSeek V4 Flash |
|---|---|---|---|
| GPQA Diamond | 90.9 | 92.4 | 89.9 |
| Terminal-Bench 2.1 | 90.6 | 87.9 | 82.7 |
| DeepSWE v1.1 | 74.2 | 62.7 | 54.4 |
| NL2Repo-Bench | 65.4 | 61.5 | 54.2 |
| HLE with tools | 63.9 | 60.0 | 51.5 |
| Automation-Bench | 54.8 | 43.2 | 37.7 |
| Agents' Last Exam | 31.8 | 25.7 | 25.2 |
De praktische conclusie is specifieker dan “V4.1 is slimmer.” DeepSeek V4.1 Flash is vooral aantrekkelijk voor herhaald toolgebruik, terminalacties, codering op repository-schaal, automatisering en lange agenttrajecten. Zuivere kennis- of redeneerworkloads kunnen een andere rangschikking opleveren.
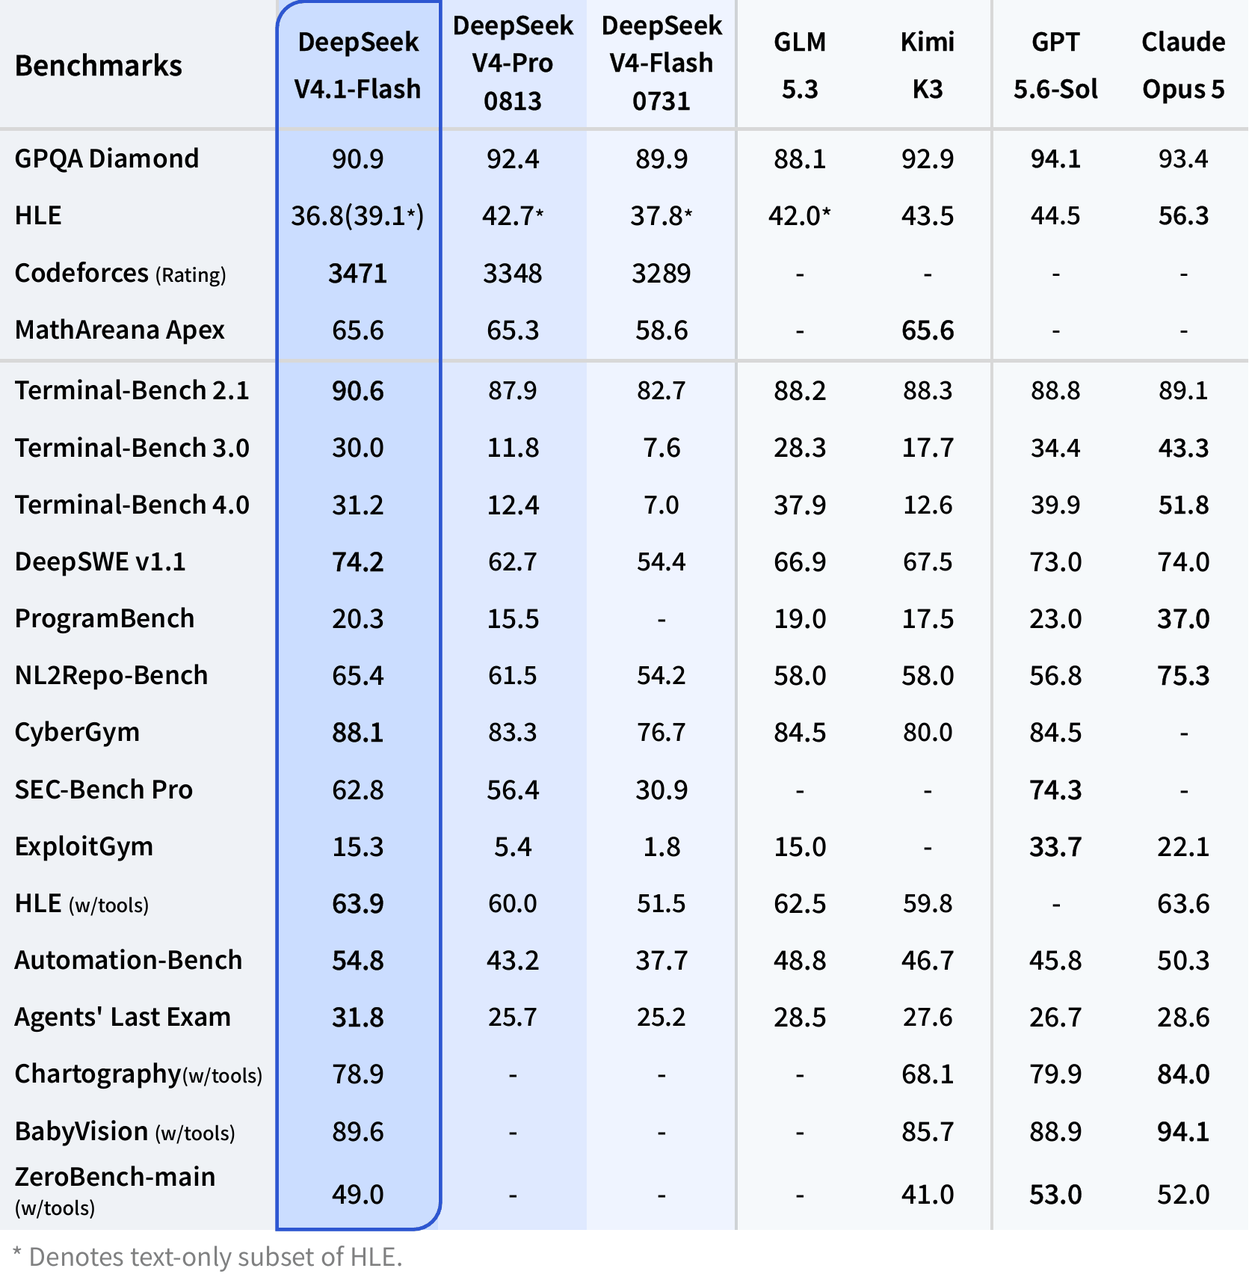
Officiële DeepSeek-benchmarkresultaten? officiële afbeeldingsbron
Why Use the DeepSeek V4.1 Flash API Through CometAPI?
Het belangrijkste integratievoordeel is dat de DeepSeek V4.1 Flash API in CometAPI kan worden aangeroepen via hetzelfde OpenAI-compatibele clientpatroon dat voor andere modellen wordt gebruikt, waardoor SDK-wisselingen in multi-modeltoepassingen worden beperkt.
| Setting | Value |
|---|---|
| Base URL | https://api.cometapi.com/v1 |
| Chat endpoint | /chat/completions |
| Model ID | deepseek-v4.1-flash |
| Authentication | Bearer API key |
| Python SDK | OpenAI SDK compatible |
| JavaScript SDK | OpenAI SDK compatible |
Dit voorkomt ook een veelgemaakte integratiefout: het kopiëren van de first-party identifier van DeepSeek in een CometAPI-request. De providerroutes verwijzen naar dezelfde modellijn, maar de gedocumenteerde model-ID’s verschillen.
| Dimension | CometAPI DeepSeek V4.1 Flash | DeepSeek official API |
|---|---|---|
| Base URL | https://api.cometapi.com/v1 | https://api.deepseek.com |
| Model | deepseek-v4.1-flash | deepseek-flash |
| Interface | OpenAI-compatible | OpenAI-compatible |
| Base/off-peak input | $0.12/M base | $0.15/M off-peak cache miss |
| Base/off-peak output | $0.48/M base | $0.60/M off-peak |
| Cache read/hit | $0.0024/M base | $0.003/M off-peak |
Connect to DeepSeek V4.1 Flash with CometAPI
Configure Your API Key and Base URL
Maak een CometAPI API-sleutel aan, sla deze op in een omgevingsvariabele en configureer de OpenAI-compatibele basis-URL als https://api.cometapi.com/v1. Plaats geen productie-inloggegevens in broncode.
export COMETAPI_KEY="YOUR_COMETAPI_KEY"
``````sh
$env:COMETAPI_KEY="YOUR_COMETAPI_KEY"
Make Your First API Request
Gebruik de CometAPI-modelidentifier deepseek-v4.1-flash met het standaard Chat Completions-endpoint.
curl "https://api.cometapi.com/v1/chat/completions"
  -H "Content-Type: application/json"
  -H "Authorization: Bearer ${COMETAPI_KEY}"
  -d '{
    "model": "deepseek-v4.1-flash",
    "messages": [
      {
        "role": "user",
        "content": "Explain three ways to reduce latency in a high-throughput API service."
      }
    ]
  }'
Een succesvol antwoord gebruikt de vertrouwde OpenAI-stijl completion-structuur, waardoor applicaties die al choices[0].message.content lezen minimale migratiewerkzaamheden vereisen.
Python SDK Example
pip install openai
``````python
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[
        {
            "role": "user",
            "content": "Write a Python retry helper with exponential backoff."
        }
    ],
)

print(response.choices[0].message.content)
Voor productie: voeg expliciete time-outs, begrensde retries, requestlogging en gebruiksmonitoring toe.
JavaScript SDK Example
npm install openai
``````js
import OpenAI from "openai";

const client = new OpenAI({
  apiKey: process.env.COMETAPI_KEY,
  baseURL: "https://api.cometapi.com/v1",
});

const response = await client.chat.completions.create({
  model: "deepseek-v4.1-flash",
  messages: [
    {
      role: "user",
      content: "Create a typed rate limiter interface for an Express API."
    }
  ],
});

console.log(response.choices[0].message.content);
De clientabstractie blijft ongewijzigd, terwijl de basis-URL en model-ID providerspecifieke configuratie worden.
DeepSeek V4.1 Flash API Features
Configure Reasoning and Thinking Mode
DeepSeek documenteert zowel thinking- als non-thinking-modus. Bij routing via CometAPI moet je verifiëren dat vendorspecifieke velden exact zoals verwacht worden doorgegeven voordat je erop vertrouwt als productiespecificatie.
response = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[
        {
            "role": "user",
            "content": "Design a fault-tolerant distributed job scheduler."
        }
    ],
    reasoning_effort="high",
    extra_body={
        "thinking": {"type": "enabled"}
    },
)
Test elk ondersteund effort-niveau tegen je eigen doelen voor latency, tokenverbruik en taakvoltooiing, omdat provider-mappings kunnen verschillen.
Analyze Images with Vision Input
DeepSeek V4.1 Flash accepteert JPEG-, PNG-, GIF- en WebP-afbeeldingen. Officiële limieten omvatten 32 MiB per inline afbeelding, 64 MiB per bestand, tot 600 afbeeldingen per request en een limiet van 8.192 tekens voor externe afbeeldings-URL’s. Afbeeldingen horen in user- of developer-berichten, niet in system- of assistant-berichten.
response = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[
        {
            "role": "user",
            "content": [
                {"type": "text", "text": "Identify the three most important anomalies."},
                {
                    "type": "image_url",
                    "image_url": {"url": "https://example.com/dashboard.png"}
                }
            ]
        }
    ],
)
Valideer afbeeldingsgrootte, URL-toegankelijkheid, preprocessing, tokenverbruik en latency op precies de CometAPI-route die je in productie gebruikt.
Stream Responses with SSE
Streaming verlaagt de waargenomen latency door incrementele output te leveren aan interactieve coding-, chat- en agentinterfaces.
stream = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[
        {
            "role": "user",
            "content": "Explain distributed-cache invalidation."
        }
    ],
    stream=True,
)

for chunk in stream:
    if chunk.choices and chunk.choices[0].delta.content:
        print(chunk.choices[0].delta.content, end="", flush=True)
Productieclients moeten om kunnen gaan met onderbroken streams, lege deltas, time-outherstel, retry-grenzen en definitieve gebruiksregistratie.
How Much Does the DeepSeek V4.1 Flash API Cost?
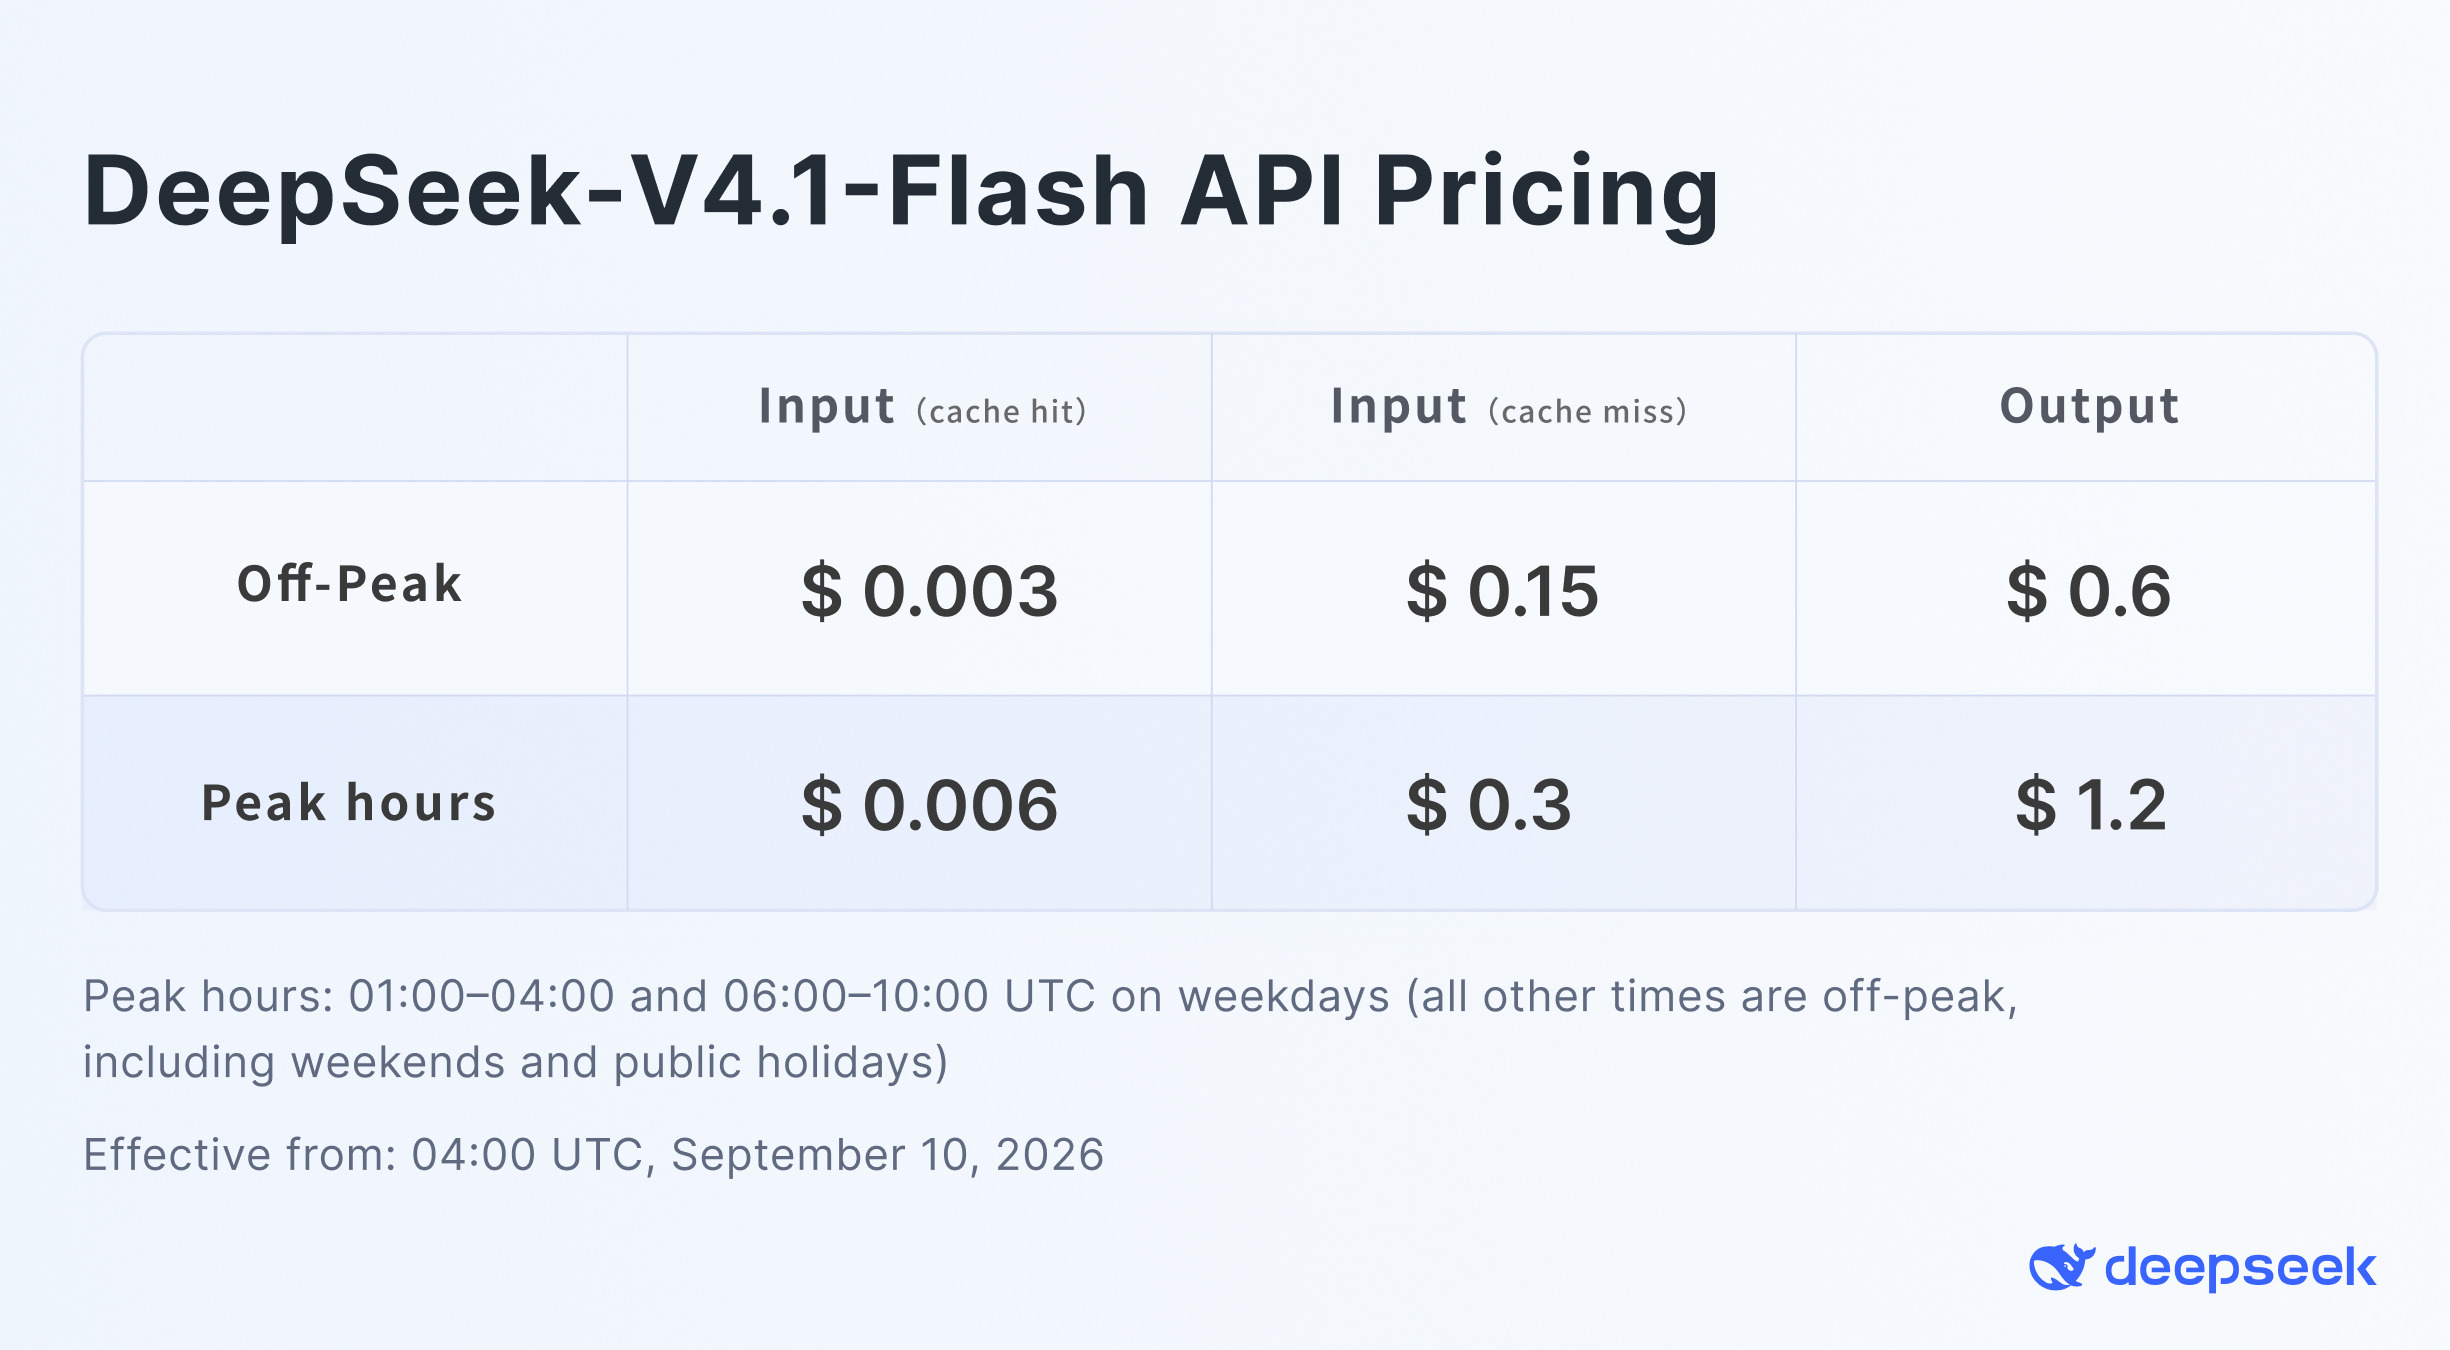
DeepSeek’s gedocumenteerde API-prijzen gebruiken piek- en dalvensters. De officiële prijsafbeelding toont off-peak-tarieven van $0.003/M cache-hit input, $0.15/M cache-miss input en $0.60/M output; piektarieven zijn dubbel.
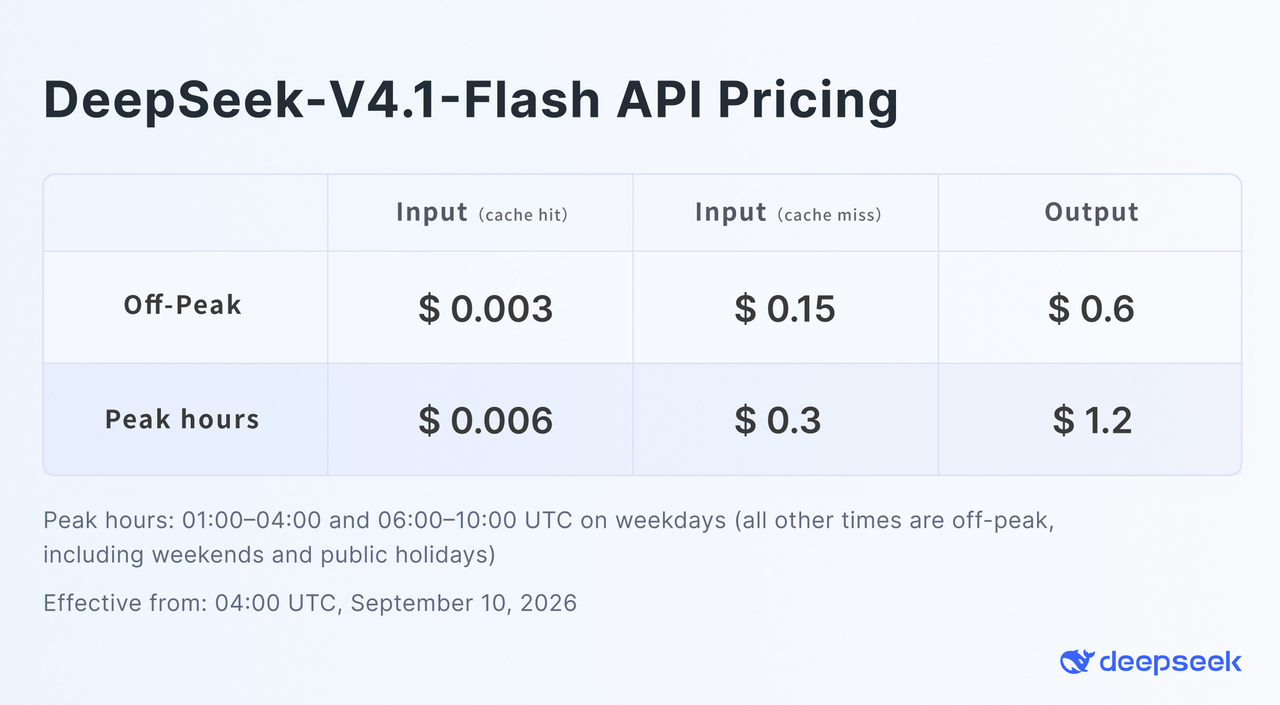
Officiële DeepSeek V4.1 Flash API-prijzen? officiële afbeeldingsbron
| Token category | CometAPI DeepSeek V4.1 Flash | DeepSeek official pricing |
|---|---|---|
| Input / cache miss | $0.1200/M base | $0.15/M off-peak |
| Output | $0.4800/M base | $0.60/M off-peak |
| Cache read / cache hit | $0.0024/M base | $0.003/M off-peak |
| Peak multiplier | 2x during matching windows | 2x during matching windows |
| Weekday peak window 1 | 01:00-04:00 UTC | 01:00-04:00 UTC |
| Weekday peak window 2 | 06:00-10:00 UTC | 06:00-10:00 UTC |
Een eenvoudig basistariefvoorbeeld voor 100M cache-miss inputtokens en 20M outputtokens is:
Input:
100 x $0.12 = $12.00

Output:
20 x $0.48 = $9.60

Total base cost:
$21.60
De werkelijke productiekosten hangen af van de mix van gecachete tokens, piekmultipliers, requestcondities en het actuele providertarief. Het grote verschil tussen cache-hit en cache-miss prijzen maakt stabiele, herbruikbare prefixen — systeeminstructies, toolschema’s en gemeenschappelijke context — een belangrijke kostenhefboom.
DeepSeek V4.1 Flash API vs V4 Pro vs V4 Flash
| Dimension | DeepSeek V4.1 Flash | DeepSeek V4 Pro | DeepSeek V4 Flash |
|---|---|---|---|
| Primary positioning | Efficiënt redeneren, agents, vision | High-end V4 reasoning | Vorige snelle V4-laag |
| Native vision | Yes | Model-dependent / route-specific | Aparte vision-route in vorige generatie |
| Thinking | Yes | Yes | Yes |
| Agent performance | Sterkst van de drie op vele gepubliceerde agenttests | Sterk | Lager dan V4.1 op gepubliceerde tests |
| First-party canonical ID | deepseek-flash | deepseek-v4-pro | Legacy/compatibility alias |
| CometAPI ID | deepseek-v4.1-flash | deepseek-v4-pro | deepseek-v4-flash |
| Best fit | Nieuwe high-volume agent-/codingworkloads | Workloads specifiek gevalideerd op Pro | Legacy-compatibiliteit en vergelijkingen |
Huidige status: de live
van DeepSeek stelt dat DeepSeek V4 Pro beschikbaar blijft na 14 september 2026, met ongewijzigde billing. Verifieer de live documentatie voordat je op routing- of migratiegedrag vertrouwt.
What Should You Test Before Putting DeepSeek V4.1 Flash API into Production?
- Modelrouting: bevestig deepseek-v4.1-flash in CometAPI en houd providerspecifieke ID’s in configuratie in plaats van in applicatielogica.
- Promptregressie: voer representatieve productieprompts uit en vergelijk taakvoltooiing, niet alleen benchmarkscores.
- Gestructureerde output: valideer elke JSON-respons tegen het applicatieschema en definieer een herstel- of retrypad.
- Tool-aanroepen: test argumenttypen, ongeldige aanroepen, parallelle aanroepen en lusbeëindigingsvoorwaarden.
- Thinking-instellingen: verifieer welke velden CometAPI doorgeeft en meet de impact op latency en tokens per instelling.
- Vision: test echte screenshots en documenten, inclusief groottelimieten, ontoegankelijke URL’s en niet-ondersteunde berichtrollen.
- Streaming: handel lege deltas, onderbroken verbindingen, retry-grenzen en definitieve gebruiksregistratie af.
- Lange context en caching: meet antwoordkwaliteit, cache-hitratio en kosten naarmate de promptlengte toeneemt.
- Betrouwbaarheid: registreer p50-, p95- en p99-latency; oefen 429, 5xx, time-outs en fallbackpaden.
- Kostenbeheersing: volg input-, gecachete input-, reasoning- en outputtokens per voltooide taak.
Voor agentworkloads: vergelijk kosten per voltooide taak — niet alleen dollars per miljoen tokens. Een model kan duurder zijn per outputtoken en toch goedkoper end-to-end als het retries en tool-aanroepen vermindert; omgekeerd als hogere reasoning-inspanning tokens toevoegt zonder de taakvoltooiing te verbeteren.
Is the DeepSeek V4.1 Flash API Worth Using?
Voor nieuwe DeepSeek-integraties is DeepSeek V4.1 Flash een sterke standaardkandidaat voor de Flash-familie omdat het betere gepubliceerde agentprestaties combineert met native vision en scherpe prijzen.
De sterkste use-cases zijn niet enkel generieke chat. De betere fit is coding agents, geautomatiseerde software-engineering, analyse met lange context, multimodale assistenten, high-volume workflowautomatisering en tool-gebruikende agents waar herhaalde context de totale kosten kan domineren.
Voor ontwikkelaars die een OpenAI-achtige SDK-architectuur willen behouden, biedt de DeepSeek V4.1 Flash API in CometAPI het integratiepatroon dat in deze gids wordt gebruikt: behoud de standaard clientinterface, wijs naar https://api.cometapi.com/v1 en gebruik deepseek-v4.1-flash.
DeepSeek V4.1 Flash API FAQ
How should I organize provider-specific model IDs?
Sla provider, basis-URL en model-ID samen op in omgevingsspecifieke configuratie. Dit voorkomt dat een first-party ID zoals deepseek-flash per ongeluk naar een CometAPI-route wordt gestuurd die deepseek-v4.1-flash verwacht.
How can I improve cache reuse in long-running agents?
Houd stabiele systeeminstructies, toolschema’s en gedeelde referentiecontext aan het begin van de prompt. Voeg veranderlijke gebruikersinput en toolresultaten later toe, zodat de herbruikbare prefix minder vaak verandert.
What is the safest way to compare V4.1 Flash with V4 Pro?
Speel dezelfde productietaakset af, begrens retry-budgetten en vergelijk voltooiingsratio, latency, aantal tool-aanroepen en totale tokens. Een lagere prijs per token garandeert geen lagere kosten per succesvolle taak.
What fallback policy should an agent use?
Definieer welke fouten retrybaar zijn, stel een strikte retry-limiet in en kies pas een fallbackmodel nadat je de toolstatus hebt behouden die nodig is om veilig te hervatten. Log elke fallback, zodat stille kwaliteitsdrift zichtbaar is.
How should image inputs be validated before sending them?
Controleer de echte bestandsignatuur, ondersteund formaat, bytegrootte, URL-toegankelijkheid en berichtrol. Verwijder onnodige metadata en verzend geen gevoelige beelden, tenzij je retentie- en toegangsbeleid dit expliciet toestaat.
When should I consider the Responses API instead of Chat Completions?
Gebruik Chat Completions wanneer je een bestaande OpenAI-compatibele berichtworkflow onderhoudt. Overweeg de Responses API wanneer de applicatie profiteert van getypte inputitems, tool-outputafbeeldingen of JSON Schema-output; bevestig vervolgens dat de gekozen providerroute de vereiste velden ondersteunt.
How should I handle schema validation failures?
Wijs ongeldige output af voordat deze downstreamsystemen bereikt, registreer de validatiefout en probeer het opnieuw met een begrensde herstelprompt. Als herhaald herstel faalt, routeer de taak naar een veilige fallback in plaats van plausibele maar ongeldige JSON te accepteren.