Specyfikacja techniczna GLM-5.2
| Element | GLM-5.2 |
|---|---|
| Dostawca | Zhipu AI |
| Data wydania | 13 czerwca 2026 |
| Typ modelu | LLM typu Mixture-of-Experts (MoE) z otwartymi wagami |
| Łączna liczba parametrów | ~744B |
| Aktywne parametry | ~40B na token |
| Okno kontekstu | 1,000,000 tokenów |
| Maksymalna długość odpowiedzi | 131,072 tokenów |
| Tryby rozumowania | High, Max |
| Licencja | MIT |
| Główne ukierunkowanie | programowanie agentowe, inżynieria oprogramowania, długohoryzontowe wnioskowanie |
| Dostępność API | Platforma Z.ai i kompatybilni dostawcy |
| Otwarte wagi | Tak |
GLM-5.2 to najnowszy flagowy model z rodziny GLM firmy Zhipu AI. W odróżnieniu od ogólnych modeli z najwyższej półki, GLM-5.2 jest pozycjonowany przede wszystkim jako model nastawiony na programowanie i agentów, zaprojektowany do inżynierii oprogramowania w skali całych repozytoriów, autonomicznych przepływów pracy oraz rozumowania na ekstremalnie długich kontekstach. Jego flagową możliwością jest natywne okno kontekstu o rozmiarze 1 miliona tokenów, co czyni go jednym z największych publicznie dostępnych wśród modeli z otwartymi wagami.
Główne funkcje GLM-5.2
- Okno kontekstu 1M tokenów dla całych repozytoriów, obszernych zestawów dokumentacji i wielosesyjnych przepływów pracy agentów.
- Optymalizacja ukierunkowana na kod z naciskiem na refaktoryzację, debugowanie, generowanie kodu i zadania z zakresu inżynierii oprogramowania.
- Wsparcie przepływów pracy agentów dla narzędzi takich jak Claude Code, Cline, Roo Code, OpenCode i podobnych agentów programistycznych.
- Wydanie z otwartymi wagami na licencji MIT, umożliwiające samodzielne hostowanie i dostrajanie.
- Dwa tryby rozumowania (High i Max) pozwalające równoważyć opóźnienie i głębokość rozumowania.
- Duża architektura MoE z ok. 744B łącznych parametrów, przy aktywowaniu jedynie ~40B na token dla efektywności.
Wyniki benchmarków GLM-5.2
Zhipu nie opublikowało przy premierze kompleksowych oficjalnych wyników benchmarków, co sprawia, że bezpośrednie porównania są bardziej niepewne niż w przypadku modeli takich jak GPT-5 czy Claude. Wiele branżowych raportów odnotowuje brak niezależnie zweryfikowanych publikacji wyników.
| Benchmark | Zgłoszony wynik |
|---|---|
| Terminal-Bench 2.1 | 81.0 |
| SWE-Bench Pro | 62.1 |
| NL2Repo | 48.9 |
| AIME 2026 | 99.2 |
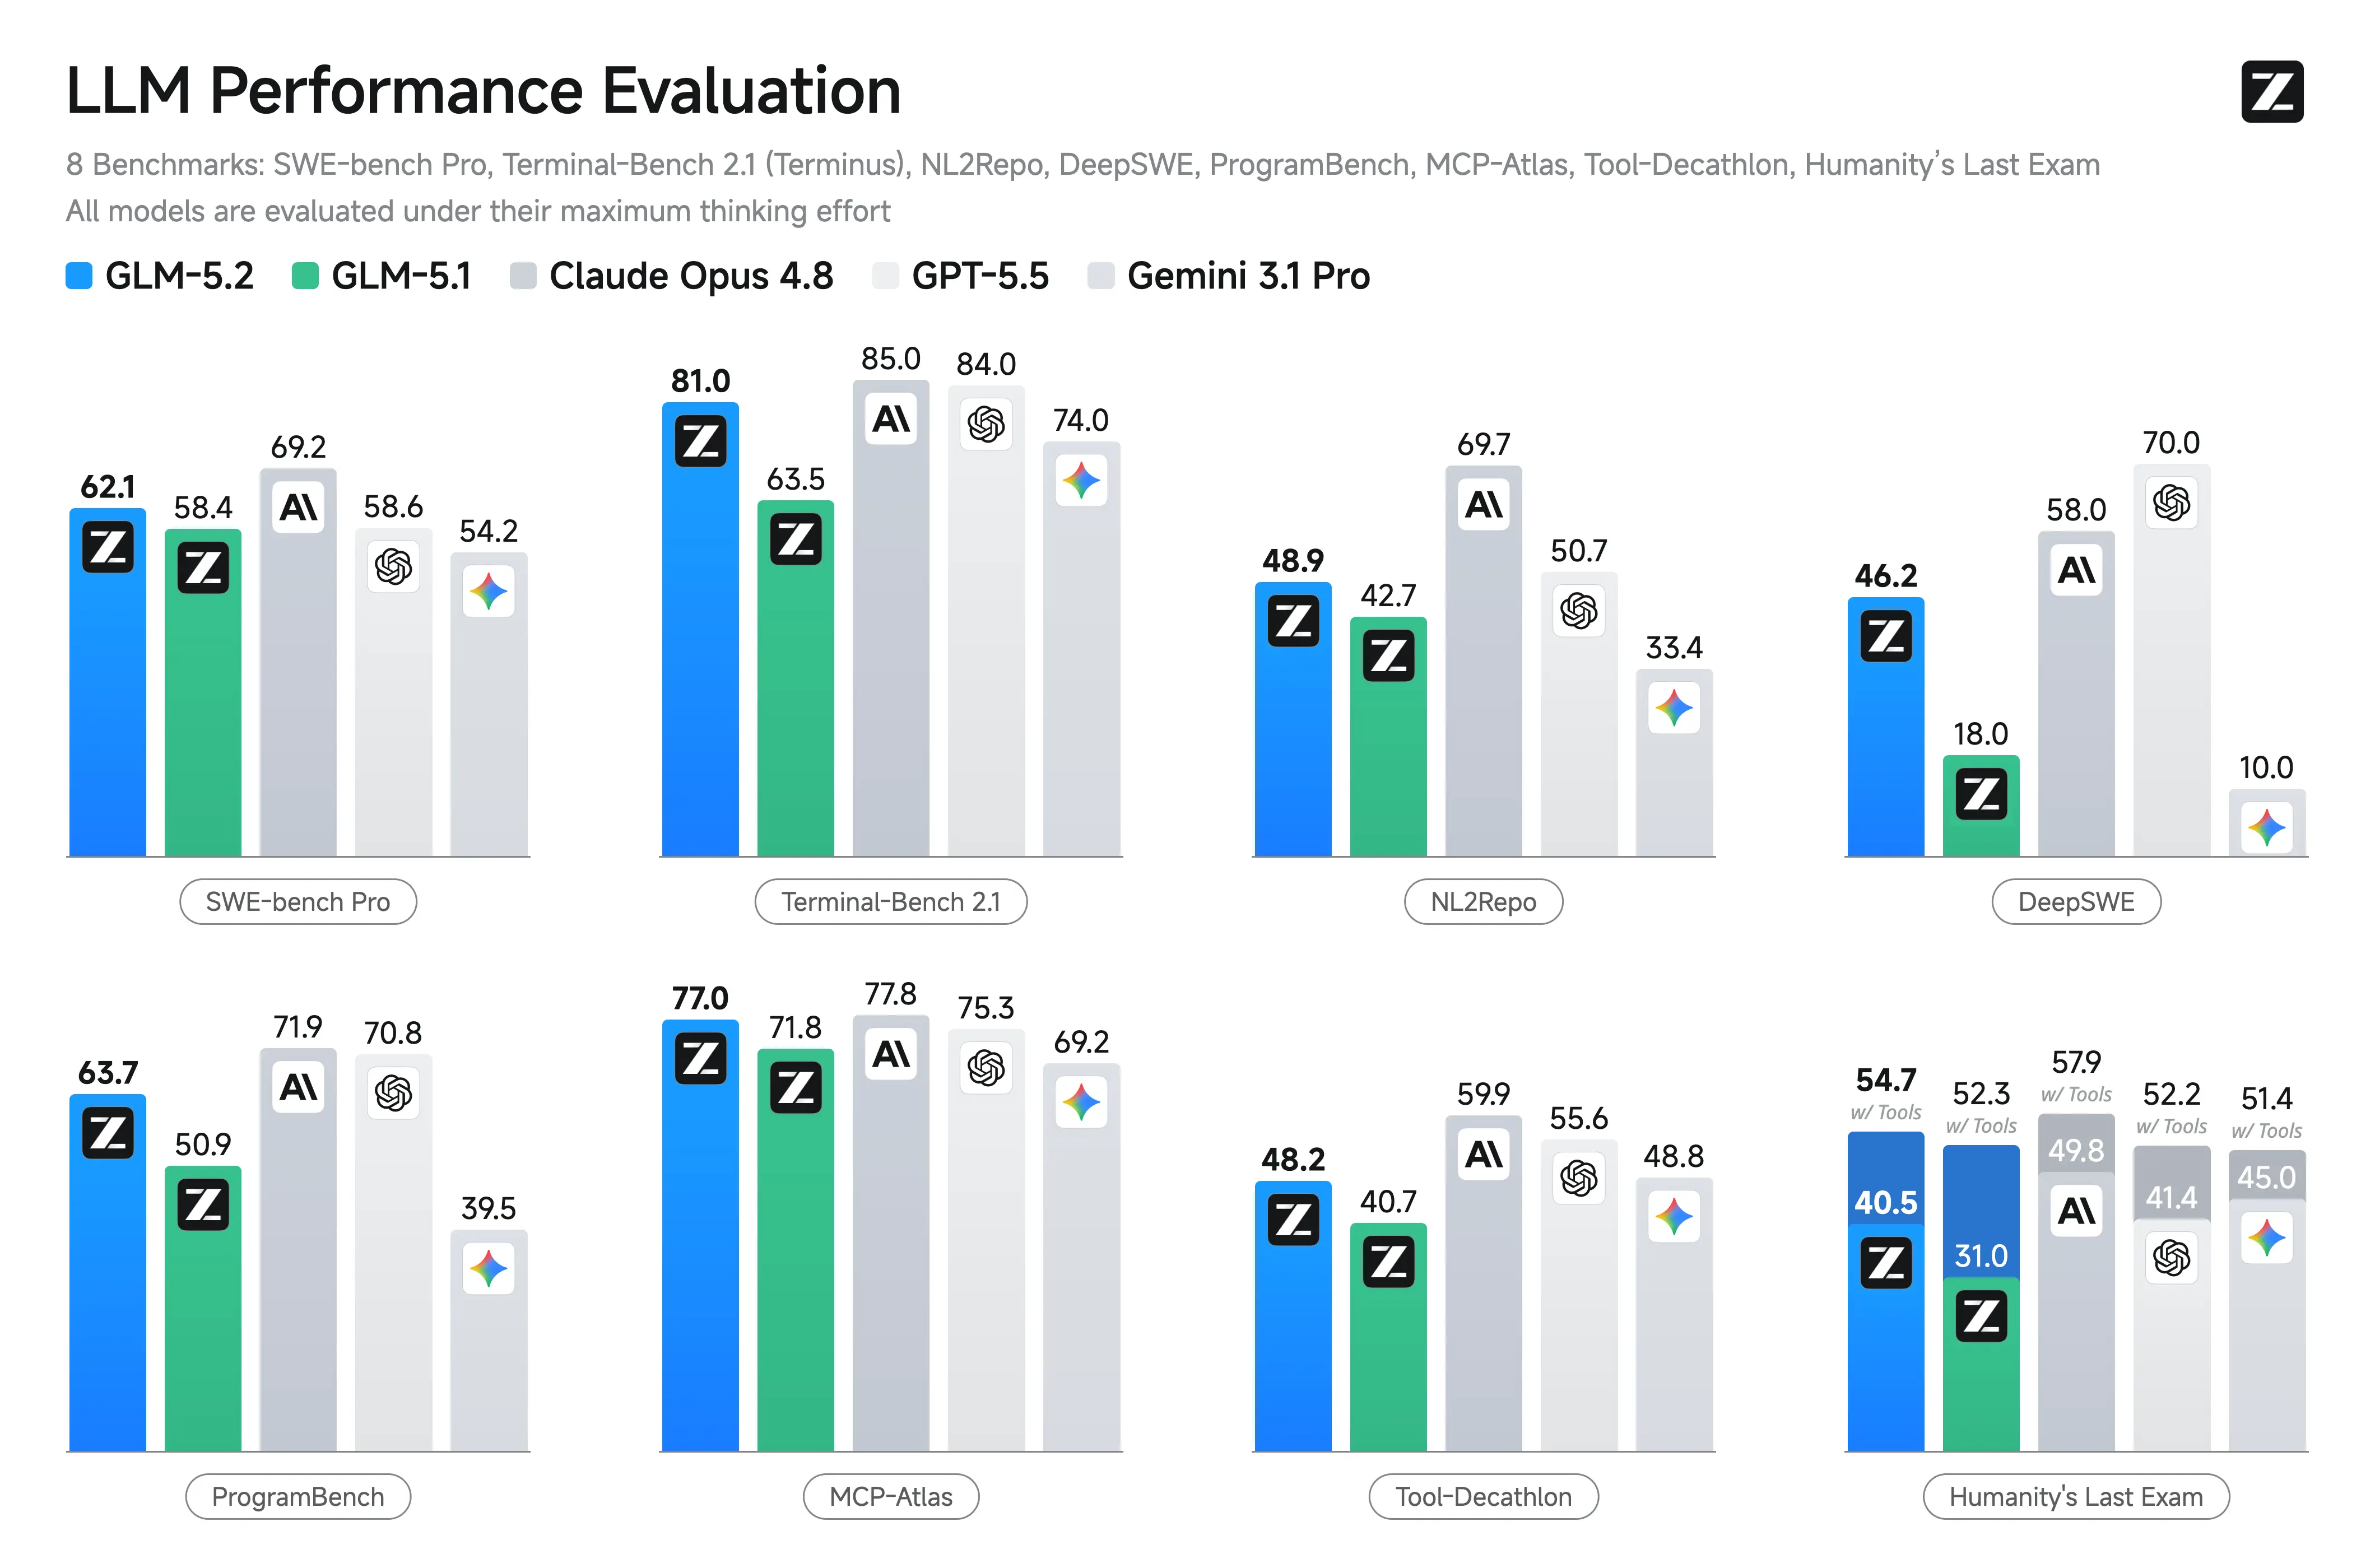
GLM-5.2 vs GLM-5.1 vs Claude Opus 4.8
| Specyfikacja | GLM-5.2 | GLM-5.1 | Claude Opus 4.8 |
|---|---|---|---|
| Data wydania | 2026-06-13 | 2026 | 2026 |
| Okno kontekstu | 1,000,000 | ~200,000 | 1,000,000 |
| Otwarte wagi | Tak (MIT) | Tak | Nie |
| Tryby rozumowania | High, Max | Standard | Extended Thinking |
| Łączna liczba parametrów | 744B | 744B | Nie ujawniono |
| Aktywne parametry | 40B | 40B | Nie ujawniono |
| Oficjalne dane benchmarkowe | Nie opublikowano | Opublikowano przy premierze | Opublikowano |
Główną udokumentowaną zmianą GLM-5.2 względem GLM-5.1 jest rozszerzenie okna kontekstu do 1M tokenów oraz wprowadzenie wybieralnych trybów rozumowania High i Max. Przy premierze Z.ai nie opublikowało oficjalnych wyników SWE-Bench, LiveCodeBench, HumanEval ani podobnych benchmarków, dlatego porównania wydajności względem Claude Opus 4.8, GPT-5, DeepSeek czy Qwen pozostają niezweryfikowane.
W porównaniu z innymi otwartymi modelami głównym wyróżnikiem GLM-5.2 jest połączenie bardzo dużego okna kontekstu, specjalizacji pod kątem kodu oraz licencji MIT. Najmocniej przemawia on do zastosowań związanych z inżynierią oprogramowania w skali repozytoriów, a nie do ogólnych aplikacji czatowych.
Dlaczego warto używać GLM-5.2 poprzez CometAPI?
CometAPI pozwala programistom integrować GLM-5.2, korzystając z tego samego interfejsu, co w przypadku dziesiątek wiodących modeli AI.
Korzyści obejmują:
- Ujednolicone uwierzytelnianie w wielu dostawcach
- Integrację z API zgodnym z OpenAI
- Uproszczone rozliczanie i zarządzanie użyciem
- Szybkie eksperymenty z alternatywnymi modelami
- Łatwe przełączanie między modelami do kodu, rozumowania, obrazu, audio i wideo
- Mniejsze ryzyko uzależnienia od dostawcy w systemach produkcyjnych
Niezależnie od tego, czy tworzysz IDE oparte na AI, wewnętrznego asystenta inżynierskiego, czy platformę automatyzacji dla przedsiębiorstw, CometAPI minimalizuje wysiłek integracyjny, zachowując elastyczność.
Jak uzyskać dostęp do API GLM-5.2 w CometAPI
Zacznij pracę z naszym produktem w kilku prostych krokach...
Krok 1: Zarejestruj się, aby uzyskać klucz API GLM-5.2
Utwórz konto w CometAPI i przejdź do pulpitu API, aby wygenerować klucz API GLM-5.2. Ten klucz uwierzytelnia wszystkie Twoje żądania i daje natychmiastowy dostęp do pełnych możliwości GLM-5.2 API, w tym okna kontekstu 1M tokenów i 128k tokenów wyjściowych.
Krok 2: Wysyłaj żądania do GLM-5.2 API
Użyj klucza API GLM-5.2, aby wysyłać żądania POST do endpointu CometAPI. Przekaż swój prompt, ustaw parametry modelu, takie jak poziom wysiłku i maksymalna liczba tokenów, a GLM-5.2 API przetworzy Twoje żądanie — od generowania kodu, przez analizę dokumentów, po agentowe użycie narzędzi.
Krok 3: Odbieraj wyniki i integruj GLM-5.2 API
GLM-5.2 API zwraca ustrukturyzowane odpowiedzi, w tym tekst uzupełnienia, instrukcje wywoływania narzędzi oraz metadane użycia tokenów. Obsługuje zarówno standardowe odpowiedzi synchroniczne, jak i strumieniowanie w czasie rzeczywistym poprzez Server-Sent Events (SSE), gdy skonfigurowano stream: true. Endpoint można łatwo zintegrować z istniejącymi przepływami pracy za pomocą standardowych klientów HTTP lub zgodnych z OpenAI SDK, kierując żądania przez url(//api.cometapi.com/v1) z użyciem Bearer Token.