CometAPI ile geliştirinBirden çok model için tek bir API mi gerekiyor?İş akışını Playground'da test edin, ardından model ve maliyet kullanım senaryonuza uyduğunda bir API anahtarı oluşturun.
Muse Spark 1.2'nin teknik özelliklerini, kodlama kıyaslamalarını, Muse Code entegrasyonunu, API fiyatlandırmasını, temel özelliklerini, sınırlamalarını ve model karşılaştırmalarını keşfedin.
Meta Muse Spark 1.2’yi yayımladı; bu sürüm Muse Spark 1.1’in kodlamaya odaklı bir güncellemesi. Model, geniş kapsamlı bir spesifikasyon sıfırlaması yerine kod üretimi, karmaşık hata ayıklama, depo (repository) anlama ve uçtan uca geliştirici iş akışları için tasarlandı. Model 1M belirteçlik (token) bağlam penceresini koruyor ve metin, görsel, video ve PDF girdilerini kabul ederken metin çıktısı üretiyor.
Yayınlananın en önemli kısmı, model ile Muse Code arasındaki ilişki. Meta, modeli Muse Code ile birlikte ajan trajeleri, hedef koşullandırma, bağlam sıkıştırma, alt ajan davranışı ve bizzat kodlama araç setini kullanarak eş-eğitti. Bu, Muse Spark 1.2’yi Meta’nın kendi kodlama ortamında özellikle cazip kılıyor; ancak aynı zamanda en güçlü lansman skorlarının model+ajan sistemi olarak okunması gerektiği anlamına geliyor.
, Muse Spark 1.2, Muse Code ile eşleştirildiğinde Terminal-Bench 2.1’de %82,9 ve DeepSWE 1.1’de %59,3 skorladı. Mevcut Artificial Analysis model sayfası, bildiriyor ve daha önceki indeks sürümündeki 54’lük lansman skorunun yerini alıyor. En güncel 1.623 Elo; bu da onu değerlendirilen 213 model arasında 15. sıraya yerleştiriyor. Dolayısıyla Muse Spark 1.2, kodlama ve ajan odaklı çalışmada rekabetçi kalıyor ancak genel lider değil; , Meta’nın öne çıkardığı kodlama kıyaslarında ve mevcut GDPval-AA v2 sıralamasında önde.
Önceliği kodlama: Muse Spark 1.2, üretim, hata ayıklama, kod tabanı anlama ve uzun soluklu geliştirici iş akışlarında kazanımları yoğunlaştırıyor.
1M belirteç bağlam: API, depo ölçeğinde çalışma ve kalıcı ajan oturumları için 1.048.576 belirteçlik bağlam penceresi listeliyor.
Çok modlu girdi: Barındırılan model metin, görsel, video ve PDF belgelerini kabul ediyor ve metin döndürüyor.
Ajan-sistem optimizasyonu: Model, Muse Code’un planlama, araç, sıkıştırma ve alt ajan kalıplarıyla çalışacak şekilde eğitildi.
Güçlü ancak koşum bağımlı kodlama sonuçları: Meta, Muse Code ile Terminal-Bench 2.1’de %82,9 ve DeepSWE 1.1’de %59,3 bildiriyor.
Rekabetçi API ekonomisi: Standart fiyatlandırma 1M girdi belirteci için $1,25 ve 1M çıktı belirteci için $4,25; farklı veri şartları altında çok daha ucuz bir Contributor kademesi var.
Önemli ihtar: Açık parametre sayısı, mimari ve eğitim belirteçleri açıklanmadı.
What Is Muse Spark 1.2?
Muse Spark 1.2, Meta Superintelligence Labs’in kodlamaya optimize edilmiş çok modlu akıl yürütme modeli. Meta, bunu Muse Spark 1.1’in bir güncellemesi olarak tanımlıyor; kod üretimi, karmaşık hata ayıklama, kod tabanı anlama ve tam geliştirici iş akışlarında iyileştirmeler içeriyor. Yayın, büyük depolarda planlama, kod yazma, araç çalıştırma, kalıcı alt ajanları koordine etme ve sonuçları doğrulamak için tasarlanmış bir terminal kodlama ajanı olan Muse Code beta ile eşleştirildi.
Bu konumlandırma önemli. Muse Spark 1.2, esas olarak daha iyi bir sohbet botu veya daha büyük genel amaçlı bir model olarak pazarlanmıyor. Yazılım ajanlarını zorlaştıran koşullara göre tasarlandı: birçok dosyaya yayılmış gereksinimler, birikmiş terminal çıktısı, tekrarlanan test başarısızlıkları, değişen planlar, uzun oturumlar ve çok sayıda ara adımdan sonra özgün hedefin korunması gerekliliği.
Muse Spark 1.2 Specifications
Specification
Muse Spark 1.2
Developer
Meta Superintelligence Labs
Release date
August 5, 2026
API model ID
muse-spark-1.2
Model type
Proprietary multimodal reasoning and coding model
Primary focus
Coding agents, debugging, repository understanding, long-horizon development
Specification note:Meta’nın model dokümantasyonu model konumlandırmasını, bağlamı ve fiyatlandırmayı sağlar; barındırılan API dokümantasyonu desteklenen girdi ve çıktı modlarını sunar. Dağıtım sınırları, altyapı modelinin teorik yeteneklerinden farklı olabilir.
What Is New in Muse Spark 1.2?
More Coding Training
Meta, kodlama görevlerinde eğitim hesaplamasını önemli ölçüde artırdığını ve eğitim ortamlarının çeşitliliğini genişlettiğini söylüyor. Pratik hedef yalnızca doğru parçacıklar üretmek değil; bir ajanın tanıdık olmayan bir depoyu incelemesi, ilgili dosyaları belirlemesi, bir değişikliği uygulaması, derlemeyi veya testleri çalıştırması ve geri bildirimden sonra çalışmasını revize etmesi gerektiğinde ilk deneme doğruluğunu artırmak.
Bu, tek seferlik kod üretimindeki bir kazançtan çok üretim mühendisliğine daha ilgili kılıyor. Gerçek depolar çatı iskeletleri, gizli bağlaşım, eksik dokümantasyon, kırılgan testler ve tek bir izole fonksiyonu düzenleyerek karşılanamayacak gereksinimler içerir. Muse Spark 1.2, açıkça bu daha geniş görev zarfı için eğitildi.
Co-Training With Muse Code
Meta, modeli ajanın araç seti ve çalışma zamanı ile daha iyi eşleşmesi için Muse Code ile Muse Spark 1.2’yi eş-eğitti. Eğitim; reddetme örneklemeli harness trajeleri ve hedefler, bağlam sıkıştırma ve alt ajanlar için tarif (recipe) optimizasyonunu içerdi. Bu, genel bir modeli eğitim sonrası bir komut satırı sarmalayıcısına bağlamaktan daha kasıtlı.
Fayda uyumluluk: Model, araç geri bildiriminin nasıl göründüğünü, bir planın ne zaman revize edilmesi gerektiğini, arka plan çalışanlarının nasıl iletişim kurduğunu ve durumun bağlam sıkıştırması sırasında hangilerinin korunması gerektiğini öğrenir. Bedel, aktarılabilirlik. Bir harness’e göre ayarlanmış bir model başka yerlerde de çalışabilir, ancak en iyi sonucu, eğitim sırasında gördüğü istemler, araçlar, bellek sistemi ve kontrol döngüsüne bağlı olabilir.
Long-Horizon Coding
Muse Spark 1.2, tüm depo üretimi ve uzun projelerde eğitildi; buna kendi araştırmasını yapan iş akışları da dâhil. Meta üç davranışı vurguluyor: çalışmayı sıralamak için planlama, ajanın özgün hedefe yönelik kalması için hedef koşullandırma ve oturum büyüdükçe kritik bilgiyi elde tutmak için bağlam sıkıştırma.
Bu mekanizmalar, kodlama ajanlarındaki yaygın bir hata kipini adresler: Sistem yerel olarak üretken olur, ancak küresel olarak yönünü kaybeder. Bir testi düzeltirken gereksinimi bozabilir, önceki araştırmaları tekrar edebilir veya bir tasarım seçiminin neden yapıldığını unutabilir. Uzun vadeli eğitim, ilerlemeyi epizodik değil kümülatif kılmayı amaçlar.
Self-Improvement With Muse Spark 1.1
Meta ayrıca, Muse Spark 1.1’i zorlayıcı kodlama ortamları ve talimat izleme şablonları üretmek için kullandı. Önceki model, oluşturulan gereksinimlere karşı aday çözümleri derecelendirerek Muse Spark 1.2 için ölçeklenebilir eğitim verisi üretti. Bu, dağıtılan modelin kontrolsüz kendini değiştirmesi değil; model destekli görev üretimi ve değerlendirme olarak anlaşılmalıdır.
Multimodal Repository Work
1M belirteç penceresi ve çok modlu girdiler önemlidir, çünkü birçok geliştirme görevi yalnızca metin değildir. Bir ajan, bir ön yüzü ekran görüntüsüyle karşılaştırması, bir PDF spesifikasyonunu incelemesi, bir UI kaydını yorumlaması veya kod düzenlerken görsel gereksinimleri koruması gerekebilir. Muse Code’un bir ev fly-through videosunu yorumlayıp bir pazarlama ve rezervasyon sayfası üretmesini gösteren yayın demosu, algıdan uygulamaya iş akışını örnekliyor.
Muse Spark 1.2 vs Muse Spark 1.1: What Actually Changed?
Muse Spark 1.1
Muse Spark 1.2
Context
1M
1M
Standard Input
$1.25
$1.25
Standard Output
$4.25
$4.25
Intelligence Index
53 current
57 current
Terminal-Bench
78% AA
80% AA
Coding focus
High
Higher
Muse Code co-training
No
Yes
Long-horizon training
Yes
Expanded
Open weights
No
No
How Muse Spark 1.2 Works With Muse Code
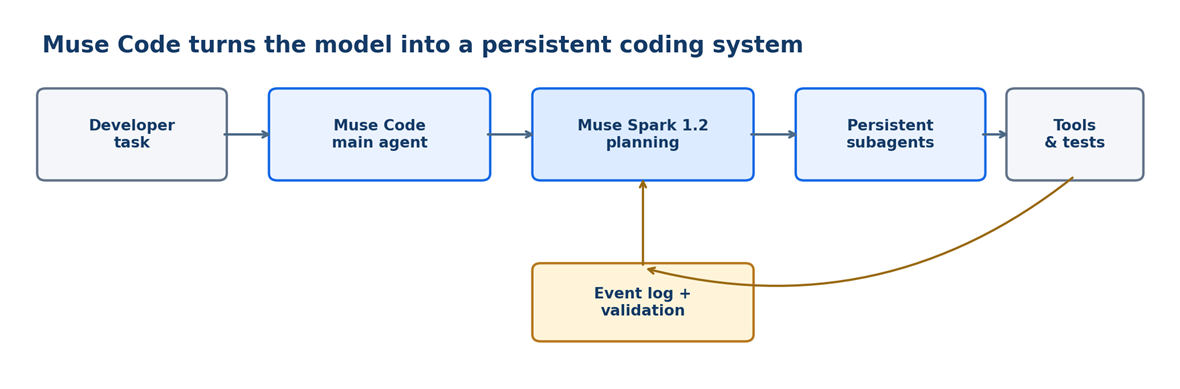
Muse Spark 1.2 modeldir; Muse Code ise model çağrılarını kalıcı yazılım mühendisliği işine çeviren ajan ürünüdür. Muse Code, oturum boyunca etkin kalan asenkron arka plan ajanlarının yanında bir ana ajan çalıştırır. Bu çalışanlar, bağlam toplayabilir, sonraki adımları yürütebilir ve her görev için yeniden oluşturulmadan ilgili bulguları ana ajana geri iletebilir.
Çalışma zamanı ayrıca yerel bir olay günlüğü tutar. Her model çağrısı, araç yürütmesi, onay ve düzenleme tek bir geçmişe eklenir; bu, ajanın görevi yeniden başlatmak yerine bir çöküşten sonra devam etmesini sağlar. /plan, /grill ve /goal gibi yerleşik beceriler; onay kontrollü planlama, plan stres testi ve hedef odaklı yürütme ekler.
Şekil 1. Muse Code, Muse Spark 1.2’yi kalıcı bir planlama, yürütme ve doğrulama sistemine dönüştürür. Kaynak:Meta lansman açıklaması
Yorum: Muse Code’un kalıcılığı, olay günlüğü, araçları ve alt ajan orkestrasyonu sistem yetenekleridir. Bunlar yalnızca temel modele atfedilmemelidir.
Benchmark Performance of Muse Spark 1.2
Aşağıdaki sonuçlar Meta tarafından raporlanmıştır. Kodlama skorları, tam model ve ajan sistemlerini ölçer; daha sonra gelen çok modlu bileşik ölçüler, araçlarla ve araçsız Meta Model API yapılandırmalarını kapsar. Bunlar, takip eden bağımsız Artificial Analysis metrikleriyle birleştirilmemelidir.
Coding Benchmark Performance
Meta coding benchmarks
Muse Spark 1.2 result
Leading comparison in Meta's chart
Evaluation scope
How to read it
Terminal-Bench 2.1
82.9% with Muse Code
Claude Opus 5: 86.7% with Claude Code
Terminal tasks in selected coding agents
Vendor-reported system result
DeepSWE 1.1
59.3% with Muse Code
Claude Opus 5: 65.0%; GPT-5.6 Terra: 64.8%
113 tasks, 91 repositories, five languages
Vendor-reported system result
Meta Internal Coding Bench
70.6%
Claude Opus 5: 79.4%
440 private tasks derived from Meta pull requests
Private and not independently reproducible
Meta’nın değerlendirme metodolojisi, Muse Spark 1.2 için Muse Code’u, Claude Opus 5 için Claude Code’u, GPT-5.6 Terra için Codex’i ve Grok 4.5 için Grok Build’i kullanır. Daha yüksek bir skor; model, ajan döngüsü, istemler, araçlar ve bellek tasarımının birlikte etkisini yansıtabilir. Doğru ifade şudur: Muse Spark 1.2, Muse Code içinde %82,9 skorladı; temel model tek başına %82,9 skorladı değil.
Multimodal Benchmark Performance
Meta’nın 20 Ağustos çok modlu değerlendirmesi görsel algı, görsel bilgi, mekânsal ve UI akıl yürütme ve grafik/çizelge anlama alanlarında on kıyasın eşit ortalamasını bildiriyor. En büyük kazanç, Muse Spark 1.2’nin araçları kullanabildiği durumda görülüyor.
Meta multimodal evaluation
Direct response
With tools
Tool uplift
Interpretation
Muse Spark 1.2
59.8
72.0
+12.2
Araç etkin yapılandırmada daha güçlü
Muse Spark 1.1
60.2
69.1
+8.9
Araçsız biraz daha yüksek, araçlı daha düşük
Resmî çok modlu metodoloji BabyVision, PerceptionBench, ZeroBench, WorldVQA, SimpleVQA, ERQA, OmniSpatial, CharXiv Reasoning, ChartMuseum ve ChartQAPro’yu eşitler. Karşılaştırma, Meta’nın çerçevesi içinde araç katkısını ölçmek için yararlıdır; bağımsız şekilde çoğaltılmış bir kıyas değildir.
Independent Benchmark Results
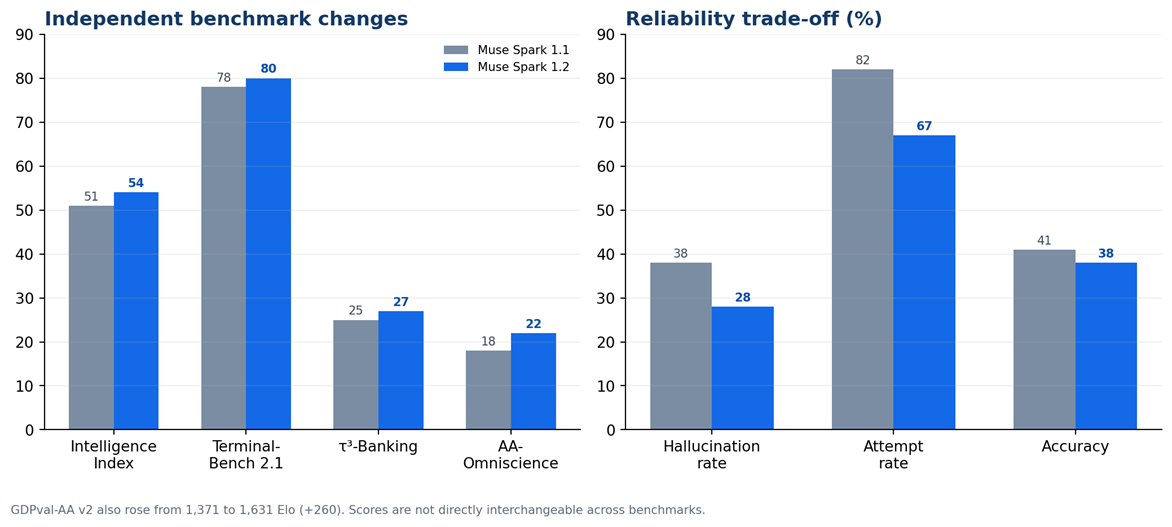
Mevcut Artificial Analysis Intelligence Index v4.1.1 kapsamında Muse Spark 1.2, 57 skor alıyor; Muse Spark 1.1 için 53 ve özgün Muse Spark için tahmini 44 ile karşılaştırıldığında. En son GDPval-AA v2 derecesi 1.623 Elo; bu da onu 213 değerlendirilmiş model arasında 15. sıraya yerleştiriyor. Muse Spark 1.2, ayrıca mevcut AA-LCR uzun bağlam kıyası lideri; %83,3 skorla, gücünün ajan odaklı bilgi işi, kodlama iş akışları ve uzun bağlam akıl yürütme boyunca uzandığını gösteriyor.
Güvenilirlik verileri dikkatli yorumlanmalıdır. AA-Omniscience 18’den 22’ye yükselirken ve halüsinasyon oranı %38’den %28’e düşerken, modelin deneme oranı da %82’den %67’ye düşüyor. Doğruluk %41’den %38’e düşüyor. Başka bir deyişle, Muse Spark 1.2, emin olmadığında çekimser kalmaya daha istekli; bu, yanlış iddiaları azaltıyor, ancak denenen yanıt sayısını da düşürüyor.
Bilimsel akıl yürütme nispeten yatay. CritPt %15’ten %18’e yükselirken, SciCode %58’den %56’ya düşüyor ve Humanity’s Last Exam %45’ten %44’e düşüyor. Bu desen, Meta’nın kendi konumlandırmasını destekler: Muse Spark 1.2, her akıl yürütme alanında uniform bir sıçrama değil; uzmanlaşmış bir kodlama ve ajan güncellemesidir.
Muse Spark 1.2 Pricing
Meta, Standard ve Contributor erişimi sunuyor. Standart model, 1M girdi belirteci için $1,25, 1M önbelleğe alınmış girdi belirteci için $0,15 ve 1M çıktı belirteci için $4,25 olarak fiyatlandırılmıştır. Contributor varyantı dramatik şekilde daha ucuzdur, ancak Meta, verilerinin ürünleri iyileştirmek için kullanılabileceğini belirtir.
Tier
Input / 1M
Cached input / 1M
Output / 1M
Data treatment
Standard
$1.25
$0.15
$4.25
Not used to improve Meta products
Contributor
$0.10
$0.002
$0.20
May be used to improve Meta products
Pricing source:Meta’nın resmî model sayfası. Ekiplerin, Contributor rotası üzerinden gönderilen veriler için geçerli ürün ve veri şartlarını, özel kod, kimlik bilgileri, müşteri verisi veya iç dokümanlar göndermeden önce gözden geçirmesi gerekir.
Düşük belirteç fiyatları, otomatik olarak en düşük tamamlanan görev maliyeti anlamına gelmez. Artificial Analysis, Muse Spark 1.2 için Intelligence Index görevi başına yaklaşık $0,40 tahmin ediyor; Muse Spark 1.1 için $0,29’dan yükselmiş durumda. Artış, özellikle profesyonel ajan işinde daha yüksek belirteç kullanımından kaynaklanıyor. Ekipler bu nedenle yalnızca liste fiyatlarını karşılaştırmak yerine, kabul edilen çekme isteği (pull request) başına maliyet, çözülen sorun veya doğrulanmış teslimat başına maliyeti ölçmelidir.
Muse Spark 1.2 vs Other Frontier Coding Models
En ilgili karşılaştırma kümesi Claude Opus 5, GPT-5.6 Terra, Grok 4.5 ve Kimi K3 içerir. Bu modeller kodlama, araçlar, uzun bağlam ve profesyonel ajan iş akışlarında örtüşür; ancak dağıtım, modallik genişliği, ekosistem ve fiyat-performans önceliklerinde farklıdır.
Model
Context
Inputs
Terminal-Bench 2.1 signal
Deployment
Best fit
Muse Spark 1.2
1M
Text, image, video, PDF
82.9% with Muse Code
Meta hosted API
Muse Code, uzun süreli depo çalışması, daha düşük API fiyatı
Claude Opus 5
1M
Text, image, documents
86.7% with Claude Code
Hosted API
Maksimum kodlama güvenilirliği ve karmaşık ajan yargısı
GPT-5.6 Terra
~1.05M
Text, image
81.8% with Codex
Hosted API
Dengeli kodlama, üretkenlik ve geniş araç iş akışları
Grok 4.5
500K
Text, image
81.6% with Grok Build
Hosted API
Kodlama, xAI araçları ve güncel bilgiyle birlikte
Kimi K3
1M
Text, image, video
Not shown in Meta chart
Hosted and open-weight options
Uzun vadeli çalışma ve dağıtım esnekliği
Where Muse Spark 1.2 Has the Clearest Advantage
Muse Spark 1.2, uygulamanın Muse Code’un kalıcı olay günlüğünü, alt ajan tasarımını ve modele özgü eğitimi kullanabildiği durumlarda en fazla farklılaşır. Standart API fiyatı da, üst düzey kodlama modellerine kıyasla agresiftir. Sıkı entegre bir ajan sistemine değer veren ekipler için kombinasyon, tek bir kıyastaki küçük bir farktan daha önemli olabilir.
Claude Opus 5, yer aldığı üç Meta kodlama grafiğinin tümünde lider. Başarısız bir değişikliğin maliyetinin yüksek olduğu ve maksimum uçtan uca kodlama güvenilirliğinin belirteç fiyatından daha önemli olduğu durumlarda daha güvenli seçim olmaya devam ediyor. Muse Spark 1.2, özellikle terminal görevlerinde farkı daraltıyor, ancak ortadan kaldırmıyor.
GPT-5.6 Terra, Meta’nın değerlendirmesinde Terminal-Bench’te Muse Spark 1.2’ye yakın, DeepSWE’de önde. Avantajı genişlik: Halihazırda OpenAI’nin response, search, file, shell, computer ve MCP araçlarını kullanan ekipler, başka bir model biraz daha ucuz olsa bile mevcut üretim yığınına uyan bir modeli tercih edebilir.
Grok 4.5, kodlamayı xAI’nin güncel bilgi ve araç ekosistemiyle birleştiren iş akışları için güçlü bir alternatiftir. Kimi K3, uzun vadeli performans, açık ağırlık dağıtımı veya sağlayıcı kontrolü önemli olduğunda daha çekicidir. Pratik seçim, tam çalışma zamanına bağlıdır: İstemler, araçlar, bellek, güvenlik gereksinimleri ve doğrulama stratejisi, temel model kadar sonuçları değiştirebilir.
What Can Muse Spark 1.2 Do?
Repository-Scale Software Engineering
1M belirteçlik bağlam; önemli miktarda kaynak kodu, dokümantasyon, test çıktısı, sorun geçmişi ve ajan durumunu barındırabilir. Uygun görevler arasında çok dosyalı özellikler, çatı yükseltmeleri, depo genelinde yeniden düzenlemeler, API geçişleri, test onarımları, çekme isteği incelemesi ve mimari analiz bulunur. Uzun bağlam, bir depoyu rastgele yüklemek yerine alma (retrieval) ve sıkıştırma ile eşleştiğinde en faydalıdır.
Complex Debugging
Muse Spark 1.2; kodu inceleyebilir, araçları çalıştırabilir, hataları okuyabilir, hipotezler kurabilir, yamalar uygulayabilir ve yeniden test edebilir. Kod odaklı eğitimi, bu döngüyü iyileştirmeyi amaçlar; zor olan kısım, makul bir düzeltme önermek değil, kök nedeni belirlemek ve yamanın regresyonlar yaratmadığını doğrulamaktır.
Long-Running Coding Agents
Kalıcı projeler merkezî bir kullanım durumudur. Muse Code’un olay günlüğü ve arka plan ajanları, işi birçok model çağrısı ve araç adımı boyunca sürdürmeye izin verir. Bu, yükseltmeler, performans ayarı, dokümantasyon üretimi, test modernizasyonu ve tek bir yanıtta güvenle tamamlanamayacak özellik dilimleri için yararlıdır.
Automated Technical Research
Meta, Muse Spark 1.2’yi 1.000’den fazla araç çağrısı ve 24 saate kadar GPU çekirdeği optimizasyonu üzerinde test etti. Ajan, referans taban çizgilerine karşı Triton uygulamaları yazdı, derledi, profilledi ve iyileştirdi. Daha geniş ders, modelin deneylerin bir sonraki eylemi yönlendirdiği yinelemeli teknik çalışma için tasarlanmış olmasıdır.
Multimodal Development
Görsel, video ve PDF girdi; geliştirme döngüsünü kaynak kodun ötesine genişletir. Bir ekip, modeli bir UI’yi ekran görüntüsü ile karşılaştırmak, bir ürün dokümanından gereksinimleri çıkarmak, kaydedilmiş bir etkileşimi yorumlamak veya görsel bir referanstan bir uygulama üretmek için kullanabilir. Görsel içerikte yer alan erişilebilirlik, marka tutarlılığı, güvenlik ve olgusal iddialar için insan incelemesi gerekli olmaya devam eder.
When should you NOT use Muse Spark 1.2?
Don't choose it primarily for:
basit sohbet
temel kod tamamlama
düşük gecikmeli otomatik tamamlama
genel yazım
maksimum kıyas güvenilirliğinin önemli olduğu görevler
Contributor veri şartları uygun değilse sıkı regülasyonlu iş yükleri
Limitations of Muse Spark 1.2
Açıklanmamış mimari: Meta, parametre sayısı, model topolojisi, uzman yönlendirme veya eğitim belirteçlerini yayımlamadı.
Koşum bağımlı lansman sonuçları: En güçlü skorlar, Muse Spark 1.2’yi Muse Code ile eşlerken, rakipler farklı kodlama ürünleri kullanıyor.
Özel iç kıyas: Meta Internal Coding Bench, dış geliştiriciler tarafından bağımsız şekilde çoğaltılamaz veya denetlenemez.
Düzensiz yetenek kazanımları: Bağımsız değerlendirme, ajan odaklı işte daha büyük, bilimsel akıl yürütmede daha sınırlı iyileşmeler gösteriyor.
Çekimserlik takası: Daha düşük halüsinasyon oranı, daha düşük deneme oranı ve AA-Omniscience’ta biraz daha düşük doğrulukla birlikte geliyor.
Veri politikası seçimi: En ucuz Contributor kademesi, gönderilen verileri Meta ürünlerini geliştirmek için kullanabilir ve hassas kod için uygun olmayabilir.
Uzun bağlam kusursuz bellek değildir: 1M belirteç sınırı, her pozisyonda uniform alma, dikkat veya doğruluk garantilemez.
Barındırılan lansman: Yayın paketi, indirilebilir model ağırlıkları yerine API ve Muse Code erişimi sağlar.
How to Access Muse Spark 1.2
Geliştiriciler, Muse Spark 1.2’ye Muse Code veya Meta Model API üzerinden erişebilir. Standart API model kimliği muse-spark-1.2; daha düşük maliyetli contributor rotası muse-spark-1.2-contributor kullanır. Meta’nın barındırılan API’si, OpenAI uyumlu bir temel URL sunar; böylece birçok mevcut chat-completions istemcisi farklı bir anahtar, temel URL ve model adıyla uyarlanabilir.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["MODEL_API_KEY"],
    base_url="https://api.meta.ai/v1",
)

response = client.chat.completions.create(
    model="muse-spark-1.2",
    messages=[
        {"role": "user", "content": "Review this repository plan and identify the highest-risk implementation steps."}
    ],
)

print(response.choices[0].message.content)
Uygulama notu: Dağıtmadan önce Meta’nın API dokümantasyonunda etkin model adını, hesap uygunluğunu, hız sınırlarını, desteklenen parametreleri ve bölgesel kullanılabilirliği doğrulayın. Bir API anahtarını doğrudan kaynak koda koymayın.
Yanyana test için, CometAPI hâlihazırda Claude Opus 5, GPT-5.6, Grok 4.5 ve Kimi K3 için birleşik erişim sağlar; bu da A/B testini ve sağlayıcı değişimini basitleştirebilir. Muse Spark 1.2 de yakında CometAPI’de yer alacak.
Is Muse Spark 1.2 Worth Using?
Muse Spark 1.2, iş yükü depo ölçeğinde kodlama, uzun süreli yürütme, tekrarlanan araç geri bildirimi ve çoklu ajan koordinasyonundan oluştuğunda test etmeye değerdir. En güçlü argümanı; kodlamaya özel bir model, amaçlı bir kalıcı ajan, 1M belirteçlik çok modlu bağlam ve düşük standart API fiyatlandırmasının birleşimidir.
O, evrensel kıyas lideri değil. Claude Opus 5 Meta’nın öne çıkan kodlama değerlendirmelerinde önde; GPT-5.6 Terra kodlama ve genel üretim araçlarında oldukça rekabetçi; bağımsız veriler, Muse Spark 1.2’nin kazançlarının uniform değil, yoğunlaştırılmış olduğunu gösteriyor. En iyi seçim süreci bu nedenle iş yükü temellidir: Her modeli gerçek ajan çalışma zamanında test edin, doğrulanmış görev tamamlamayı ölçün ve güvenlik açısından hassas veya yüksek etkili değişiklikler için insan incelemesi ekleyin.
Özet:
Muse Spark 1.2, Meta’nın bugüne kadarki en güçlü kodlama odaklı Muse güncellemesidir. Gerçek fark yaratan unsur, tek bir kıyas skoru değil; model, Muse Code, kalıcı alt ajanlar, uzun bağlam ve doğrulama döngüsünün birlikte çalışacak şekilde sıkı biçimde tasarlanmış olmasıdır.